Bài trước ta thấy nút thắt của chèn hàng loạt vào database là số round-trip mạng, không phải tốc độ chèn một dòng. Redis có đúng vấn đề này — và đúng lời giải. Redis xử lý một lệnh trong micro-giây; nhưng khi Redis nằm ở máy khác (như trong mọi hệ thống thật), mỗi lệnh phải đi qua mạng và chờ phản hồi. Gửi 1000 lệnh tuần tự nghĩa là chờ 1000 lần độ trễ mạng — và với remote Redis, gần như toàn bộ thời gian là chờ mạng, không phải chờ Redis.
Pipeline trong go-redis là lời giải: thay vì gửi từng lệnh rồi chờ phản hồi, bạn xếp nhiều lệnh vào một hàng đợi rồi gửi hết cùng lúc, và đọc hết phản hồi trong một lần. N lệnh gói vào một round-trip. Bài này giải thích cơ chế, đo thật lợi ích, và phân biệt Pipeline với TxPipeline (giao dịch).
Vấn đề: mỗi lệnh một round-trip
// Gửi N lệnh Redis tuần tự = N vòng đi-về mạng.
// Mỗi lệnh CHỜ phản hồi rồi mới gửi lệnh kế -> N x độ trễ mạng.
// Redis xử lý lệnh cực nhanh (micro-giây), nên với remote Redis
// gần như TOÀN BỘ thời gian là chờ mạng, không phải chờ Redis.
Đây là cùng một nguyên lý với batch insert: khi độ trễ mạng lớn hơn nhiều so với thời gian xử lý, giảm số lần đi qua mạng là tối ưu quan trọng nhất.
Cách 1: tuần tự (N round-trip)
for i := 0; i < N; i++ {
	rdb.Set(ctx, key(i), i, 0) // chờ OK rồi mới gửi lệnh kế
}
Mỗi Set gửi lệnh, chờ Redis trả OK, rồi mới sang lệnh kế. N lệnh trả giá độ trễ mạng đầy đủ N lần.
Cách 2: pipeline (1 round-trip)
pipe := rdb.Pipeline()
for i := 0; i < N; i++ {
	pipe.Set(ctx, key(i), i, 0) // chỉ XẾP vào hàng đợi, chưa gửi
}
cmds, err := pipe.Exec(ctx) // gửi HẾT N lệnh, đọc HẾT phản hồi 1 lần
Điểm mấu chốt: gọi pipe.Set không gửi gì cả — nó chỉ xếp lệnh vào bộ đệm. Chỉ khi pipe.Exec chạy, go-redis mới gửi trọn N lệnh trong một lần ghi, rồi đọc trọn N phản hồi trong một lần đọc. Đó là một round-trip cho cả nhóm.
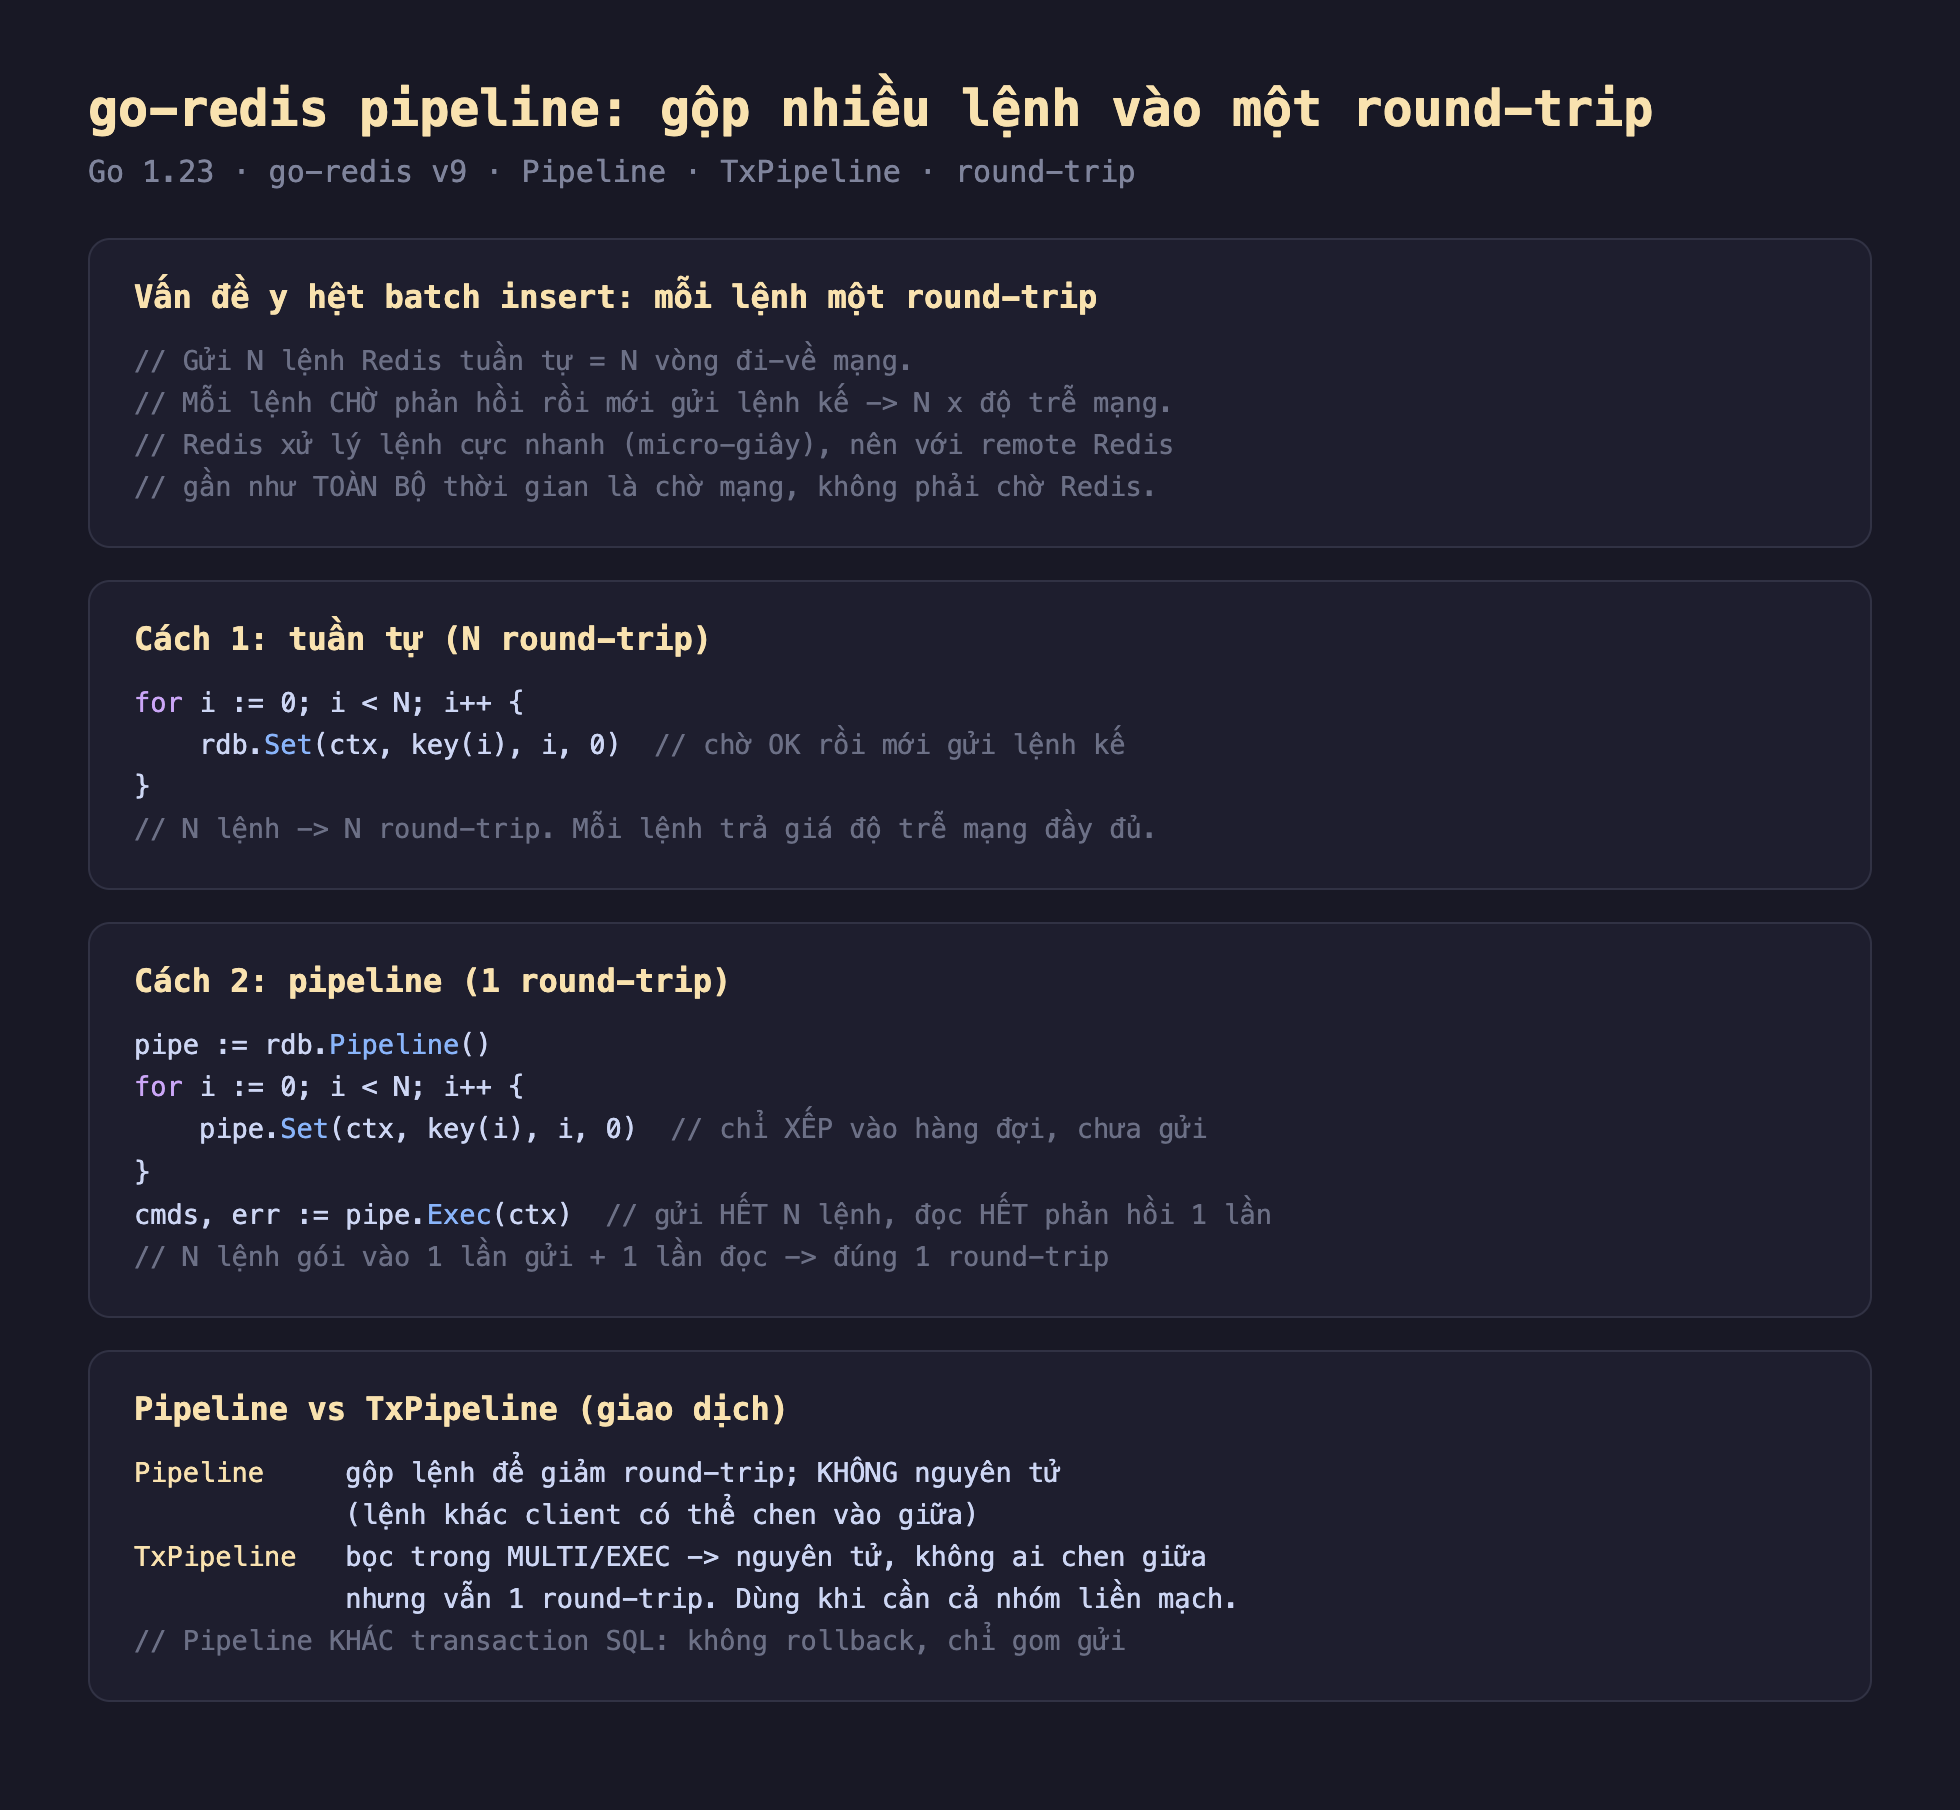
Hình 1: go-redis pipeline giải cùng bài toán round-trip như batch insert — xếp N lệnh rồi Exec gửi hết/đọc hết trong một round-trip; và phân biệt Pipeline (chỉ gom gửi) với TxPipeline (thêm MULTI/EXEC cho nguyên tử).
Đo thật: 1000 lệnh, 140 lần nhanh hơn
Vì miniredis (Redis trong bộ nhớ) không có độ trễ mạng thật, tôi bọc kết nối bằng một net.Conn cộng thêm 0.5ms cho mỗi lần đọc — mô phỏng RTT của remote Redis. Rồi gửi 1000 lệnh SET hai cách:
Cách                     thời gian  tb/lệnh
Tuần tự (N round-trip)   1.431s     1.431ms
Pipeline (1 round-trip)  10ms       10µs

Pipeline: không lỗi | nhanh hơn: 140x
Kiểm dữ liệu: k500=500  p500=500  // cả hai cách ghi đúng
Tuần tự mất 1.431s (mỗi lệnh ~1.4ms — chính là RTT đi + về). Pipeline chỉ 10ms — nhanh 140 lần. Và tôi kiểm cả hai cách đều ghi đúng dữ liệu (k500 và p500 đều bằng 500), nên đây không phải mẹo bỏ qua công việc — cùng 1000 lệnh, chỉ khác cách gửi.
Bản chất: Redis xử lý 1000 lệnh y hệt nhau ở cả hai cách; khác biệt hoàn toàn là số round-trip. Pipeline không làm Redis nhanh hơn — nó bỏ đi phần chờ mạng lặp lại. Đây chính xác là nguyên lý "giảm round-trip" của bài batch insert, áp cho Redis.
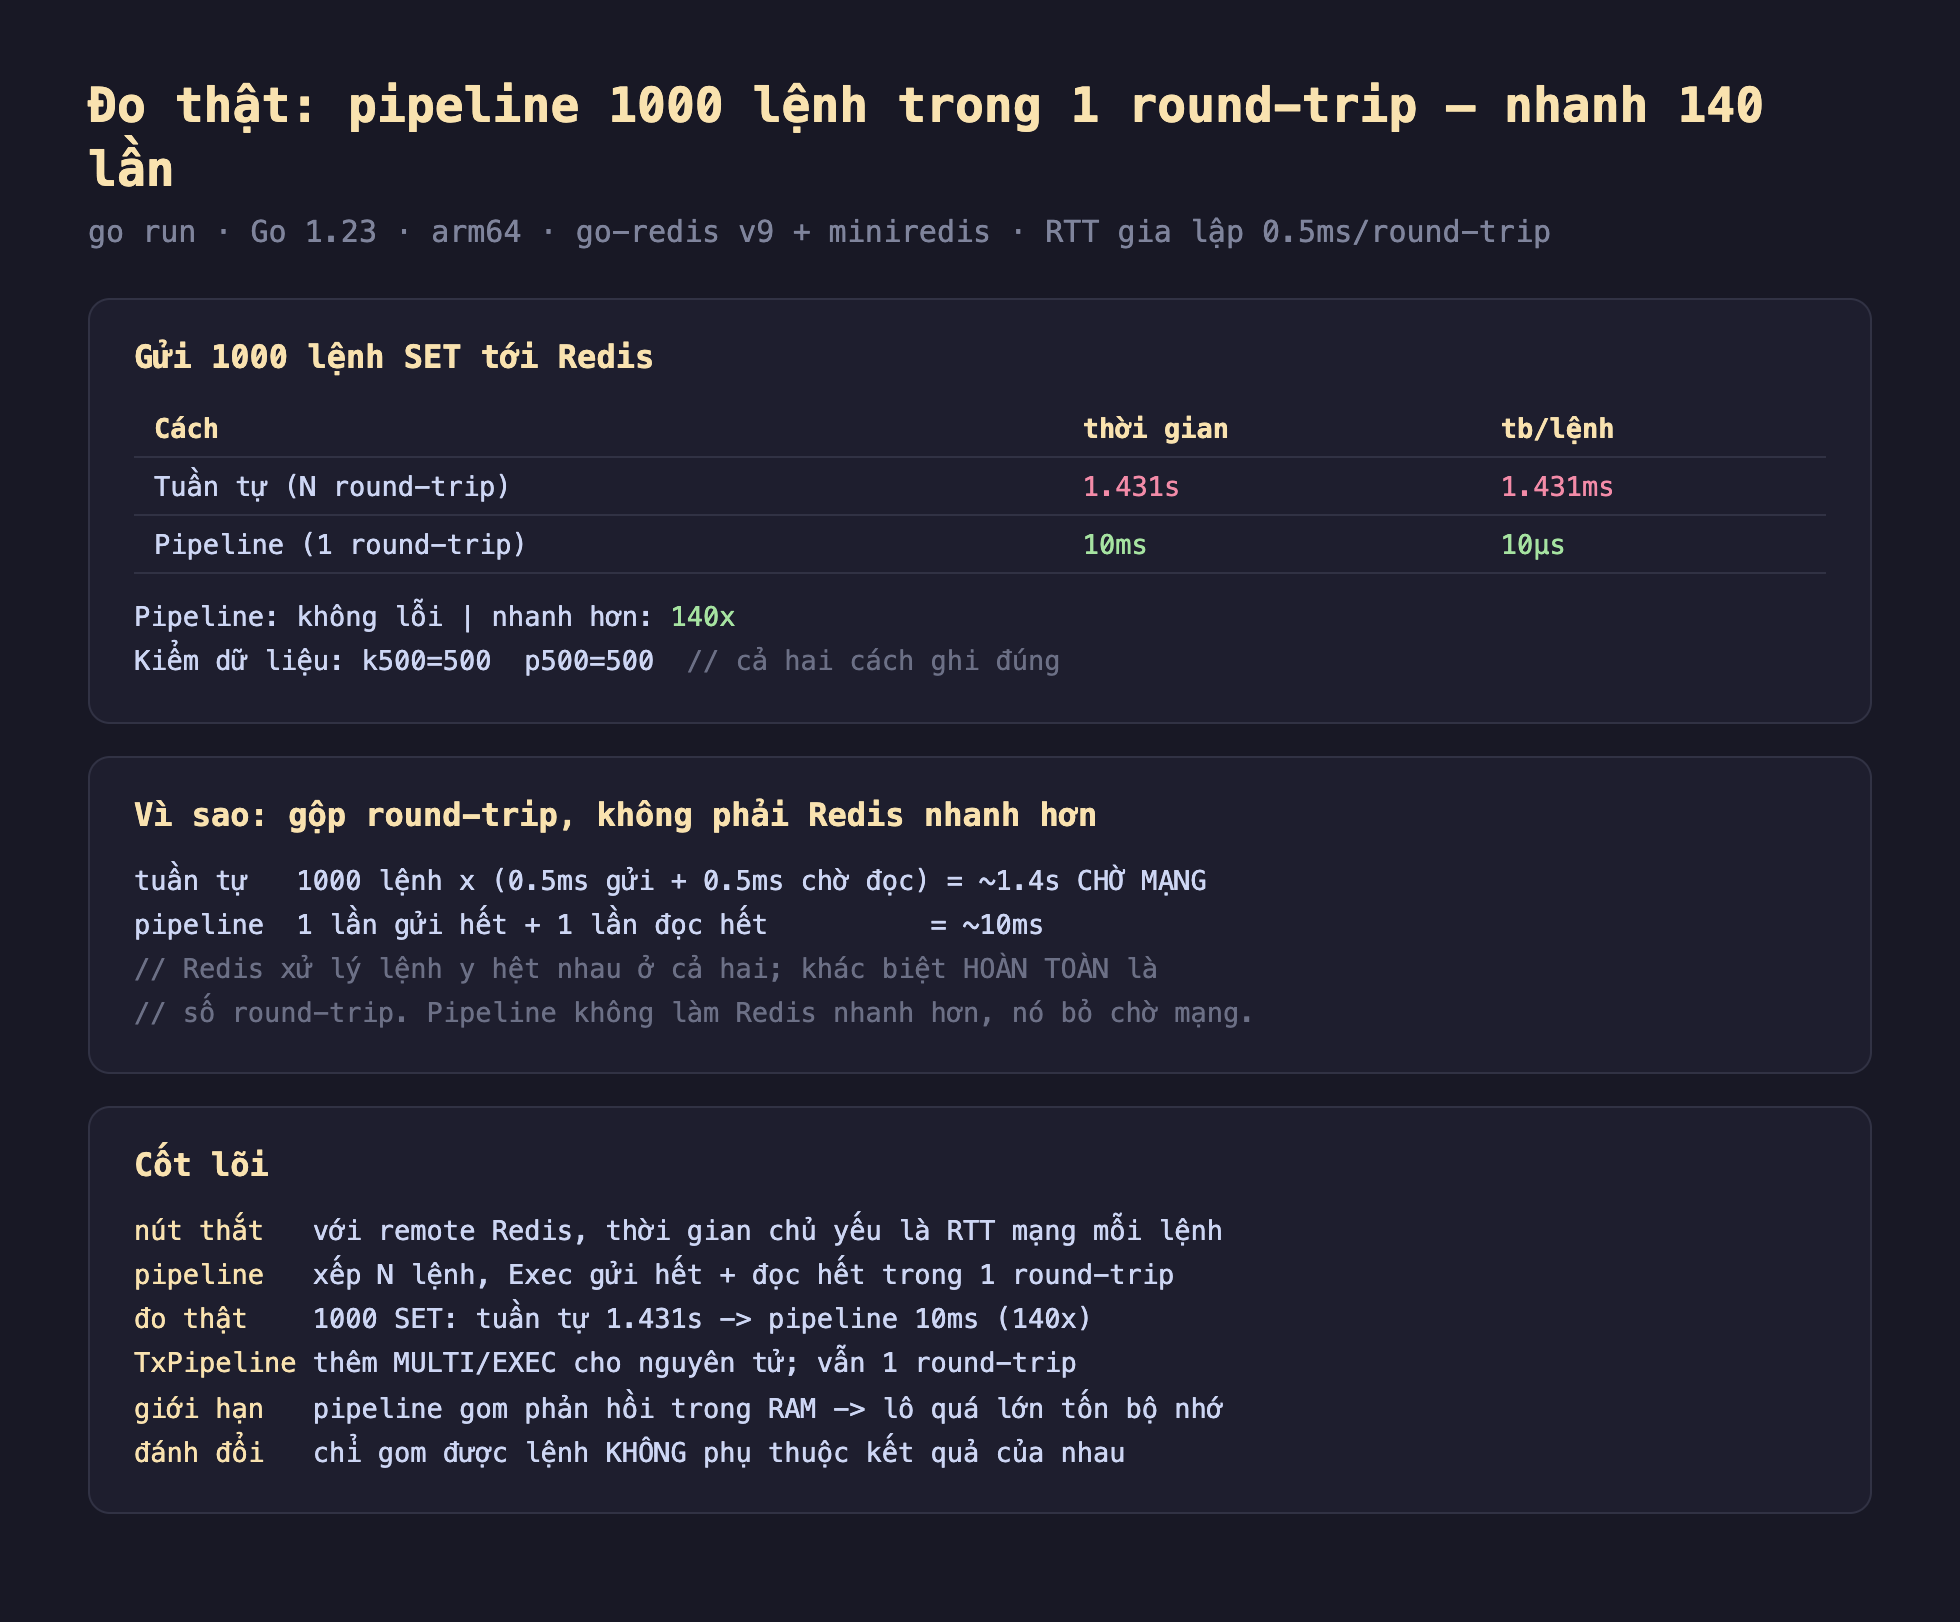
Hình 2: Đo thật 1000 lệnh SET — tuần tự 1.431s (N round-trip), pipeline 10ms (1 round-trip), nhanh 140 lần; cả hai cách ghi đúng dữ liệu (k500=p500=500), khác biệt hoàn toàn nằm ở số round-trip mạng.
Pipeline khác gì transaction
Một nhầm lẫn phổ biến: pipeline không phải transaction. Cần phân biệt rõ:
Pipeline: chỉ gom nhiều lệnh để giảm round-trip. Nó không nguyên tử — giữa các lệnh của bạn, lệnh từ client khác vẫn có thể chen vào (Redis xử lý xen kẽ). Không có rollback: nếu một lệnh trong pipeline lỗi, các lệnh khác vẫn chạy.TxPipeline: bọc nhóm lệnh trongMULTI/EXECcủa Redis, đảm bảo chúng chạy nguyên tử — không client nào chen vào giữa. Vẫn một round-trip. Dùng khi bạn cần cả nhóm lệnh thực thi liền mạch (ví dụ đọc-rồi-ghi phụ thuộc nhau).
Khác biệt với transaction SQL: Redis MULTI/EXEC không có rollback theo nghĩa SQL — nếu một lệnh trong khối lỗi lúc chạy (ví dụ sai kiểu), các lệnh khác vẫn được áp. Nó đảm bảo tính cô lập (không xen kẽ) chứ không phải tất-cả-hoặc-không như SQL.
Đánh đổi cần cân nhắc
Chỉ gom được lệnh không phụ thuộc kết quả của nhau. Pipeline gửi tất cả lệnh trước khi nhận bất kỳ phản hồi nào. Nên nếu lệnh thứ hai cần kết quả của lệnh thứ nhất để quyết định (ví dụ "GET x, rồi SET y = x+1 ở tầng ứng dụng"), bạn không thể pipeline chúng — phải chờ kết quả đầu. Với logic phụ thuộc như vậy, dùng Lua script (chạy nguyên tử phía server) thay vì pipeline.
Lô quá lớn tốn bộ nhớ. Pipeline gom tất cả phản hồi trong RAM phía client trước khi trả về. Gửi một pipeline hàng triệu lệnh nghĩa là buffer hàng triệu phản hồi cùng lúc — có thể nổ bộ nhớ. Chia thành các lô vừa phải (vài trăm đến vài nghìn lệnh mỗi pipeline) là an toàn; đo để tìm điểm cân bằng.
Pipeline không giảm tải cho Redis, chỉ giảm chờ mạng. Redis vẫn xử lý đúng N lệnh. Nếu nút thắt của bạn là CPU của Redis (không phải mạng), pipeline không giúp — thậm chí một pipeline khổng lồ có thể chặn Redis xử lý client khác trong lúc nó chạy trọn lô. Pipeline là tối ưu cho độ trễ mạng, đúng khi RTT lớn so với thời gian xử lý.
Ba ý mang về
- Pipeline gộp N lệnh Redis vào một round-trip: xếp lệnh bằng
pipe.Set(...)(chưa gửi), rồipipe.Exec(...)gửi hết và đọc hết một lần — đo thật, 1000 lệnh SET giảm từ 1.431s (tuần tự) xuống 10ms (pipeline), nhanh 140 lần, cùng dữ liệu ghi đúng. - Lợi ích đến từ bỏ chờ mạng, không phải Redis nhanh hơn: với remote Redis, thời gian chủ yếu là RTT mỗi lệnh; pipeline không giảm tải xử lý của Redis mà cắt số lần đi qua mạng — cùng nguyên lý "giảm round-trip" của batch insert.
- Pipeline khác transaction:
Pipelinechỉ gom gửi (không nguyên tử),TxPipelinethêm MULTI/EXEC cho tính cô lập nhưng không rollback kiểu SQL — và chỉ gom được lệnh không phụ thuộc kết quả của nhau, lô quá lớn thì buffer phản hồi tốn RAM.
Phần sau ta xét xử lý dữ liệu lớn không nạp hết vào bộ nhớ: streaming JSON lớn trong Go — dùng json.Decoder đọc từng phần thay vì Unmarshal cả tệp, và đo thật khác biệt bộ nhớ.
