Bạn cần chèn 2000 dòng vào database. Cách trực giác nhất — vòng lặp gọi db.Exec("INSERT ...") cho mỗi dòng — chạy đúng, nhưng chậm đến mức khó tin: nó có thể mất hàng giây cho một việc lẽ ra chỉ vài mili-giây. Lý do không phải database chèn một dòng chậm, mà là một sự thật ẩn về kiến trúc client-server: mỗi lệnh Exec là một vòng đi-về (round-trip) mạng tới DB, và mỗi vòng trả giá độ trễ mạng cố định — bất kể lệnh đó chèn một dòng hay một trăm dòng.
Nút thắt thật sự vì thế là số round-trip, không phải tốc độ chèn từng dòng. Bài này đo thật ba cách chèn 2000 dòng trong Go, và cho thấy vì sao gộp nhiều dòng vào một câu lệnh (multi-row INSERT) nhanh hơn hàng trăm lần — cùng với việc đọc kết quả cho đúng và trung thực.
Vấn đề: mỗi Exec là một vòng đi-về mạng
// Chèn N dòng bằng N lệnh Exec = N vòng đi-về (round-trip) mạng.
// Mỗi round-trip tốn độ trễ mạng CỐ ĐỊNH, bất kể chèn 1 hay 100 dòng.
// Với 2000 dòng và 1ms/round-trip -> 2 giây chỉ để CHỜ MẠNG.
Đây là điểm nhiều người bỏ sót: bạn có thể tối ưu câu lệnh INSERT đến mức hoàn hảo, nhưng nếu vẫn gửi 2000 lệnh riêng lẻ, bạn vẫn chờ 2000 lần độ trễ mạng. Cách chữa là giảm số round-trip, không phải tinh chỉnh từng lệnh.
Ba cách chèn
Cách 1 — chèn từng dòng (chậm nhất): mỗi dòng một Exec, mỗi Exec một round-trip.
for i := 0; i < N; i++ {
	db.ExecContext(ctx, "INSERT INTO t(a,b) VALUES(?,?)", i, i*2)
}
Cách 2 — gói trong một transaction:
tx, _ := db.BeginTx(ctx, nil)
for i := 0; i < N; i++ { tx.ExecContext(ctx, insert, i, i*2) }
tx.Commit()
Cách 3 — multi-row INSERT (nhanh nhất): gộp nhiều dòng vào một câu lệnh VALUES (?,?),(?,?),...:
for i := 0; i < N; i += batch {
	ph := strings.Repeat("(?,?),", n) // n cặp placeholder
	args := /* gom 2*n tham số */
	db.ExecContext(ctx, "INSERT INTO t(a,b) VALUES "+ph, args...)
}
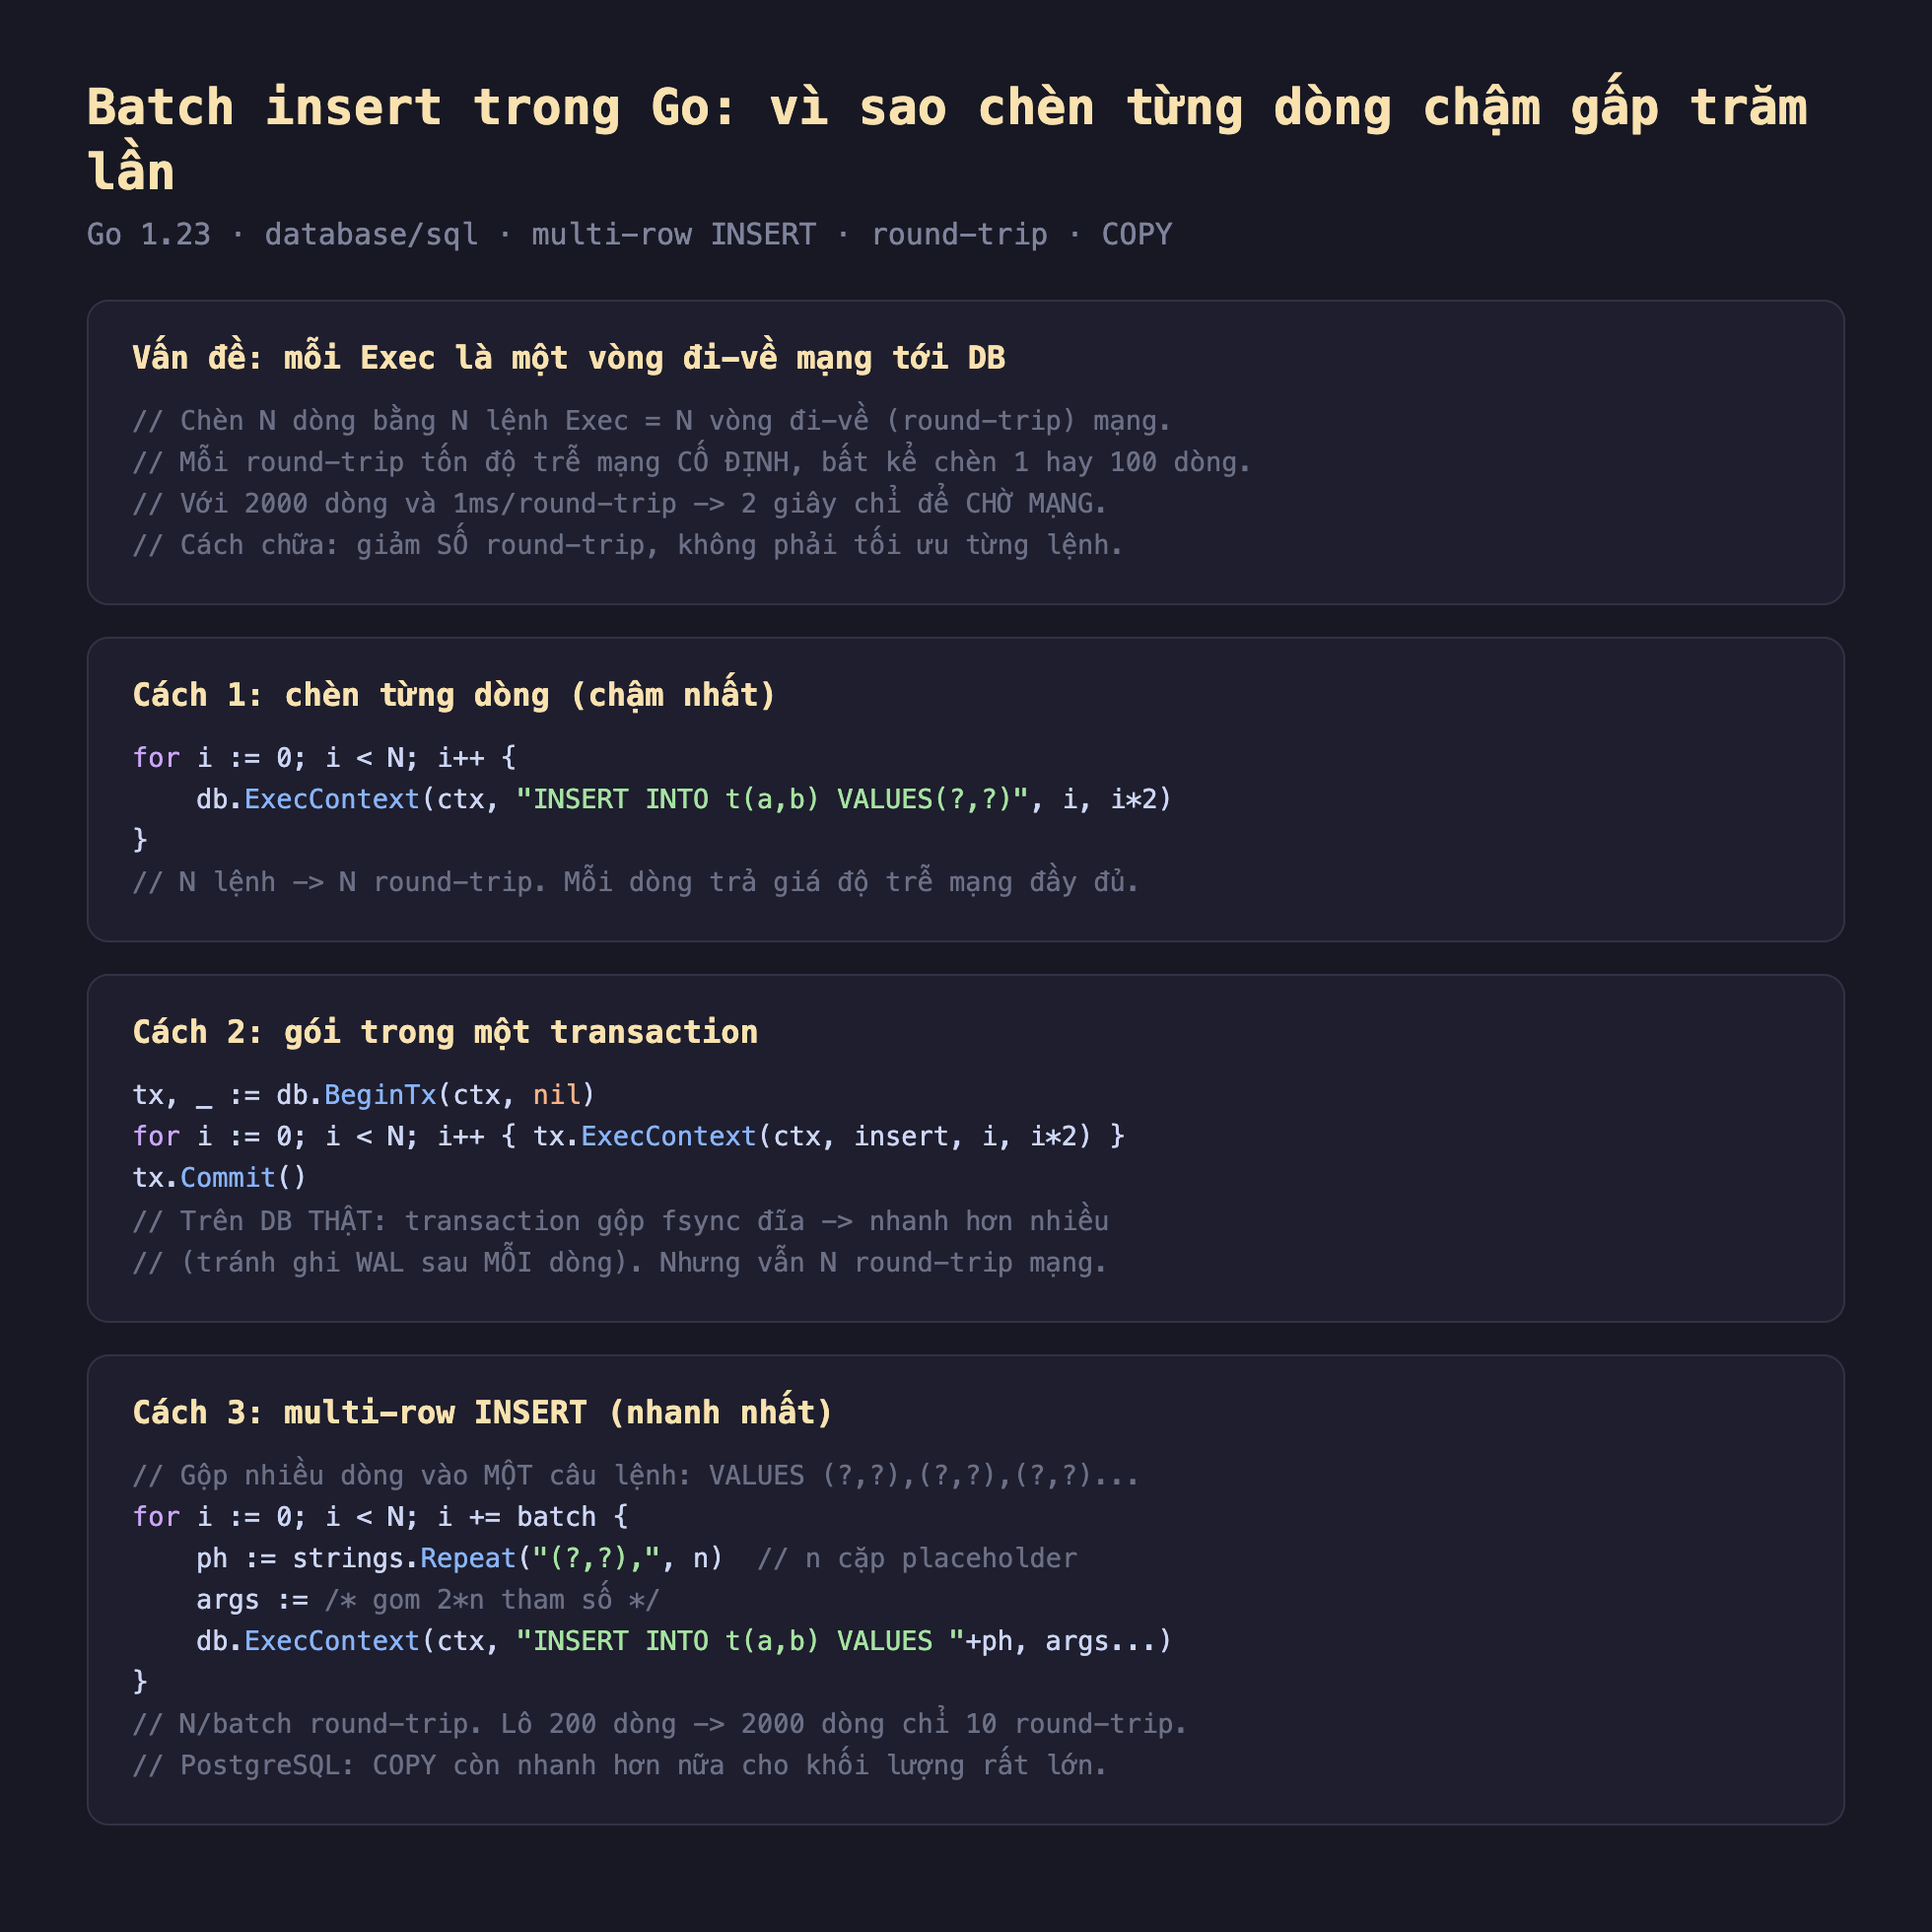
Hình 1: Ba cách chèn 2000 dòng — từng dòng (N round-trip), gói trong transaction (giảm fsync trên DB thật), và multi-row INSERT gộp nhiều dòng vào một câu lệnh (N/batch round-trip).
Đo thật: 2000 dòng, ba cách
Dùng driver giả lập với mỗi round-trip tới DB tốn 1ms (mô phỏng độ trễ mạng), chèn 2000 dòng:
Cách                                round-trip  thời gian
Chèn từng dòng (không transaction)  2000        2.648s
Từng dòng trong 1 transaction       2001        2.633s
Multi-row INSERT (lô 200 dòng)      10          14ms

Multi-row nhanh hơn chèn từng dòng: 193x | round-trip 2000 -> 10
Multi-row INSERT gộp lô 200 dòng giảm số round-trip từ 2000 xuống 10 (2000/200), và nhanh hơn 193 lần. Bản chất: chi phí là số round-trip, không phải số dòng. 2000 dòng / 1 dòng mỗi lệnh = 2000 round-trip; 2000 dòng / 200 dòng mỗi lệnh = 10 round-trip. Gộp dòng vào một câu lệnh cắt thẳng số lần chờ mạng.
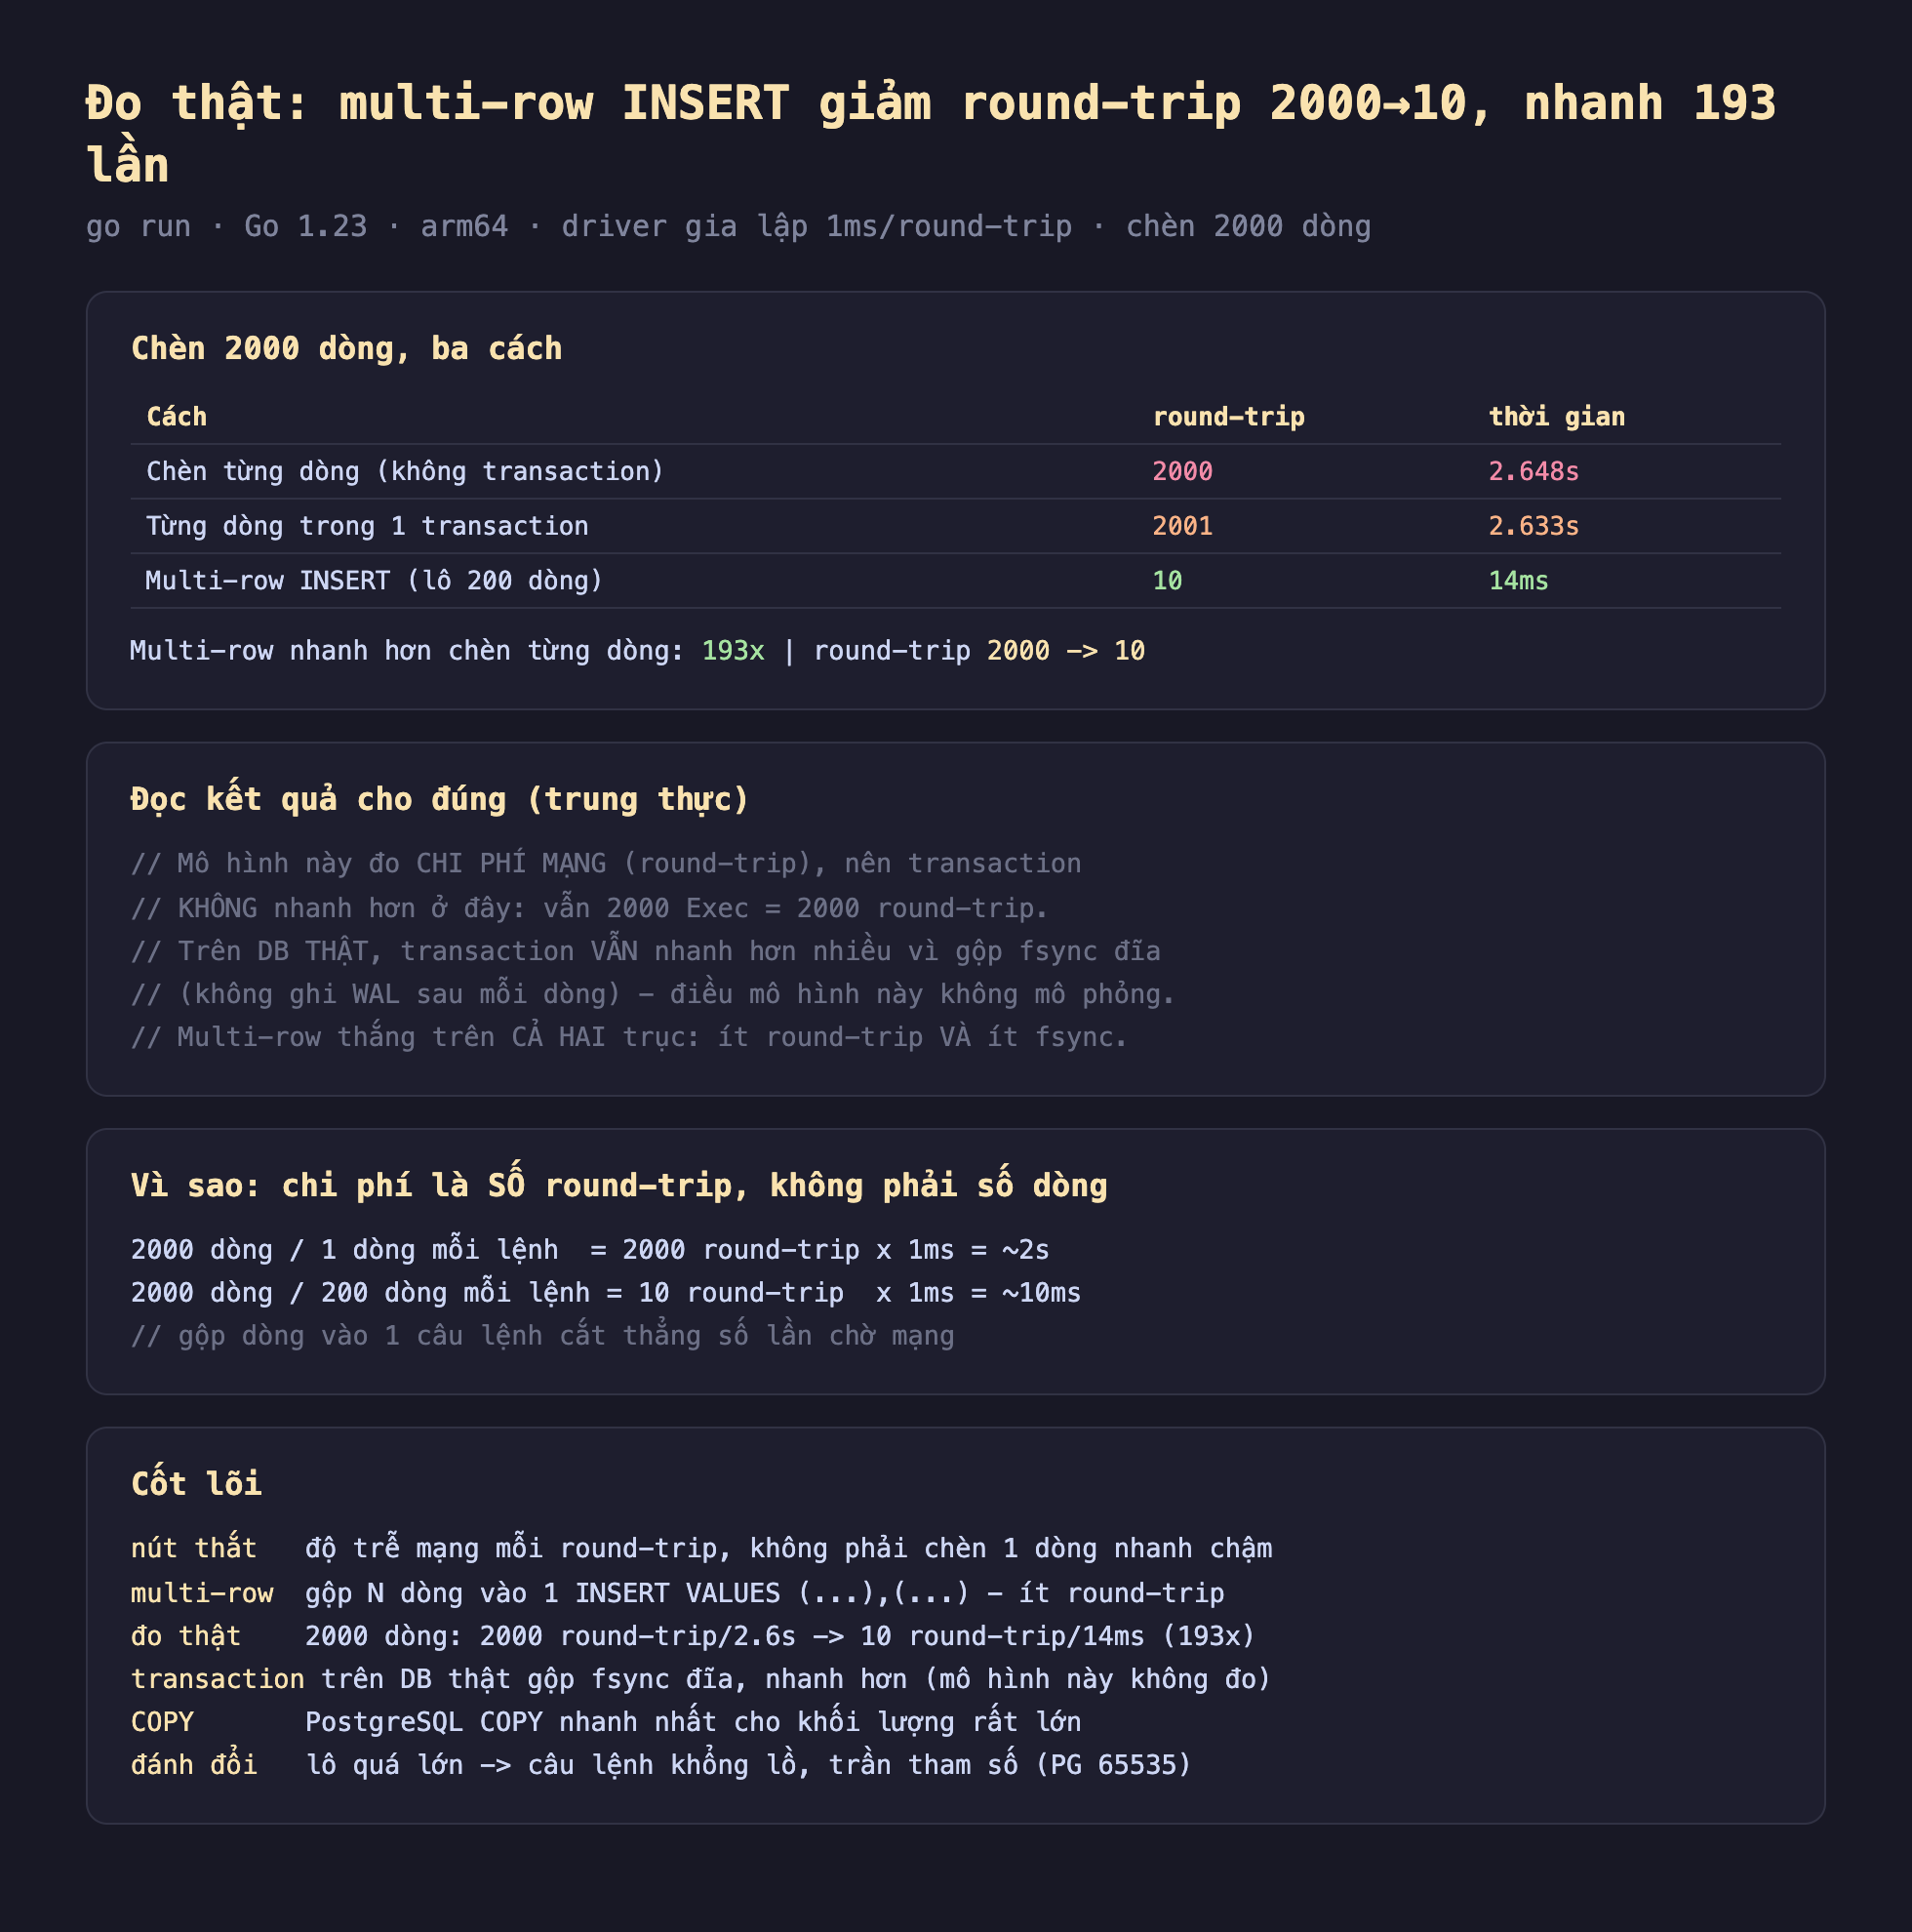
Hình 2: Đo thật chèn 2000 dòng — từng dòng: 2000 round-trip, 2.648s; multi-row lô 200: 10 round-trip, 14ms, nhanh 193 lần; với ghi chú trung thực rằng mô hình chỉ đo mạng nên transaction không hiện lợi ích fsync mà nó có trên DB thật.
Đọc kết quả cho đúng: về transaction
Ở đây cần trung thực về giới hạn của phép đo. Mô hình driver giả lập này chỉ đo chi phí mạng (round-trip), nên transaction (cách 2) không nhanh hơn ở đây — nó vẫn gửi 2000 Exec, tức 2000 round-trip (cộng một round-trip cho Commit thành 2001).
Nhưng trên database thật, transaction VẪN nhanh hơn nhiều so với chèn từng dòng không transaction — vì lý do khác mà mô hình này không mô phỏng: nó gộp fsync đĩa. Mặc định, mỗi INSERT tự-commit buộc PostgreSQL ghi WAL và fsync xuống đĩa sau mỗi dòng; gói chúng trong một transaction chỉ fsync một lần lúc commit, thường nhanh hơn hàng chục lần. Mô hình của tôi chỉ đo mạng nên không thấy hiệu ứng này — tôi nêu rõ để bạn không hiểu nhầm "transaction vô dụng".
Điểm quan trọng: multi-row INSERT thắng trên cả hai trục — nó vừa giảm round-trip mạng, vừa (khi dùng trong transaction hoặc tự-commit ít lần) giảm fsync. Đó là lý do nó là lựa chọn nhanh nhất cho chèn hàng loạt vừa phải.
Đánh đổi cần cân nhắc
Lô quá lớn gặp trần tham số và câu lệnh khổng lồ. Multi-row INSERT nhét mọi tham số vào một câu lệnh. PostgreSQL giới hạn 65535 tham số cho một câu lệnh — với 2 cột mỗi dòng, đó là trần ~32767 dòng mỗi lô. Vượt trần sẽ lỗi. Ngoài ra câu lệnh quá dài tốn bộ nhớ phân tích ở cả client lẫn server. Lô 100–1000 dòng thường là điểm cân bằng tốt; đo để tìm điểm tối ưu cho dữ liệu của bạn.
Với khối lượng rất lớn, dùng COPY. PostgreSQL có lệnh COPY (và pgx phơi bày qua CopyFrom) được thiết kế riêng cho nạp khối lượng lớn — nó bỏ qua phần lớn overhead phân tích câu lệnh và nhanh hơn cả multi-row INSERT cho hàng trăm nghìn dòng trở lên. Nếu bạn nạp dữ liệu ETL hàng triệu dòng, COPY là công cụ đúng, không phải multi-row INSERT.
Multi-row đổi tính nguyên tử lấy tốc độ nếu không cẩn thận. Khi chia thành nhiều lô, mỗi lô là một câu lệnh riêng — nếu lô thứ 5 lỗi mà bốn lô đầu đã commit, bạn có trạng thái nửa vời. Muốn tất-cả-hoặc-không, bọc toàn bộ các lô trong một transaction. Đây là đánh đổi giữa kích thước lô (bộ nhớ) và ranh giới nguyên tử.
Ba ý mang về
- Nút thắt của chèn hàng loạt là số round-trip mạng, không phải tốc độ chèn một dòng: đo thật, chèn 2000 dòng từng cái mất 2.648s vì 2000 round-trip, mỗi round-trip trả giá độ trễ mạng cố định.
- Multi-row INSERT gộp nhiều dòng vào một câu lệnh cắt thẳng số round-trip: đo thật, lô 200 dòng giảm 2000 round-trip xuống 10 và nhanh 193 lần (2.6s → 14ms) — chi phí tỉ lệ với số câu lệnh, không phải số dòng.
- Trung thực về transaction và giới hạn: mô hình này chỉ đo mạng nên transaction không hiện lợi ích, nhưng trên DB thật transaction gộp fsync đĩa nên vẫn nhanh hơn nhiều; multi-row thắng cả hai trục, nhưng nhớ trần 65535 tham số của PostgreSQL và dùng
COPYcho khối lượng cực lớn.
Phần sau ta áp dụng đúng nguyên lý "giảm round-trip" này cho Redis: go-redis nâng cao với pipeline — gộp nhiều lệnh Redis vào một lần gửi, và đo thật lợi ích so với gọi tuần tự.
