Bài trước ta thấy protobuf nhỏ hơn JSON nhiều lần, nhưng chỉ nói "vì nó mã hóa nhị phân". Bài này mở nắp capo: xem chính xác từng byte protobuf sinh ra, và hiểu ba cơ chế làm nên sự nhỏ gọn — tag byte, varint, và zigzag. Quan trọng hơn, ta sẽ gặp một cạm bẫy thật khiến một số âm phình từ 2 byte lên 11 byte nếu chọn sai kiểu. Hiểu wire format không chỉ để tò mò — nó giúp bạn thiết kế schema .proto tối ưu và gỡ lỗi khi dữ liệu trên dây trông lạ.
Tag byte: số trường và wire type
Mỗi trường protobuf bắt đầu bằng một tag byte gộp hai thông tin: số thứ tự trường và kiểu mã hóa (wire type):
tag = (field_number << 3) | wire_type
Wire type có vài giá trị: 0 = varint (số nguyên), 2 = length-delimited (chuỗi, bytes, message con), 1/5 = số cố định 64/32-bit. Đo thật (Go 1.23), proto.Marshal cho ra hex chính xác:
a=1 (field 1, varint):  08 01
  08 = (1<<3)|0 -> field 1, wire type 0 (varint); 01 = giá trị 1
s="hi" (field 4, len):  22 02 68 69
  22 = (4<<3)|2 -> field 4, wire type 2; 02 = độ dài 2; 68 69 = "hi"
Điểm mấu chốt: tag không mang tên trường — chỉ số thứ tự. Đây là lý do lớn protobuf nhỏ hơn JSON (JSON lặp lại tên trường trong mỗi message). Tên trường sống trong .proto, không đi trên dây.
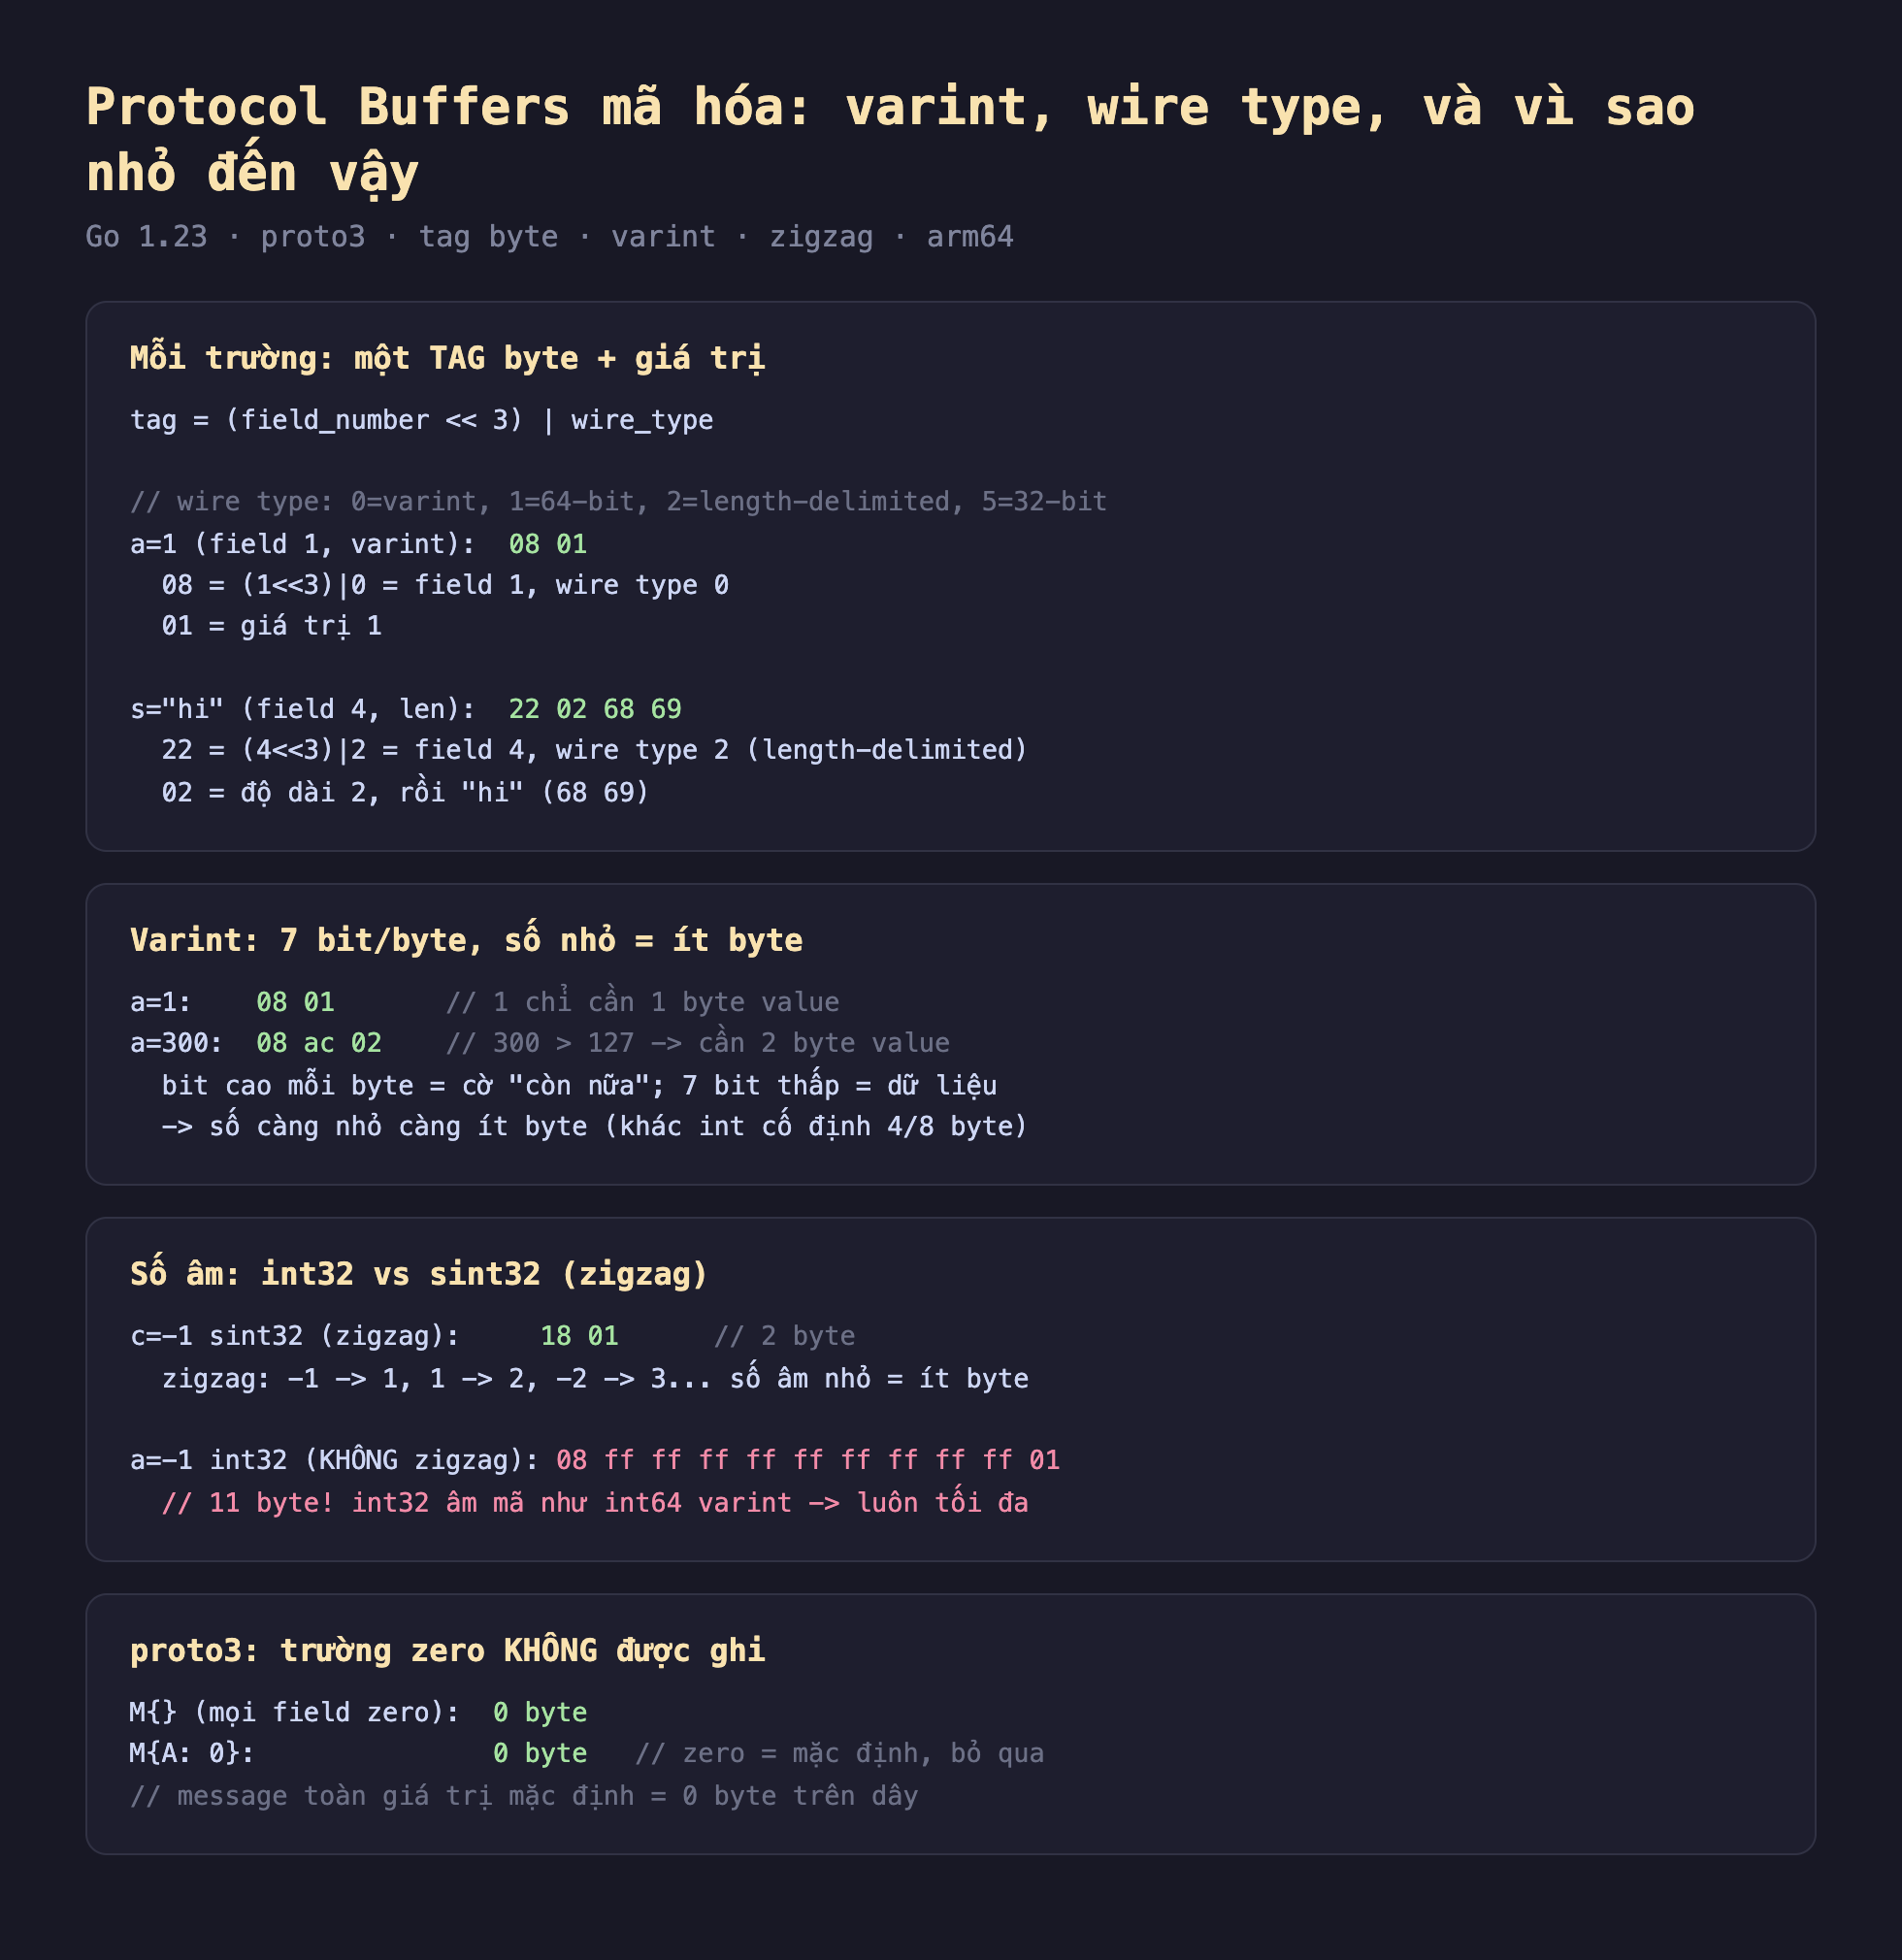
Hình 1: Tag byte = (field_number << 3) | wire_type, không mang tên trường. Varint co giãn theo giá trị. sint32 dùng zigzag cho số âm; int32 âm mã như int64 varint tốn tối đa. proto3 bỏ trường giá trị zero.
Varint: co giãn theo giá trị
Varint mã số nguyên bằng số byte thay đổi: mỗi byte dùng 7 bit thấp cho dữ liệu, bit cao nhất làm cờ "còn byte nữa". Số nhỏ tốn ít byte:
a=1:    08 01      // 1 <= 127 -> 1 byte value
a=300:  08 ac 02   // 300 > 127 -> 2 byte value
Khác với int cố định (luôn 4 hoặc 8 byte bất kể giá trị), varint làm số nhỏ — thường gặp nhất — cực gọn. Một ID 5 tốn 1 byte thay vì 4.
Cạm bẫy thật: int32 âm tốn 11 byte
Đây là phần quan trọng nhất và ít người biết. Đo thật hai cách mã số -1:
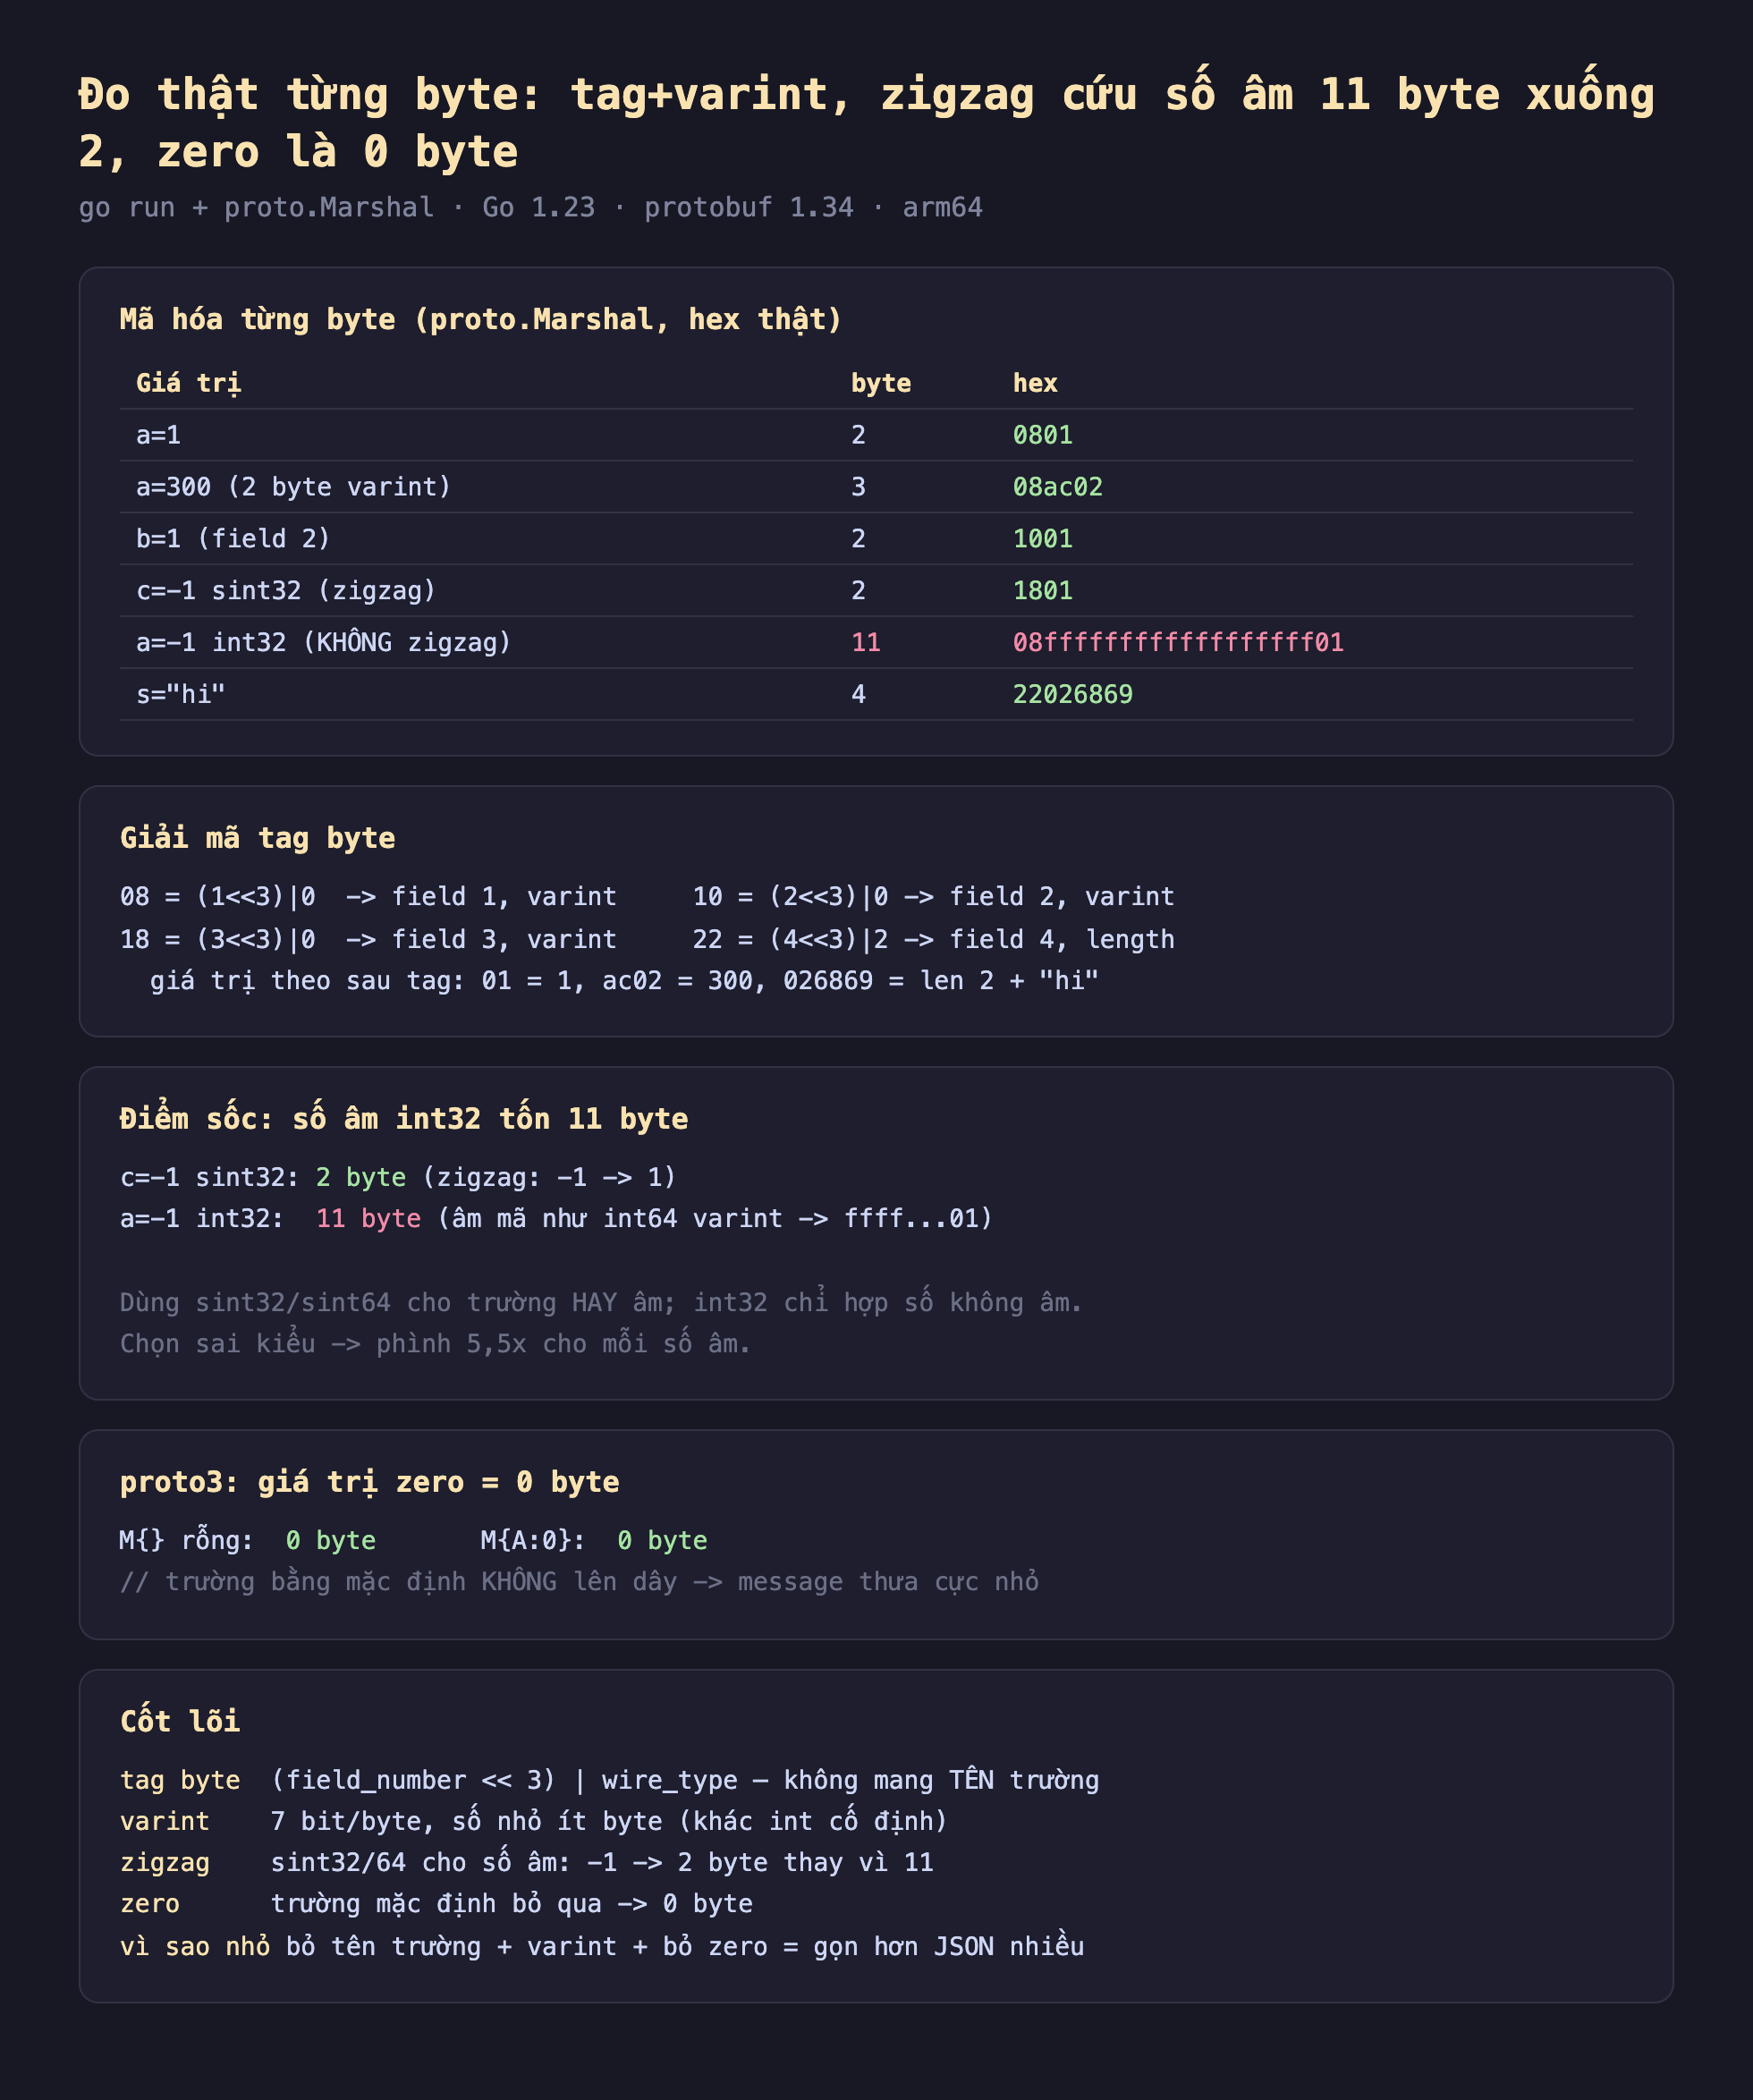
Hình 2: Hex thật từ proto.Marshal. c=-1 kiểu sint32 (zigzag): 2 byte (1801). a=-1 kiểu int32 (không zigzag): 11 byte (08ffffffffffffffffff01) — vì số âm được mã như int64 varint, luôn dùng tối đa 10 byte value + 1 tag.
- c=-1 kiểu sint32 (zigzag):
18 01— 2 byte. - a=-1 kiểu int32 (không zigzag):
08 ff ff ff ff ff ff ff ff ff 01— 11 byte!
Vì sao? Varint chuẩn không hiệu quả với số âm: -1 khi mã như int64 varint có tất cả bit cao là 1, nên tốn tối đa 10 byte. zigzag (dùng bởi sint32/sint64) ánh xạ số âm nhỏ về số dương nhỏ trước khi mã varint: 0→0, -1→1, 1→2, -2→3... — nhờ đó -1 chỉ tốn 2 byte. Bài học thực tế: dùng sint32/sint64 cho trường hay mang giá trị âm (offset, delta, tọa độ); int32/int64 chỉ hợp khi số gần như luôn không âm (ID, count). Chọn sai kiểu làm mỗi số âm phình ~5,5 lần.
proto3 bỏ trường giá trị zero
Một tối ưu nữa: trong proto3, trường có giá trị mặc định (zero) không được ghi lên dây:
M{} (mọi field zero):  0 byte
M{A: 0}:               0 byte
Một message toàn giá trị mặc định mã hóa thành 0 byte. Điều này khiến message thưa (nhiều trường zero) cực nhỏ. Đổi lại: proto3 không phân biệt được "chưa set" với "set = 0" cho kiểu vô hướng — nếu cần phân biệt, dùng optional (từ proto3.15) hoặc wrapper type.
Đánh đổi cần cân nhắc
Số thứ tự trường nhỏ (1-15) tốn tag 1 byte, từ 16 trở lên tốn 2 byte. Vì tag là (field << 3) | wire_type, field 1-15 vừa trong một byte varint, field 16+ cần hai. Đặt các trường dùng thường xuyên nhất vào số 1-15 để tiết kiệm một byte mỗi lần xuất hiện — đáng kể với message lặp nhiều lần.
Không bao giờ đổi số thứ tự trường sau khi phát hành. Số trường là hợp đồng nhị phân — đổi nó là phá vỡ mọi dữ liệu và client cũ. Đổi tên trường thì an toàn (tên không lên dây), nhưng đổi số hay kiểu wire type thì hỏng tương thích. Đây là lý do .proto khuyên "reserved" cho số trường đã bỏ.
Chọn kiểu số đúng ngữ nghĩa dữ liệu. Ngoài int32/sint32, còn fixed32/fixed64 (luôn 4/8 byte, không varint) — hợp khi số thường lớn (hash, số ngẫu nhiên), vì varint của số lớn tốn 5-10 byte còn fixed luôn 4-8. Quy tắc: varint cho số nhỏ, fixed cho số lớn/ngẫu nhiên, sint cho số hay âm.
Ba ý mang về
- Protobuf mã mỗi trường bằng tag byte
(field_number << 3) | wire_type+ giá trị, không mang tên trường (tên sống trong.proto) — đo thậta=1là0801,s="hi"là22026869; đây là lý do lớn protobuf nhỏ hơn JSON. - Varint co giãn theo giá trị (7 bit/byte, số nhỏ ít byte), nhưng số âm là cạm bẫy: đo thật
int32-1tốn 11 byte trong khisint32(zigzag) chỉ 2 byte — dùng sint32/sint64 cho trường hay âm, sai kiểu phình ~5,5 lần. - proto3 bỏ trường giá trị zero (message toàn mặc định = 0 byte, đo thật) — cực gọn cho message thưa; và nhớ đặt trường hay dùng vào số 1-15 (tag 1 byte), không bao giờ đổi số trường sau phát hành.
Bài tập làm thử
Bài 1 (đọc hiểu). Cho công thức tag = (field_number << 3) | wire_type. Giải mã tag byte 0x22 (thập phân 34): field number là bao nhiêu, wire type là gì, và nó ứng với loại dữ liệu nào?
Đáp án
0x22 = 34 (thập phân) = nhị phân 00100010. Dịch phải 3 bit: 34 >> 3 = 4 → field number = 4. Ba bit thấp: 34 & 0b111 = 2 → wire type = 2 (length-delimited). Đúng như bài viết: 22 = (4<<3)|2 -> field 4, wire type 2, ứng với chuỗi, bytes, hoặc message con — ví dụ s="hi" được mã 22 02 68 69 (tag, độ dài 2, rồi "hi").
Bài 2 (sửa lỗi). Một lập trình viên định nghĩa trường tọa độ có thể âm/dương trong .proto nhưng chọn sai kiểu, khiến message phình to bất thường khi giá trị âm:
message ToaDo {
  int32 x = 1; // thường mang giá trị âm (bên trái gốc tọa độ)
  int32 y = 2;
}
Sửa lại .proto cho đúng, và giải thích vì sao kiểu cũ gây lãng phí.
Đáp án
message ToaDo {
  sint32 x = 1; // dùng sint32 (zigzag) cho trường hay mang giá trị âm
  sint32 y = 2;
}
Với int32 (không zigzag), một giá trị âm như -1 được mã hóa như varint của int64, có tất cả bit cao là 1, nên tốn tới 11 byte (đo thật: 08ffffffffffffffffff01). Với sint32, zigzag ánh xạ số âm nhỏ về số dương nhỏ trước khi mã varint (-1→1), nên chỉ tốn 2 byte. Với trường tọa độ thường xuyên âm, dùng int32 sẽ phình gấp ~5,5 lần mỗi lần giá trị âm xuất hiện.
Bài 3 (vận dụng). Cho message message M { int32 a = 1; }. Viết ra chuỗi byte hex (dạng bài viết trình bày) khi M{A: 0} được marshal trong proto3, và giải thích vì sao.
Đáp án
Kết quả: 0 byte (không có byte nào được ghi). Vì trong proto3, trường có giá trị mặc định (zero cho kiểu số, chuỗi rỗng, v.v.) không được ghi lên dây — đúng như bài viết đo thật: M{A: 0} cho ra 0 byte, y hệt M{} rỗng. Đây là tối ưu giúp message thưa (nhiều trường ở giá trị mặc định) cực nhỏ, nhưng đổi lại proto3 không phân biệt được "chưa set" với "set = 0" cho kiểu vô hướng trừ khi dùng optional hoặc wrapper type.
Bài 4 (bẫy/đánh đổi). Một đội đã phát hành .proto với message SanPham { string ten = 1; int32 gia = 2; } ra production. Sau đó họ muốn đổi số thứ tự trường gia từ 2 thành 5 để "dọn lại cho gọn". Vì sao đây là quyết định nguy hiểm?
Đáp án
Số thứ tự trường là hợp đồng nhị phân trên dây — nó chính là phần được mã hóa trong tag byte ((field_number << 3) | wire_type), không phải tên trường. Đổi số trường từ 2 sang 5 nghĩa là dữ liệu cũ đã lưu/gửi với tag của field 2 sẽ không còn khớp với field mới (field 5) ở phía đọc — phá vỡ khả năng đọc dữ liệu cũ và giao tiếp với client cũ chưa cập nhật. Bài viết nhấn mạnh: "không bao giờ đổi số thứ tự trường sau khi phát hành" — đổi tên trường thì an toàn (tên không lên dây), nhưng đổi số hay wire type thì hỏng tương thích. Cách đúng nếu muốn "dọn" là dùng reserved để đánh dấu số cũ không tái sử dụng.
Bài 5 (đọc hiểu/đánh đổi). Bài viết khuyên "đặt các trường dùng thường xuyên nhất vào số 1-15" và gợi ý dùng fixed32/fixed64 cho "số thường lớn (hash, số ngẫu nhiên)". Giải thích cả hai lời khuyên bằng cơ chế mã hóa đã học.
Đáp án
(1) Trường số 1-15 vừa gọn trong tag byte 1-byte (vì field << 3 với field ≤ 15 vẫn nằm trong phạm vi biểu diễn bằng 1 byte varint cùng 3 bit wire type), còn từ 16 trở lên tag cần 2 byte — nên đặt trường hay xuất hiện nhất vào số nhỏ để tiết kiệm 1 byte mỗi lần trường đó xuất hiện, đáng kể khi message được gửi lặp nhiều lần. (2) fixed32/fixed64 luôn dùng đúng 4/8 byte cố định, không co giãn theo giá trị như varint; với số lớn (hash, số ngẫu nhiên, gần lấp đầy 32/64 bit), varint sẽ tốn 5-10 byte (gần hoặc vượt kích thước fixed), nên dùng fixed sẽ nhỏ hơn hoặc bằng, còn varint chỉ có lợi thế khi số nhỏ.
Phần sau ta xuống tầng vận chuyển mà gRPC dựa lên: Phần sau mổ xẻ HTTP/2 multiplexing — cách nhiều request chia sẻ một kết nối qua các stream song song, và vì sao nó xóa bỏ head-of-line blocking của HTTP/1.1.
