Cách lưu dữ liệu thông thường lưu trạng thái hiện tại: tài khoản có số dư 400. Nhưng thông tin "làm sao đến được 400" bị mất — nạp bao nhiêu, rút bao nhiêu, khi nào. Event sourcing lật ngược điều này: thay vì lưu trạng thái, ta lưu chuỗi sự kiện bất biến đã dẫn tới trạng thái đó, và dựng lại trạng thái bằng cách phát lại (replay) chúng. Bài trước ta thấy CQRS (thường đi kèm event sourcing nhưng độc lập); bài này mổ xẻ chính event sourcing: cơ chế, lợi ích truy vết, và snapshot — thứ giữ cho nó không chậm dần theo thời gian.
Sự kiện là sự thật bất biến
Trong event sourcing, mỗi thay đổi trạng thái là một sự kiện — một sự thật đã xảy ra trong quá khứ, không bao giờ sửa hay xóa. Mỗi sự kiện biết cách áp chính nó lên trạng thái:
type Event interface{ apply(*TaiKhoan) }
type MoTaiKhoan struct{ Chu string }
type NapTien struct{ SoTien int }
type RutTien struct{ SoTien int }

func (e NapTien) apply(t *TaiKhoan) { t.SoDu += e.SoTien }
func (e RutTien) apply(t *TaiKhoan) { t.SoDu -= e.SoTien }
Điểm mấu chốt: trạng thái không được lưu. TaiKhoan{SoDu: 400} không nằm ở đâu cả — nó được dựng lại bằng cách phát lại toàn bộ sự kiện lên một trạng thái rỗng. Event store chỉ append, không bao giờ sửa:
type Store struct{ events []Event }
func (s *Store) Ghi(e Event) { s.events = append(s.events, e) }

func (s *Store) DungLai() *TaiKhoan { // replay
	t := &TaiKhoan{}
	for _, e := range s.events { e.apply(t) } // gấp từng sự kiện
	return t
}
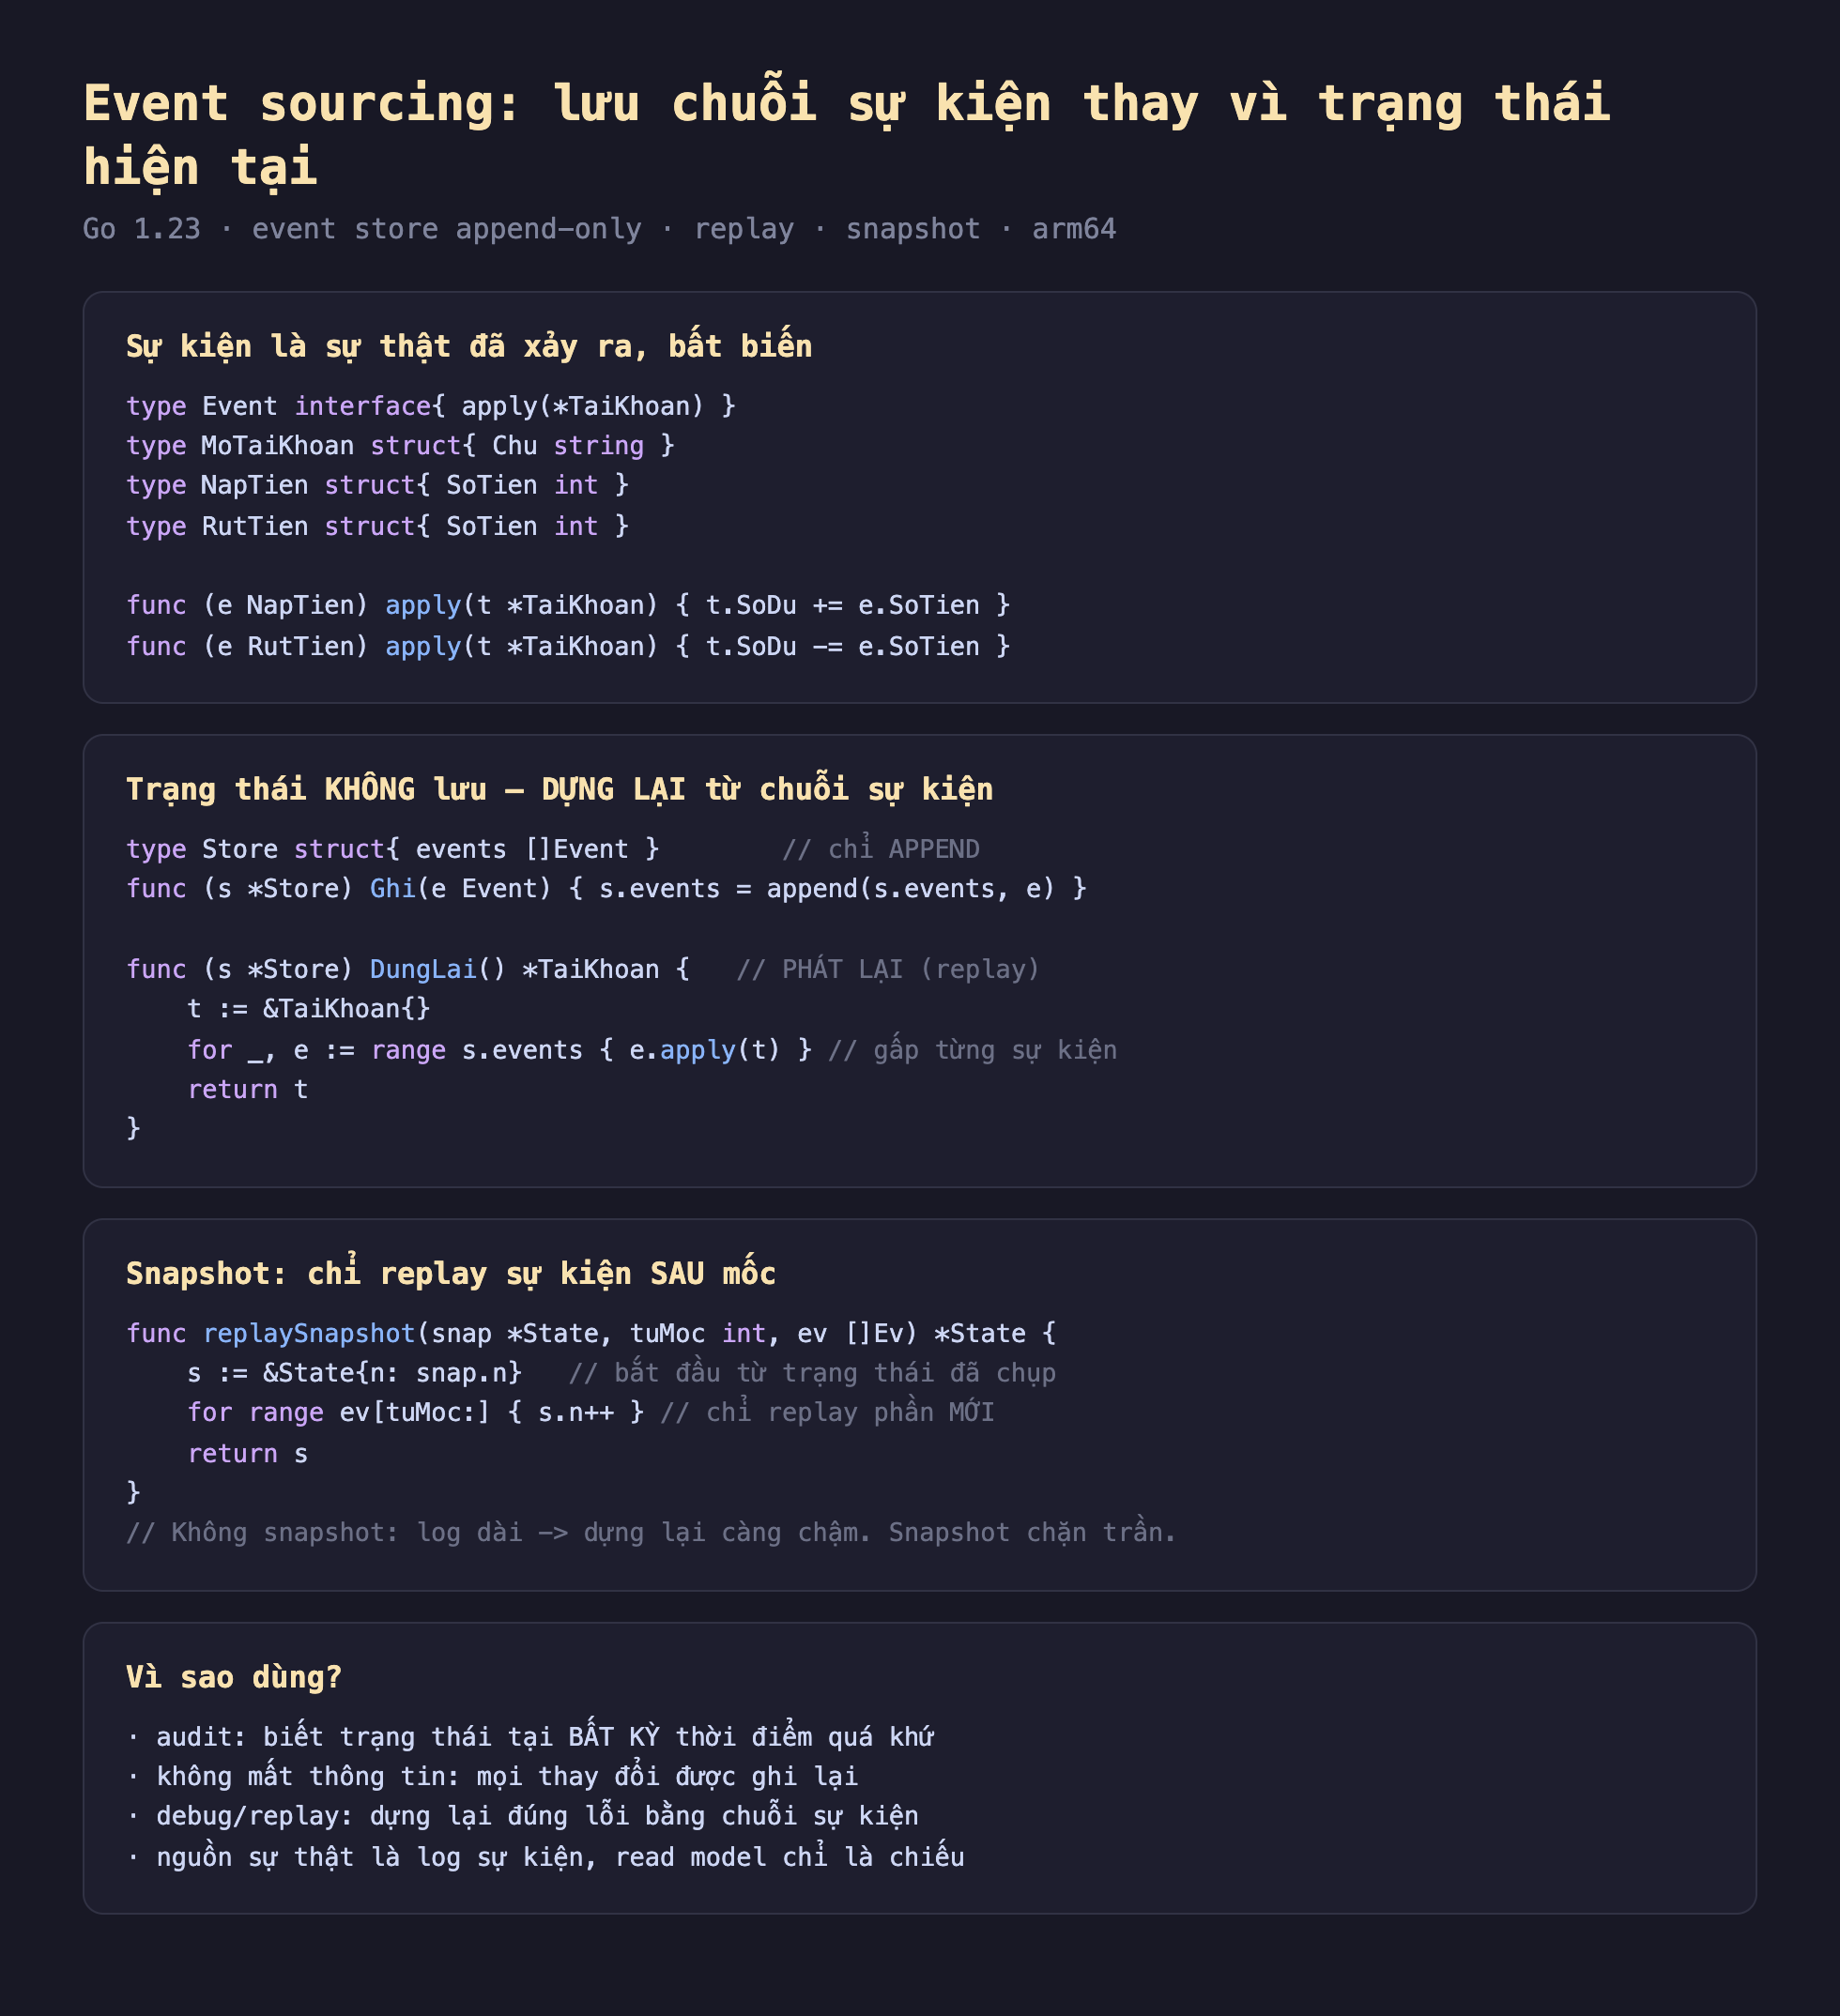
Hình 1: Sự kiện (MoTaiKhoan, NapTien, RutTien) là sự thật bất biến, mỗi cái biết apply lên trạng thái. Store chỉ append; DungLai replay toàn bộ để dựng trạng thái. Snapshot chỉ replay sự kiện sau một mốc đã chụp.
Đo thật: dựng lại và truy vết lịch sử
Chạy thật trong go-lab (Go 1.23): ghi MoTaiKhoan An, NapTien 500, RutTien 200, NapTien 100, rồi dựng lại:
Trạng thái hiện tại: {Chu:An SoDu:400 Mo:true}
Lịch sử (replay từng bước):
  sau sự kiện 2 (NapTien): số dư = 500
  sau sự kiện 3 (RutTien): số dư = 300
  sau sự kiện 4 (NapTien): số dư = 400
Số dư 400 được dựng lại đúng (500−200+100). Nhưng đây mới là sức mạnh thật: vì ta có toàn bộ chuỗi sự kiện, ta biết trạng thái tại bất kỳ thời điểm nào trong quá khứ — chỉ cần replay tới sự kiện thứ N. Với hệ tài chính, kiểm toán, hay bất cứ nơi nào cần "trạng thái tại thời điểm X", đây là tính năng không thể có với lưu trạng thái thông thường. Không thông tin nào bị mất; mọi thay đổi là một bản ghi vĩnh viễn.
Snapshot: chặn trần chi phí replay
Vấn đề rõ ràng của replay: log càng dài, dựng lại càng chậm — vì phải phát lại mọi sự kiện từ đầu. Giải pháp là snapshot: chụp trạng thái tại một mốc định kỳ, và chỉ replay các sự kiện sau mốc đó:
func replaySnapshot(snap *State, tuMoc int, ev []Ev) *State {
	s := &State{n: snap.n}      // bắt đầu từ trạng thái đã chụp
	for range ev[tuMoc:] { s.n++ } // chỉ replay phần MỚI
	return s
}
Đo thật với 100.000 sự kiện:
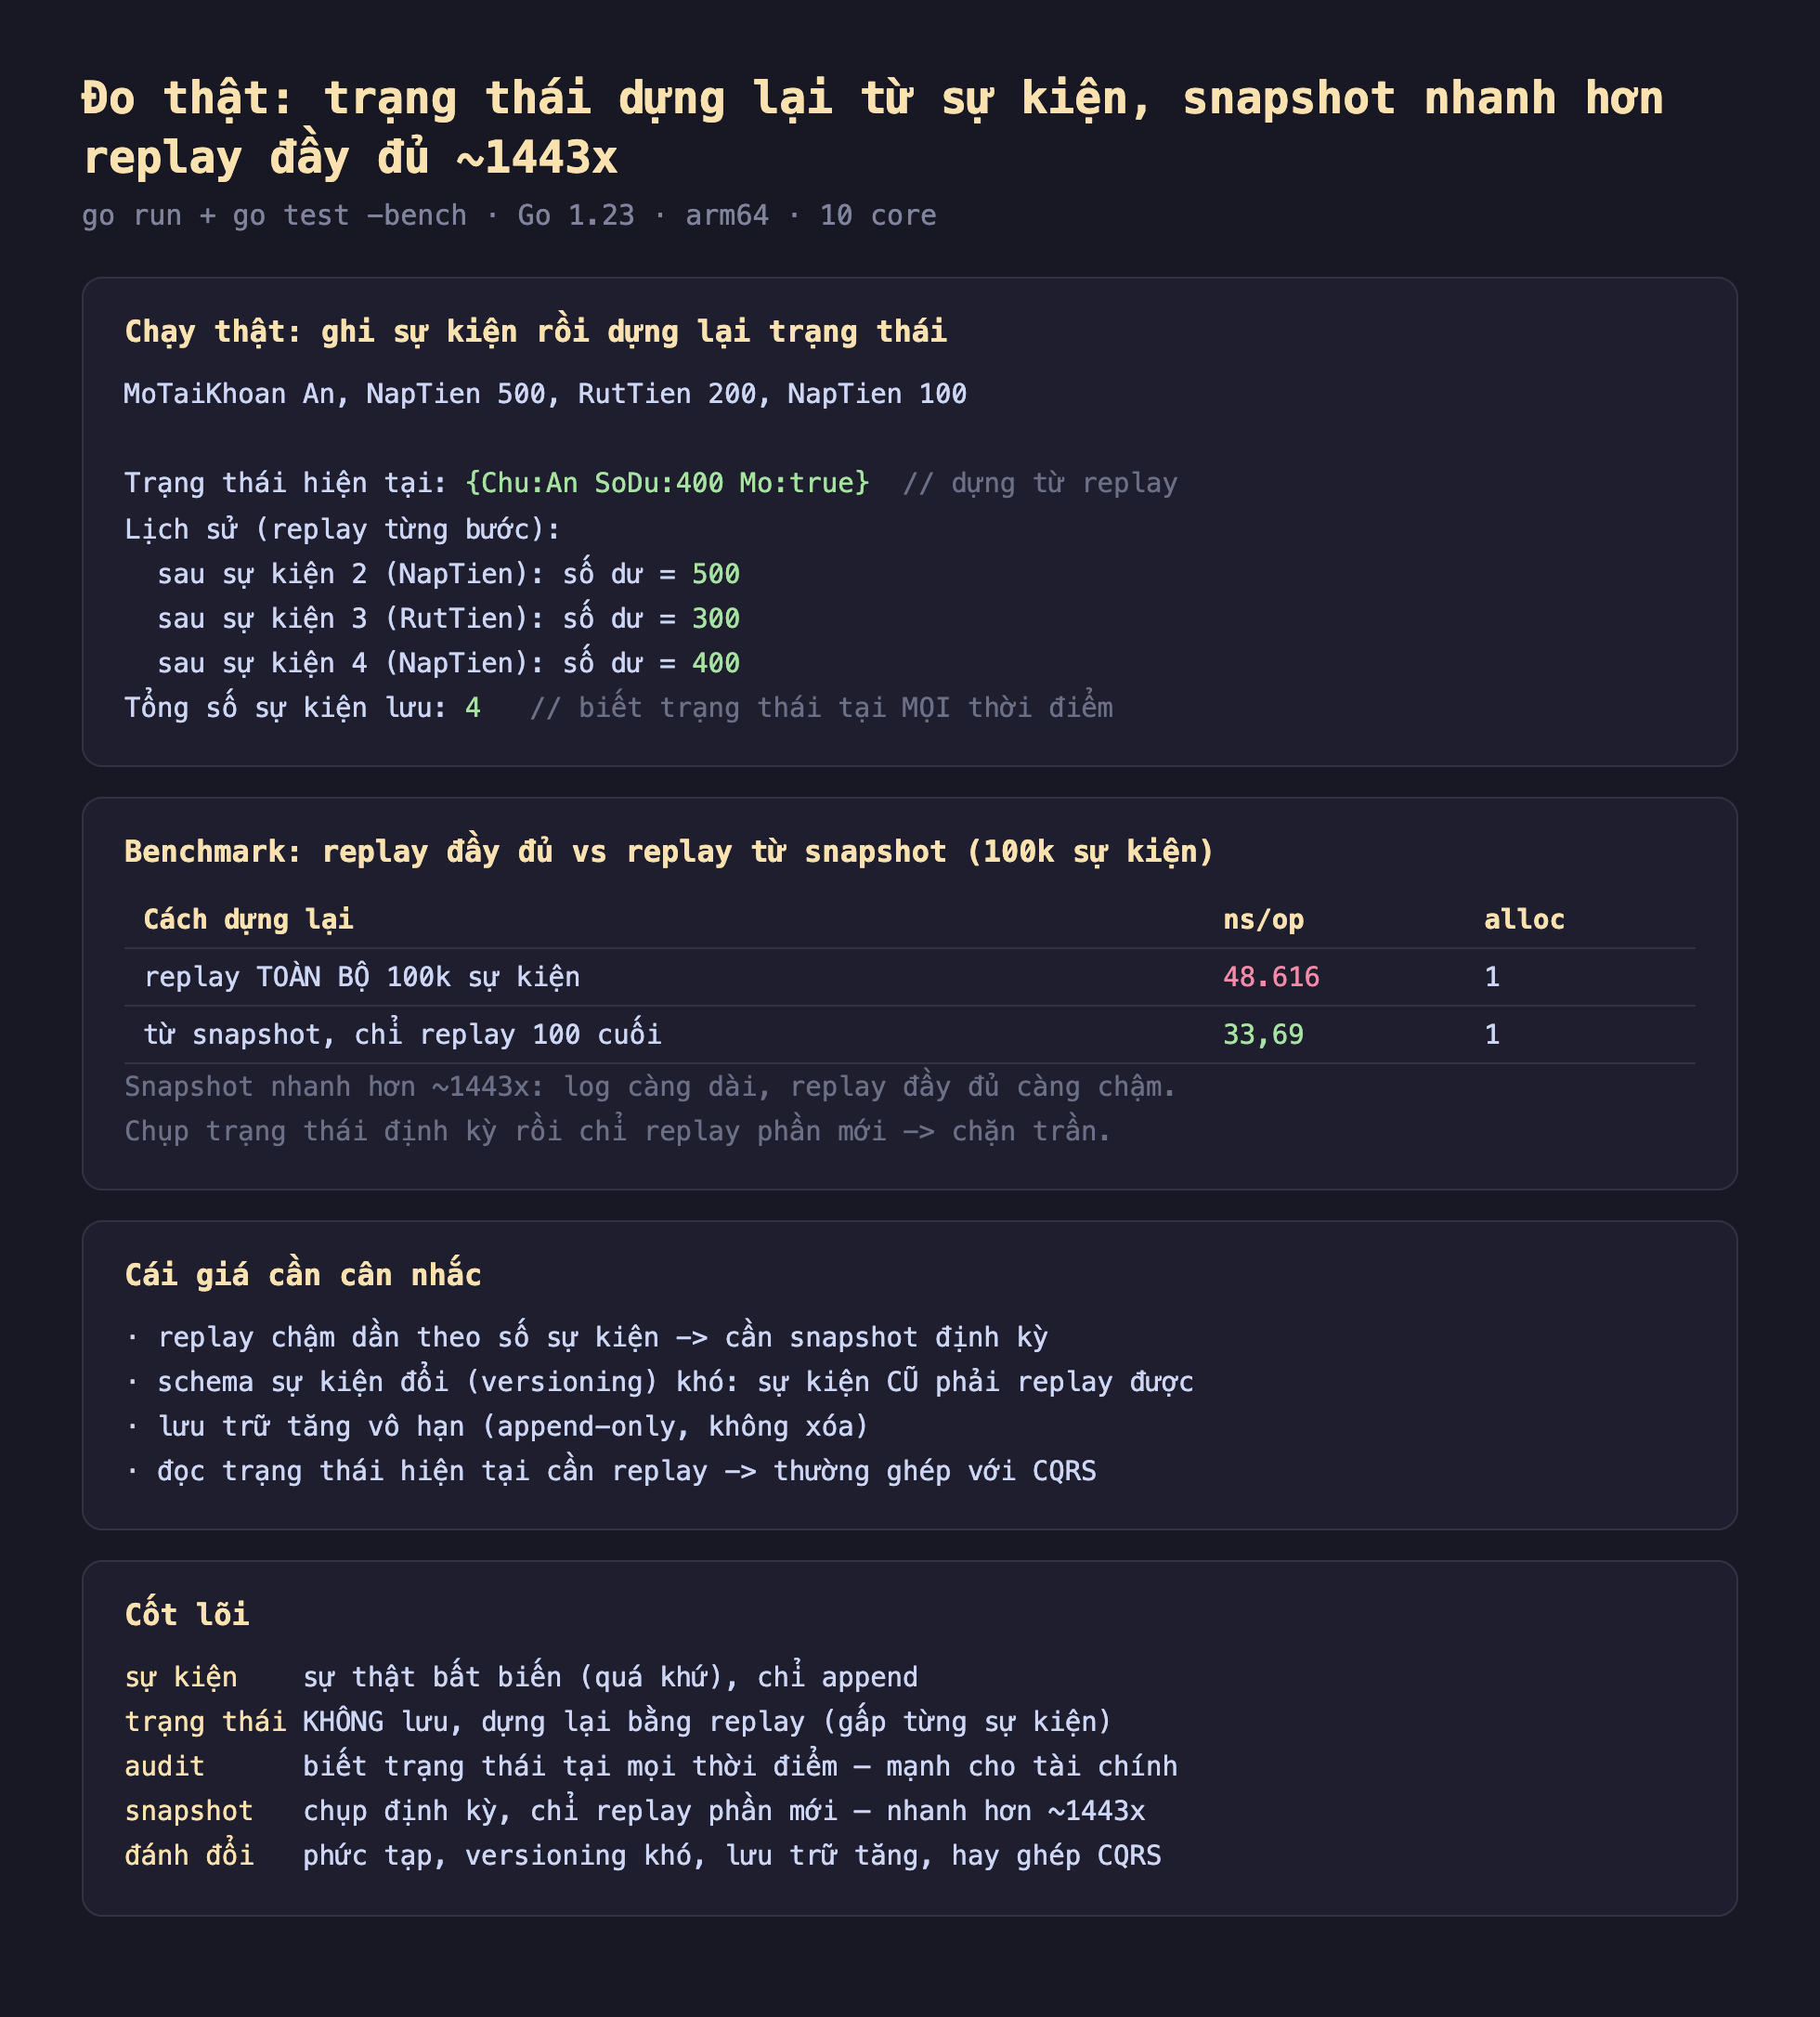
Hình 2: Trạng thái dựng lại đúng (SoDu 400) và biết lịch sử tại mọi bước. Benchmark: replay toàn bộ 100k sự kiện 48.616 ns so với replay từ snapshot (chỉ 100 sự kiện cuối) 33,69 ns — nhanh hơn ~1443 lần.
- replay toàn bộ 100k sự kiện: 48.616 ns/op.
- từ snapshot, chỉ replay 100 cuối: 33,69 ns/op.
Nhanh hơn ~1443 lần. Nếu không snapshot, một tài khoản hoạt động 10 năm với hàng triệu sự kiện sẽ mất rất lâu để dựng lại mỗi lần. Snapshot chặn trần chi phí: dù log dài bao nhiêu, bạn chỉ replay từ snapshot gần nhất. Đây là kỹ thuật bắt buộc cho event sourcing thực tế.
Đánh đổi cần cân nhắc
Tiến hóa schema sự kiện (versioning) là chỗ khó nhất. Vì bạn phải replay mọi sự kiện từ quá khứ, một sự kiện NapTien ghi 5 năm trước phải vẫn replay được hôm nay — kể cả khi bạn đã đổi cấu trúc. Bạn không thể "migrate" chúng dễ như một bảng SQL; phải giữ khả năng đọc mọi phiên bản sự kiện cũ, hoặc dùng upcasting (chuyển sự kiện cũ sang định dạng mới lúc đọc). Đây là gánh nặng dài hạn, và là lý do event sourcing không nên dùng bừa.
Lưu trữ tăng vô hạn và đọc phức tạp hơn. Event store chỉ append, không xóa — dung lượng tăng mãi (cần chiến lược lưu trữ lạnh/nén). Và đọc trạng thái hiện tại luôn cần replay (hoặc snapshot), nên event sourcing gần như luôn ghép với CQRS: log sự kiện là nguồn sự thật cho ghi, còn một read model (chiếu từ sự kiện) phục vụ đọc nhanh. Hai mẫu này bổ trợ nhau chặt chẽ.
Chỉ dùng khi truy vết là yêu cầu thật. Event sourcing tỏa sáng ở domain mà lịch sử là dữ liệu nghiệp vụ: tài chính (mọi giao dịch phải truy vết), kho vận, hệ thống kiểm toán, hoặc bất cứ nơi nào "tại sao đến trạng thái này" quan trọng như chính trạng thái. Với CRUD thông thường mà chỉ cần trạng thái hiện tại, nó là phức tạp thừa khổng lồ — lưu trạng thái trực tiếp đơn giản hơn nhiều.
Ba ý mang về
- Event sourcing lưu chuỗi sự kiện bất biến thay vì trạng thái hiện tại: mỗi sự kiện là sự thật đã xảy ra, event store chỉ append, và trạng thái được dựng lại bằng replay (gấp từng sự kiện lên trạng thái rỗng) — đo thật số dư 400 dựng từ chuỗi nạp/rút.
- Lợi ích cốt lõi là truy vết toàn bộ lịch sử: biết trạng thái tại bất kỳ thời điểm nào trong quá khứ (replay tới sự kiện N), không mất thông tin nào — mạnh cho tài chính và kiểm toán mà lưu trạng thái thông thường không có.
- Snapshot chặn trần chi phí replay: đo thật replay toàn bộ 100k sự kiện 48.616 ns so với replay từ snapshot 33,69 ns (~1443 lần) — bắt buộc cho hệ thực tế; nhưng versioning sự kiện khó, lưu trữ tăng vô hạn, và thường phải ghép với CQRS.
Bài tập làm thử
Bài 1 (đọc hiểu). Cho chuỗi sự kiện đã ghi: MoTaiKhoan An, NapTien 500, RutTien 200, NapTien 100. Tính số dư sau khi DungLai() chạy, và giải thích từng bước.
func (e NapTien) apply(t *TaiKhoan) { t.SoDu += e.SoTien }
func (e RutTien) apply(t *TaiKhoan) { t.SoDu -= e.SoTien }
Đáp án
Số dư cuối = 400. DungLai() bắt đầu từ TaiKhoan{} rỗng (SoDu=0), rồi lần lượt apply từng sự kiện: sau NapTien 500 → SoDu=500; sau RutTien 200 → SoDu=300; sau NapTien 100 → SoDu=400. Trạng thái không được lưu trực tiếp ở đâu — nó luôn được dựng lại bằng cách replay toàn bộ sự kiện từ đầu.
Bài 2 (sửa lỗi). Đoạn mã sau cố "sửa" một sự kiện đã ghi để chỉnh lại số dư, vi phạm nguyên tắc cốt lõi của event sourcing:
func (s *Store) SuaSuKien(idx int, moi Event) {
	s.events[idx] = moi // ghi đè sự kiện cũ
}
Vì sao đây là sai, và cách đúng để "sửa" một giao dịch nhầm là gì?
Đáp án
Sai vì sự kiện trong event sourcing là "sự thật bất biến" — không bao giờ được sửa hay xóa, event store chỉ append. Ghi đè s.events[idx] phá vỡ tính bất biến này và làm mất khả năng truy vết đúng lịch sử thật đã xảy ra. Cách đúng: thêm một sự kiện bù trừ mới (ví dụ RutTien để hoàn lại một NapTien sai), append vào cuối chuỗi — lịch sử vẫn giữ nguyên "đã có một giao dịch sai, và sau đó đã sửa", đúng tinh thần append-only.
Bài 3 (vận dụng). Viết một sự kiện mới DoiChu{ChuMoi string} để đổi tên chủ tài khoản, cùng phương thức apply của nó, sao cho tương thích với interface Event.
Đáp án
type DoiChu struct{ ChuMoi string }

func (e DoiChu) apply(t *TaiKhoan) { t.Chu = e.ChuMoi }
Nhờ Go dùng duck typing, DoiChu tự động thỏa Event (interface{ apply(*TaiKhoan) }) chỉ cần có đúng phương thức apply. Ghi sự kiện này bằng store.Ghi(DoiChu{ChuMoi: "Bình"}), và DungLai() sẽ áp nó vào đúng vị trí trong chuỗi replay.
Bài 4 (bẫy/đánh đổi). Đo thật cho thấy replay từ snapshot (33,69 ns) nhanh hơn replay toàn bộ 100k sự kiện (48.616 ns) khoảng 1443 lần. Nếu một tài khoản hoạt động 10 năm mà hệ thống không bao giờ chụp snapshot, điều gì sẽ xảy ra, và snapshot giải quyết vấn đề đó ra sao?
Đáp án
Không snapshot nghĩa là mỗi lần cần đọc trạng thái hiện tại, hệ thống phải phát lại (replay) toàn bộ hàng triệu sự kiện tích lũy trong 10 năm từ đầu — thời gian dựng lại tăng dần theo độ dài log và cuối cùng trở nên rất chậm. Snapshot giải quyết bằng cách chụp trạng thái tại một mốc định kỳ, sau đó chỉ cần replay các sự kiện sau mốc đó (ev[tuMoc:]) — chặn trần chi phí replay ở một hằng số nhỏ, bất kể log tổng cộng dài bao nhiêu.
Bài 5 (đọc hiểu/đánh đổi). Bài viết nói "tiến hóa schema sự kiện (versioning) là chỗ khó nhất". Vì sao một sự kiện NapTien ghi 5 năm trước lại gây khó khăn khi đội phát triển muốn đổi cấu trúc struct của nó?
Đáp án
Vì event sourcing yêu cầu phải replay được mọi sự kiện từ quá khứ để dựng lại trạng thái hiện tại — không thể "migrate" dữ liệu sự kiện cũ dễ dàng như một bảng SQL (đổi cột, thêm ràng buộc). Nếu đổi cấu trúc NapTien (ví dụ thêm trường bắt buộc), sự kiện cũ được lưu theo cấu trúc cũ vẫn phải đọc và apply được với code mới. Giải pháp là giữ khả năng đọc mọi phiên bản sự kiện cũ, hoặc dùng upcasting (chuyển sự kiện cũ sang định dạng mới ngay lúc đọc) — một gánh nặng dài hạn mà bài viết coi là lý do event sourcing "không nên dùng bừa".
Phần sau ta rời các mẫu kiến trúc lớn để về với cách mô hình hóa chính domain: Phần sau mổ xẻ Domain-Driven Design tactical patterns trong Go — entity, value object, aggregate — và cách Go thể hiện chúng khác với ngôn ngữ hướng đối tượng truyền thống.
