CQRS — Command Query Responsibility Segregation — là một trong những mẫu kiến trúc bị hiểu nhầm nhiều nhất. Nhiều người tưởng nó là event sourcing, hoặc phải dùng hai database. Thực ra ý tưởng cốt lõi rất đơn giản: tách đường ghi khỏi đường đọc để mỗi bên tối ưu cho mục đích của nó. Ghi cần đúng đắn và ràng buộc, nên dùng mô hình chuẩn hóa; đọc cần nhanh, nên dùng mô hình gộp sẵn (denormalized). Bài này dựng CQRS chạy được, đo thật lợi ích tốc độ đọc, và nói thẳng cái giá phải trả.
Hai bên: command và query
Trong CQRS, mọi thao tác thay đổi trạng thái là command (lệnh), mọi thao tác đọc là query (truy vấn), và chúng đi qua hai đường code khác nhau. Bên command dùng mô hình chuẩn hóa tối ưu cho tính đúng:
type Command interface{ ten() string }
type TaoDon struct{ ID int; Khach string; Tien int }
type HuyDon struct{ ID int }

func (h *CommandHandler) Xu(c Command) error {
	switch v := c.(type) {
	case TaoDon: h.ws.don[v.ID] = &donGhi{ID: v.ID, Khach: v.Khach, Tien: v.Tien}
	case HuyDon: if d, ok := h.ws.don[v.ID]; ok { d.Huy = true }
	}
	h.onChange() // CHIẾU sang read model sau mỗi lệnh
	return nil
}
Bên query dùng một read model đã gộp sẵn — ở đây là thống kê theo khách, dựng trước để đọc không phải tính lại:
type ThongKeKhach struct{ Khach string; TongTien int; SoDon int } // dựng SẴN

func (q *QueryHandler) TopKhach() []*ThongKeKhach {
	// chỉ đọc + sắp, KHÔNG duyệt từng đơn
}
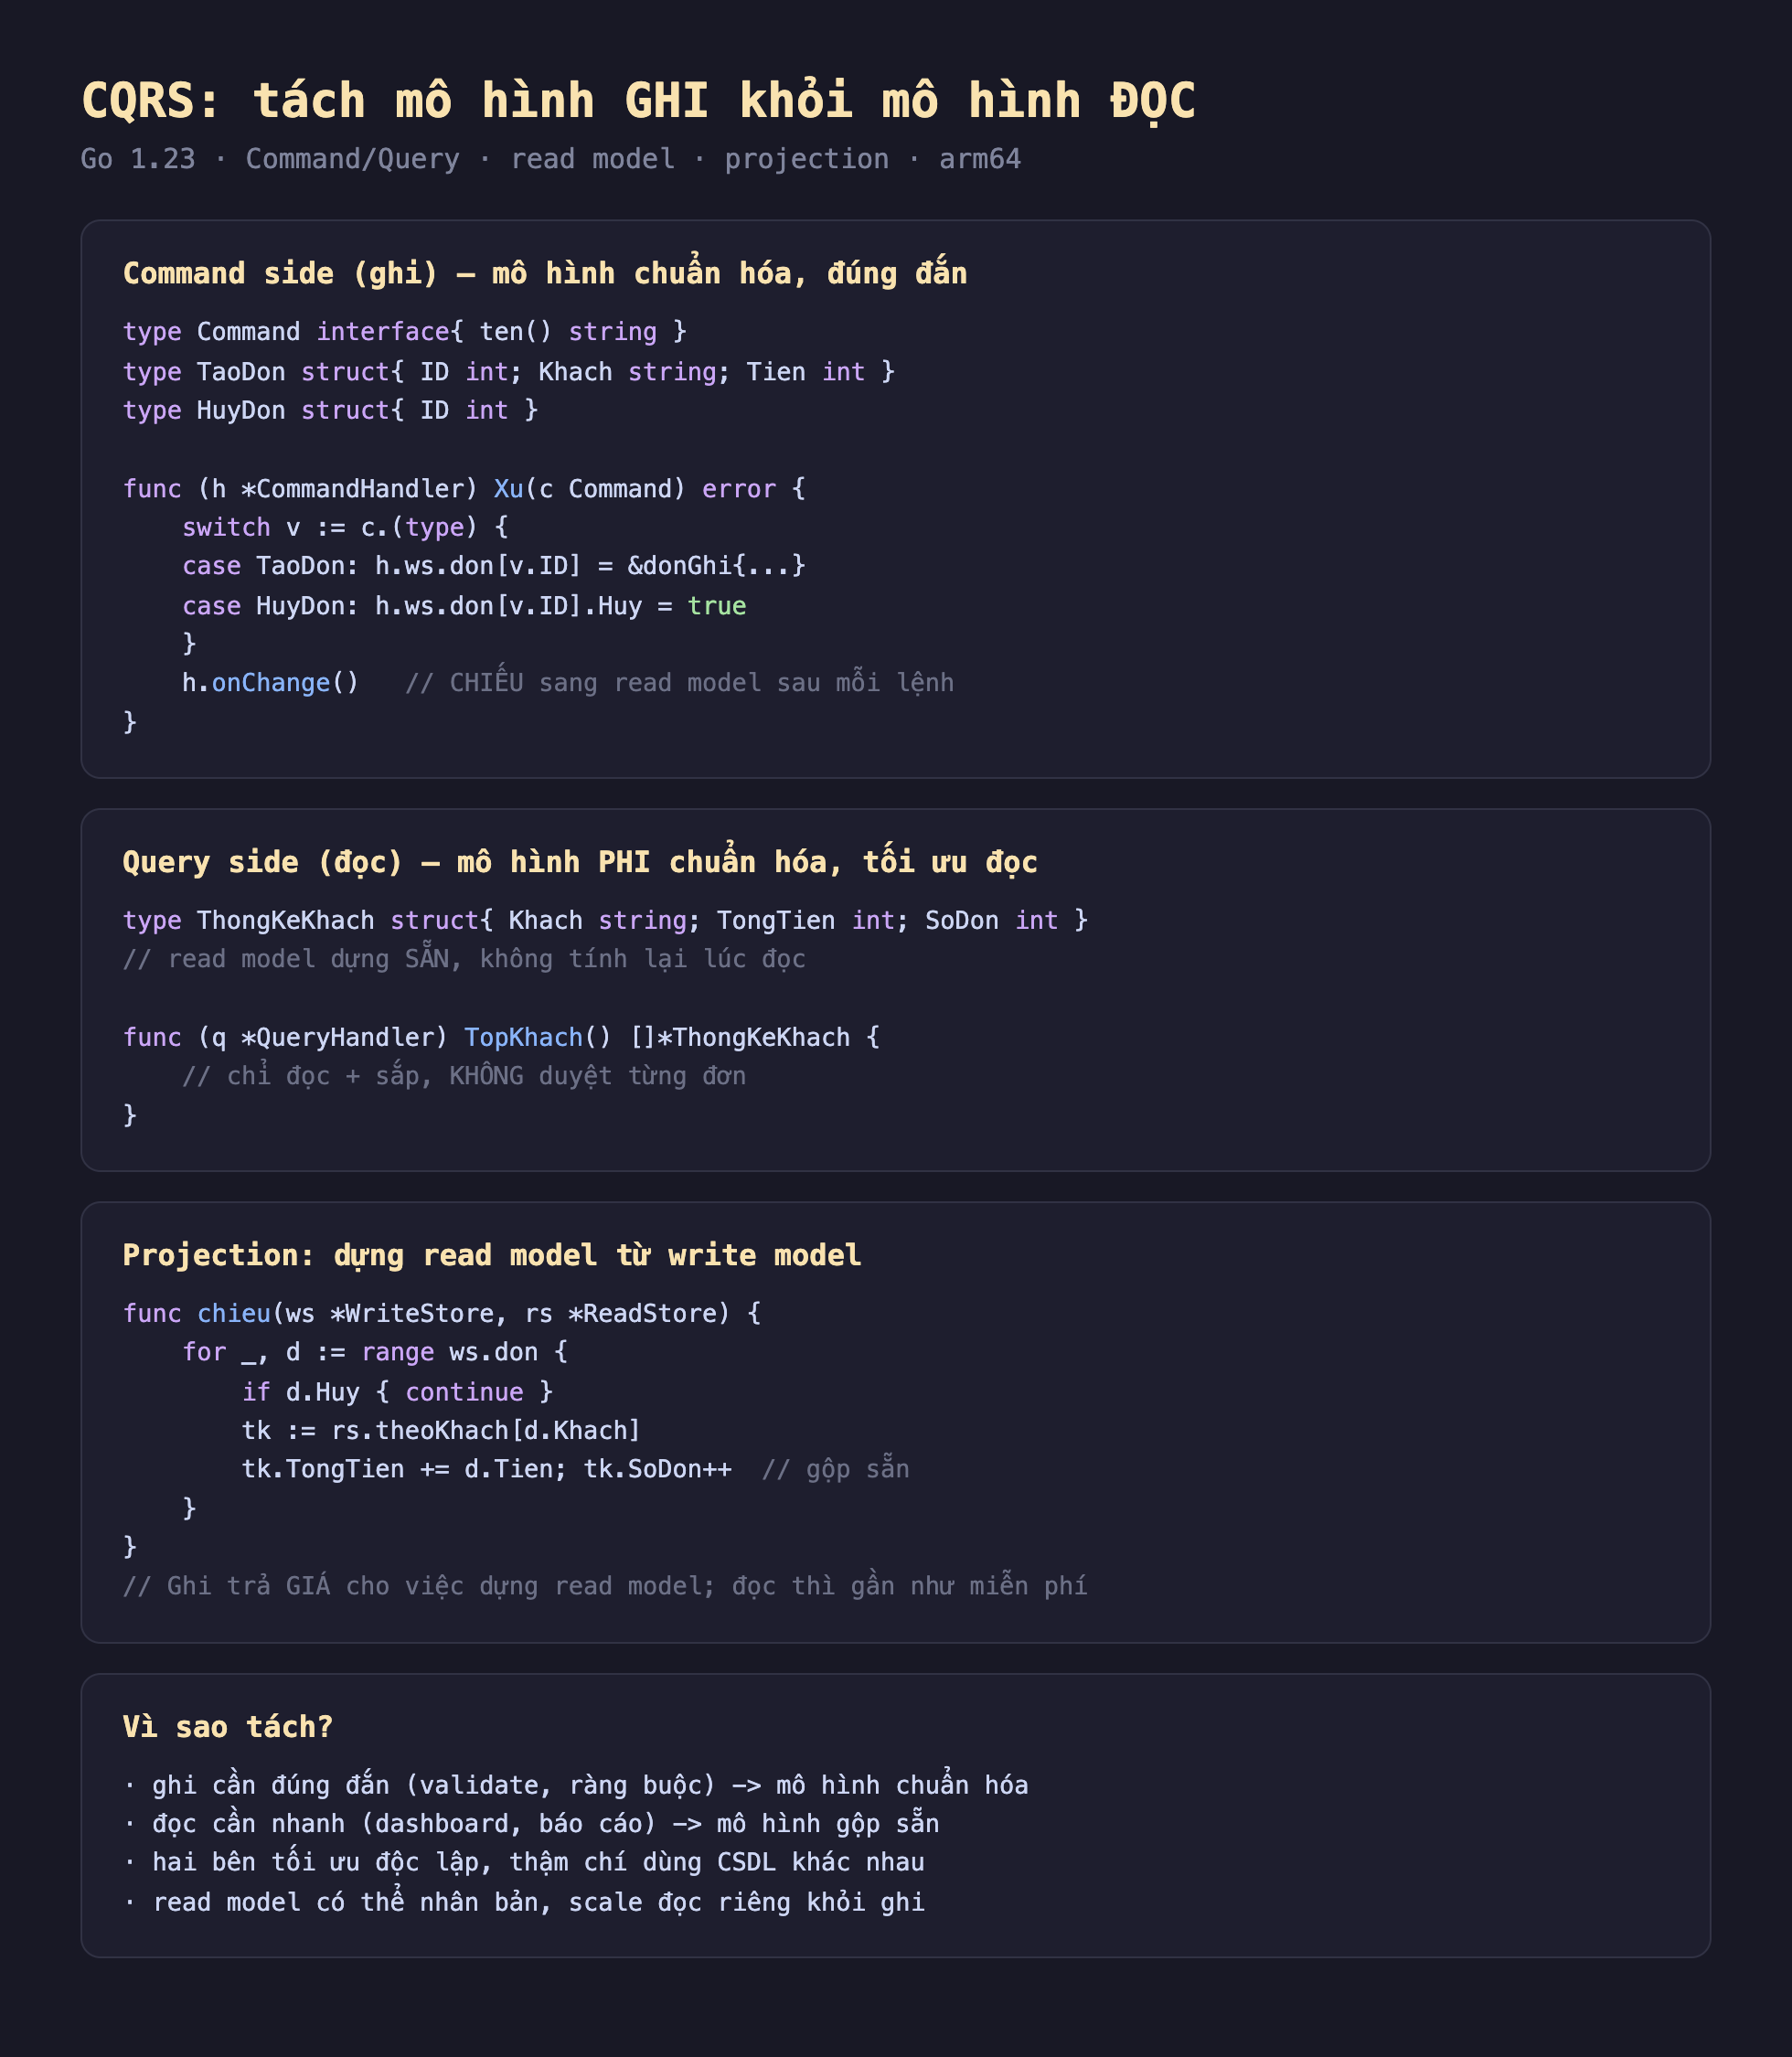
Hình 1: Bên command (TaoDon, HuyDon) dùng mô hình ghi chuẩn hóa; bên query dùng read model ThongKeKhach gộp sẵn. Sau mỗi lệnh, projection chiếu write model sang read model để đọc không phải tính lại.
Projection: cầu nối hai mô hình
Cái gắn hai bên lại là projection (phép chiếu): sau mỗi lệnh ghi, dựng lại (hoặc cập nhật) read model từ write model:
func chieu(ws *WriteStore, rs *ReadStore) {
	for _, d := range ws.don {
		if d.Huy { continue }
		tk := rs.theoKhach[d.Khach]
		tk.TongTien += d.Tien; tk.SoDon++ // gộp sẵn cho đọc
	}
}
Đo thật (Go 1.23): sau các lệnh TaoDon An 100, TaoDon Bình 250, TaoDon An 80, HuyDon(Bình), truy vấn TopKhach() trả An: tổng 180, 2 đơn — đúng (100+80), và Bình biến mất vì đơn đã hủy (projection loại đơn Huy). Read model luôn phản ánh trạng thái sau mỗi lệnh.
Đo thật: đọc từ read model nhanh hơn ~328 lần
Đây là lý do CQRS tồn tại. So đọc từ read model dựng sẵn với việc tính lại từ write model (100.000 đơn) mỗi lần truy vấn:
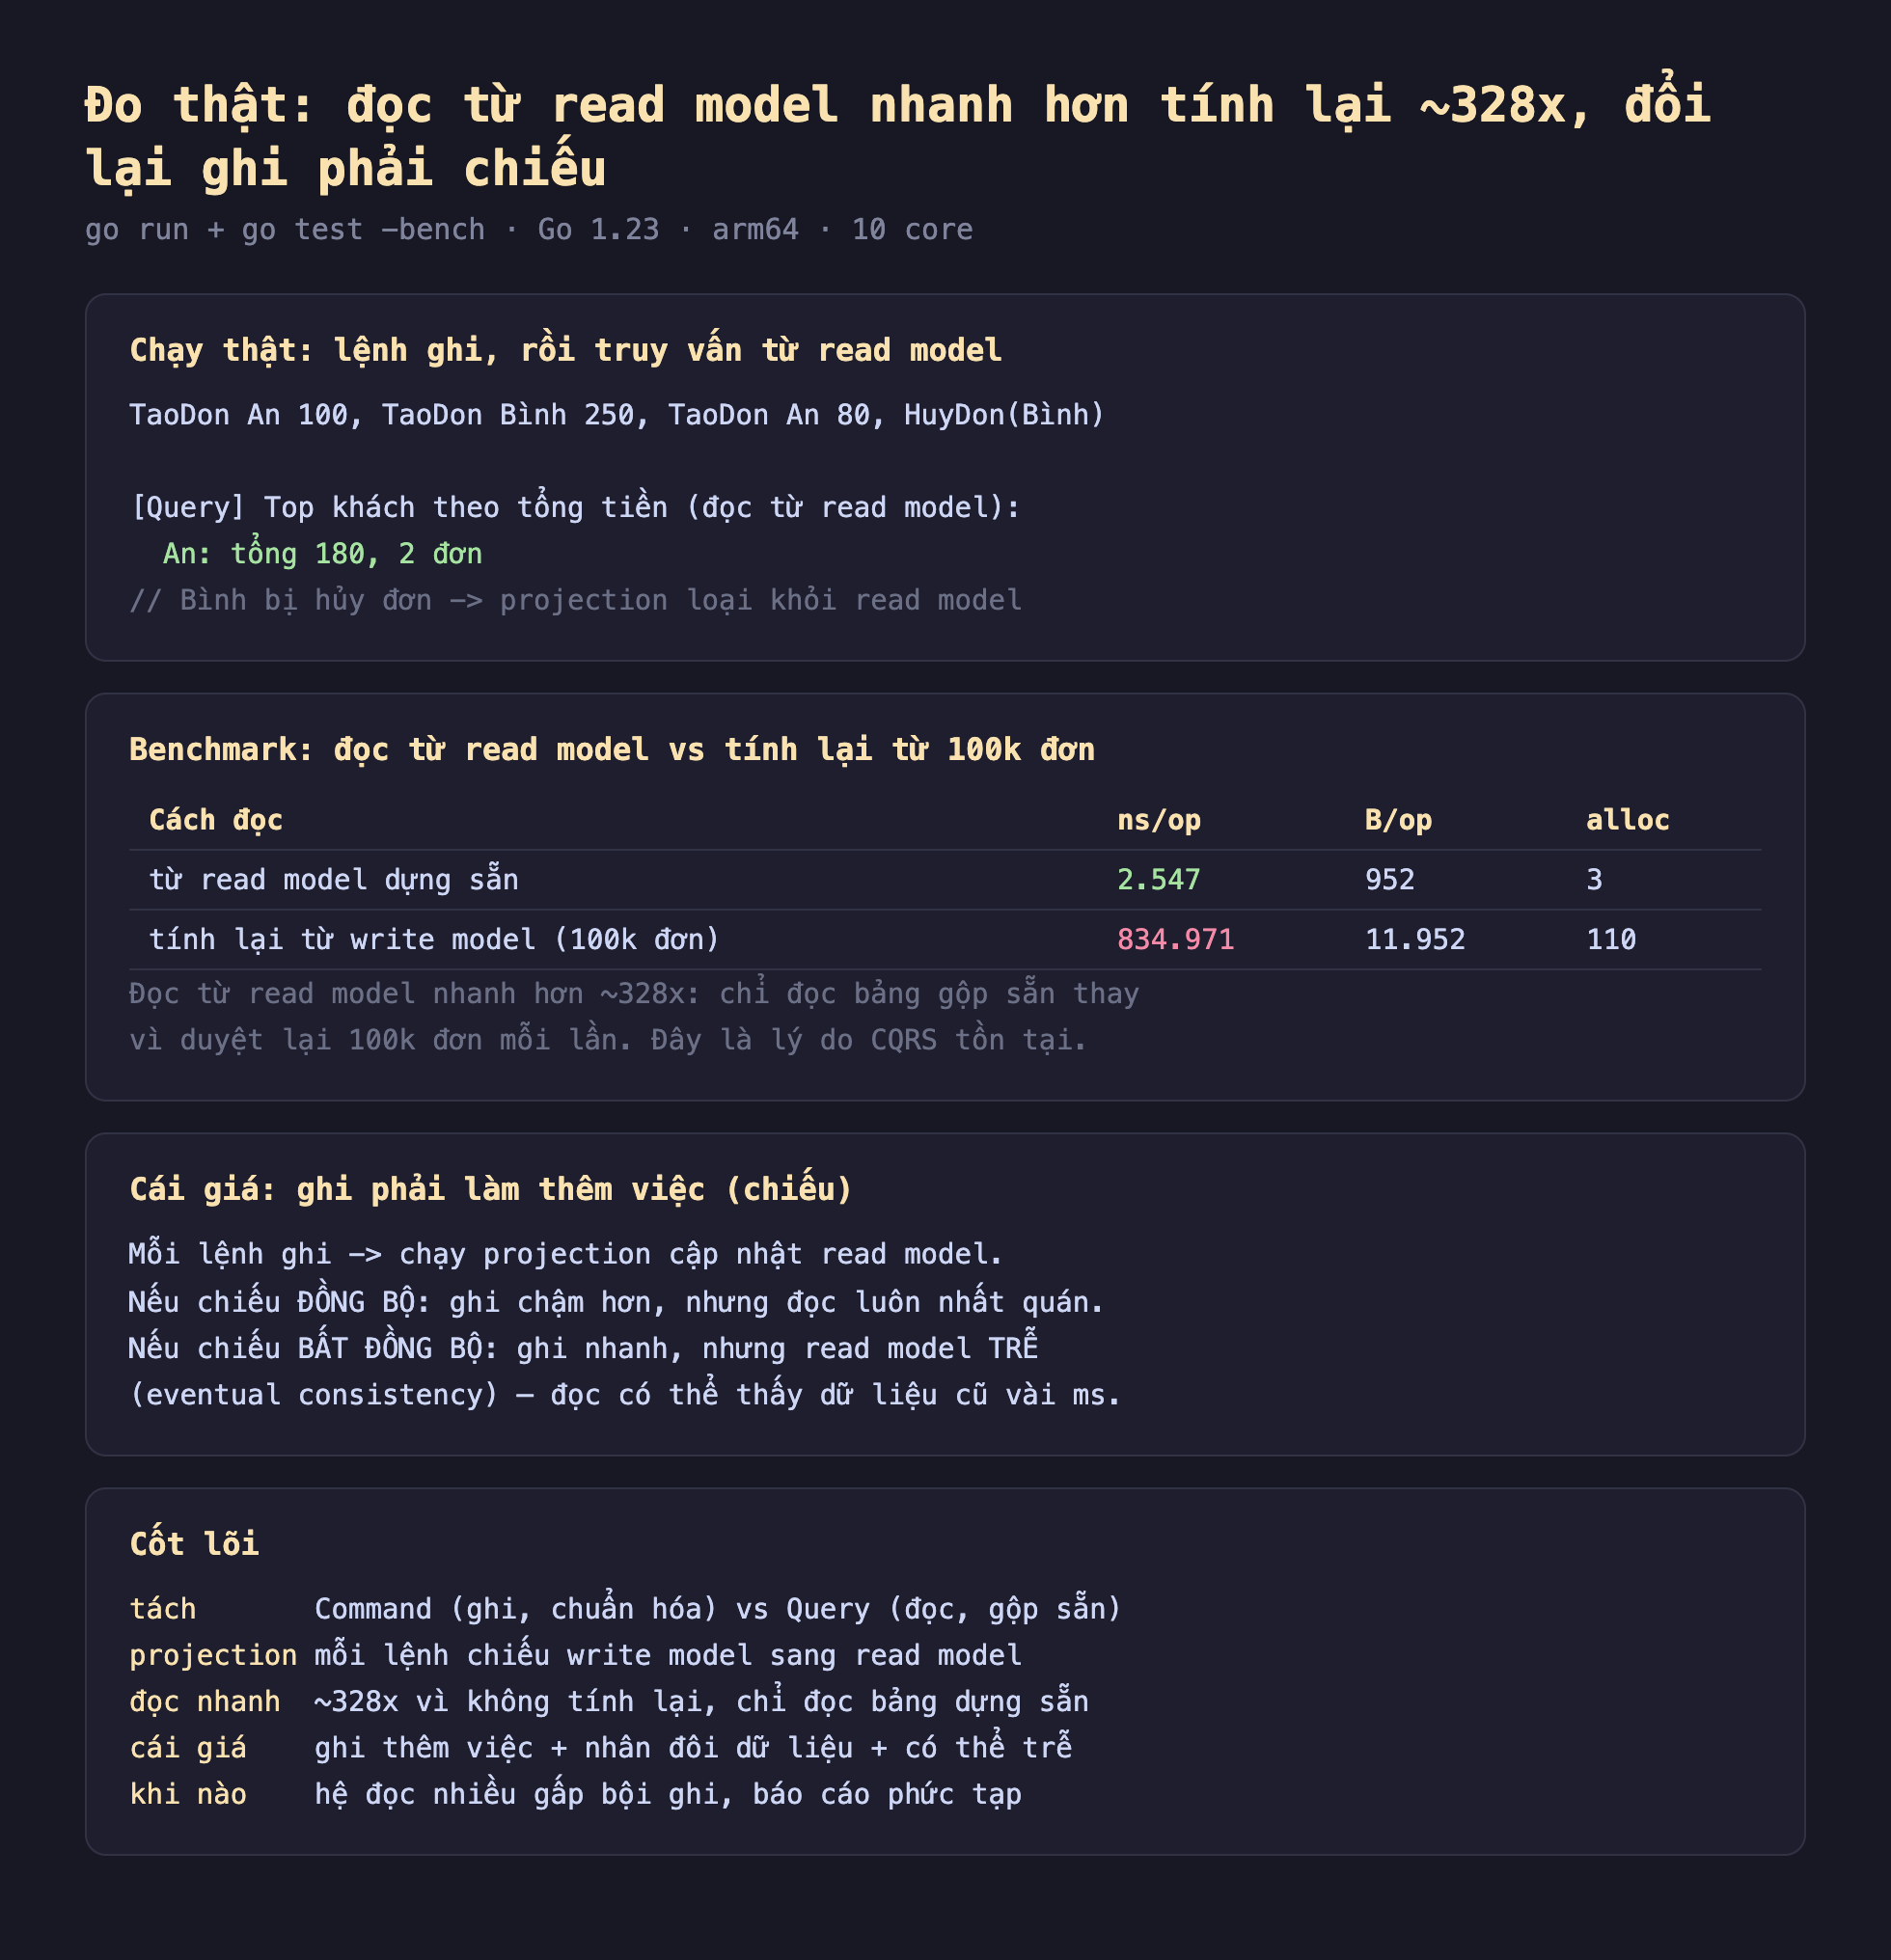
Hình 2: Đọc từ read model dựng sẵn 2.547 ns so với tính lại từ 100k đơn 834.971 ns — nhanh hơn ~328 lần (và 3 cấp phát so với 110). Đổi lại, mỗi lệnh ghi phải chạy projection; nếu chiếu bất đồng bộ thì read model có độ trễ (eventual consistency).
- đọc từ read model: 2.547 ns/op, 952 B, 3 cấp phát.
- tính lại từ write model: 834.971 ns/op, 11.952 B, 110 cấp phát.
Nhanh hơn ~328 lần. Read model chỉ là một bảng gộp sẵn — đọc nó là đọc kết quả đã tính; còn tính lại phải duyệt cả 100.000 đơn mỗi lần truy vấn. Với một dashboard hay báo cáo gọi hàng nghìn lần mỗi giây, khác biệt này là sống còn. Đây chính là giá trị cốt lõi của CQRS: dời chi phí tính toán từ lúc đọc sang lúc ghi, vì phần lớn hệ đọc nhiều hơn ghi rất nhiều.
Đánh đổi cần cân nhắc
Ghi phải trả giá cho projection, và có thể trễ nhất quán. Mỗi lệnh ghi giờ phải cập nhật read model. Nếu chiếu đồng bộ (ngay trong transaction ghi), ghi chậm hơn nhưng đọc luôn nhất quán tức thì. Nếu chiếu bất đồng bộ (qua hàng đợi, worker riêng), ghi nhanh nhưng read model trễ — đọc có thể thấy dữ liệu cũ vài mili giây (eventual consistency). Đây là đánh đổi cơ bản của CQRS, và chọn sai gây bug khó hiểu ("tôi vừa tạo đơn mà báo cáo chưa thấy").
CQRS thêm phức tạp đáng kể — đừng dùng khi chưa cần. Bạn giờ có hai mô hình, một projection, và (nếu bất đồng bộ) một cơ chế đồng bộ. Với CRUD đơn giản mà đọc/ghi cân bằng và không có truy vấn phức tạp, CQRS chỉ nhân đôi công việc mà không đem lại gì. Nó trả cổ tức khi: đọc nhiều gấp bội ghi, truy vấn đọc phức tạp (gộp nhiều bảng, thống kê), hoặc đọc và ghi cần scale độc lập.
CQRS không bắt buộc đi kèm event sourcing. Một hiểu nhầm phổ biến. CQRS chỉ nói "tách đọc và ghi"; read model có thể dựng từ chính write store bằng projection thường (như bài này), không cần event log. Event sourcing (lưu chuỗi sự kiện thay vì trạng thái) là một mẫu khác thường kết hợp với CQRS nhưng độc lập — đừng gánh cả hai khi chỉ cần một.
Ba ý mang về
- CQRS tách đường ghi (command, mô hình chuẩn hóa cho tính đúng) khỏi đường đọc (query, read model gộp sẵn cho tốc độ), nối bằng projection — mỗi lệnh ghi chiếu write model sang read model để đọc không phải tính lại.
- Đọc từ read model nhanh hơn tính lại rất nhiều: đo thật 2.547 ns so với 834.971 ns khi tính lại từ 100k đơn (~328 lần), vì read model là kết quả đã gộp sẵn — CQRS dời chi phí tính toán từ lúc đọc sang lúc ghi.
- Cái giá là phức tạp và có thể trễ nhất quán: ghi phải chạy projection, chiếu bất đồng bộ cho eventual consistency, và dữ liệu nhân đôi — chỉ đáng khi đọc nhiều gấp bội ghi hoặc truy vấn phức tạp; và CQRS không bắt buộc đi kèm event sourcing.
Phần sau ta xét chính mẫu hay bị nhầm với CQRS, lưu lịch sử thay vì trạng thái: Phần sau mổ xẻ event sourcing cơ bản — lưu chuỗi sự kiện thay cho trạng thái hiện tại, cách dựng lại trạng thái, và đánh đổi so với lưu trạng thái trực tiếp.
