Inlining là phép tối ưu quan trọng nhất mà compiler làm âm thầm: nó "dán" thân một hàm nhỏ thẳng vào nơi gọi, xoá đi lệnh gọi. Nhưng lợi ích thật lớn hơn nhiều so với việc tiết kiệm một lệnh CALL — và Go quyết định inline hay không bằng một cost model rất cụ thể mà bạn xem được. Bài này mổ xẻ mô hình đó bằng số liệu thật: cost của từng hàm, cái gì chặn inline, và đo tác động lên hiệu năng.
Cost model: mỗi hàm một điểm chi phí
Compiler duyệt thân mỗi hàm và cộng dồn một "chi phí" (cost): mỗi toán tử/lệnh cộng một ít, một lời gọi hàm khác cộng nhiều. Nếu tổng dưới ngân sách 80, hàm đủ nhỏ để inline. Xem cost cụ thể bằng go build -gcflags=-m=2:
can inline cong  with cost 4   // return a + b
can inline max3  with cost 21  // hai câu if
can inline tong  with cost 16  // có for range (Go 1.23 tính vòng lặp rẻ hơn)
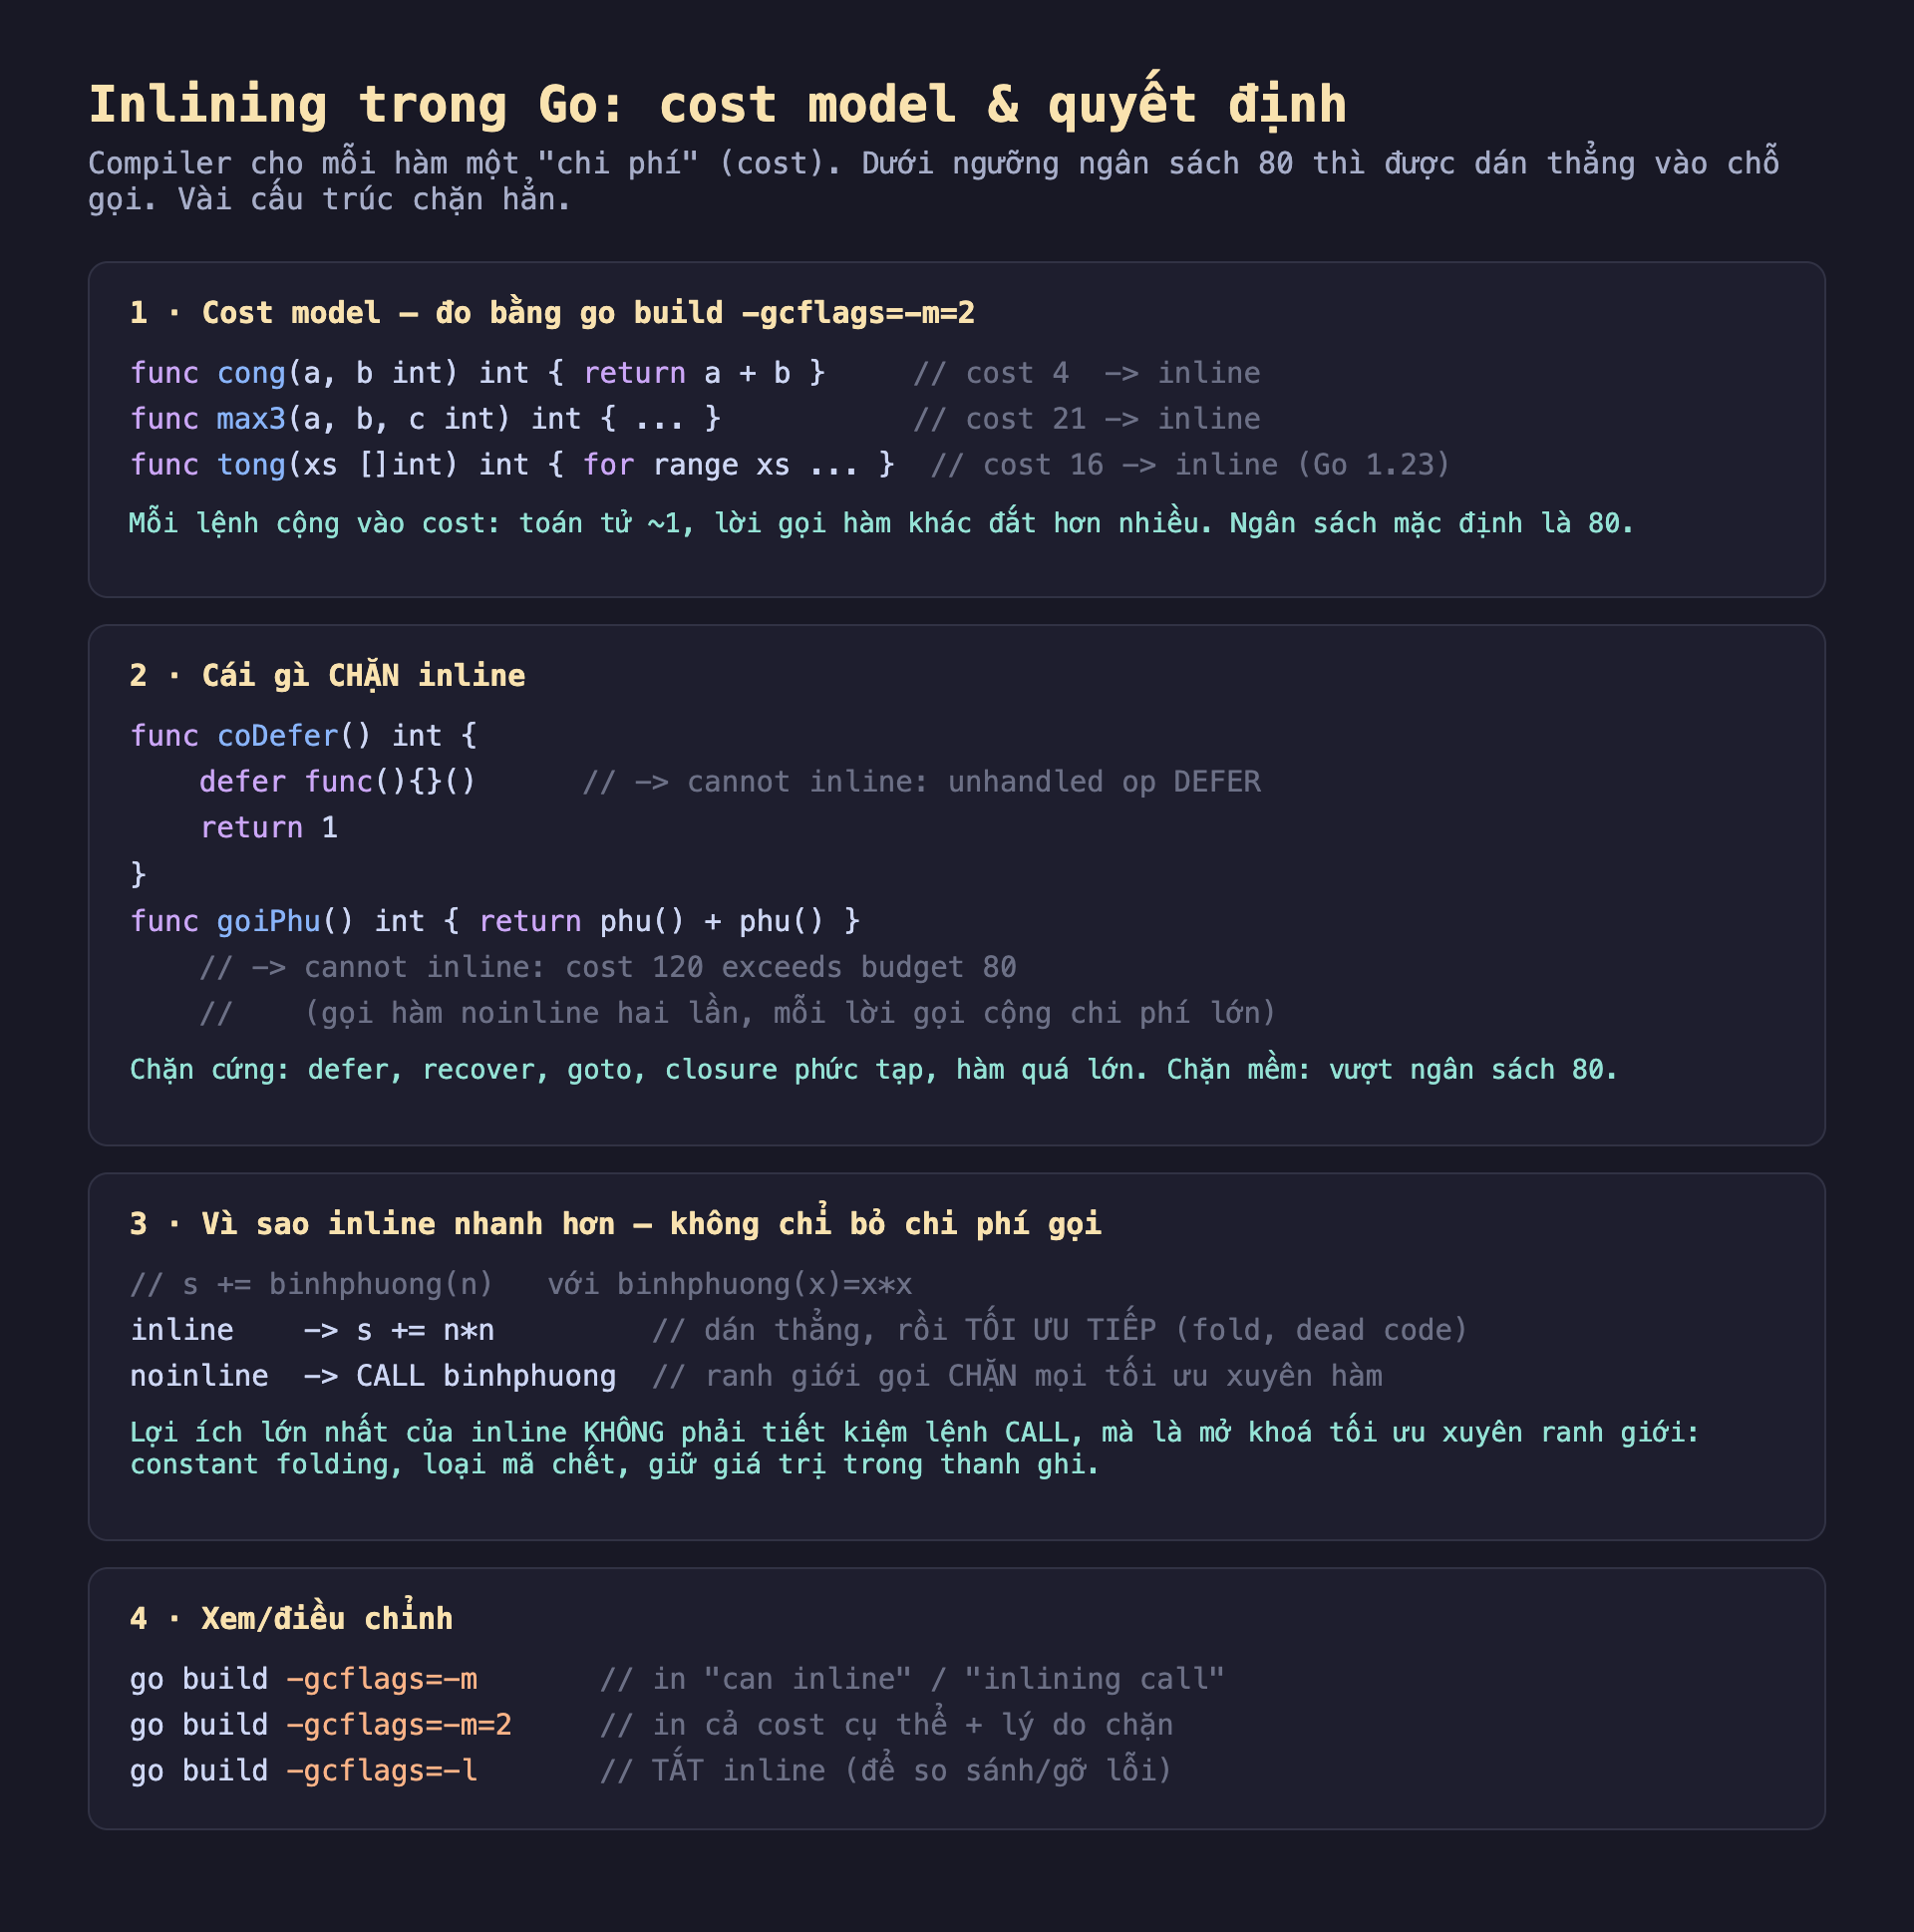
Hình 1: Cost model và các cấu trúc chặn inline. cong cost 4, max3 cost 21, tong cost 16 — đều dưới ngân sách 80; defer chặn cứng, goiPhu vượt budget.
Cái gì chặn inline
Có hai loại chặn. Chặn mềm — vượt ngân sách:
cannot inline goiPhu: function too complex: cost 120 exceeds budget 80
goiPhu gọi một hàm noinline hai lần; mỗi lời gọi tới hàm không-inline được cộng chi phí rất lớn, đẩy tổng lên 120 > 80. Chặn cứng — vài cấu trúc khiến compiler từ chối bất kể cost:
cannot inline coDefer: unhandled op DEFER
Ngoài defer, các thứ chặn cứng gồm recover, goto, closure phức tạp, và một số cấu trúc khác mà bộ inline chưa xử lý. Đây là lý do đặt defer trong một hàm getter nhỏ ở đường nóng có thể âm thầm mất inline.
Vì sao inline nhanh hơn — không chỉ bỏ lệnh CALL
Đây là hiểu lầm phổ biến: "inline chỉ tiết kiệm lệnh gọi". Thực ra lợi ích lớn hơn nhiều. Khi hàm được dán vào, compiler tối ưu tiếp xuyên qua ranh giới cũ: gập hằng, loại mã chết, giữ giá trị trong thanh ghi thay vì đẩy qua stack. Ranh giới lời gọi vốn là bức tường chặn mọi tối ưu đó.
Đo thật với vòng nóng s += binhphuong(n) (binhphuong(x) = x*x), so hàm inline với cùng hàm bị //go:noinline:
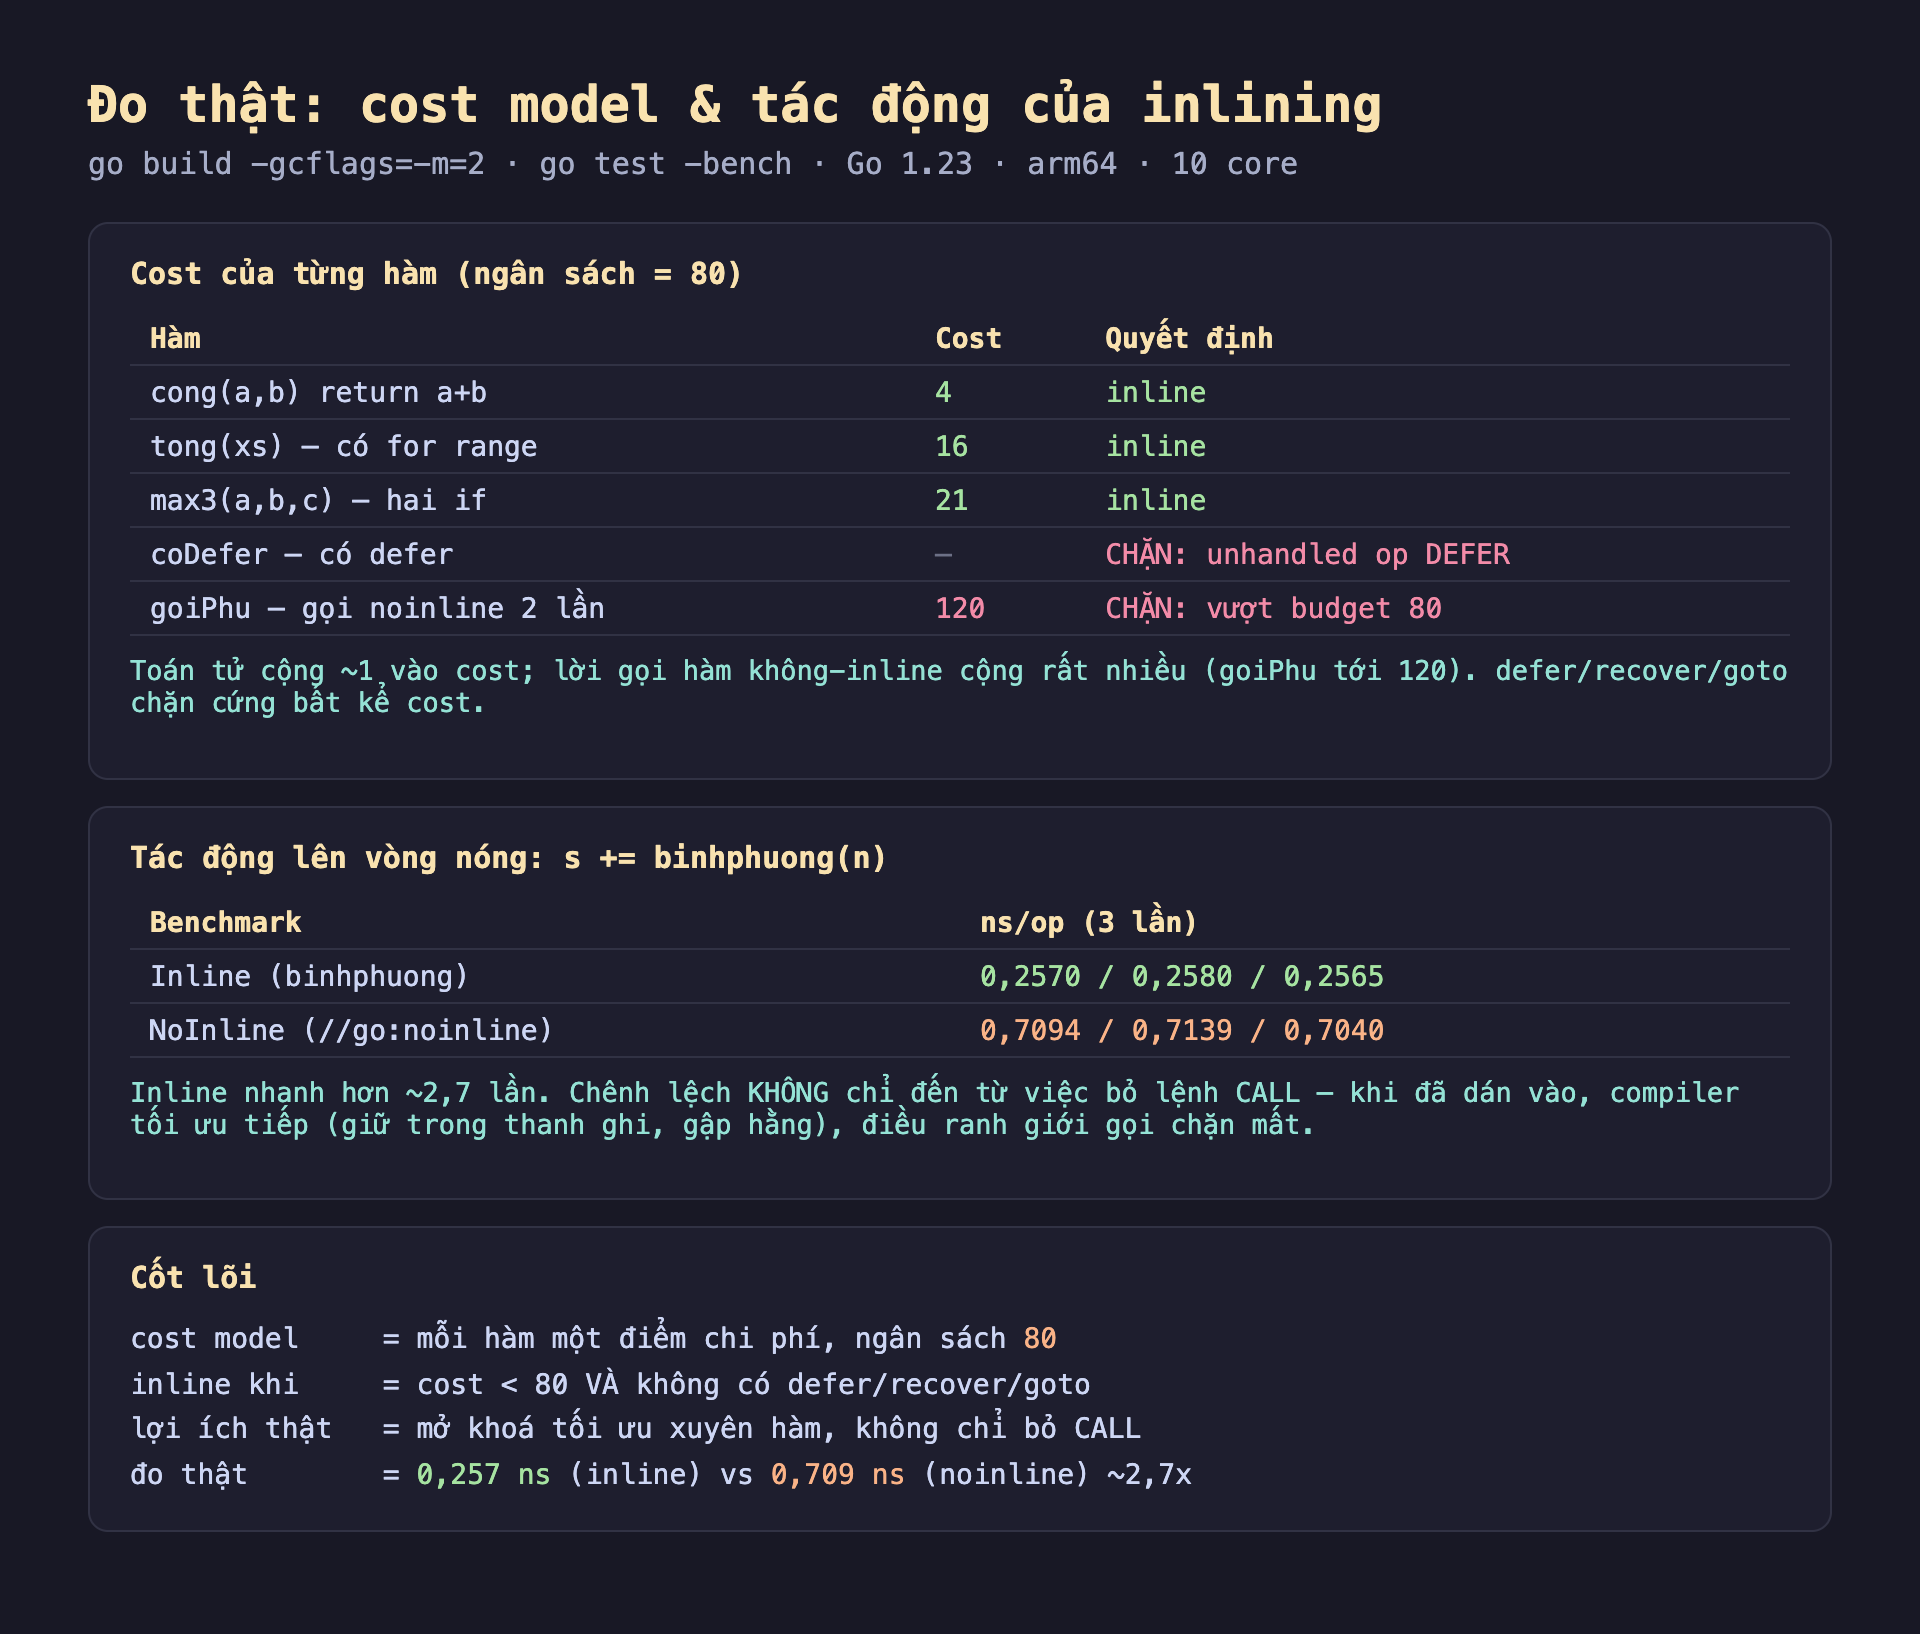
Hình 2: Cost từng hàm (ngân sách 80) và tác động thật. Inline ~0,257 ns so với noinline ~0,709 ns — nhanh hơn ~2,7 lần qua 3 lần đo ổn định.
- Inline: 0,2570 / 0,2580 / 0,2565 ns/op.
- NoInline: 0,7094 / 0,7139 / 0,7040 ns/op.
Nhanh hơn ~2,7 lần. Với một hàm chỉ làm x*x, chi phí lệnh CALL thuần không thể giải thích chênh lệch này — phần lớn đến từ việc compiler, sau khi inline, giữ được n trong thanh ghi và tối ưu cả vòng lặp như một khối liền.
Ứng dụng thực tế
Getter/setter nhỏ gần như miễn phí — nhờ inline. Viết func (p Point) X() int { return p.x } không chậm hơn truy cập trực tiếp p.x, vì compiler inline nó (cost ~4). Đừng ngại đóng gói bằng phương thức nhỏ vì sợ chi phí gọi; cost model đảm bảo chúng biến mất.
Giữ hàm ở đường nóng đủ nhỏ để inline. Nếu một hàm trong vòng lặp nóng vượt ngân sách 80 (thân quá lớn, gọi nhiều hàm khác), tách phần nóng ra một hàm con nhỏ có thể giúp nó được inline. Kiểm bằng -gcflags=-m xem hàm của bạn có "can inline" không.
Cẩn thận defer trong hàm nhỏ ở đường nóng. Một defer — dù rẻ về mặt runtime trong Go hiện đại — chặn hẳn inline. Trong một accessor siêu nóng, thay defer mu.Unlock() bằng unlock tường minh (khi an toàn) có thể mở lại inline. Chỉ làm khi profiler chỉ ra và bạn giữ được tính đúng đắn.
Đánh đổi cần cân nhắc
Inline nhiều làm code phình to (I-cache). Dán thân hàm vào mọi chỗ gọi làm mã máy lớn hơn, có thể gây áp lực lên instruction cache. Ngân sách 80 là điểm cân bằng của Go giữa tốc độ và kích thước — đừng cố ép inline hàm lớn bằng cách chia nhỏ vô tội vạ, có thể phản tác dụng.
Đừng vi tối ưu inline mà chưa đo. Chênh lệch 2,7x nghe lớn nhưng là trên một hàm cực nhỏ trong vòng cực nóng; ở code thường, chi phí gọi bị lấn át bởi công việc thật. Chỉ can thiệp inline khi pprof chỉ ra một hàm nhỏ bị gọi hàng trăm triệu lần và không được inline.
-gcflags=-l để so sánh, không để dùng thật. Tắt inline giúp gỡ lỗi và đo baseline, nhưng đừng build production với nó — bạn mất một trong những tối ưu quan trọng nhất. Ngược lại, không có cờ chuẩn để ép inline một hàm; cách duy nhất là giữ nó dưới ngân sách và tránh cấu trúc chặn cứng.
Ba ý mang về
- Go quyết định inline bằng cost model với ngân sách 80: đo thật
congcost 4,tongcost 16,max3cost 21 đều được inline; xem cost và lý do bằnggo build -gcflags=-m=2. - Hai loại chặn: chặn cứng (
defer,recover,goto— đo thậtcoDeferbị "unhandled op DEFER" bất kể cost) và chặn mềm (vượt ngân sách,goiPhucost 120 > 80) — cẩn thận đặtdefertrong hàm nhỏ ở đường nóng. - Lợi ích của inline không chỉ là bỏ lệnh CALL: đo thật inline nhanh hơn noinline ~2,7 lần (0,257 so 0,709 ns) vì sau khi dán vào, compiler mở khoá tối ưu xuyên ranh giới — gập hằng, loại mã chết, giữ giá trị trong thanh ghi.
Bài tập làm thử
Bài 1 (đọc hiểu). Cho ba hàm với cost đo được bằng go build -gcflags=-m=2: cong cost 4, max3 cost 21, tong cost 16 (có for range). Ngân sách inline mặc định là bao nhiêu, và cả ba hàm này có được inline không? Giải thích ngắn.
Đáp án
Ngân sách mặc định là 80. Cả ba hàm đều có cost nhỏ hơn 80 (4, 21, 16) nên đều được inline — miễn là chúng không chứa cấu trúc chặn cứng (defer, recover, goto...).
Bài 2 (sửa lỗi). Đoạn code sau được kỳ vọng inline vì thân rất ngắn, nhưng go build -gcflags=-m báo cannot inline unlockGetter: unhandled op DEFER. Sửa lại để hàm có cơ hội được inline mà vẫn đúng đắn (giả sử không có goroutine khác tranh chấp trong đoạn này).
func (c *Cache) unlockGetter() int {
	c.mu.Lock()
	defer c.mu.Unlock()
	return c.value
}
Đáp án
Thay defer bằng unlock tường minh, vì defer là chặn cứng bất kể cost (không liên quan tới ngân sách 80):
func (c *Cache) unlockGetter() int {
	c.mu.Lock()
	v := c.value
	c.mu.Unlock()
	return v
}
Lưu ý bài viết cảnh báo: chỉ làm việc này khi profiler chỉ ra cần thiết và vẫn giữ được tính đúng đắn (ví dụ không có early-return/panic nằm giữa Lock và Unlock, nếu có thì defer vẫn an toàn hơn).
Bài 3 (vận dụng thực tế). Hàm goiPhu trong bài có cost 120, vượt ngân sách 80, vì nó gọi một hàm khác được đánh dấu //go:noinline hai lần. Đây là loại chặn gì (mềm hay cứng)? Nếu muốn goiPhu được inline, cách nào trong hai cách sau hợp lý hơn: (a) thêm //go:noinline lên chính goiPhu, hay (b) giảm số lời gọi/độ phức tạp trong thân nó để cost xuống dưới 80?
Đáp án
Đây là chặn mềm (vượt ngân sách, không phải cấu trúc bị cấm). Cách (b) hợp lý — giảm cost để lọt dưới 80 thì hàm có cơ hội được inline trở lại. Cách (a) đi ngược mục tiêu: //go:noinline là chủ động cấm inline, dùng cho benchmark/profiling, không giúp hàm được inline.
Bài 4 (bẫy/đánh đổi). Một đồng nghiệp nói: "Cứ chia nhỏ mọi hàm lớn thành nhiều hàm con để ép compiler inline hết, code sẽ luôn nhanh hơn." Bài viết không đồng ý với cách nghĩ này ở điểm nào? Nêu đúng lý do được nhắc tới.
Đáp án
Inline nhiều làm mã máy phình to hơn (mỗi chỗ gọi được dán thêm một bản sao thân hàm), có thể gây áp lực lên instruction cache (I-cache). Ngân sách 80 là điểm cân bằng Go đã chọn giữa tốc độ và kích thước; chia nhỏ hàm vô tội vạ để ép inline có thể phản tác dụng, và mọi thay đổi kiểu này phải được đo (bằng -gcflags=-m và benchmark) chứ không suy đoán.
Bài 5 (đọc hiểu số liệu). Bài đo vòng nóng s += binhphuong(n): bản inline cho ~0,257 ns/op, bản //go:noinline cho ~0,709 ns/op. Vì sao chênh lệch ~2,7 lần này không thể giải thích chỉ bằng việc "tiết kiệm một lệnh CALL"?
Đáp án
Vì binhphuong(x) = x*x là phép tính cực rẻ — chi phí thuần của một lệnh CALL không thể tạo ra chênh lệch lớn như vậy. Phần lớn khác biệt đến từ việc sau khi inline, compiler tối ưu tiếp xuyên ranh giới cũ: gập hằng, loại mã chết, và giữ giá trị (n) trong thanh ghi thay vì phải tuân theo quy ước gọi hàm (đẩy qua stack/thanh ghi tham số). Ranh giới lời gọi vốn chặn đứng các tối ưu đó.
Phần sau ta xem mặt đối lập — cách chủ động chặn inline và vì sao đôi khi bạn muốn thế: Phần sau mổ xẻ chỉ thị //go:noinline — khi nào nó cần thiết cho benchmark đúng, cho pprof đọc được, và các directive compiler khác.
