Bài trước dạy sắp field để struct gọn nhất — nhồi dữ liệu gần nhau tiết kiệm bộ nhớ. Bài này là mặt trái đáng ngạc nhiên: có lúc nhồi dữ liệu gần nhau lại làm chương trình chậm 30 lần. Hiện tượng đó gọi là false sharing (chia sẻ giả), và nó xảy ra khi nhiều lõi CPU cùng ghi vào các biến khác nhau nhưng nằm chung một cache line. Bài này đo trực tiếp mức chậm khủng khiếp đó và cách sửa.
Cache line: CPU không làm việc theo byte
CPU không đọc/ghi bộ nhớ theo từng byte mà theo khối cố định gọi là cache line — thường 64 byte. Khi bạn chạm một byte, cả cache line 64 byte chứa nó được nạp vào cache. Đây là lý do duyệt mảng tuần tự nhanh (dữ liệu kề nhau vào cùng line).
Vấn đề nảy sinh với cache coherency — giao thức đảm bảo mọi lõi thấy dữ liệu nhất quán. Khi lõi A ghi vào một cache line, mọi bản sao của line đó ở các lõi khác bị vô hiệu hoá (invalidate): chúng phải nạp lại bản mới. Nếu hai lõi liên tục ghi vào cùng một cache line, line đó bị "ping-pong" qua lại giữa chúng — dù mỗi lõi ghi vào một biến khác nhau trong line.
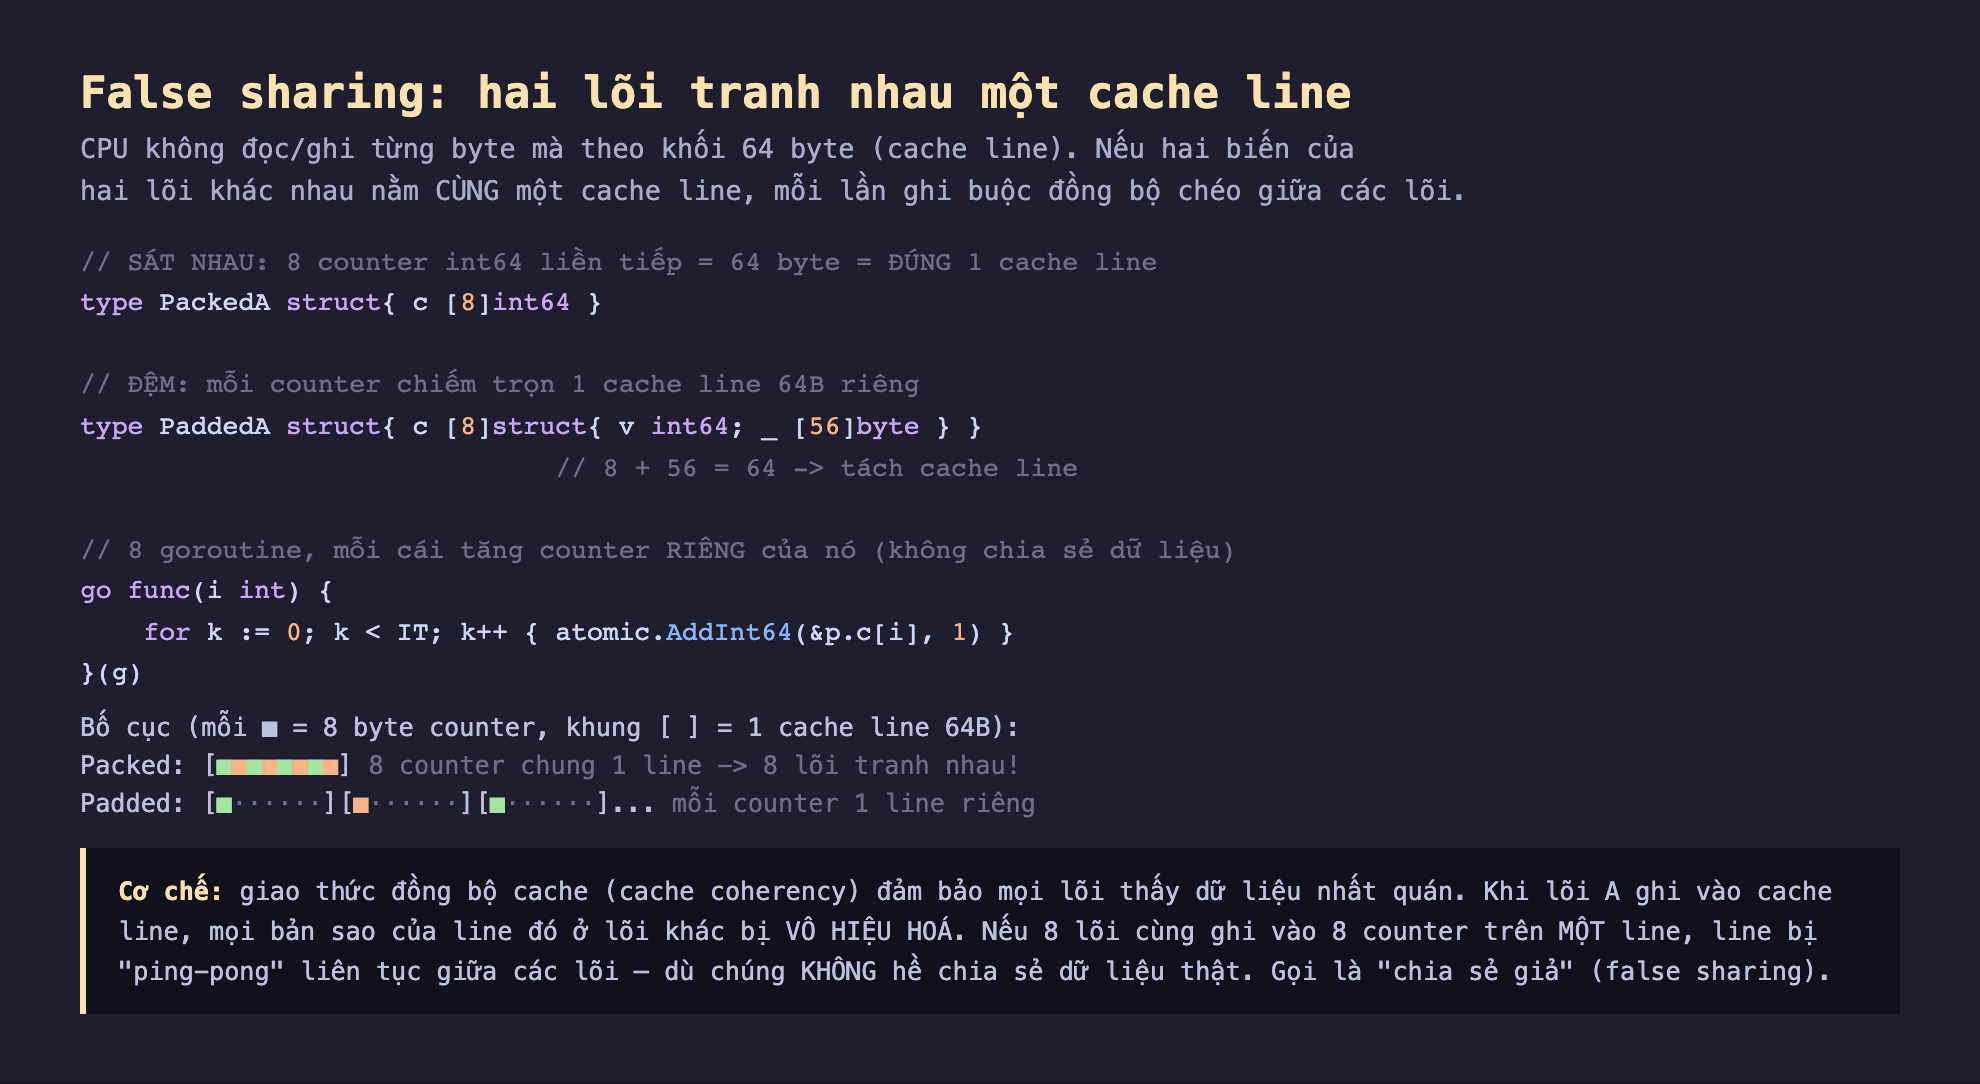
Hình 1: 8 counter int64 liền tiếp = 64 byte = đúng một cache line, nên 8 goroutine cùng ghi vào một line. Chèn 56 byte đệm để mỗi counter chiếm một cache line riêng.
Đo thật: chậm 30 lần
Đây là một trong những phép đo gây sốc nhất của cả sê-ri. Tám goroutine, mỗi cái tăng counter riêng của nó — hoàn toàn không chia sẻ dữ liệu về mặt logic. Chỉ khác chỗ đặt counter trong bộ nhớ: sát nhau (chung cache line) hay có đệm (mỗi cái một line).
type PackedA struct{ c [8]int64 }  // 8*8 = 64 byte = 1 cache line
type PaddedA struct{ c [8]struct{ v int64; _ [56]byte } }  // mỗi cái 64B

// mỗi goroutine: for k... atomic.AddInt64(&p.c[i], 1)
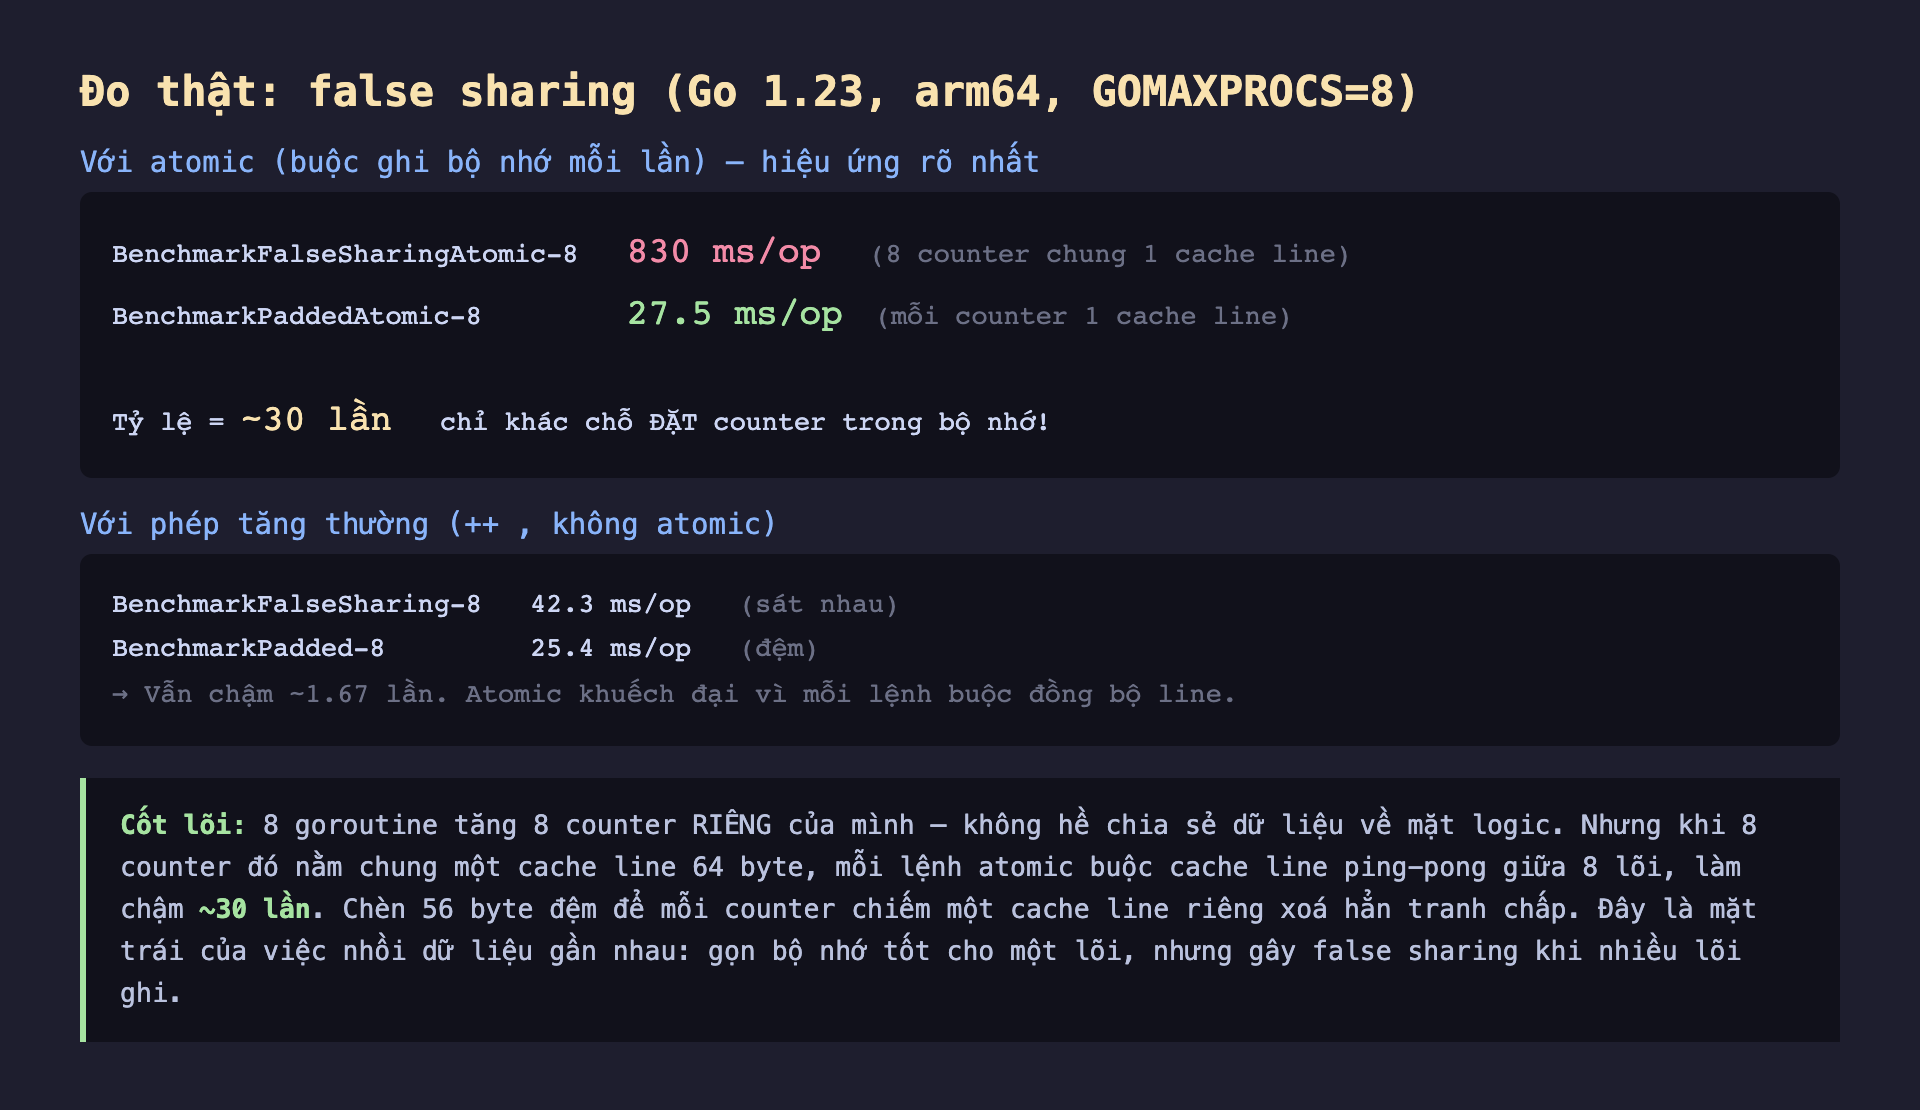
Hình 2: Với atomic, counter sát nhau 830 ms so với có đệm 27,5 ms — chậm ~30 lần. Với phép tăng thường: 42,3 so với 25,4 ms (~1,67 lần). Chỉ khác chỗ đặt counter.
Kết quả với atomic: counter sát nhau tốn 830 ms, counter có đệm chỉ 27,5 ms — chậm ~30 lần! Tám lõi cùng làm atomic.AddInt64 vào tám counter trên một cache line khiến line đó bị giằng co liên tục giữa tám lõi. Mỗi lệnh atomic phải giành quyền độc chiếm line, ghi, rồi lõi khác lại giành lại. Chèn 56 byte đệm để mỗi counter chiếm một cache line riêng → tám lõi làm việc độc lập, không tranh chấp → nhanh 30 lần.
Với phép tăng thường (++, không atomic), hiệu ứng nhỏ hơn (42 so với 25 ms, ~1,67 lần) vì phần cứng và compiler có chút tự do gộp ghi. Atomic khuếch đại vì mỗi lệnh buộc đồng bộ cache line ngay lập tức — đó là bản chất của atomic.
Ứng dụng thực tế
Mảng/slice counter theo mỗi goroutine là ổ false sharing. Mẫu phổ biến: mỗi worker cập nhật stats[workerID]. Nếu các phần tử stats sát nhau (mảng int64), bạn đang tự tạo false sharing. Đệm mỗi phần tử tới 64 byte, hoặc cho mỗi worker một biến hoàn toàn riêng rồi gộp cuối cùng.
Struct chia sẻ giữa nhiều goroutine cần cân nhắc bố cục. Nếu một struct có nhiều field được các goroutine khác nhau ghi (ví dụ hai bộ đếm cho hai luồng), đặt chúng cùng cache line gây false sharing. Tách chúng bằng padding nếu đo được vấn đề.
Đây là lý do runtime Go tự đệm một số cấu trúc. Các cấu trúc nội bộ của runtime (như trong scheduler, allocator) có padding chống false sharing ở những chỗ nóng. sync.Pool, mcache per-P... đều được thiết kế để mỗi P chạm vùng nhớ riêng, tránh giằng co cache line giữa các lõi.
Đánh đổi cần cân nhắc
Padding tốn bộ nhớ — ngược với tối ưu alignment. Bài trước ta bỏ padding để struct gọn; bài này ta thêm padding để tách cache line. Hai mục tiêu mâu thuẫn: gọn bộ nhớ (tốt cho một lõi duyệt tuần tự) vs tách cache line (tốt cho nhiều lõi ghi song song). Chọn theo cách dữ liệu được truy cập: đọc tuần tự một lõi thì nhồi gọn; nhiều lõi ghi thì đệm tách.
Chỉ đệm khi đo được false sharing. Đừng đệm mọi struct "cho chắc" — phí bộ nhớ và hại cache khi truy cập tuần tự. False sharing chỉ xảy ra khi nhiều lõi ghi vào cùng cache line ở tần suất cao. Nếu dữ liệu chủ yếu đọc, hoặc chỉ một lõi ghi, không có false sharing. Dùng perf c2c (Linux) hoặc profiling để xác nhận trước khi đệm.
Kích thước cache line phụ thuộc kiến trúc. 64 byte đúng cho hầu hết x86 và arm64 hiện đại, nhưng một số kiến trúc dùng 128 byte. Để đệm an toàn tuyệt đối trên mọi CPU, dùng cpu.CacheLinePad từ golang.org/x/sys/cpu thay vì hardcode 56.
Ba ý mang về
- False sharing làm chậm chương trình song song mà không chia sẻ dữ liệu thật: đo thật, 8 goroutine tăng 8 counter riêng chậm ~30 lần (830 so với 27,5 ms) chỉ vì 8 counter nằm chung một cache line 64 byte và bị 8 lõi giằng co qua cache coherency.
- Sửa bằng cách đệm để mỗi biến hay ghi chiếm một cache line riêng: chèn 56 byte đệm (8 + 56 = 64) tách các counter → xoá hẳn tranh chấp — nhưng chỉ đệm khi đo được false sharing, vì nó tốn bộ nhớ.
- Padding chống false sharing mâu thuẫn với tối ưu alignment gọn: nhồi gọn tốt cho một lõi đọc tuần tự, tách cache line tốt cho nhiều lõi ghi — chọn theo cách truy cập, và dùng
cpu.CacheLinePadcho di động giữa kiến trúc.
Bài tập làm thử
Bài 1 (đọc hiểu). Bài viết định nghĩa hai struct sau và đo với 8 goroutine, mỗi goroutine dùng atomic.AddInt64 tăng counter riêng của mình (p.c[i], không chia sẻ dữ liệu logic với goroutine khác):
type PackedA struct{ c [8]int64 }
type PaddedA struct{ c [8]struct{ v int64; _ [56]byte } }
Kết quả đo: BenchmarkFalseSharingAtomic (dùng PackedA) = 830 ms/op; BenchmarkPaddedAtomic (dùng PaddedA) = 27,5 ms/op — chậm khoảng 30 lần. Tại sao 8 goroutine không hề chia sẻ dữ liệu logic mà vẫn chậm đi 30 lần khi dùng PackedA?
Đáp án
PackedA có 8 phần tử int64 (8 byte mỗi phần tử) nằm liền kề nhau, tổng cộng 8×8 = 64 byte — đúng bằng kích thước một cache line, nên cả 8 counter nằm chung một cache line. Do cơ chế cache coherency, khi một lõi CPU ghi (qua atomic.AddInt64) vào cache line đó, mọi bản sao của line ở các lõi khác bị vô hiệu hoá và phải nạp lại. Với 8 lõi liên tục ghi vào 8 counter khác nhau nhưng cùng nằm trên một line, line đó bị "ping-pong" liên tục giữa 8 lõi — mỗi lệnh atomic phải giành quyền độc chiếm line, ghi, rồi lõi khác giành lại. Đây là false sharing: dữ liệu logic không được chia sẻ, nhưng đơn vị phần cứng (cache line) thì bị chia sẻ và tranh chấp. PaddedA chèn 56 byte đệm sau mỗi int64 (8+56=64 byte), khiến mỗi counter chiếm trọn một cache line riêng, 8 lõi làm việc hoàn toàn độc lập, không còn tranh chấp.
Bài 2 (sửa lỗi). Đoạn code dưới đây là một mẫu phổ biến mà bài viết gọi là "ổ false sharing": mỗi worker cập nhật một phần tử trong mảng stats dùng chung. Hãy sửa lại theo cách bài viết khuyến nghị (đệm mỗi phần tử tới 64 byte) để tránh false sharing.
var stats [8]int64 // mỗi worker i tăng stats[i]

func Worker(i int, n int) {
    for k := 0; k < n; k++ {
        atomic.AddInt64(&stats[i], 1)
    }
}
Đáp án
Mảng stats [8]int64 có 8 phần tử × 8 byte = 64 byte, nằm gọn trong một cache line — chính xác là kịch bản false sharing bài viết đo được (830 ms so với 27,5 ms, chậm ~30 lần). Sửa bằng cách đệm mỗi phần tử tới 64 byte, giống mẫu PaddedA trong bài:
var stats [8]struct {
    v int64
    _ [56]byte // đệm để mỗi phần tử chiếm trọn 1 cache line 64 byte
}

func Worker(i int, n int) {
    for k := 0; k < n; k++ {
        atomic.AddInt64(&stats[i].v, 1)
    }
}
Với đệm này, mỗi worker chạm một cache line riêng, không còn tranh chấp cache coherency giữa các lõi.
Bài 3 (vận dụng). Bài viết cũng đo với phép tăng thường (++, không dùng atomic): BenchmarkFalseSharing (sát nhau) = 42,3 ms/op, BenchmarkPadded (có đệm) = 25,4 ms/op — chỉ chậm khoảng 1,67 lần, thay vì 30 lần như khi dùng atomic. Giải thích vì sao dùng atomic lại khuếch đại tác động của false sharing mạnh hơn nhiều so với phép tăng thường.
Đáp án
Bài viết giải thích: với phép tăng thường, "phần cứng và compiler có chút tự do gộp ghi" — nghĩa là không phải mọi lần ++ đều buộc đồng bộ cache line ngay lập tức, nên tác động của việc chia sẻ line bị giảm nhẹ phần nào. Ngược lại, atomic.AddInt64 theo đúng bản chất của nó phải đảm bảo tính nguyên tử và nhất quán ngay lập tức trên mọi lõi — "mỗi lệnh atomic buộc đồng bộ cache line ngay lập tức". Vì vậy khi 8 lõi cùng thực hiện atomic trên cùng một cache line, mỗi lệnh đều phải giành quyền độc chiếm line một cách tường minh và ngay lập tức, khiến chi phí tranh chấp bị khuếch đại lên rất nhiều (30 lần) so với phép tăng thường không có ràng buộc đồng bộ chặt như vậy (chỉ 1,67 lần).
Bài 4 (bẫy/đánh đổi). Bài trước (struct alignment) khuyên nên bỏ padding để struct gọn nhất; bài này lại khuyên thêm padding để chống false sharing. Hai lời khuyên này có mâu thuẫn nhau không? Hãy nêu quy tắc bài viết đưa ra để quyết định khi nào nên chọn cách nào, và một điều kiện bắt buộc trước khi thêm padding chống false sharing.
Đáp án
Không thực sự mâu thuẫn — chúng phục vụ hai mục tiêu khác nhau tùy theo cách dữ liệu được truy cập. Bài viết nêu rõ: "Chọn theo cách dữ liệu được truy cập: đọc tuần tự một lõi thì nhồi gọn; nhiều lõi ghi thì đệm tách." Cụ thể: nếu dữ liệu chủ yếu được một lõi đọc tuần tự (ví dụ duyệt mảng struct), nhồi gọn (bỏ padding, tối ưu alignment) giúp nhiều struct khớp vào một cache line, cải thiện locality. Nếu dữ liệu bị nhiều lõi ghi vào các biến khác nhau nhưng ở gần nhau, cần đệm tách để tránh false sharing.
Điều kiện bắt buộc trước khi thêm padding: chỉ đệm khi đo được false sharing thật sự — bài viết cảnh báo "Đừng đệm mọi struct 'cho chắc'" vì tốn bộ nhớ và hại cache khi truy cập tuần tự; false sharing chỉ xảy ra khi nhiều lõi ghi vào cùng cache line ở tần suất cao, nếu dữ liệu chủ yếu đọc hoặc chỉ một lõi ghi thì không có false sharing. Nên dùng công cụ như perf c2c (Linux) hoặc profiling để xác nhận trước khi thêm đệm.
Phần sau ta bước sang trụ cột lớn nhất của runtime Go — bộ thu gom rác: Phần sau mổ xẻ GC tricolor mark-sweep chạy đồng thời — cách Go đánh dấu object sống bằng ba màu, quét song song với chương trình, và giữ thời gian dừng cực ngắn.
