Mười phần trước đo từng cặp client–server. Phần này đo một chuỗi: người dùng gọi gateway, gateway gọi service A, A gọi service B. Mỗi tầng được viết bởi một người khác, vào một thời điểm khác, và mỗi người đều "làm đúng": đặt timeout cho lời gọi của mình, retry khi lỗi. Cộng lại, hệ thống có hành vi mà không ai trong số họ thiết kế. Bài này đo hành vi đó, và đo cách chữa: một ngân sách thời gian đi cùng request qua mọi tầng.
Một ngân sách, truyền xuống, huỷ ngược lên
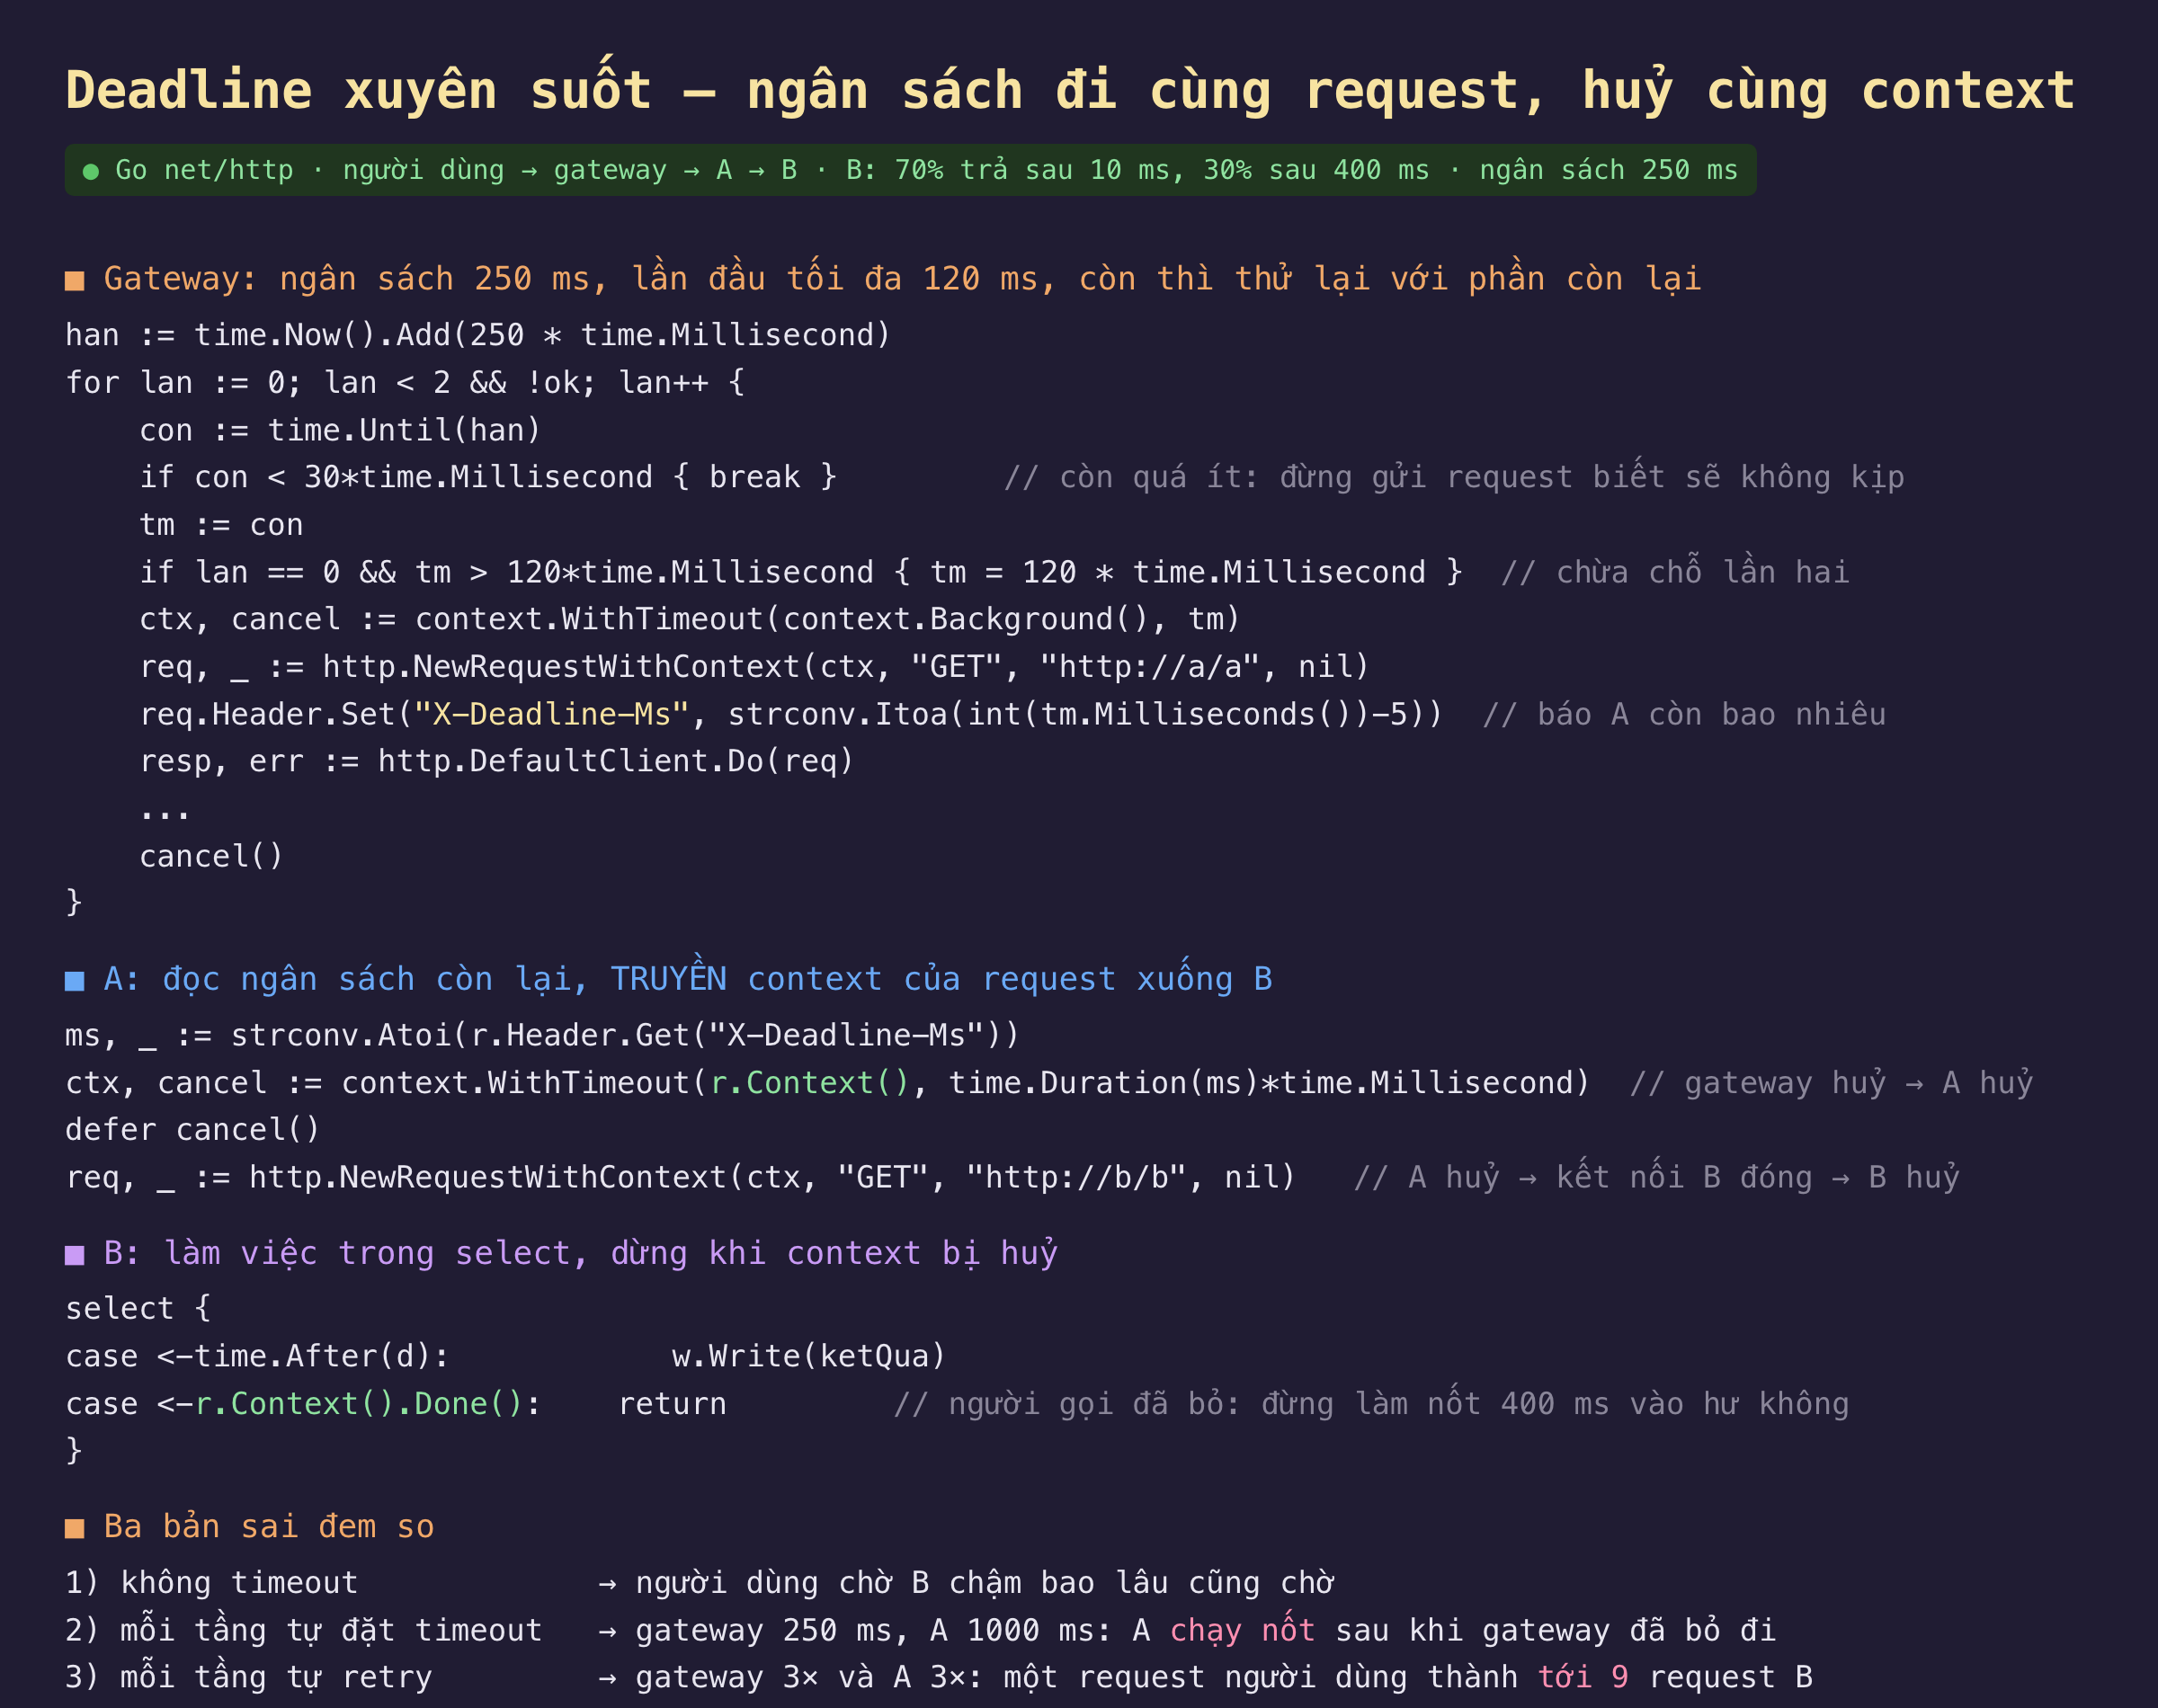
Hình 1: Gateway giữ ngân sách và báo phần còn lại cho A qua header. A đặt timeout từ con số đó và truyền context của request xuống B. B dừng khi context bị huỷ.
Ba mảnh, mỗi mảnh một việc:
- Gateway giữ ngân sách 250 ms — con số người dùng chịu được, không phải con số của bất kỳ service nào. Lần gọi đầu giới hạn 120 ms để nếu hỏng vẫn còn chỗ thử lại; nếu phần còn lại quá ít thì không gửi, vì một request biết trước sẽ không kịp chỉ tốn tài nguyên của người khác.
- A đọc phần còn lại từ header
X-Deadline-Ms(gRPC làm đúng chuyện này bằnggrpc-timeout) và đặt timeout cho lời gọi B từ con số đó — không phải từ một hằng số trong cấu hình của A. Quan trọng hơn: A dùngr.Context()chứ không phảicontext.Background(), nên khi gateway ngắt kết nối, lời gọi của A tới B bị huỷ theo. - B làm việc trong
selectvớir.Context().Done(): khi A ngắt, B dừng thay vì chạy hết 400 ms rồi ghi kết quả vào một kết nối đã đóng.
Đo thật: bốn kịch bản, cùng một B
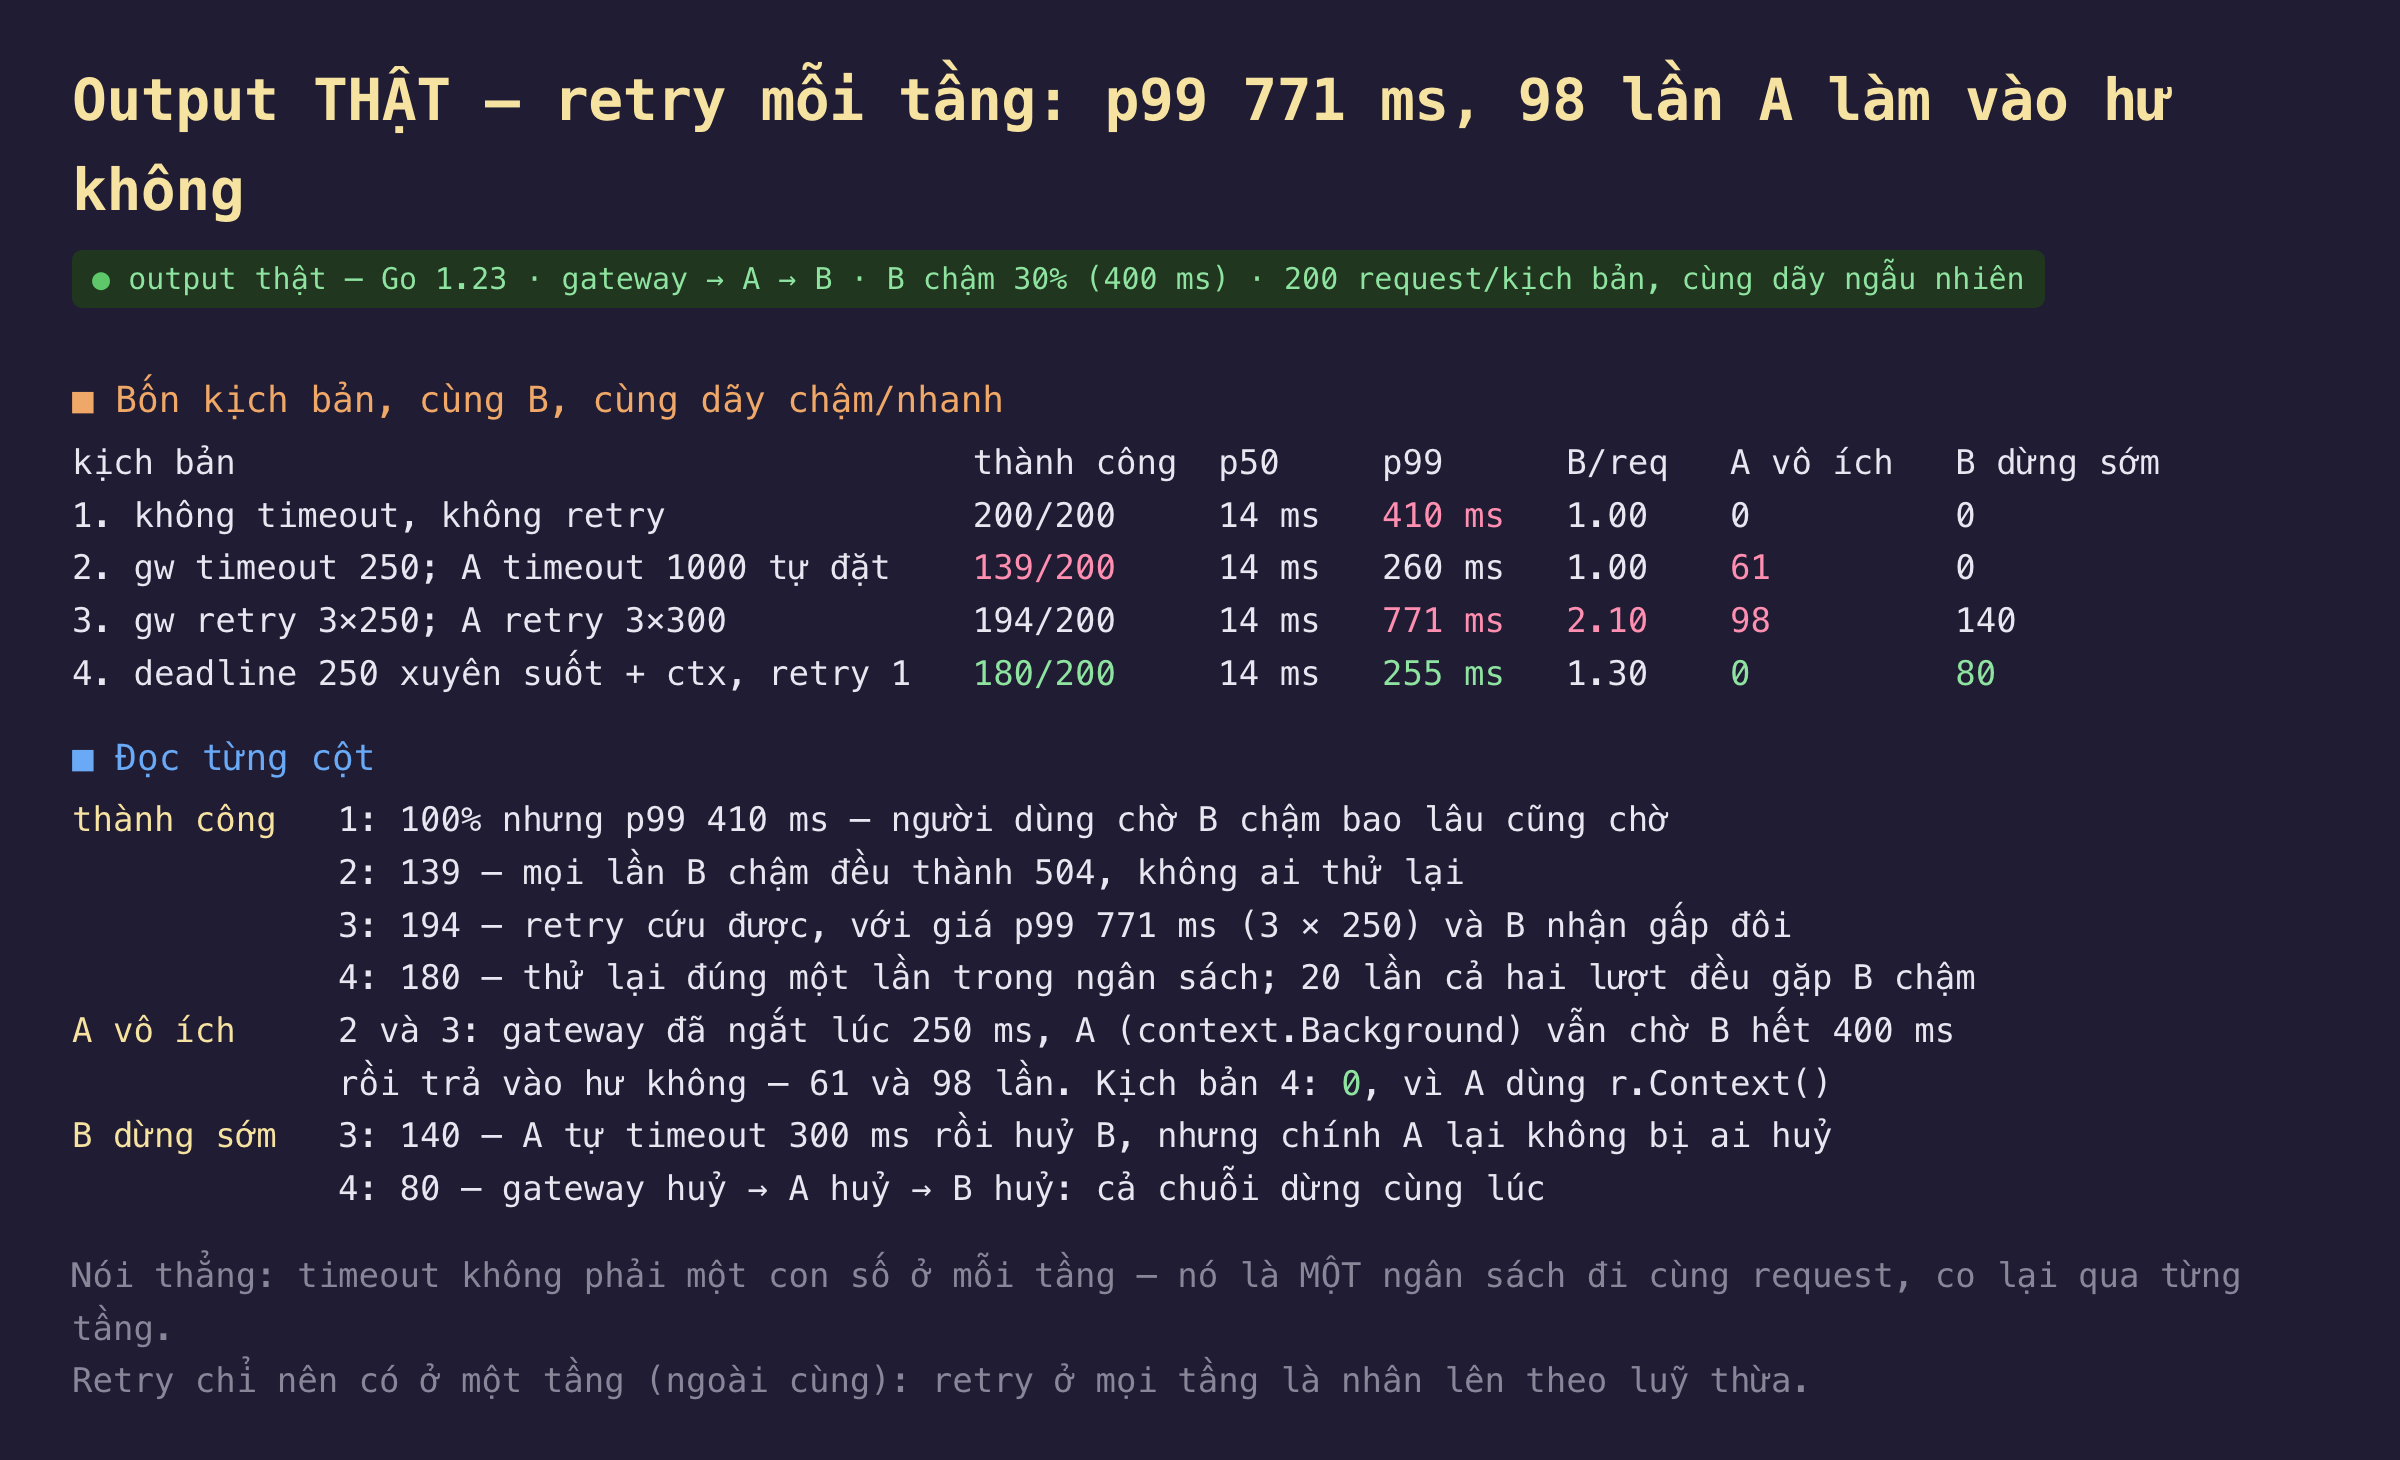
Hình 2: Kết quả thật, 200 request người dùng mỗi kịch bản với cùng dãy ngẫu nhiên chậm/nhanh của B. Hai cột cuối là thứ bảng đo thông thường không có.
| kịch bản | thành công | p99 | B nhận / request | A làm vô ích |
|---|---|---|---|---|
| 1. không timeout, không retry | 200/200 | 410 ms | 1,00 | 0 |
| 2. mỗi tầng tự đặt timeout | 139/200 | 260 ms | 1,00 | 61 |
| 3. mỗi tầng tự retry | 194/200 | 771 ms | 2,10 | 98 |
| 4. deadline xuyên suốt + context | 180/200 | 255 ms | 1,30 | 0 |
Kịch bản 1 — không timeout. 100% thành công, và đó là điểm duy nhất tốt. p99 410 ms: khi B chậm, người dùng chờ đúng bấy nhiêu, và nếu B treo hẳn thì chờ vô hạn. Không có kịch bản nào khác đạt 200/200, vì mọi kịch bản còn lại đều chọn bỏ cuộc ở 250 ms — con số thành công giảm là cái giá đã tính trước, không phải lỗi.
Kịch bản 2 — mỗi tầng tự đặt timeout. Gateway 250 ms, A 1.000 ms cho lời gọi B, hai con số do hai người chọn độc lập. Gateway bỏ đi lúc 250 ms; A không biết, vì A dùng context.Background(), nên nó chờ B hết 400 ms rồi trả kết quả vào một kết nối đã đóng — 61 lần trong 200 request. Service A tốn CPU, giữ goroutine, giữ kết nối tới B cho những request không còn ai cần. Ở tải cao, đây chính là cách một service "chết vì việc đã bị huỷ": tài nguyên bị chiếm bởi request mà client đã quên từ lâu.
Kịch bản 3 — mỗi tầng tự retry. Gateway retry 3 lần, A retry 3 lần. Thành công lên 194/200, nhìn vào mỗi cột đó thì có vẻ tốt. Nhìn tiếp: p99 771 ms — gấp ba ngân sách, vì 3 lần × 250 ms. B nhận 2,1 request cho mỗi request người dùng, và trần lý thuyết là 9. A làm việc vào hư không 98 lần: gateway đã retry sang một request A mới, trong khi request A cũ vẫn đang retry B. Đây là retry amplification — khi B thật sự quá tải (chứ không phải ngẫu nhiên chậm 30%), mỗi tầng retry là một hệ số nhân lên tải của B, đúng lúc B cần ít tải nhất. Cột "B dừng sớm" 140 trông như điều tốt, nhưng đó là A tự huỷ B sau 300 ms rồi gọi lại — không phải vì người dùng đã bỏ đi.
Kịch bản 4 — deadline xuyên suốt. 180/200 thành công (20 lần cả hai lượt đều gặp B chậm — xác suất 0,3 × 0,3 = 9%, khớp). p99 255 ms: chưa bao giờ vượt ngân sách quá 5 ms. B nhận 1,3 request mỗi request người dùng — chỉ retry một lần, ở một tầng, trong ngân sách. A làm vô ích 0 lần, và 80 lần B dừng sớm thật sự vì người dùng đã bỏ: gateway huỷ → A huỷ → B huỷ, cả chuỗi dừng cùng một lúc.
Vì sao timeout là ngân sách chứ không phải con số
Timeout đặt ở mỗi tầng trả lời câu hỏi sai: "tôi sẵn sàng chờ tầng dưới bao lâu?". Câu hỏi đúng là "người dùng còn sẵn sàng chờ bao lâu?", và câu trả lời đó thay đổi theo thời gian trôi qua. Nếu gateway có 250 ms và đã dùng 180 ms cho xác thực và gọi service khác, thì A chỉ còn 70 ms — bất kể cấu hình của A nói gì. Chỉ có cách truyền con số đó xuống (header, metadata gRPC) và để mỗi tầng tự trừ đi phần mình đã dùng.
Và huỷ phải đi ngược lên: khi tầng trên bỏ cuộc, mọi tầng dưới phải biết. Trong Go, đó là r.Context() — net/http huỷ nó khi client ngắt kết nối, và nếu bạn truyền nó xuống mọi lời gọi ra ngoài (HTTP, database, Redis), cả chuỗi dừng miễn phí. Một context.Background() ở giữa chuỗi là chỗ ngắt dây: từ đó trở xuống không ai biết người dùng đã đi.
Đánh đổi cần cân nhắc
Retry ở một tầng, và tầng đó phải biết lỗi nào đáng retry. Kịch bản 4 chỉ retry ở gateway. Quy tắc chung: retry ở tầng ngoài cùng (nơi biết ngân sách người dùng) hoặc tầng trong cùng (nơi biết lỗi của phụ thuộc cụ thể), không bao giờ cả hai. Và chỉ retry lỗi tạm thời — timeout, 503, lỗi kết nối — chứ không retry 4xx, như phần 3 đã đo. Với request ghi, retry cần khoá idempotency ở phần 2, nếu không "thử lại" là "tạo đơn đôi".
Lần đầu ngắn hay dài. Gateway trong demo giới hạn lần đầu 120 ms để chừa chỗ cho lần hai. Đổi lại, 120 ms có thể cắt ngang một request lẽ ra thành công ở 150 ms. Chọn con số này từ phân phối độ trễ thật: đặt lần đầu ở p95–p99 của đường đi bình thường, phần còn lại cho lần hai. Một biến thể là hedged request — gửi lần hai song song sau p95 mà không huỷ lần đầu, lấy cái về trước — đổi thêm tải lấy độ trễ đuôi thấp hơn.
Huỷ không phải lúc nào cũng an toàn. B dừng giữa chừng khi context bị huỷ là tốt với request đọc; với request ghi, dừng giữa chừng có thể để lại trạng thái dở dang. Chỗ ghi cần hoặc giao dịch (database tự rollback khi kết nối đóng), hoặc cố ý không huỷ bước commit cuối — dùng context.WithoutCancel cho đúng đoạn đó và để phần còn lại vẫn huỷ được.
Ngân sách qua header là thoả thuận, không phải cưỡng chế. A có thể bỏ qua X-Deadline-Ms; gRPC chuẩn hoá grpc-timeout nên mọi thư viện đều đọc, còn với REST thì phải tự quy ước và ghi vào hợp đồng API. Phần cưỡng chế được là context: dù A bỏ qua header, gateway ngắt kết nối vẫn huỷ r.Context() của A — với điều kiện A truyền nó xuống.
Số đo ba service trong một tiến trình. Độ trễ mạng giữa các tầng gần bằng 0, nên 5 ms "chi phí mạng" trừ trong header là lạc quan; qua mạng thật, phần trừ phải lớn hơn và tính cả serialize. Kết luận về số lần làm việc vô ích và hệ số nhân retry không phụ thuộc điều đó.
Ba ý mang về
- Timeout là một ngân sách đi cùng request, không phải một con số ở mỗi tầng: mỗi tầng tự đặt là gateway bỏ đi lúc 250 ms còn A vẫn chờ B tới 400 ms — 61 lần làm việc vào hư không, tài nguyên bị chiếm cho request không ai cần.
- Retry chỉ ở một tầng, trong ngân sách: retry ở mọi tầng cho 194/200 thành công nhưng p99 771 ms, B nhận gấp 2,1 lần (trần 9 lần), và 98 lần làm việc vô ích — hệ số nhân đó đánh vào B đúng lúc B yếu nhất.
- Huỷ phải truyền ngược lên qua context:
r.Context()ở mọi lời gọi ra ngoài làm cả chuỗi dừng khi người dùng bỏ đi (80 lần B dừng sớm, 0 việc vô ích); mộtcontext.Background()ở giữa là chỗ ngắt dây.
Nguồn
- Google SRE Book — Handling Overload, mục Deadlines and Deadline propagation: https://sre.google/sre-book/addressing-cascading-failures/
- gRPC — Deadlines (
grpc-timeouttruyền qua metadata): https://grpc.io/docs/guides/deadlines/ - Go blog — Go Concurrency Patterns: Context: https://go.dev/blog/context
- Go docs — net/http: Request.Context (huỷ khi client ngắt kết nối): https://pkg.go.dev/net/http#Request.Context
- Marc Brooker — Timeouts, retries and backoff with jitter (AWS Builders' Library): https://aws.amazon.com/builders-library/timeouts-retries-and-backoff-with-jitter/
- Jeff Dean, Luiz Barroso — The Tail at Scale (hedged requests): https://research.google/pubs/the-tail-at-scale/
Phần sau là phần cuối: gom mười một phép đo thành một khung thiết kế và một checklist rà soát API trước khi lên production.
