Đến giờ sê-ri này đo từng request một. Phần này đo hình dạng của dữ liệu — vì một màn hình hiếm khi cần đúng một tài nguyên. Nó cần danh sách review và sản phẩm của từng review, đơn hàng và khách hàng và địa chỉ giao. Khi hình dạng client cần không khớp hình dạng endpoint trả, client tự ghép bằng cách gọi thêm — và đó là N+1, lần này không ở tầng ORM mà ở tầng HTTP, nơi mỗi lần gọi thêm tốn một vòng đi-về qua mạng thật.
Năm cách lấy cùng một màn hình
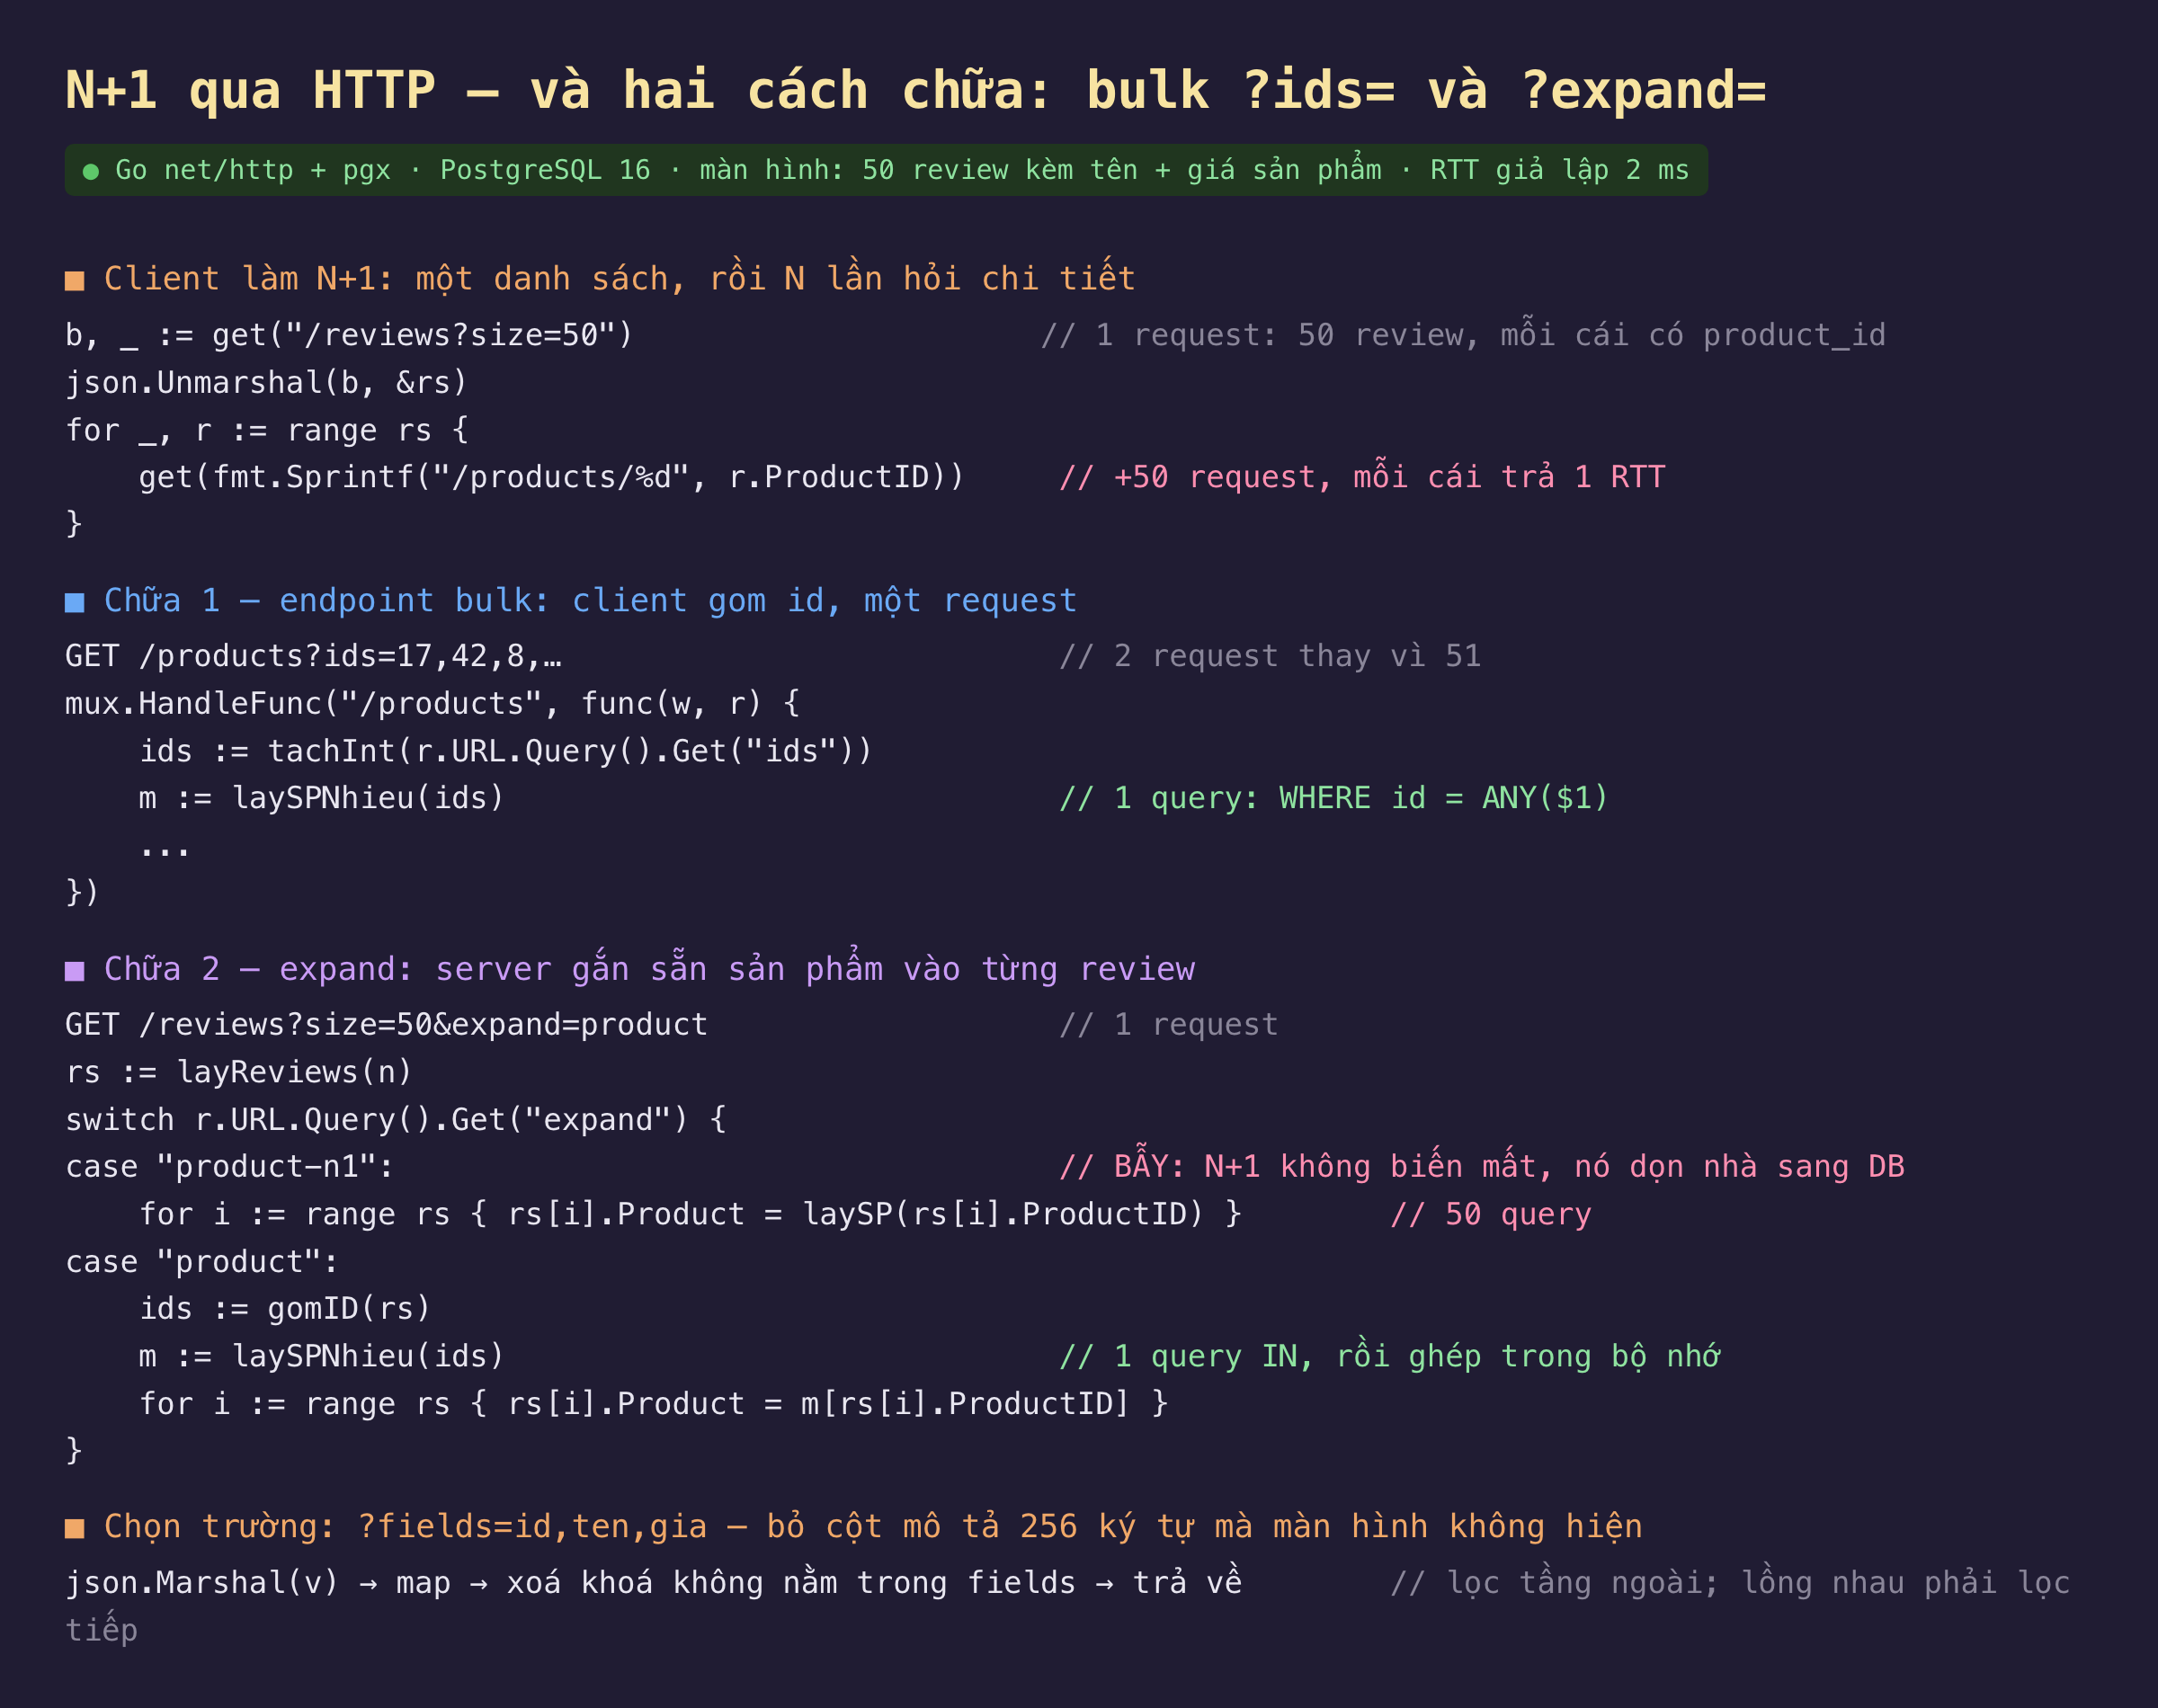
Hình 1: Client N+1, endpoint bulk, endpoint expand với hai cách cài — một cách chỉ chuyển N+1 từ HTTP sang database — và lọc trường.
Server Go nối PostgreSQL, bảng reviews 400.000 dòng và products 50.000 dòng. Mỗi request server ngủ 2 ms để giả lập độ trễ mạng — vì qua loopback, N+1 trông vô hại, và đó chính là lý do nó sống sót qua môi trường dev.
Đo thật: 51 request so với 1
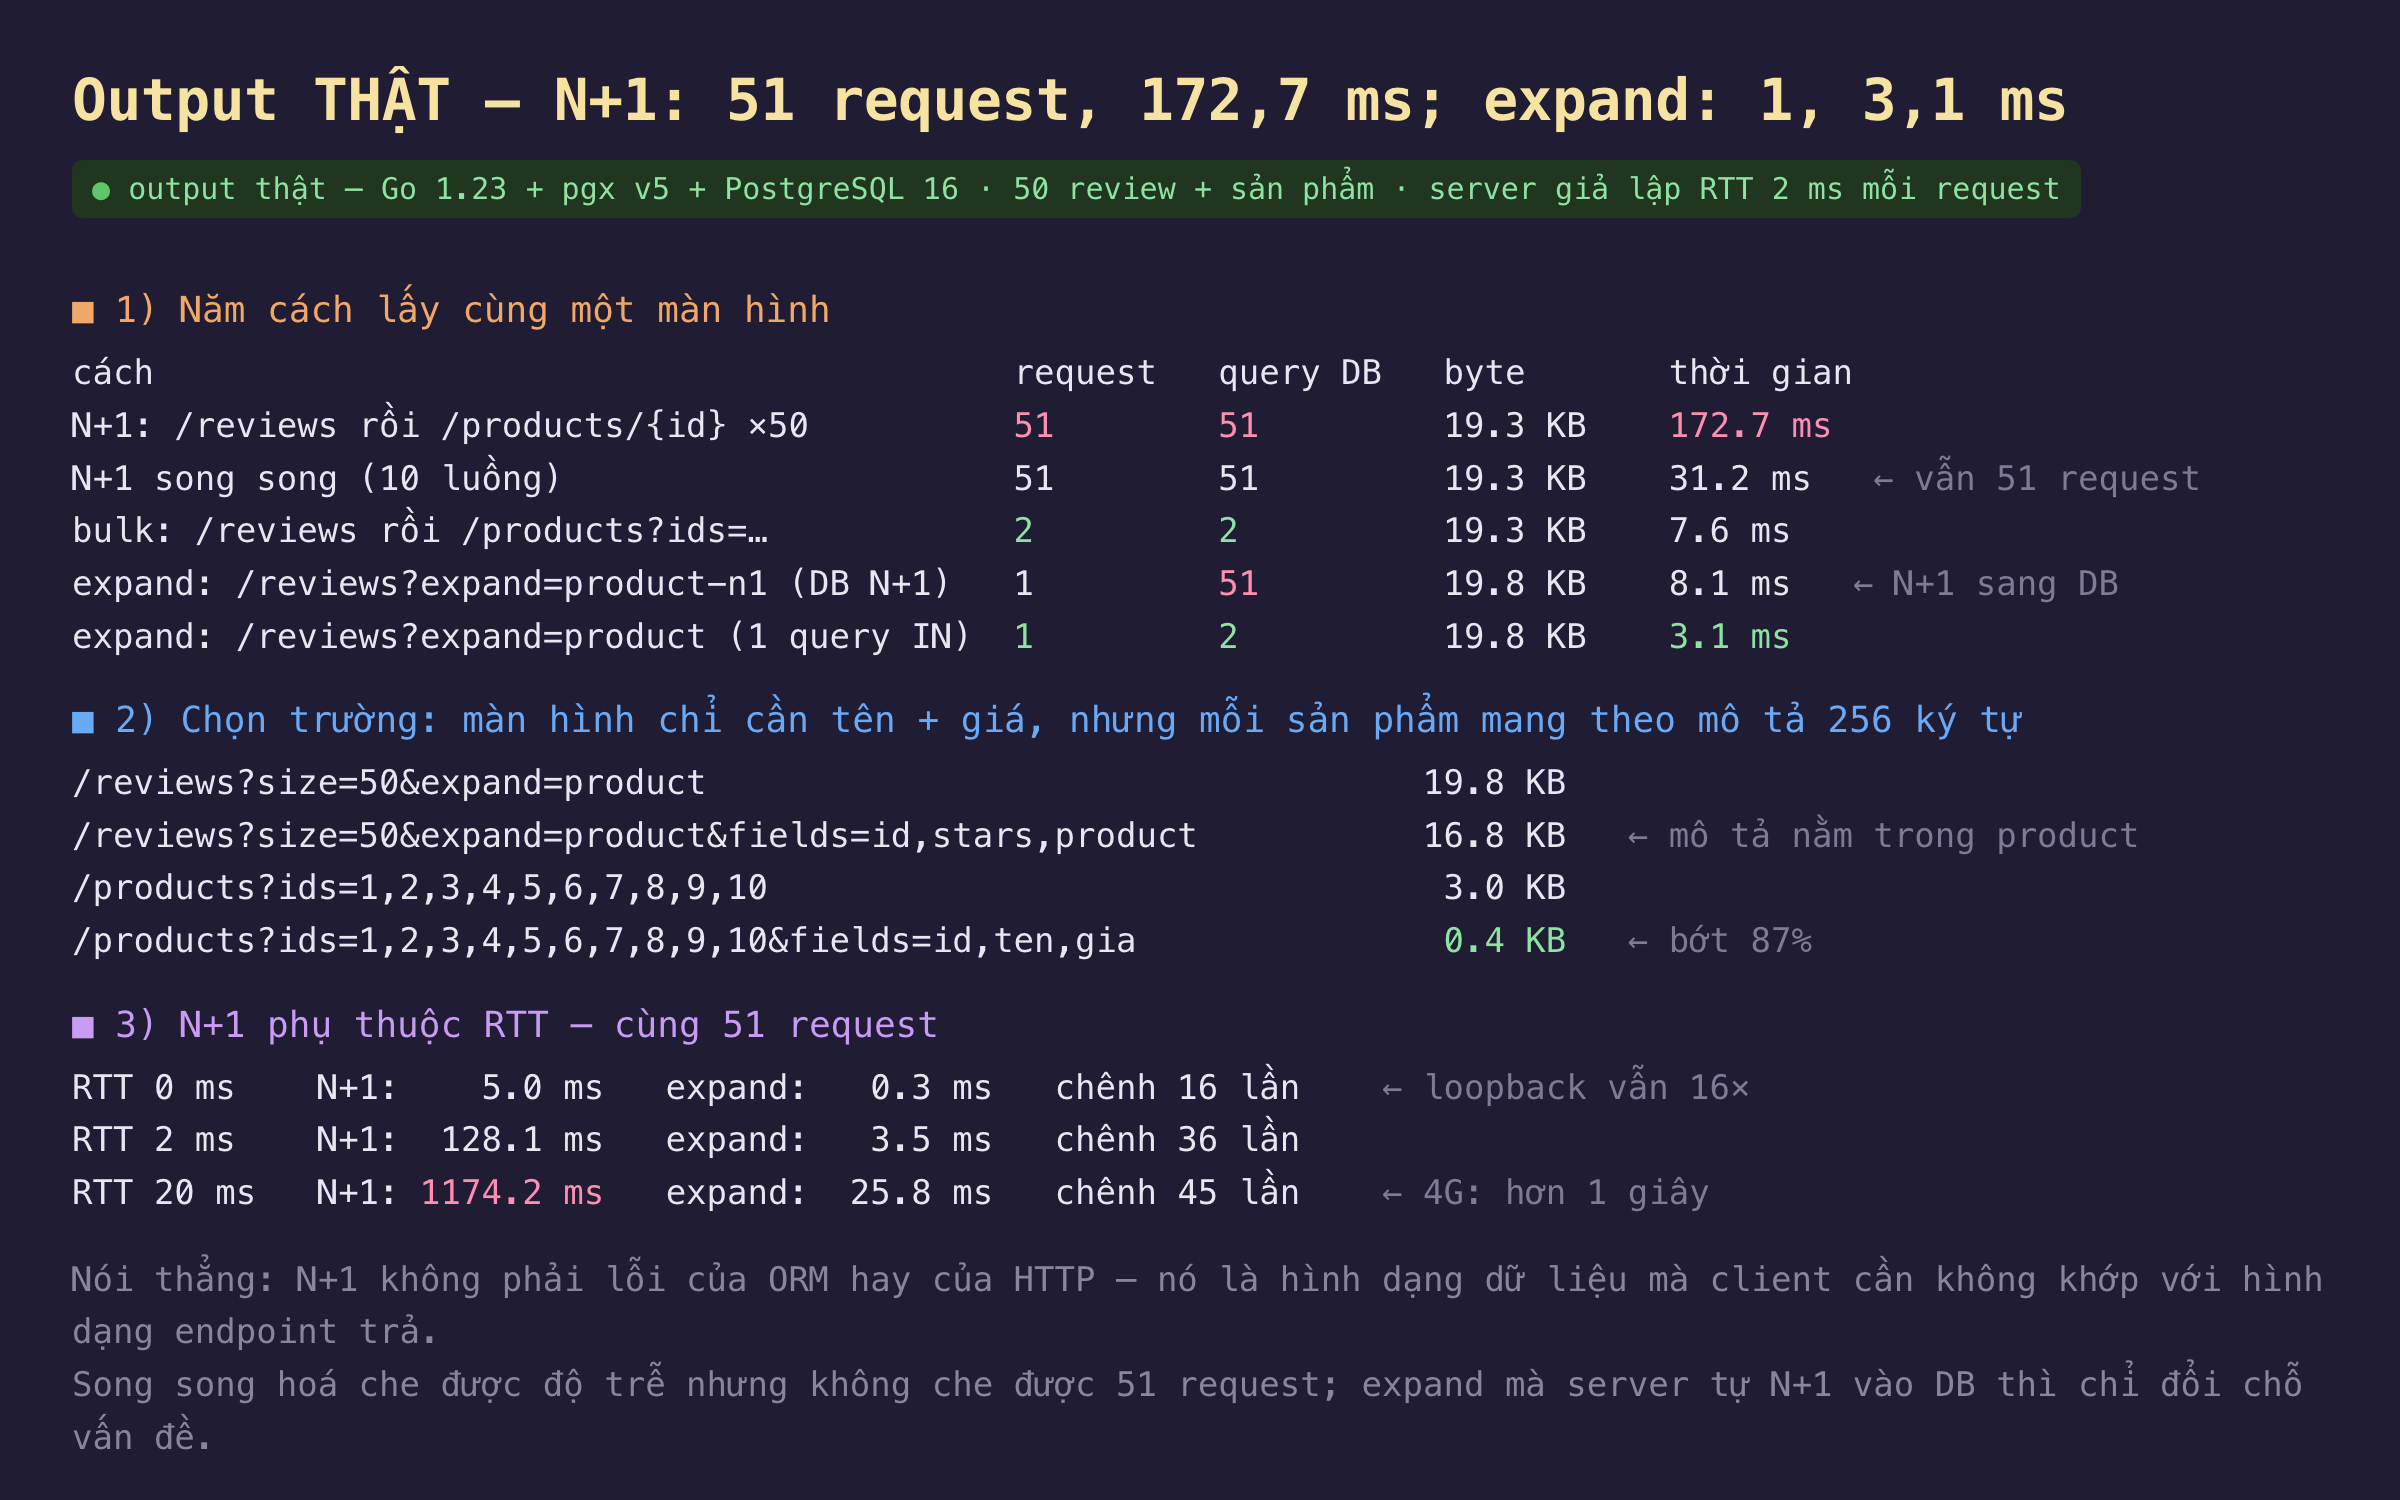
Hình 2: Kết quả thật. Cột "query DB" là thứ bảng đo thông thường không hiện, và là chỗ cách cài expand thứ nhất lộ ra.
| cách | request | query DB | thời gian |
|---|---|---|---|
| N+1 tuần tự | 51 | 51 | 172,7 ms |
| N+1 song song 10 luồng | 51 | 51 | 31,2 ms |
bulk ?ids= |
2 | 2 | 7,6 ms |
| expand, server lặp từng sản phẩm | 1 | 51 | 8,1 ms |
| expand, server gom một query IN | 1 | 2 | 3,1 ms |
N+1 tuần tự là 172,7 ms cho 50 dòng. 51 request × (2 ms RTT + xử lý) — con số gần như hoàn toàn là thời gian chờ mạng, cộng dồn vì các request nối đuôi nhau. Đây là cách client "tự nhiên" viết khi API chỉ có /reviews và /products/{id}: không ai cố ý làm chậm, nó chỉ là hình dạng endpoint buộc client phải làm vậy.
Song song hoá giảm xuống 31,2 ms, nhưng vẫn 51 request. Mười luồng che được phần lớn độ trễ, và nhiều client dừng ở đây vì "đã nhanh". Server thì không thấy khác gì: vẫn 51 lần phân tích HTTP, 51 lần xác thực, 51 query, 51 lần serialize. Nhân với số người dùng, đó là tải gấp 50 lần cho cùng một màn hình — và là tải dồn cục, vì 10 request đến cùng lúc.
Bulk ?ids= giảm xuống 2 request, 7,6 ms. Client vẫn phải ghép, nhưng chỉ gọi thêm một lần. Cách này giữ endpoint /products độc lập (cache được riêng, dùng lại cho mọi màn hình cần sản phẩm) và không bắt server biết client sẽ cần gì.
Expand giảm xuống 1 request — với điều kiện. ?expand=product bảo server gắn sản phẩm vào từng review. Cài theo cách hiển nhiên — lặp qua 50 review, mỗi review query một sản phẩm — cho 8,1 ms và 51 query: N+1 không biến mất, nó chuyển từ HTTP sang database, nơi mỗi query rẻ hơn (không có 2 ms RTT) nhưng vẫn là 51 lần. Gom id rồi một query WHERE id = ANY($1) cho 3,1 ms và 2 query. Hai bản có cùng URL, cùng thân phản hồi, cùng test xanh — chỉ khác cột mà ít ai đo.
Mục 3: N+1 phụ thuộc RTT, và dev không thấy
Cùng 51 request với RTT 0 (loopback thuần), 2 ms, 20 ms:
- RTT 0: N+1 5,0 ms, expand 0,3 ms — chênh 16 lần, nhưng 5 ms thì không ai để ý.
- RTT 2 ms (cùng datacenter): 128 ms so với 3,5 ms.
- RTT 20 ms (4G tốt): 1,17 giây so với 25,8 ms.
Máy dev chạy server và client cùng chỗ, nên N+1 là 5 ms và vô hình. Người dùng trên điện thoại thấy hơn một giây cho một danh sách 50 dòng. Khoảng cách 16 lần ở loopback đã là dấu hiệu — tỉ lệ không đổi, chỉ có đơn vị đổi — nhưng phải đo bằng số request chứ không phải bằng cảm giác nhanh chậm.
Chọn trường: byte không hiện lên màn hình
Mục 2 đo một chuyện khác: mỗi sản phẩm mang theo cột mô tả trung bình 256 ký tự mà màn hình danh sách không hiện. ?fields=id,ten,gia trên endpoint bulk cắt 3,0 KB xuống 0,4 KB — bớt 87%. Nhưng trên ?expand=product, fields=id,stars,product chỉ cắt 19,8 xuống 16,8 KB, vì bộ lọc trong demo chỉ làm việc ở tầng ngoài và mô tả nằm trong product. Lọc trường có ích phải lọc được lồng nhau (fields=id,stars,product.ten,product.gia), và đến mức đó thì bạn đang viết một ngôn ngữ truy vấn nhỏ — GraphQL là điểm đến logic của con đường này, với mọi cái giá của nó.
Đánh đổi cần cân nhắc
Bulk hay expand. Bulk giữ tài nguyên tách bạch, cache tốt, và client tự quyết; cái giá là client phải viết logic ghép và vẫn tốn một vòng đi-về thêm. Expand cho client đúng hình dạng nó cần trong một request; cái giá là server phải biết các tổ hợp (expand=product,customer) và mỗi tổ hợp là một đường code cần test — đặc biệt là test số query, như mục 1 cho thấy. Thực tế thường có cả hai: expand cho vài tổ hợp phổ biến, bulk cho phần còn lại.
Expand cần giới hạn. ?expand=product.category.parent lồng ba tầng là một query join ba bảng cho mỗi request, và người gọi không trả tiền cho nó. Giới hạn độ sâu (thường 1–2) và giới hạn size của danh sách gốc — ?size=5000&expand=product là một request tạo ra 5.000 dòng × nhiều KB.
Bulk cần giới hạn số id. ?ids= với 10.000 id là một URL dài vượt giới hạn proxy (thường 8 KB) và một query IN khổng lồ. Chặn ở 100–200 id và trả 400 kèm thân lỗi theo phần 3 khi vượt; client cần nhiều hơn thì chia lô.
Mục "query DB" phải nằm trong test. Hai bản expand ở mục 1 không phân biệt được bằng bất kỳ test hành vi nào. Cách bắt: đếm query trong test tích hợp và assert <= 2 cho endpoint danh sách — hoặc bật log query chậm với ngưỡng thấp trong CI. Đây là lý do số đo trong bài này có cột đó.
Số đo RTT là giả lập bằng time.Sleep. Nó mô phỏng đúng phần chờ nhưng không mô phỏng TCP slow start, HTTP/2 multiplexing hay giới hạn kết nối đồng thời của trình duyệt (6 mỗi host với HTTP/1.1 — tức "song song 10 luồng" ở mục 1 là lạc quan hơn thực tế trình duyệt). Kết luận về số request thì không phụ thuộc mô phỏng.
Ba ý mang về
- N+1 qua HTTP là 51 request và 172,7 ms cho 50 dòng ở RTT 2 ms, 1,17 giây ở RTT 20 ms — vô hình ở máy dev (5 ms) vì chỉ đơn vị đổi, tỉ lệ 16–45 lần thì không. Đo bằng số request, không bằng cảm giác.
- Expand chỉ chữa N+1 nếu server gom id thành một query IN: bản lặp từng sản phẩm có cùng URL, cùng thân, cùng test xanh, và 51 query thay vì 2. Cột "số query" phải nằm trong test tích hợp.
- Bulk
?ids=và?fields=là hai công cụ rẻ, có giới hạn: bulk cắt 51 request còn 2 mà không đụng hình dạng tài nguyên;fieldscắt 87% byte khi lọc đúng tầng — và cả hai cần trần (số id, độ sâu expand, size) để không thành một query khổng lồ do client điều khiển.
Nguồn
- Stripe docs — Expanding Responses: https://docs.stripe.com/expand
- Zalando — RESTful API Guidelines, mục Support filtering of resource fields và embedding: https://opensource.zalando.com/restful-api-guidelines/#157
- Google API Design Guide — Partial response (
fields): https://cloud.google.com/apis/design/design_patterns#partial_response - PostgreSQL docs — Row and Array Comparisons (
= ANY): https://www.postgresql.org/docs/16/functions-comparisons.html - Bài cùng blog về N+1 ở tầng SQL: /posts/sql-05-n-plus-1
Phần sau sang chiều ngược lại — dữ liệu client gửi lên: kiểm tra ở biên hay ở tầng nghiệp vụ, trả lỗi theo trường, và đo xem validation sớm tiết kiệm được bao nhiêu công việc phía sau.
