Phân trang là tính năng thường được viết trong năm phút rồi không ai nhìn lại, vì ở trang 1 nó luôn chạy tốt. Nó chỉ lộ ra khi một client lật tới trang 5.000, hoặc khi một job xuất dữ liệu quét hết bảng theo từng trang — và lúc đó nó không chậm, nó chậm dần theo đúng số trang đã lật. Bài mở đầu sê-ri này đo hai cách phân trang trên cùng một bảng, cùng một server, để biết chênh lệch thật là bao nhiêu và từ đâu ra.
Hai câu SQL, cùng một endpoint
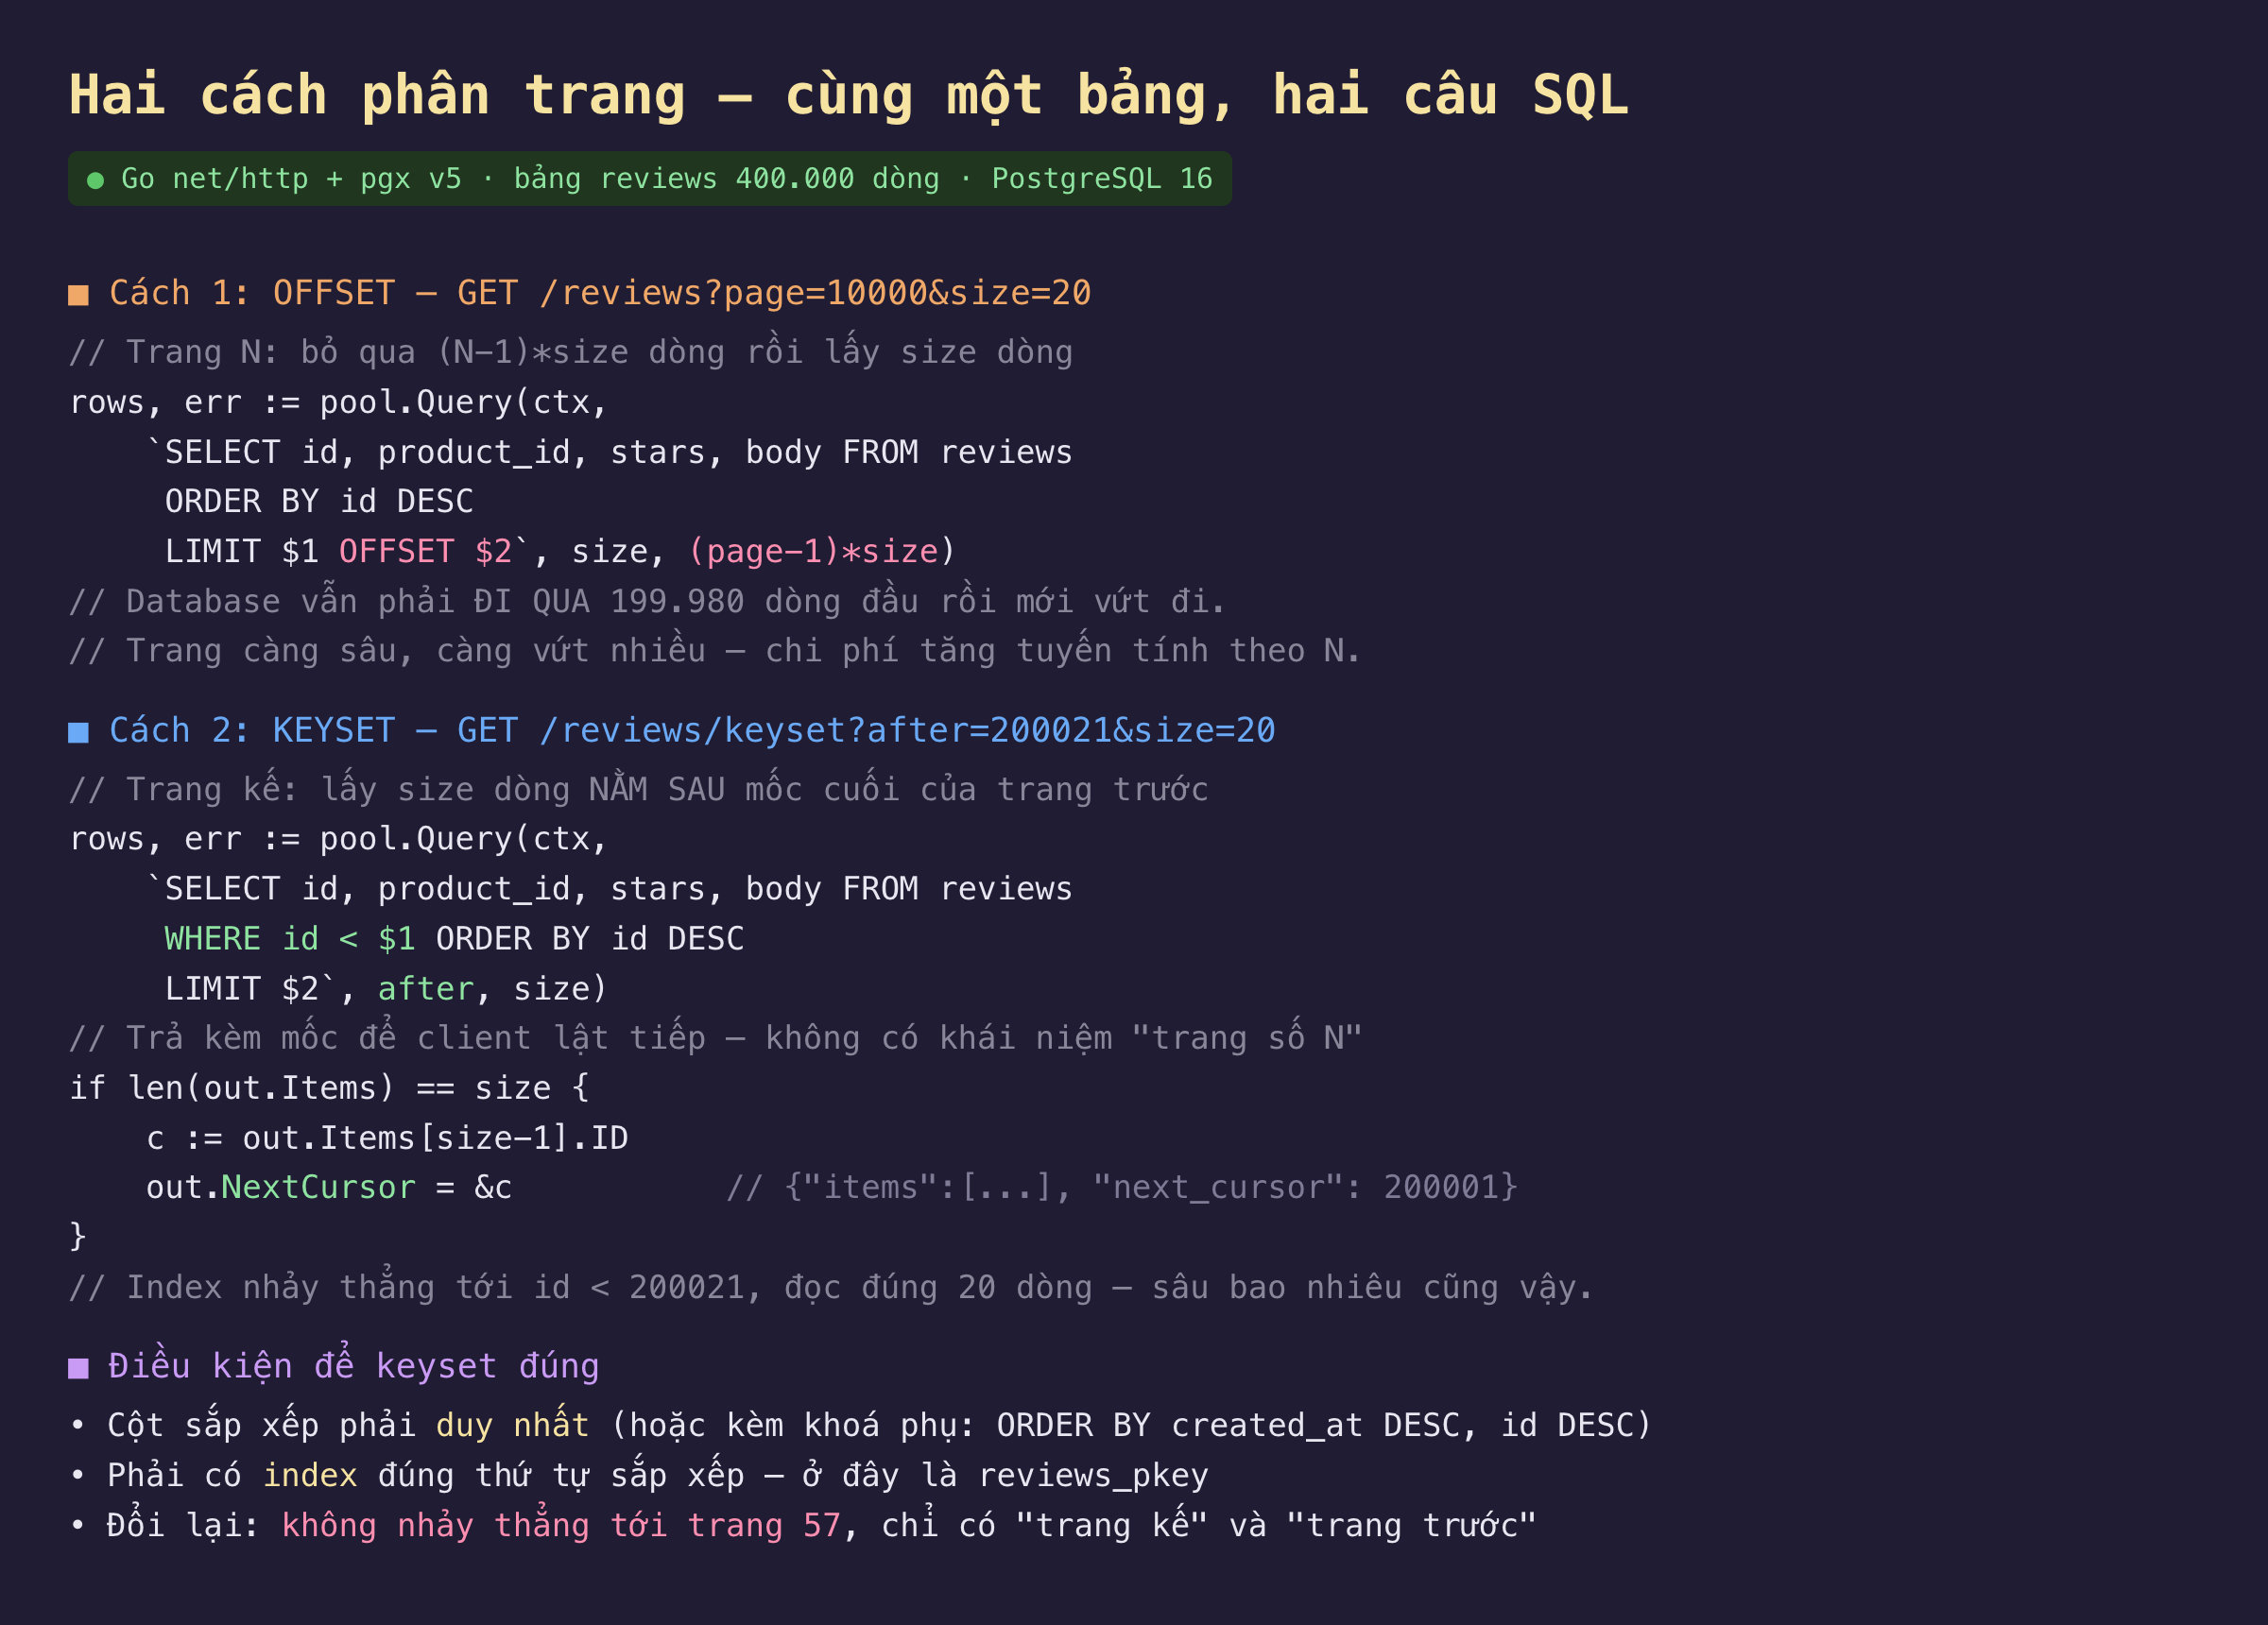
Hình 1: Hai handler. Cách 1 nhận số trang, cách 2 nhận mốc của trang trước và trả mốc cho trang sau.
Cách 1 là cách ai cũng viết đầu tiên: client gửi ?page=10000&size=20, server tính OFFSET (page-1)*size. Cách 2 — gọi là keyset hay cursor — không có khái niệm "trang số N": client gửi ?after=200021, tức id cuối cùng nó đã thấy, và server trả 20 dòng tiếp theo kèm next_cursor để lật tiếp.
Hai câu SQL khác nhau đúng một mệnh đề: OFFSET $2 so với WHERE id < $1. Toàn bộ chênh lệch ở phần sau nằm trong một mệnh đề đó.
Đo thật: chênh 90 lần ở trang cuối
Server Go dùng net/http và pgx, bảng reviews có 400.000 dòng với khoá chính id. Mình gọi qua HTTP thật (loopback), mỗi điểm đo 30 lần và lấy p50/p99:
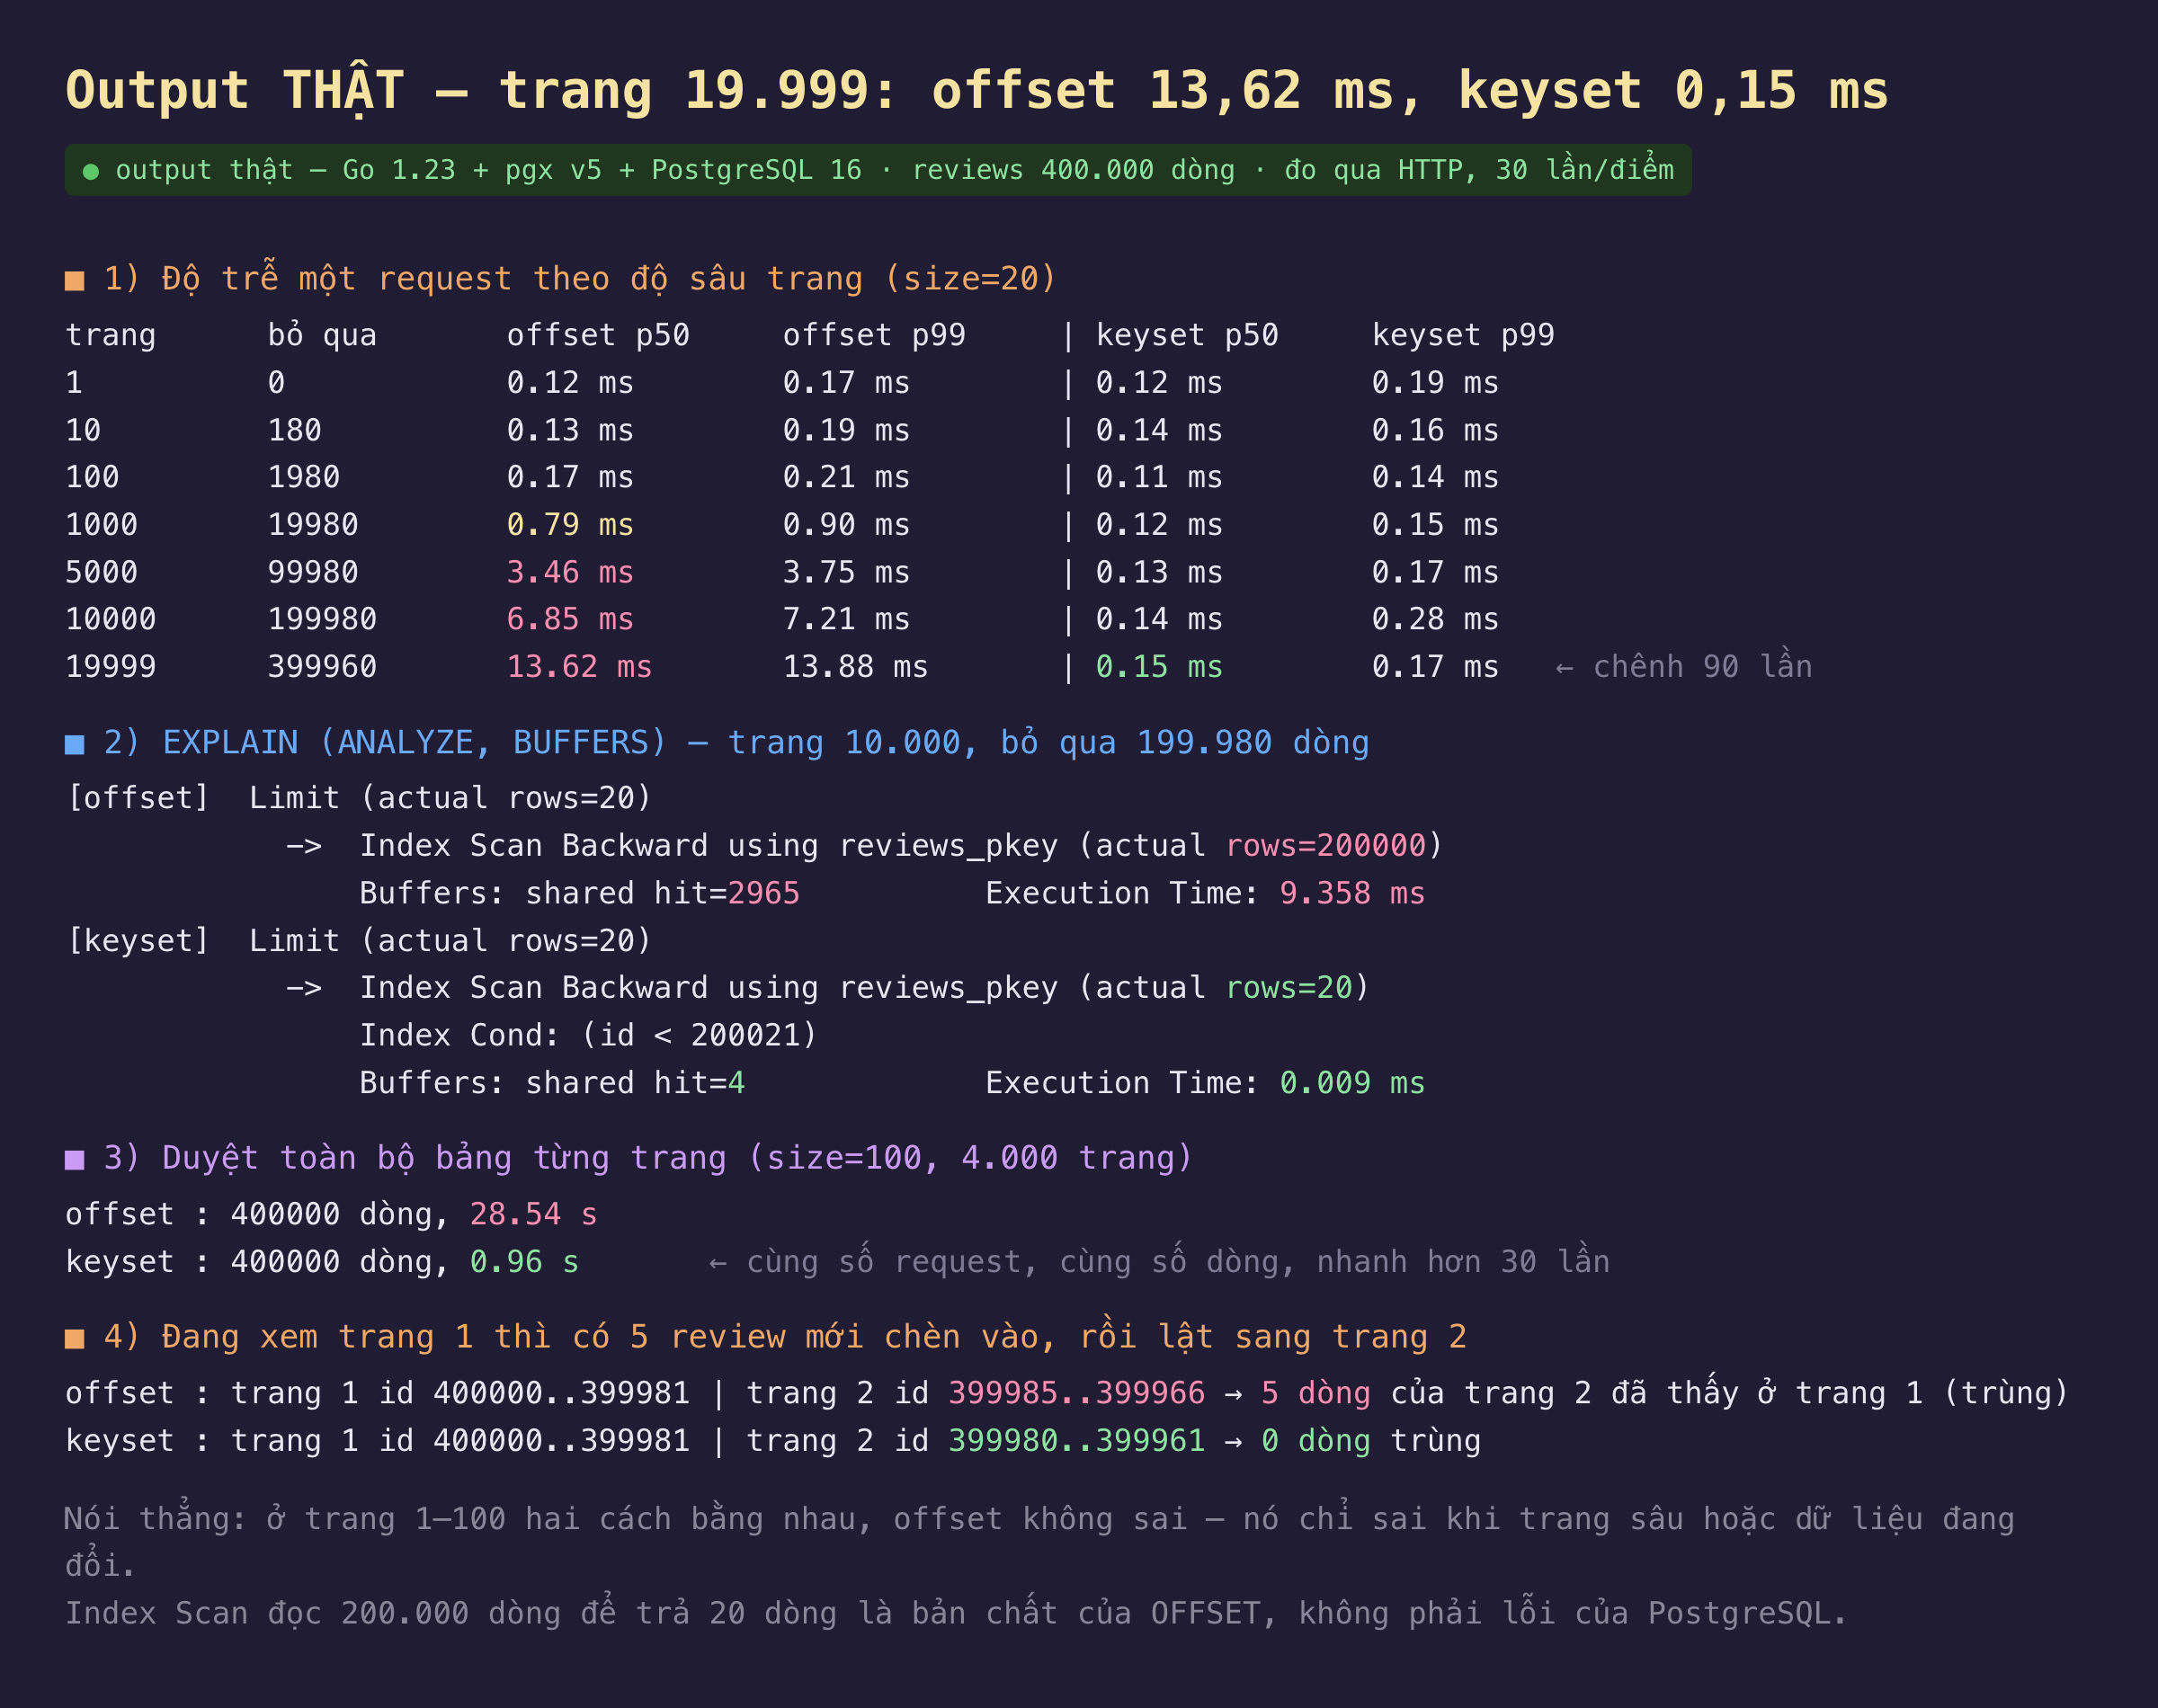
Hình 2: Kết quả thật. Bốn phép đo: độ trễ theo độ sâu, kế hoạch thực thi, duyệt cả bảng, và chuyện gì xảy ra khi có dữ liệu mới.
Ở trang 1 tới 100, hai cách không khác nhau — đều quanh 0,12–0,17 ms, và phần lớn con số đó là chi phí HTTP chứ không phải SQL. Đây là lý do lỗi này sống lâu: mọi bài test thủ công đều dừng ở trang 2.
Từ trang 1.000 trở đi, offset tăng tuyến tính theo số dòng bị bỏ qua. Trang 1.000 mất 0,79 ms, trang 5.000 mất 3,46 ms, trang 10.000 mất 6,85 ms, trang 19.999 mất 13,62 ms. Chia cho số dòng bỏ qua, mỗi dòng tốn khoảng 34 nano-giây — ổn định tới mức có thể dự đoán: muốn biết trang N chậm bao nhiêu, nhân N với 20 rồi nhân 34 ns. Keyset thì không có biến N trong công thức: 0,11–0,15 ms ở mọi độ sâu.
Vì sao: OFFSET là "đọc rồi vứt"
Bảng thứ hai trong Hình 2 là EXPLAIN (ANALYZE, BUFFERS) cho trang 10.000. Hai kế hoạch dùng cùng một index reviews_pkey, cùng Index Scan Backward, cùng nút Limit trả 20 dòng. Khác nhau ở dòng bên dưới:
| offset | keyset | |
|---|---|---|
| Dòng index phải đọc | 200.000 | 20 |
| Buffer (trang 8 KB) chạm tới | 2.965 | 4 |
| Thời gian thực thi | 9,358 ms | 0,009 ms |
OFFSET 199980 không bảo PostgreSQL "nhảy tới vị trí 199.980". Nó bảo "đọc từ đầu, đếm đủ 199.980 dòng rồi vứt đi, sau đó mới bắt đầu trả". Index B-tree không lưu "dòng thứ bao nhiêu" — nó chỉ biết so sánh giá trị — nên không có cách nào nhảy theo số thứ tự. Trong khi WHERE id < 200021 là một phép so sánh giá trị: index tìm vị trí đó bằng vài bước xuống cây, đọc 4 trang, xong.
Nói cách khác, chi phí của offset không phải lỗi của PostgreSQL, mà là định nghĩa của OFFSET. Thêm index, tăng RAM, bật cache — không cái nào đổi được chuyện phải đếm qua 199.980 dòng.
Duyệt cả bảng: 28,5 giây so với 0,96 giây
Phép đo thứ ba là trường hợp thực tế hay gặp hơn "người dùng lật tới trang 10.000": một job đồng bộ, một script xuất CSV, hoặc một client di động cuộn vô hạn — tất cả đều lật tuần tự qua mọi trang. Với size=100, cả hai cách gửi đúng 4.000 request và nhận đúng 400.000 dòng:
- offset: 28,54 giây
- keyset: 0,96 giây
Chênh 30 lần không phải vì request nào của offset cũng chậm, mà vì tổng số dòng bị "đọc rồi vứt" là 0 + 100 + 200 + ... + 399.900 — tức khoảng 800 triệu dòng index được đọc để trả về 400.000 dòng. Đây là lý do một job xuất dữ liệu chạy mượt ở tháng đầu rồi bắt đầu kéo dài hàng giờ khi bảng lớn lên: nó không chậm theo kích thước bảng, nó chậm theo bình phương kích thước bảng.
Chuyện offset sai, không chỉ chậm
Phép đo cuối không liên quan tới hiệu năng. Người dùng mở trang 1 của một feed sắp xếp mới nhất trước (id 400.000 → 399.981). Trong lúc họ đọc, 5 review mới được đăng. Rồi họ bấm "trang 2":
- offset: trang 2 trả id 399.985 → 399.966 — 5 dòng đầu đã nằm ở trang 1. Người dùng thấy lại 5 bài vừa đọc.
- keyset: trang 2 trả id 399.980 → 399.961 — nối đúng vào chỗ trang 1 dừng, không trùng dòng nào.
Lý do: "trang 2" của offset nghĩa là "dòng thứ 21 tới 40 tại thời điểm hỏi", mà sau khi có 5 dòng mới chèn lên đầu, dòng thứ 21 giờ là dòng từng đứng thứ 16. Nếu thay vì chèn là xoá 5 dòng, hiệu ứng ngược lại: người dùng bỏ lỡ 5 bài mà không bao giờ biết. Keyset không có vấn đề này vì mốc là một giá trị ("sau id 399.981"), và giá trị đó không đổi dù bảng thêm bớt bao nhiêu.
Với một feed tin, trùng vài bài chỉ gây khó chịu. Với một job đồng bộ dùng offset để kéo "mọi đơn hàng" sang hệ thống khác, bỏ lỡ dòng là mất dữ liệu — và không có lỗi nào được ghi lại.
Cái giá của keyset
Không nhảy thẳng tới trang 57. Keyset chỉ có "trang kế" và "trang trước", vì để tới trang 57 bạn phải biết id cuối của trang 56. Giao diện có dãy số trang 1 2 3 ... 57 không dựng được bằng keyset thuần. Thực tế, phần lớn giao diện hiện đại không cần dãy số đó — cuộn vô hạn, nút "Tải thêm", API cho client đều là lật tuần tự. Nếu thật sự cần nhảy trang, cách hay dùng là kết hợp: offset cho N trang đầu (nơi nó rẻ, như bảng đo cho thấy tới trang 100 vẫn 0,17 ms) và chặn hoặc chuyển sang keyset khi sâu hơn.
Cột sắp xếp phải duy nhất. WHERE id < $1 đúng vì id không trùng. Sắp theo created_at thì hai dòng cùng giây sẽ làm mốc mơ hồ: WHERE created_at < $1 có thể bỏ sót dòng cùng mốc. Cách chữa là thêm khoá phụ — ORDER BY created_at DESC, id DESC với điều kiện WHERE (created_at, id) < ($1, $2) — và index phải khớp đúng thứ tự cột đó, nếu không PostgreSQL quay về quét tuần tự và lợi thế biến mất.
Mốc lộ ra ngoài là một phần hợp đồng API. Trả next_cursor: 200001 nghĩa là client biết id nội bộ, và có người sẽ tự tính after= thay vì dùng mốc server trả. Nhiều API mã hoá mốc (base64 của một JSON chứa cột và giá trị) để giữ quyền đổi cách phân trang sau này mà không phá client. Cái giá là mốc không còn đọc được bằng mắt khi gỡ lỗi.
Số đo ở đây là loopback và bảng nằm trọn trong cache. 2.965 buffer của offset đều là shared hit, tức đọc từ RAM. Khi bảng lớn hơn shared_buffers và phải đọc đĩa, chi phí mỗi dòng của offset tăng lên nhiều lần, trong khi 4 buffer của keyset thì gần như luôn có sẵn. Chênh 90 lần ở đây là sàn, không phải trần.
Ba ý mang về
- Offset không sai ở trang 1–100, nó sai ở trang sâu: 0,17 ms ở trang 100 nhưng 13,62 ms ở trang 19.999, tăng tuyến tính ~34 ns mỗi dòng bị bỏ qua — vì
OFFSETlà "đọc rồi vứt", và index B-tree không nhảy được theo số thứ tự. - Duyệt cả bảng bằng offset là bình phương: 4.000 trang mất 28,5 giây so với 0,96 giây, do tổng số dòng đọc-rồi-vứt là ~800 triệu cho 400.000 dòng thật. Job xuất dữ liệu, đồng bộ, cuộn vô hạn — luôn dùng keyset.
- Offset còn trả sai khi dữ liệu đang đổi: 5 dòng chèn vào giữa hai lần lật là 5 dòng trùng (hoặc 5 dòng bỏ lỡ nếu là xoá). Keyset dùng giá trị làm mốc nên không bị, đổi lại mất khả năng nhảy thẳng tới trang N và đòi cột sắp xếp duy nhất kèm index khớp.
Nguồn
- PostgreSQL docs — LIMIT and OFFSET: https://www.postgresql.org/docs/16/queries-limit.html
- Markus Winand — Paging Through Results (use-the-index-luke): https://use-the-index-luke.com/sql/partial-results/fetch-next-page
- Markus Winand — We need tool support for keyset pagination: https://use-the-index-luke.com/no-offset
- PostgreSQL docs — EXPLAIN: https://www.postgresql.org/docs/16/using-explain.html
Phần sau chuyển sang chuyện ghi: client gọi POST /orders, mạng đứt sau khi server đã tạo đơn, client retry — làm sao để lần thứ hai không tạo thêm một đơn hàng nữa. Sẽ đo thật với khoá idempotency trong Redis và PostgreSQL.
