Phần 5 sinh dữ liệu ngẫu nhiên để kiểm tính chất nghiệp vụ của hàm thuần. Fuzzing là người anh em cùng họ nhưng khác mục tiêu: không hỏi "kết quả có đúng không" mà hỏi "có đầu vào nào làm nó sập không" — panic, đọc quá biên, treo, tràn số. Nó nhắm vào lớp mã đọc byte từ bên ngoài: parser, decoder, bất cứ thứ gì nhận chuỗi từ người dùng hay từ mạng. Go có fuzzing tích hợp từ 1.18, hướng dẫn bởi độ phủ, và bài này đo nó trên bốn hàm có lỗi thật: tìm ra trong bao lâu, đầu vào thu nhỏ còn gì, seed corpus đổi được bao nhiêu, và chuyện gì xảy ra sau khi sửa.
Bốn hàm đọc đầu vào ngoài
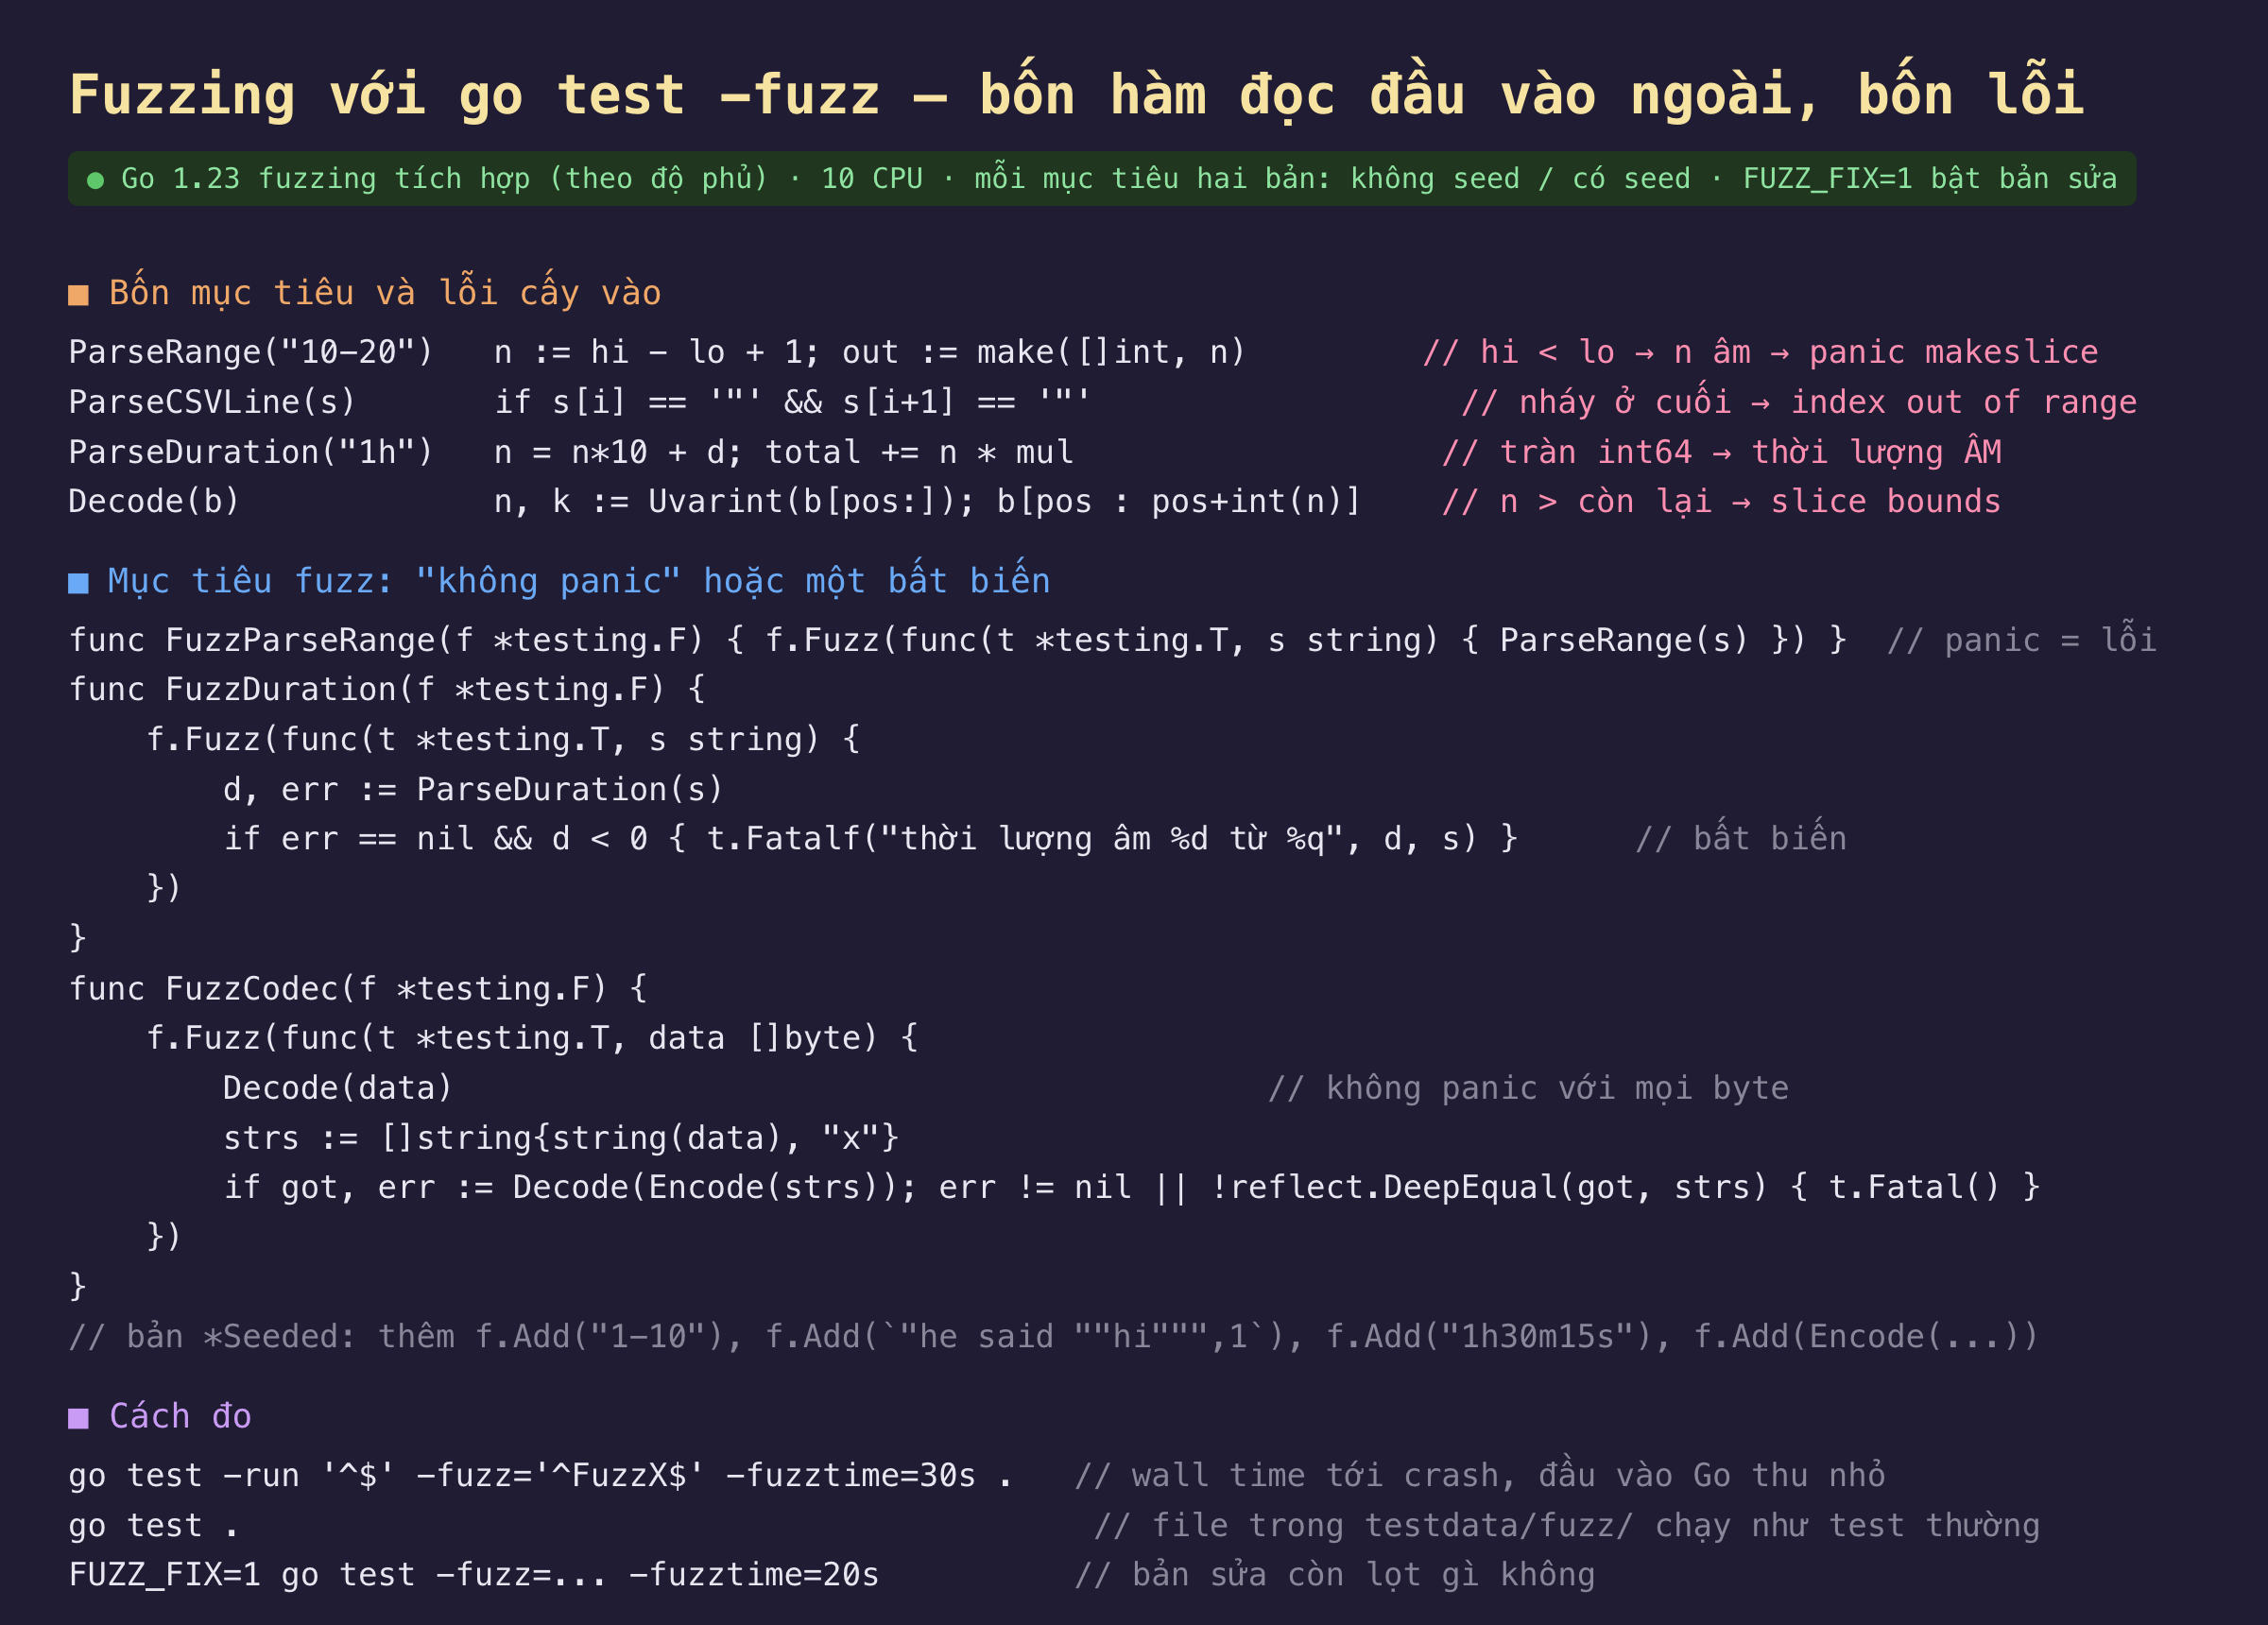
Hình 1: Bốn lỗi điển hình của lớp đọc byte, bốn mục tiêu fuzz chỉ nói "không panic" hoặc một bất biến, và cách đo.
Bốn hàm nhỏ kiểu ai cũng từng viết:
ParseRange("10-20")trả về danh sách trang. Lỗi: không kiểmhi >= lo, nên "7-0" cho độ dài âm vàmakepanic.ParseCSVLinetách một dòng CSV có dấu nháy, với""là nháy thoát. Lỗi: kiểms[i+1]mà không kiểm còn ký tự không — dấu nháy đứng cuối là đọc quá biên.ParseDuration("1h30m")ra số giây. Lỗi:n = n*10 + dkhông kiểm tràn, nên số đủ lớn quay vòng thành âm. Không panic — chỉ là kết quả sai dấu.Decodeđọc định dạng[độ dài uvarint][bytes].... Lỗi: không kiểm độ dài khai báo so với dữ liệu còn lại — một byte 0x30 khai "48 byte" trên dữ liệu dài 1 byte là slice vượt biên.
Mục tiêu fuzz cho ba hàm đầu chỉ là gọi hàm, không panic. ParseDuration cần thêm bất biến: không lỗi thì kết quả không âm. Decode có hai phần: không panic với mọi chuỗi byte, và vòng tròn Decode(Encode(x)) == x. Mỗi mục tiêu có hai bản: không seed (fuzzer bắt đầu từ chuỗi rỗng) và có seed (vài đầu vào thật như "1-10", "he said ""hi""",1, "1h30m15s") để đo seed đáng giá bao nhiêu.
Đo thật: tới crash trong bao lâu, và sau khi sửa
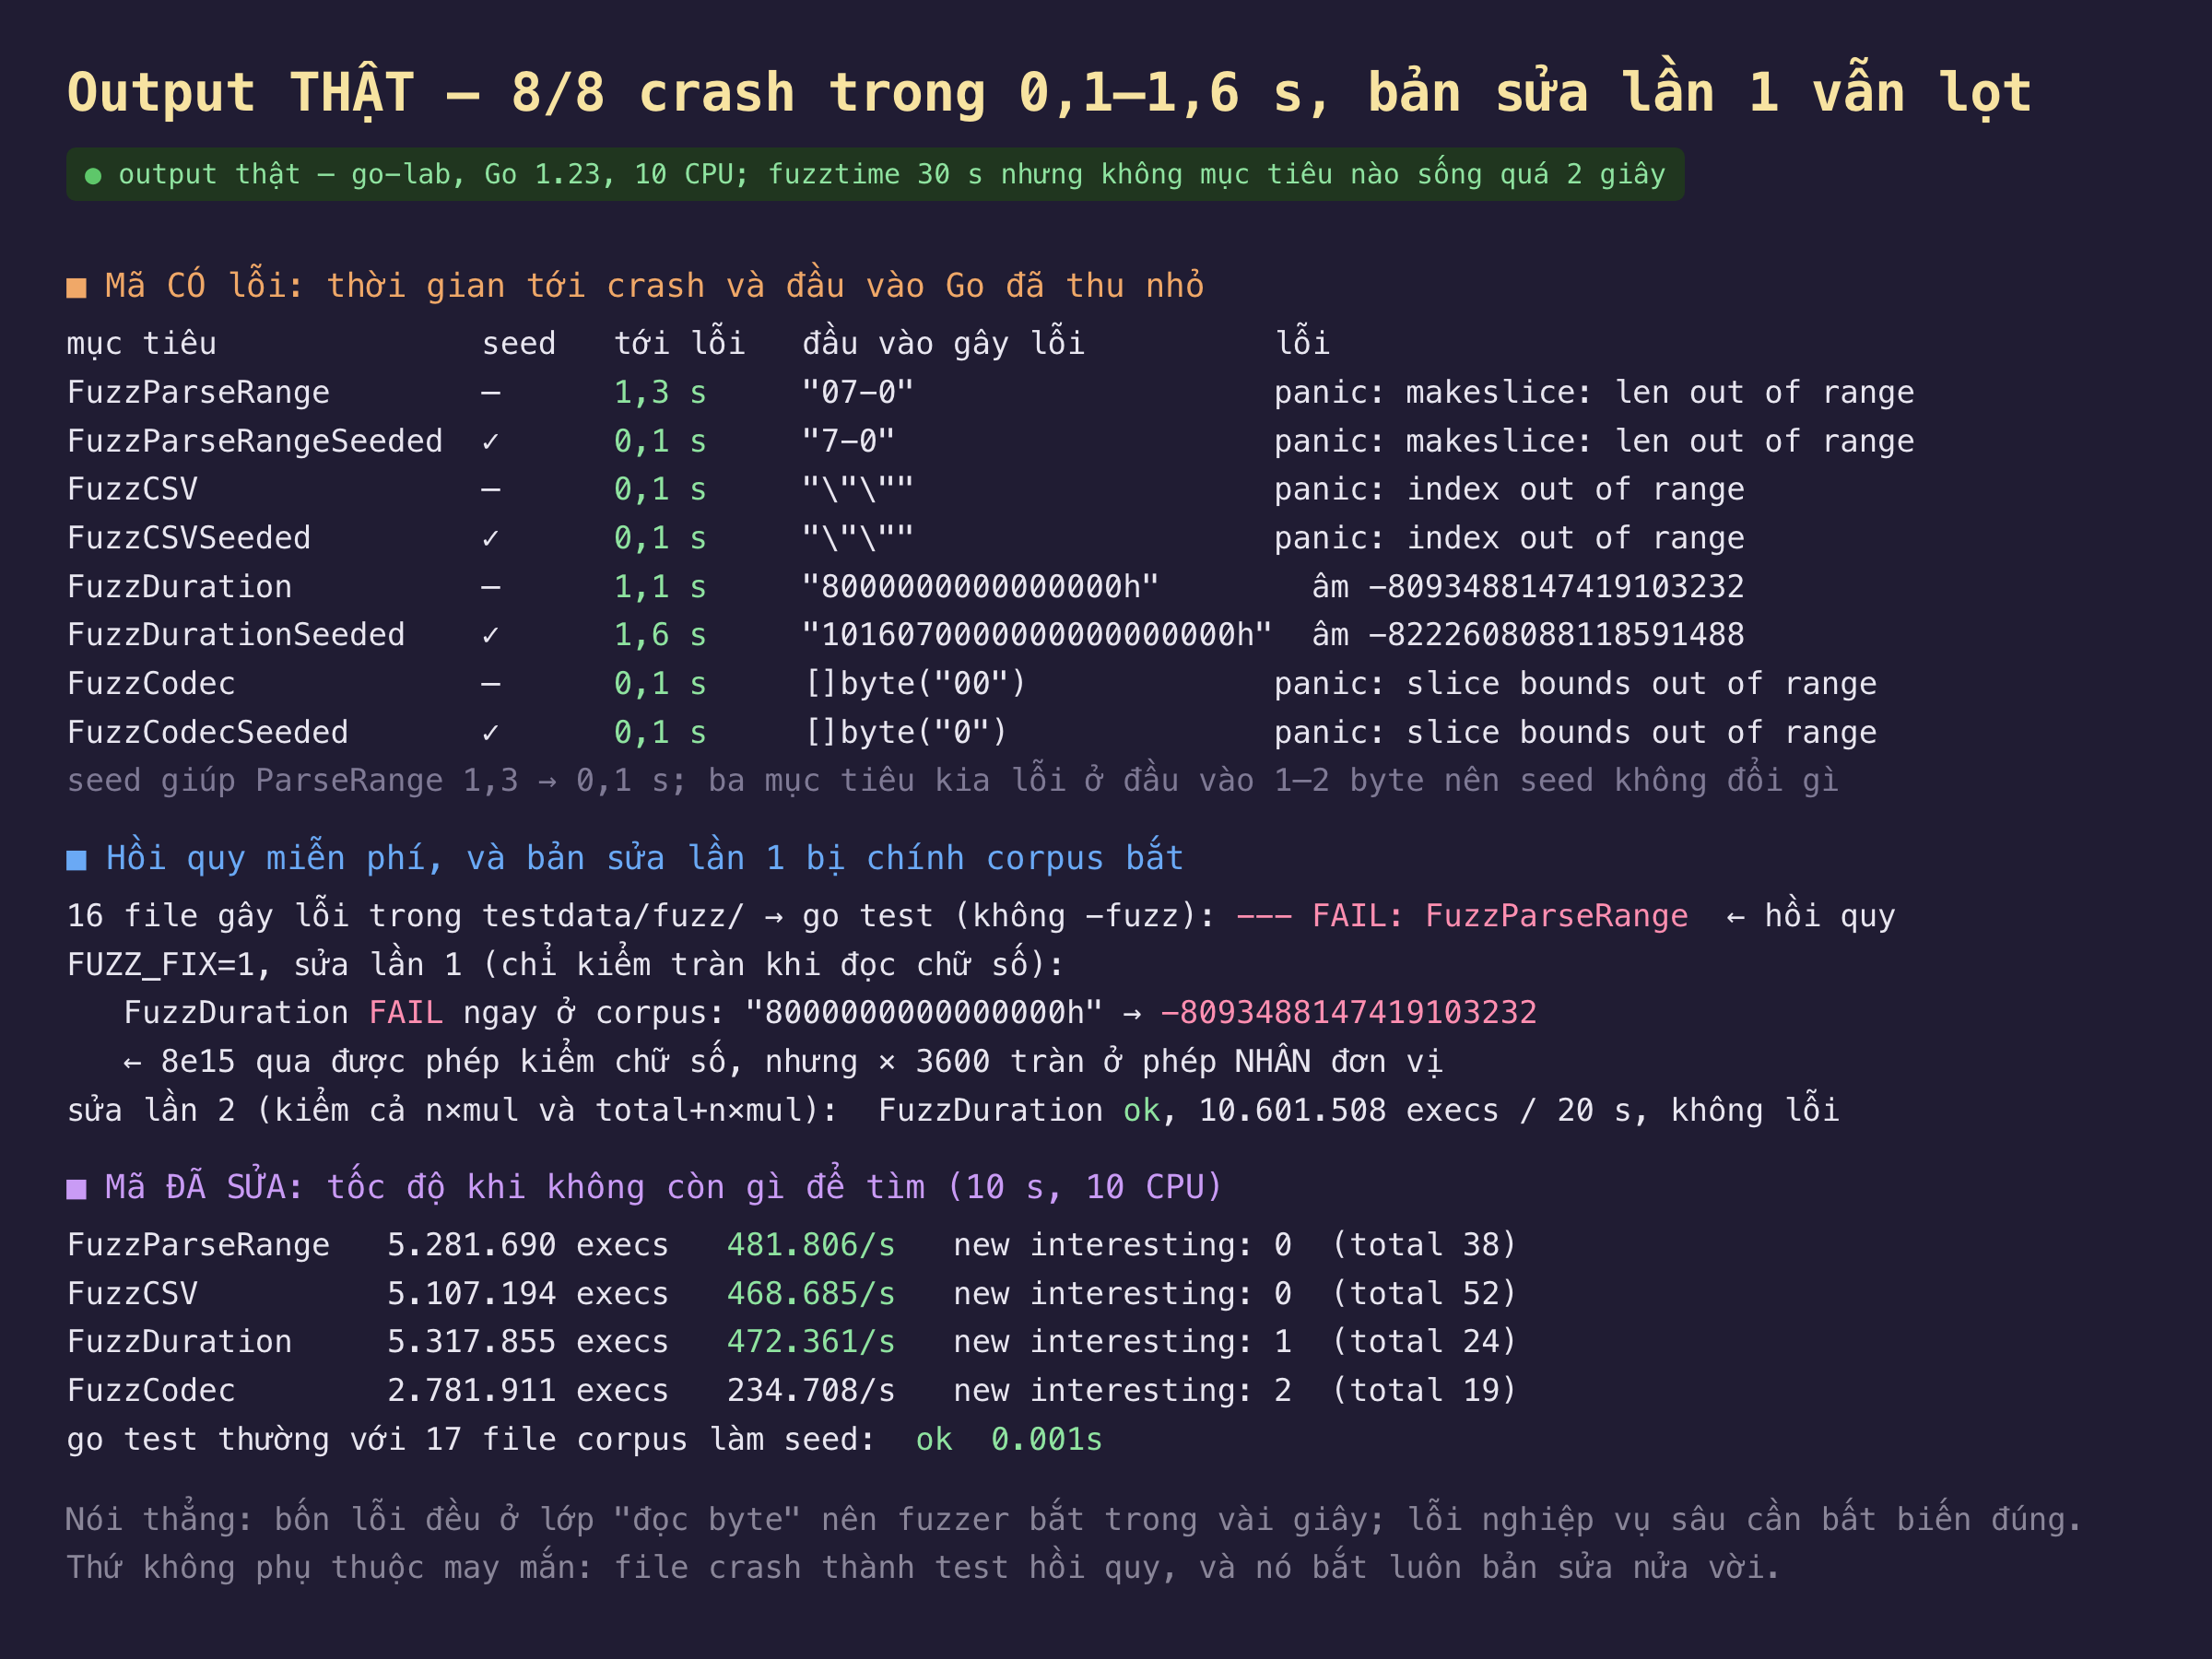
Hình 2: Tám lần fuzz, tám lần crash dưới hai giây. Phần giữa là chuyện đáng nhớ nhất: bản sửa đầu tiên bị chính file crash bắt lại.
| mục tiêu | không seed | có seed | đầu vào thu nhỏ |
|---|---|---|---|
| ParseRange | 1,3 s | 0,1 s | "7-0" |
| CSV | 0,1 s | 0,1 s | "\"\"" |
| Duration | 1,1 s | 1,6 s | "8000000000000000h" |
| Codec | 0,1 s | 0,1 s | []byte("0") |
Tám trên tám crash, không cái nào sống quá hai giây. Giới hạn đặt là 30 giây; fuzzer không cần tới. Lý do: cả bốn lỗi đều nằm ở lớp đọc byte và lộ ra với đầu vào cực ngắn — hai dấu nháy, một byte, "7-0". Fuzzer hướng dẫn bởi độ phủ bắt đầu từ chuỗi rỗng, đột biến từng byte, và giữ lại mọi đầu vào mở ra nhánh mới; với hàm vài chục dòng, nó duyệt hết nhánh trong tích tắc. Đầu vào in ra đã được Go thu nhỏ: "07-0" ở bản không seed, "7-0" ở bản có seed, hai dấu nháy, một byte — đọc là hiểu ngay lỗi ở đâu, không khác gì phản ví dụ của phần 5.
Seed chỉ đáng kể khi cấu trúc đầu vào không tầm thường. ParseRange không seed mất 1,3 giây — fuzzer phải tự "phát hiện" rằng cần một dấu gạch với số ở hai bên; có seed "1-10" thì 0,1 giây. Ba mục tiêu kia không đổi vì lỗi nằm ở đầu vào một hai byte mà đột biến mù cũng chạm tới ngay. Với định dạng thật (JSON, protobuf, một giao thức nhị phân), seed là thứ quyết định fuzzer có tới được phần sâu hay mắc kẹt ở lớp từ chối cú pháp.
File crash thành test hồi quy, không cần làm gì. Go ghi đầu vào gây lỗi vào testdata/fuzz/<tên>/, và go test thường (không -fuzz) chạy mọi file ở đó như ca kiểm bình thường. 16 file sau tám lần fuzz; chạy go test, FuzzParseRange đỏ ngay — lỗi được giữ lại trong repo, chạy trên CI mỗi lần, dù không ai bật fuzz nữa.
Và chính cơ chế đó bắt bản sửa lần một của tôi. Sửa ParseDuration bằng cách kiểm tràn khi đọc chữ số (n > (1<<62)/10 thì từ chối) — trông đủ. Bật bản sửa, chạy lại: FuzzDuration đỏ ngay ở corpus, cùng đầu vào "8000000000000000h": 8×10¹⁵ qua được phép kiểm chữ số, nhưng nhân với 3600 ở bước đổi đơn vị là 2,9×10¹⁹, vượt int64. Lỗi tràn có hai chỗ, tôi chỉ chặn một. Sửa lần hai kiểm cả phép nhân đơn vị lẫn phép cộng tổng: 10,6 triệu lượt trong 20 giây, sạch. Không có file crash lưu lại thì bản sửa nửa vời đã được merge với cảm giác "đã fix".
Tốc độ khi không còn gì để tìm: khoảng 470.000 lượt mỗi giây cho ba hàm chuỗi, 235.000 cho codec (phải cấp phát), trên 10 CPU. "New interesting: 0" sau 10 giây nghĩa là không còn nhánh mới — không phải không còn lỗi, mà là fuzzer không còn thấy đường mới để đi. Đó là lúc tăng thời gian hoặc thêm seed có cấu trúc, không phải lúc kết luận an toàn.
Đánh đổi cần cân nhắc
Fuzzing chỉ tìm được thứ bạn bảo nó tìm. Mặc định là panic và treo; mọi thứ khác cần một bất biến trong mục tiêu — "không âm", "vòng tròn", "không lỗi thì kết quả nằm trong miền". ParseDuration không panic bao giờ; không có dòng d < 0 thì fuzz 30 giây rồi báo sạch. Nghĩ ra bất biến là việc của người, giống phần 5.
Nhắm vào biên hệ thống. Chỗ đáng fuzz là nơi byte từ ngoài đi vào: parser, decoder, xử lý tệp tải lên, header HTTP tự phân tích. Hàm nghiệp vụ nhận struct đã hợp lệ thì PBT hợp hơn — fuzzer sẽ tốn phần lớn thời gian ở lớp từ chối đầu vào.
Chi phí CI: fuzz là vòng lặp vô tận theo thiết kế. Trong pipeline thường chỉ chạy go test (corpus đã lưu, mili-giây); fuzz thật chạy theo lịch riêng với -fuzztime cố định, và mỗi crash mới commit file vào testdata. Cũng cần -parallel/CPU hợp lý: 470.000 lượt/giây ở đây là 10 CPU; CI chia sẻ sẽ chậm hơn nhiều.
Phạm vi đo. Bốn lỗi cấy vào ở tầng nông, nên mọi con số "tới crash" đều nhỏ; chúng cho thấy cơ chế hoạt động, không cho thấy fuzzer tìm được lỗi sâu nhanh thế nào. Thứ bền hơn con số: thu nhỏ đầu vào, corpus thành hồi quy, và việc corpus bắt bản sửa sai.
Ba ý mang về
- Fuzzer tìm lỗi lớp đọc byte trong vài giây với đầu vào thu nhỏ còn vài byte (8/8 crash dưới 2 giây, "7-0", hai dấu nháy, một byte); seed chỉ đáng kể khi đầu vào có cấu trúc.
- File crash trong
testdata/fuzzlà test hồi quy miễn phí, và nó bắt luôn bản sửa nửa vời: sửa lần một chỉ chặn tràn ở chữ số, corpus bắt tràn ở phép nhân đơn vị; sửa lần hai sạch qua 10,6 triệu lượt. - Fuzz chỉ tìm thứ bạn bảo nó tìm: panic là mặc định, còn lại cần bất biến; nhắm vào biên hệ thống, chạy fuzz theo lịch riêng và để
go testthường chỉ chạy corpus.
Nguồn
- Go — Go Fuzzing (tài liệu chính thức): https://go.dev/doc/security/fuzz/
- Go — Tutorial: Getting started with fuzzing: https://go.dev/doc/tutorial/fuzz
- Katie Hockman — Fuzzing is Beta Ready (Go blog, 2021): https://go.dev/blog/fuzz-beta
- Michał Zalewski — American Fuzzy Lop technical whitepaper (nguồn gốc fuzzing hướng dẫn bởi độ phủ): https://lcamtuf.coredump.cx/afl/technical_details.txt
- Google — OSS-Fuzz: continuous fuzzing for open source: https://google.github.io/oss-fuzz/
Phần sau quay ống kính ngược lại: không hỏi mã có lỗi không, mà hỏi bộ test có đủ tốt để phát hiện lỗi không — cấy đột biến vào mã sản phẩm và đếm bao nhiêu đột biến sống sót qua bộ test đang xanh.
