Có một nhóm bài toán SQL mà nhiều lập trình viên né tránh vì tưởng khó: "xếp hạng sản phẩm trong từng danh mục", "tính tổng doanh thu luỹ kế theo ngày", "so doanh số tháng này với tháng trước". Phản xạ thường là kéo hết dữ liệu về code ứng dụng rồi xử lý bằng vòng lặp, hoặc viết những câu self-join tương quan rối rắm và chậm. Nhưng SQL có sẵn công cụ đúng cho chúng: window function.
Điểm khác biệt cốt lõi so với GROUP BY: GROUP BY gộp nhiều dòng thành một (mất chi tiết từng dòng), còn window function tính toán theo nhóm mà vẫn giữ nguyên mọi dòng, thêm một cột kết quả cho mỗi dòng. "Xếp hạng nhưng vẫn thấy từng người", "tổng luỹ kế nhưng vẫn thấy từng ngày". Bài này (phần 8 loạt SQL sâu) đo thật các window function phổ biến và cho thấy chúng nhanh hơn self-join tới cỡ nào.
Cơ chế: hàm OVER (PARTITION BY ... ORDER BY ...)
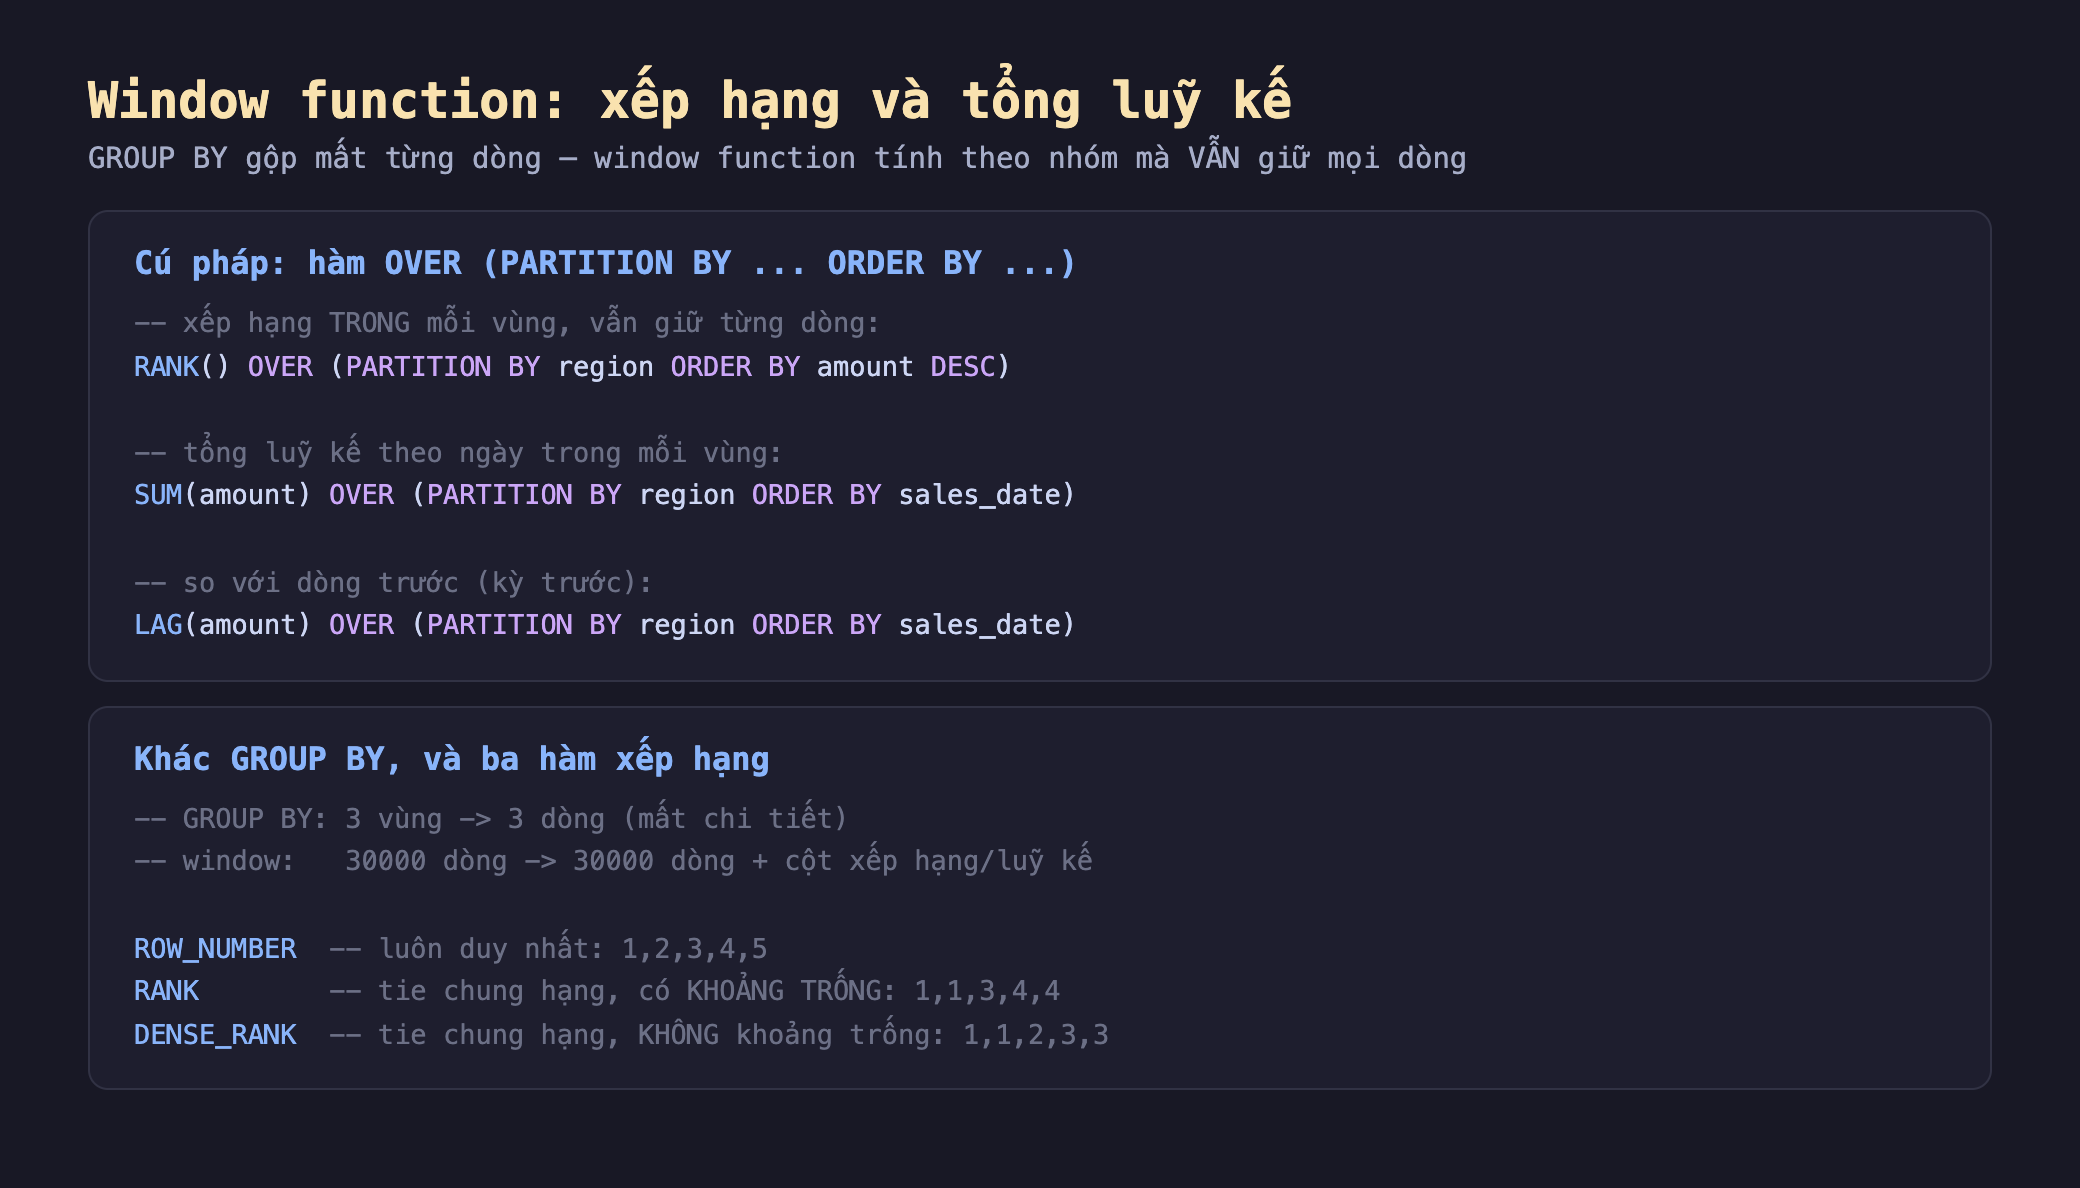
Hình 1: Cú pháp hàm() OVER (PARTITION BY ... ORDER BY ...) — RANK xếp hạng trong nhóm, SUM ... OVER cho tổng luỹ kế, LAG so với dòng trước. Khác GROUP BY (gộp mất dòng), window giữ mọi dòng. Ba hàm xếp hạng: ROW_NUMBER luôn duy nhất, RANK để khoảng trống sau tie, DENSE_RANK không để khoảng trống.
PARTITION BY chia dữ liệu thành các nhóm (như GROUP BY nhưng không gộp), ORDER BY sắp thứ tự trong mỗi nhóm, và hàm tính trên một "khung" (frame) quanh mỗi dòng.
Đo thật trong pg-lab
Mình tạo trong pg-lab (PostgreSQL 16) bảng sales 30.000 dòng, rồi chạy ba nhóm demo.
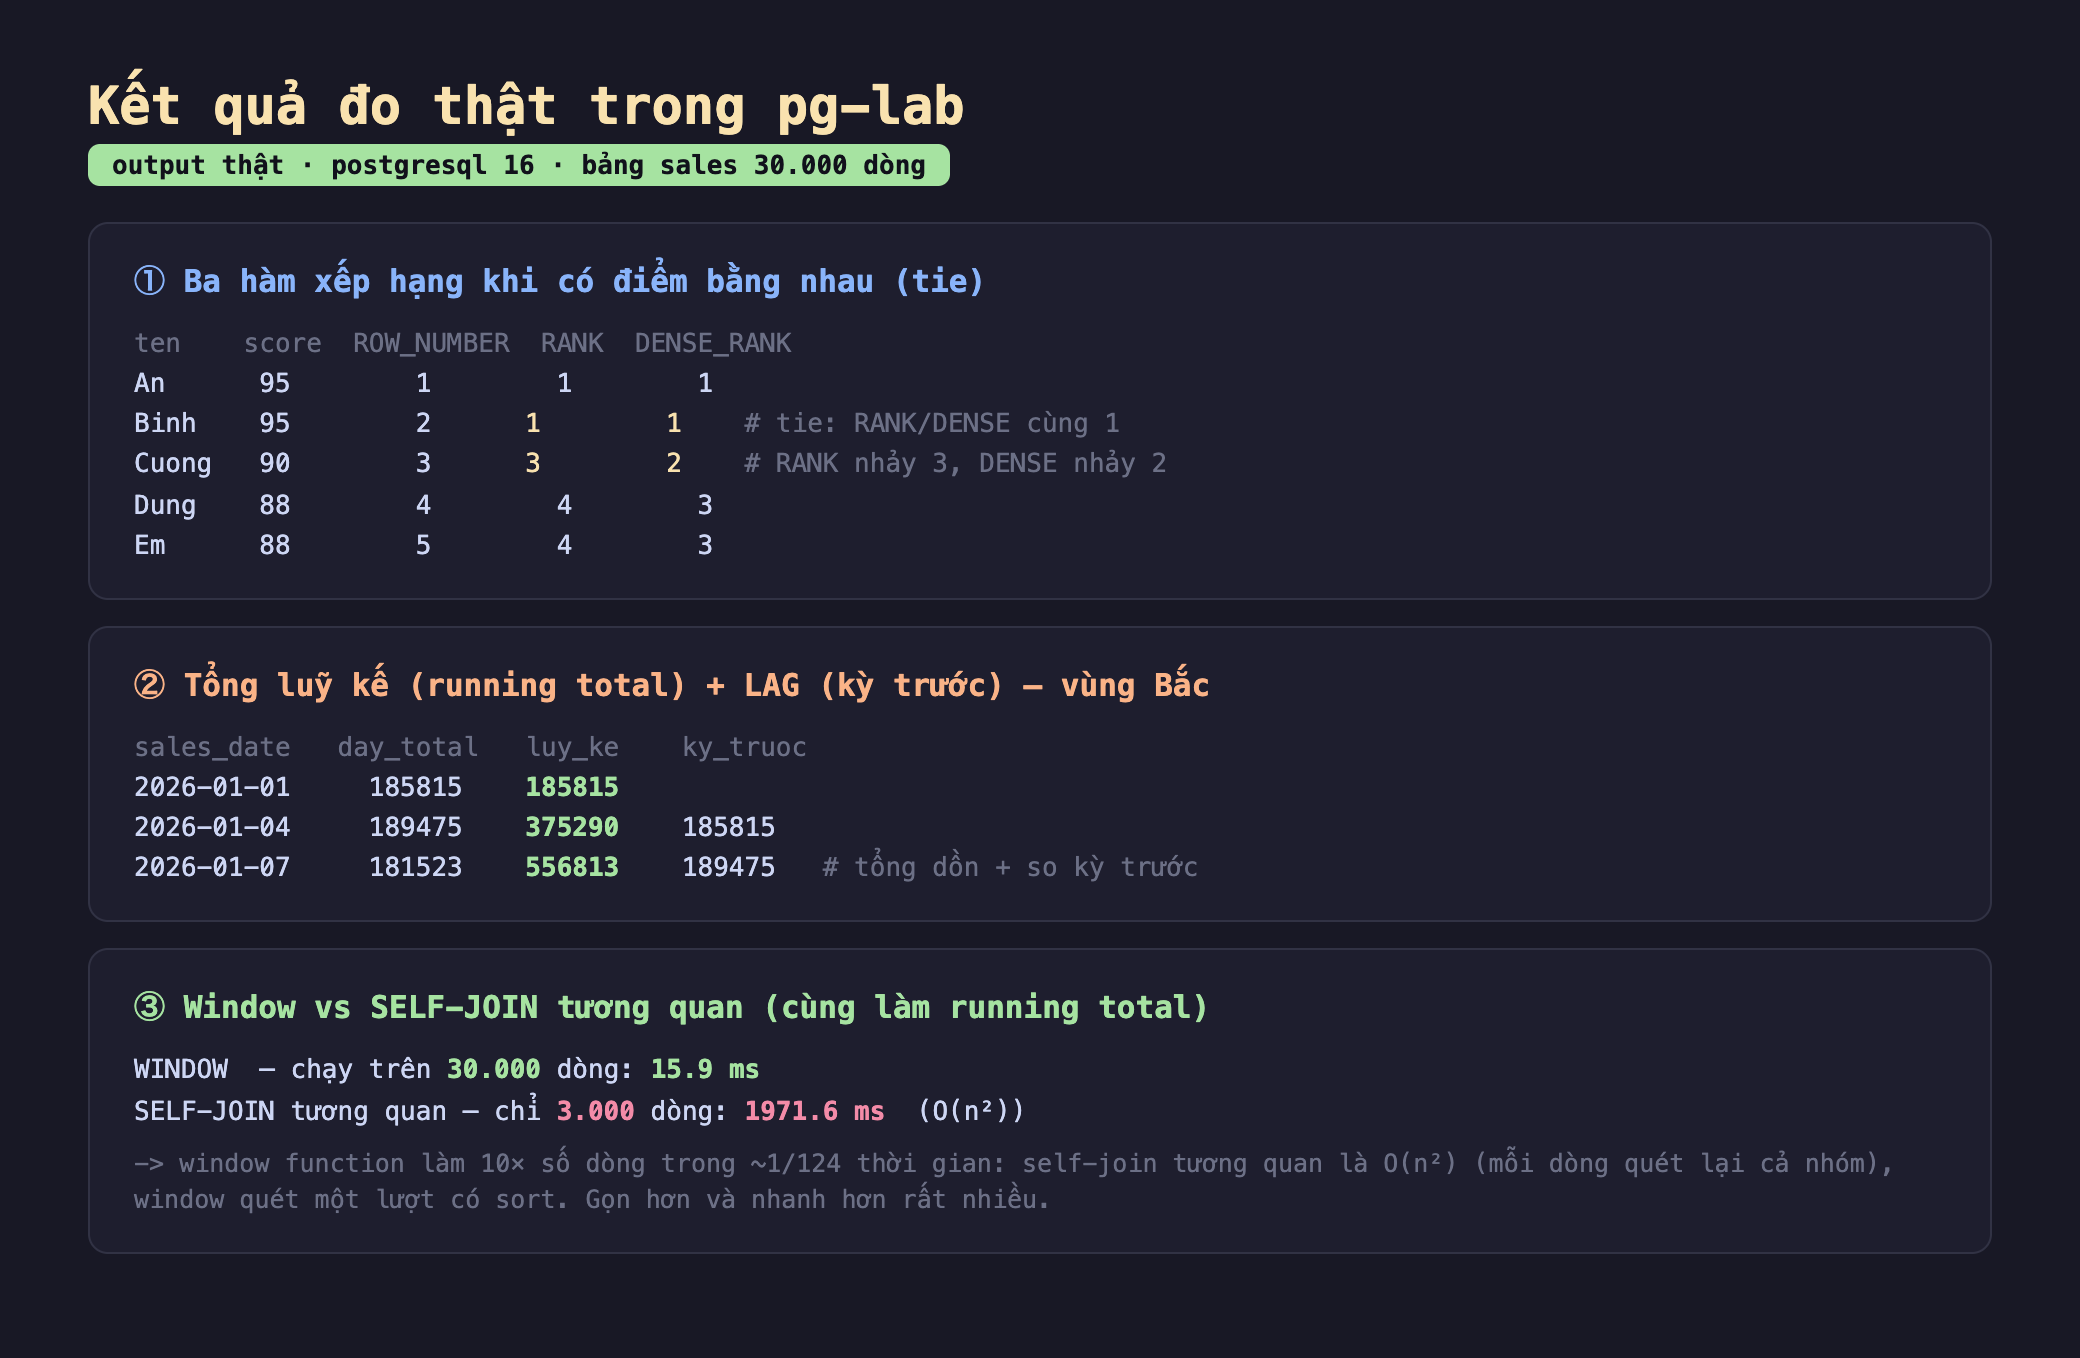
Hình 2: Kết quả thật — ① ba hàm xếp hạng khi có tie: ROW_NUMBER 1,2,3,4,5, RANK 1,1,3,4,4, DENSE_RANK 1,1,2,3,3; ② running total + LAG (luỹ kế dồn theo ngày, so kỳ trước); ③ benchmark: window trên 30.000 dòng = 15.9ms vs self-join tương quan chỉ 3.000 dòng = 1971.6ms.
Ba bài học từ số thật:
- Ba hàm xếp hạng khác nhau ở chỗ xử lý tie. Với hai người cùng 95 điểm:
ROW_NUMBERcho1,2(luôn duy nhất, chọn tuỳ tiện ai trước),RANKcho1,1rồi nhảy sang 3 (để khoảng trống — như xếp hạng thể thao: hai người đồng hạng nhất thì không có hạng nhì),DENSE_RANKcho1,1rồi2(không để khoảng trống). Chọn hàm nào tuỳ ngữ nghĩa bạn muốn — đây là điểm nhiều người dùng nhầm. - Running total và LAG trong một câu.
SUM(day_total) OVER (... ORDER BY sales_date)cho tổng luỹ kế (185815 → 375290 → 556813...), cònLAGcho giá trị dòng trước để tính tăng trưởng so kỳ. Những phép này trong code ứng dụng cần vòng lặp giữ biến tích luỹ; trong SQL chỉ một dòng, và database làm hiệu quả. - Nhanh hơn self-join tới 124 lần. Đây là con số đắt giá nhất. Running total cũng làm được bằng self-join tương quan (
SELECT SUM(...) FROM sales s2 WHERE s2.id <= s1.id), nhưng đó là O(n²) — mỗi dòng quét lại cả nhóm. Đo thật: self-join trên chỉ 3.000 dòng mất 1971.6ms, trong khi window function trên toàn bộ 30.000 dòng chỉ 15.9ms. Window làm gấp 10 lần khối lượng trong ~1/124 thời gian — vì nó quét một lượt (có sort) thay vì lồng vòng lặp.
Đánh đổi cần cân nhắc
ROWS vs RANGE trong khung window — dễ nhầm. Khi định nghĩa "khung" mà hàm tính trên đó, có hai kiểu: ROWS đếm theo số dòng vật lý (ví dụ "3 dòng trước"), còn RANGE gộp theo giá trị ORDER BY (mọi dòng cùng giá trị được coi là một). Mặc định của SUM() OVER (ORDER BY ...) là RANGE — nghĩa là nếu có nhiều dòng cùng ngày, running total sẽ nhảy cả cụm cùng lúc chứ không từng dòng. Nếu bạn muốn luỹ kế đúng từng dòng, phải ghi rõ ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW. Đây là cái bẫy tinh vi cho kết quả sai lặng lẽ khi dữ liệu có giá trị trùng.
Window cần sort — không miễn phí, nhưng vẫn rẻ hơn self-join. Window function không phải phép màu: ORDER BY trong OVER đòi hỏi sắp xếp dữ liệu, tốn thời gian và bộ nhớ (work_mem) trên bảng lớn. Nhưng như benchmark cho thấy, sort O(n log n) rẻ hơn rất nhiều so với self-join O(n²). Nếu có index đúng thứ tự partition/order, PostgreSQL còn tránh được sort. Với dữ liệu cực lớn, cân nhắc work_mem để sort không tràn ra đĩa.
Không lồng window function trong WHERE — cần subquery. Một giới hạn cú pháp hay vấp: bạn không thể viết WHERE RANK() OVER (...) <= 3 trực tiếp, vì window function được tính sau WHERE trong thứ tự xử lý. Muốn lọc theo kết quả window (ví dụ "top 3 mỗi nhóm"), phải bọc trong subquery/CTE rồi lọc ở tầng ngoài: SELECT * FROM (SELECT ..., RANK() OVER (...) rk FROM t) WHERE rk <= 3. (Một số CSDL có QUALIFY cho việc này, PostgreSQL thì chưa — dùng subquery.)
Ba ý mang về
- Window function tính theo nhóm mà vẫn giữ từng dòng: khác
GROUP BY(gộp mất chi tiết),hàm() OVER (PARTITION BY ... ORDER BY ...)thêm cột kết quả cho mỗi dòng — xếp hạng, tổng luỹ kế, so kỳ trước; ba hàm xếp hạng khác nhau ở tie: ROW_NUMBER1,2, RANK1,1,3(có khoảng trống), DENSE_RANK1,1,2(không). - Nhanh hơn self-join rất nhiều: đo thật, running total bằng window trên 30.000 dòng = 15.9ms so với self-join tương quan chỉ 3.000 dòng = 1971.6ms — window quét một lượt (O(n log n) có sort) thay vì lồng vòng lặp O(n²); gọn hơn và nhanh hơn ~124 lần.
- Nắm ROWS/RANGE và giới hạn cú pháp:
RANGE(mặc định) gộp dòng cùng giá trị ORDER BY — dùngROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROWcho luỹ kế đúng từng dòng; window cần sort (cân nhắcwork_mem/index); và không lồng window trong WHERE — phải bọc subquery/CTE để lọc theo kết quả window.
Nguồn
- PostgreSQL — Window Functions Tutorial: https://www.postgresql.org/docs/current/tutorial-window.html
- PostgreSQL — Window Function Calls (ROWS/RANGE, frame): https://www.postgresql.org/docs/current/sql-expressions.html#SYNTAX-WINDOW-FUNCTIONS
- PostgreSQL — Window function processing order: https://www.postgresql.org/docs/current/queries-table-expressions.html#QUERIES-WINDOW
Phần sau ta bàn về CTE (WITH): cách viết query nhiều tầng cho dễ đọc, recursive CTE để duyệt cây/đồ thị, và một thay đổi quan trọng ở PostgreSQL 12 về "CTE fence" (materialization) ảnh hưởng hiệu năng.
