Mọi định dạng ta đã xem — JSON, Protobuf, MessagePack, CBOR, gob — có chung một bước bắt buộc: giải mã. Trước khi đọc được dù chỉ một field, bạn phải parse toàn bộ buffer thành struct trong bộ nhớ. Với message lớn mà bạn chỉ cần vài field (đọc trường gia để lọc, đọc id để định tuyến), đây là lãng phí lớn: dựng lại cả chục field chỉ để dùng một. Zero-copy serialization (FlatBuffers của Google, Cap'n Proto) đi hướng khác: dữ liệu trên wire đã có sẵn layout để đọc trực tiếp field bằng offset, không cần bước giải mã, không cấp phát. Bài này (phần 11 loạt Serialization) đo thật để thấy chênh lệch — và nó lớn đến mức bất ngờ.
Cơ chế: layout cố định, đọc bằng offset
Ý tưởng cốt lõi: thay vì mã hóa dữ liệu thành dạng phải parse lại, zero-copy đặt mỗi field ở một vị trí biết trước trong buffer. Đọc một field chỉ là đọc vài byte tại offset đó.
Vì cài flatc/capnp compiler trong lab này phức tạp, mình mô phỏng đúng nguyên lý bằng một layout offset cố định tự cài — đủ để đo bản chất zero-copy:
// [0:8]=ID  [8:16]=Gia  [16:24]=SoLuong  rồi vùng chuỗi (len uint16 + bytes)
func encodeZeroCopy(o Order) []byte {
    buf := make([]byte, 24)
    binary.LittleEndian.PutUint64(buf[8:], uint64(o.Gia))  // Gia ở offset 8
    // ... các field khác
}

// đọc 1 field = 1 phép đọc bộ nhớ tại offset, KHÔNG parse, KHÔNG alloc
func readGia(buf []byte) int64 {
    return int64(binary.LittleEndian.Uint64(buf[8:16]))
}
So với JSON, nơi đọc gia buộc phải json.Unmarshal(buf, &o) — parse toàn bộ, cấp string/struct cho mọi field — rồi mới lấy o.Gia.
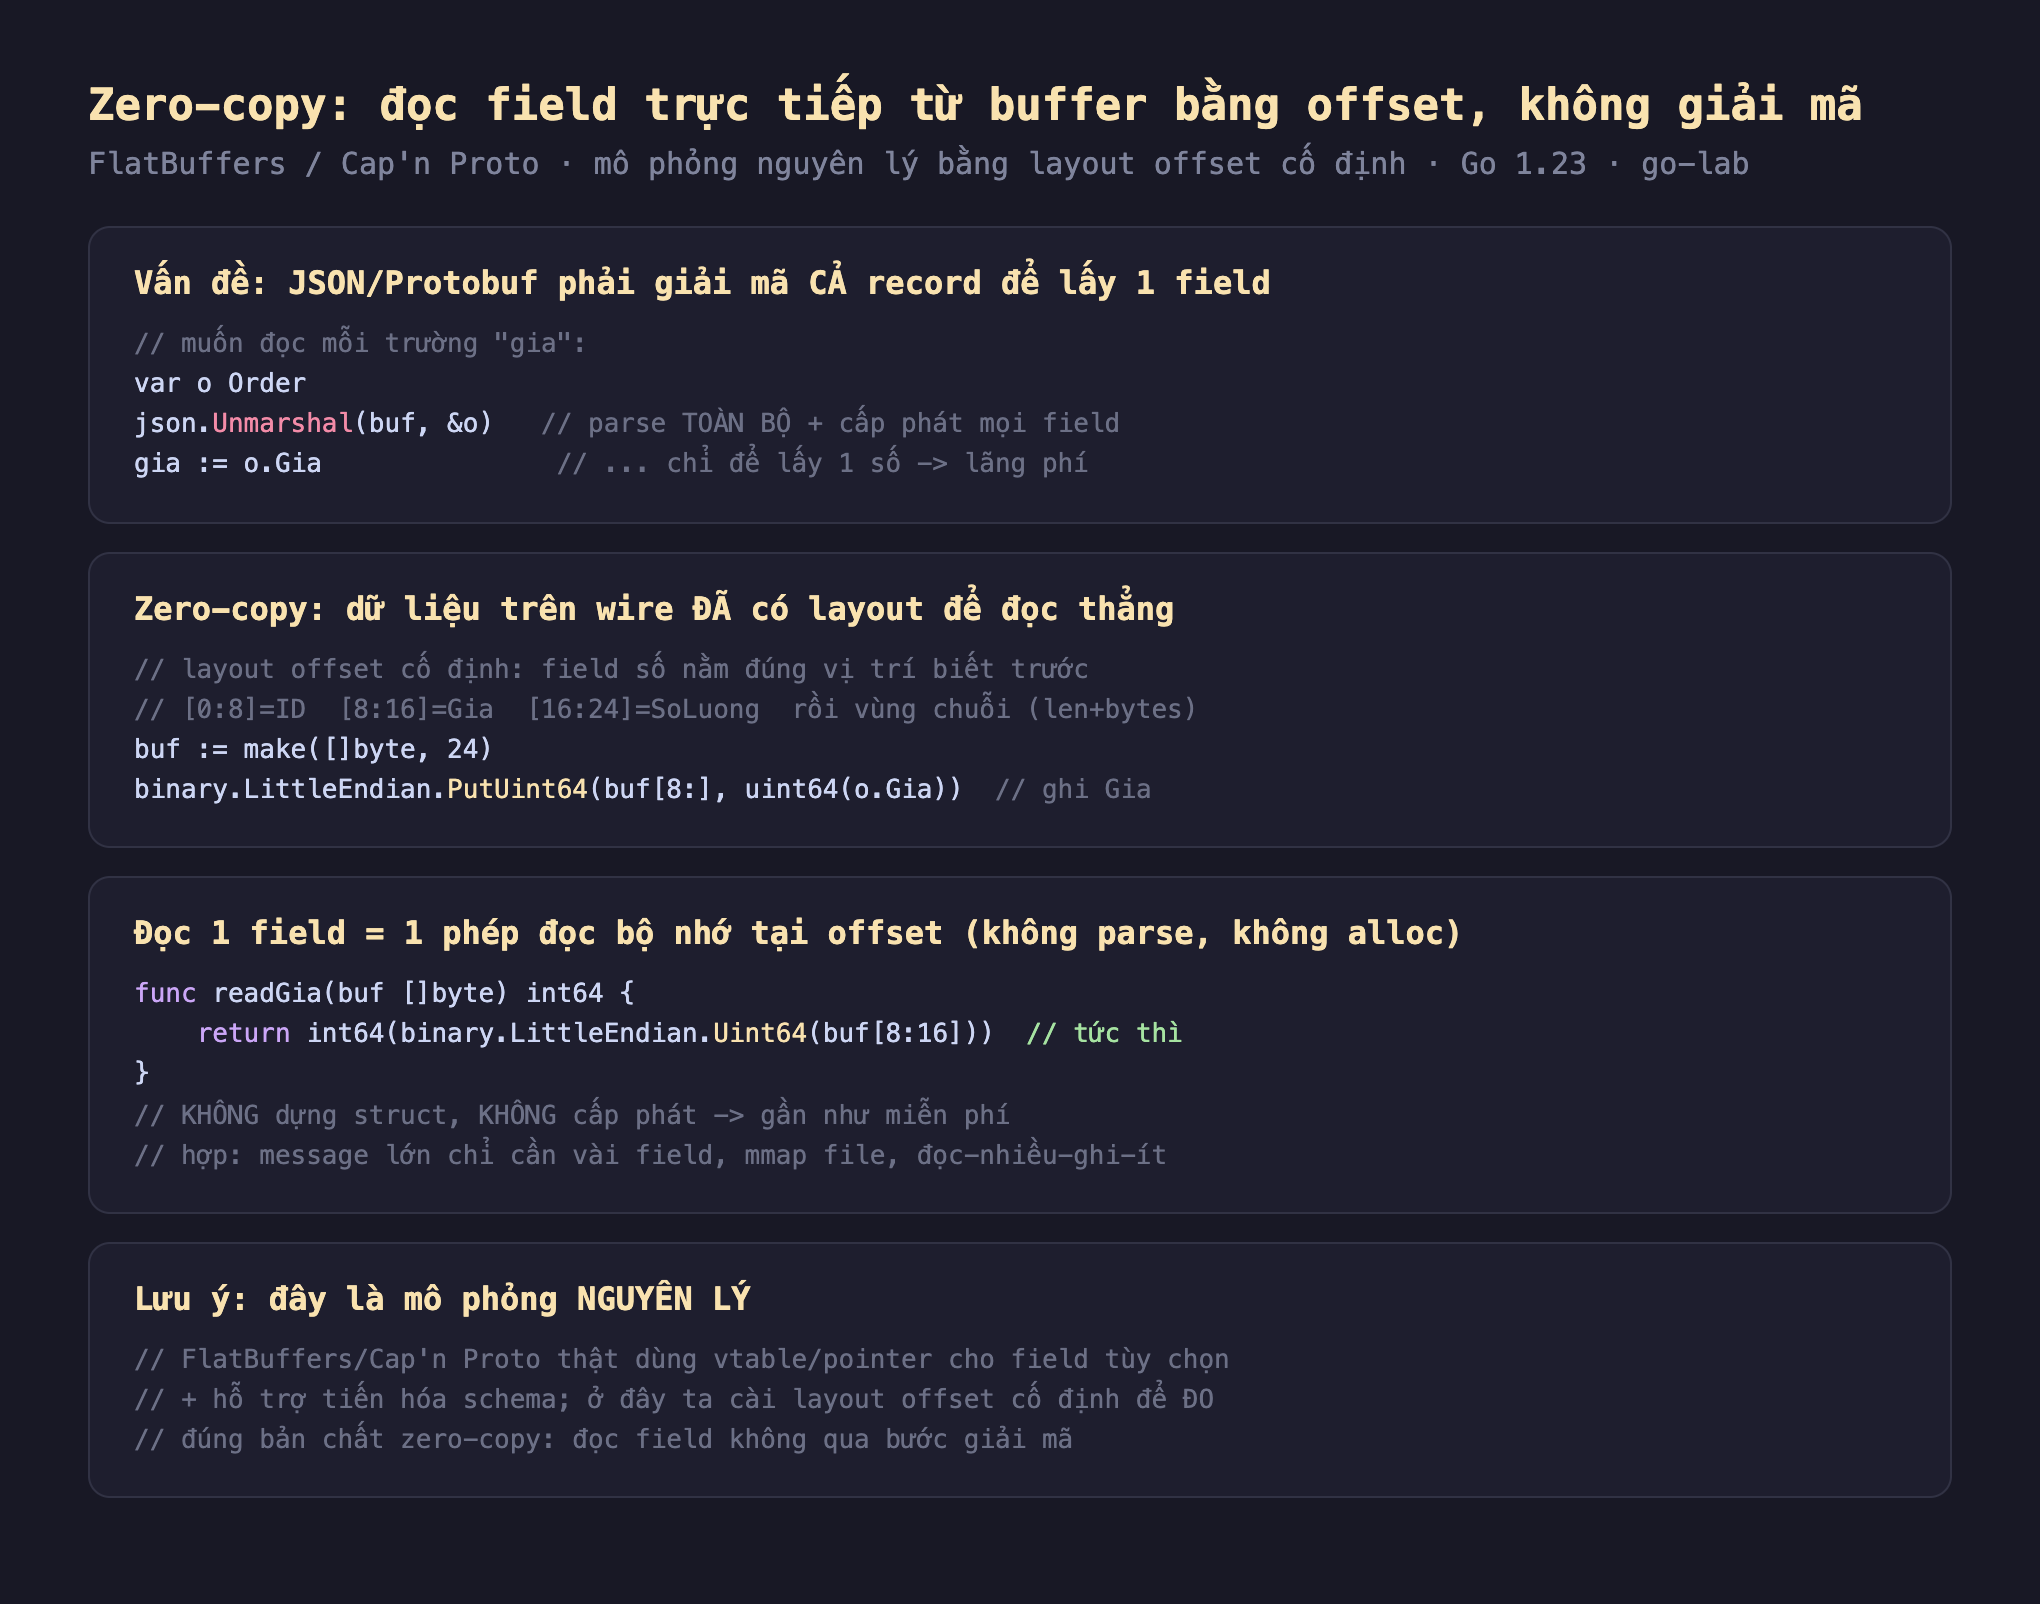
Hình 1: JSON/Protobuf phải Unmarshal cả record để lấy một field; zero-copy đặt field ở offset cố định và đọc thẳng bằng binary.LittleEndian.Uint64(buf[8:16]) — không parse, không cấp phát; đây là mô phỏng nguyên lý (FlatBuffers thật dùng vtable cho field tùy chọn + tiến hóa schema).
Đo thật: đọc một field
Mình benchmark đọc trường gia từ một bản ghi có 7 field, hai cách:
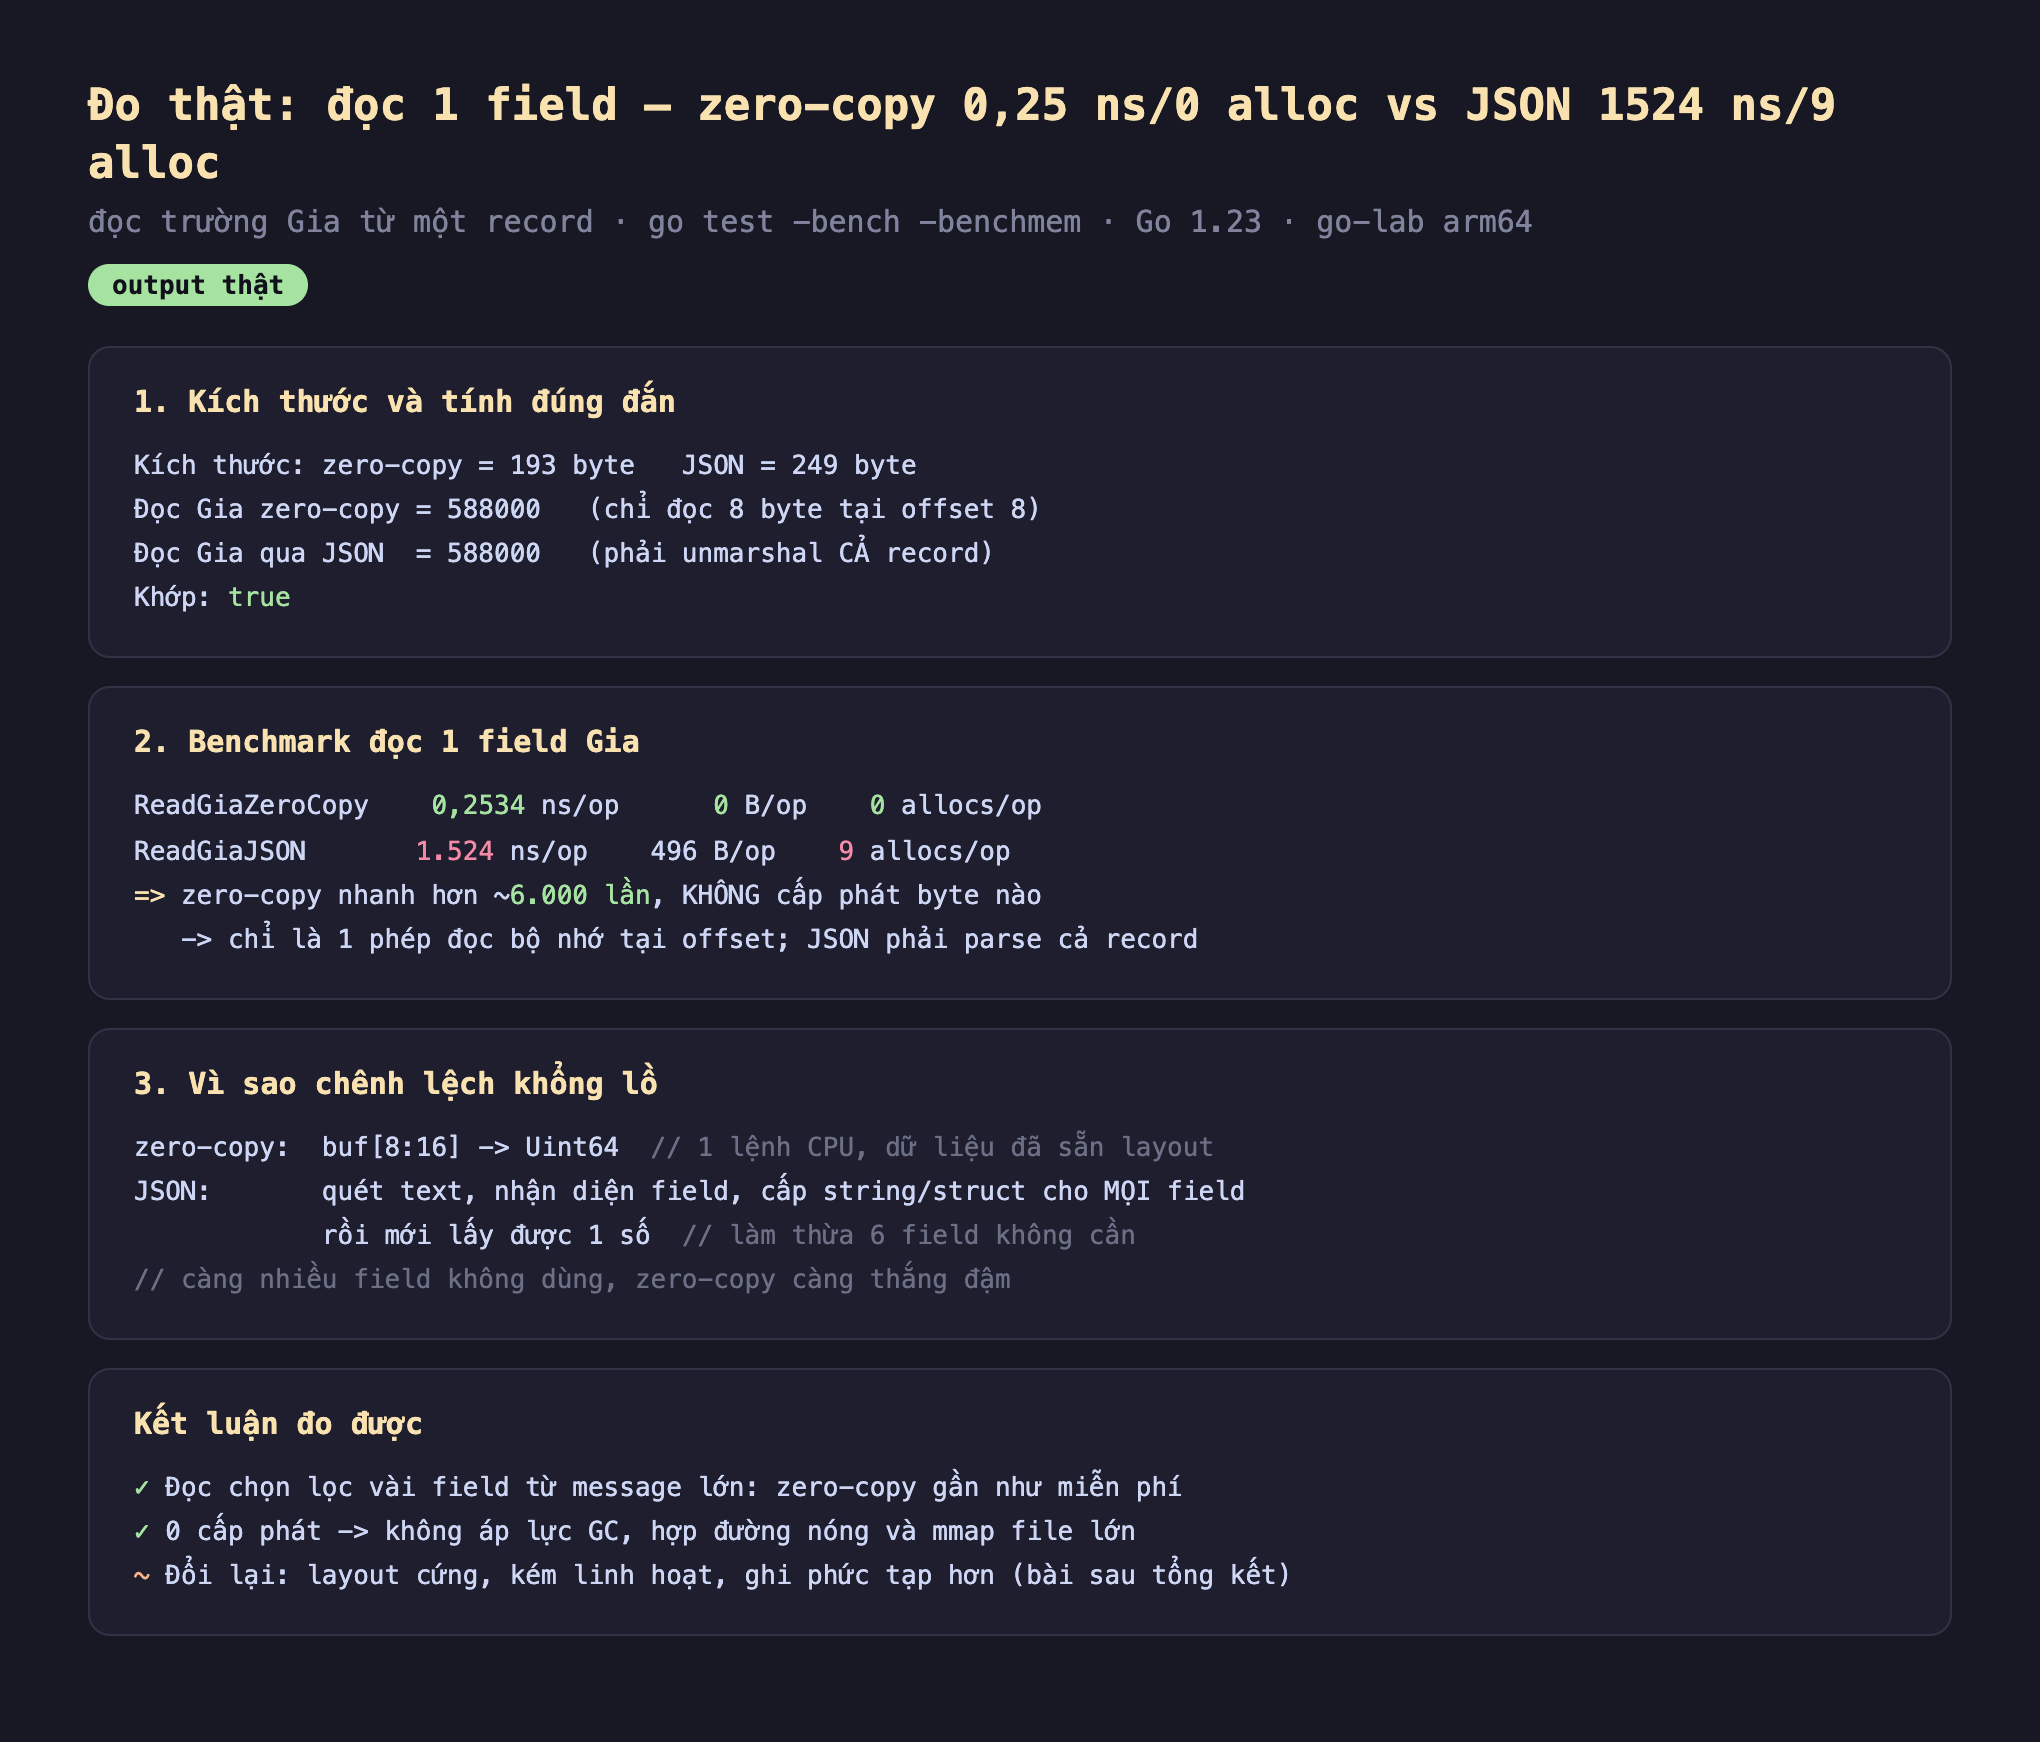
Hình 2: Chạy thật — đọc trường gia: zero-copy 0,2534 ns/op, 0 B, 0 allocs so với JSON 1.524 ns/op, 496 B, 9 allocs — nhanh hơn ~6000 lần và không cấp phát; zero-copy 193 byte vs JSON 249 byte; cả hai đọc ra đúng 588000.
Đọc kết quả đo được:
- Chênh lệch khổng lồ: đọc một field zero-copy tốn 0,2534 ns — thực chất là một phép đọc bộ nhớ, gần như miễn phí. Đọc cùng field qua JSON tốn 1.524 ns — nhanh hơn ~6000 lần. Con số lớn đến vậy vì hai việc hoàn toàn khác nhau: zero-copy là một lệnh CPU đọc 8 byte tại offset; JSON phải quét text, nhận diện từng field, cấp phát string và struct cho cả 7 field, rồi mới lấy được một số.
- Không cấp phát: zero-copy 0 allocs, JSON 9 allocs (496 byte). Với đường nóng xử lý hàng triệu message, khác biệt này không chỉ là tốc độ mà còn là áp lực lên GC — zero-copy không tạo rác.
- Càng nhiều field không dùng, càng thắng đậm: ở đây bản ghi có 7 field, ta chỉ cần 1. JSON làm thừa việc dựng 6 field kia. Với message thật có hàng chục/trăm field mà bạn chỉ đọc vài cái (rất phổ biến trong lọc, định tuyến, index), lợi thế zero-copy còn lớn hơn.
Đánh đổi cần cân nhắc
Zero-copy đổi tính linh hoạt lấy tốc độ đọc. Cái giá của việc đọc thẳng bằng offset là layout cứng nhắc: FlatBuffers/Cap'n Proto cần bước sinh code từ schema, buffer khó tạo hơn (phải xây theo thứ tự nhất định), và dữ liệu thường lớn hơn trên wire so với Protobuf (có padding/vtable để căn chỉnh). Nếu workload của bạn là ghi nhiều, đọc toàn bộ mỗi lần thì zero-copy không có lợi thế — chi phí giải mã Protobuf một lần rẻ hơn việc mang layout cồng kềnh.
Lợi thế chỉ hiện rõ ở đúng bài toán: đọc chọn lọc từ message lớn. Zero-copy tỏa sáng khi: message lớn nhưng mỗi lần chỉ cần vài field (game state, dữ liệu cảm biến, log có cấu trúc), hoặc bạn mmap một file khổng lồ và muốn truy cập ngẫu nhiên field mà không nạp/parse cả file. Nếu bạn luôn cần toàn bộ dữ liệu ngay, con số 6000x này không phản ánh thực tế của bạn — bạn sẽ phải đọc mọi field, và tổng chi phí gần hơn với các định dạng khác.
Đây là mô phỏng nguyên lý, không phải FlatBuffers đầy đủ. Layout offset cố định của mình minh họa đúng bản chất zero-copy (đọc field không qua giải mã), nhưng FlatBuffers/Cap'n Proto thật phức tạp hơn: dùng vtable/con trỏ để hỗ trợ field tùy chọn và tiến hóa schema, xử lý endianness, và có kiểm tra biên an toàn. Đừng tự cài layout thủ công cho production (dễ sai, không tiến hóa được); dùng thư viện đã kiểm chứng khi cần zero-copy thật.
Ba ý mang về
- Zero-copy đọc field bằng offset, không giải mã, không cấp phát: đo thật đọc một trường tốn 0,25 ns và 0 allocs (chỉ một phép đọc bộ nhớ) so với 1.524 ns và 9 allocs khi phải
Unmarshalcả bản ghi — nhanh hơn ~6000 lần. - Thắng đậm nhất khi đọc chọn lọc từ message lớn: JSON/Protobuf làm thừa việc dựng mọi field dù bạn chỉ cần một; càng nhiều field không dùng, zero-copy càng lợi — hợp game state, cảm biến, mmap file lớn, đường nóng cần 0 cấp phát.
- Đổi lại là layout cứng và kém linh hoạt: FlatBuffers/Cap'n Proto cần sinh code, buffer khó tạo hơn, thường lớn hơn Protobuf trên wire; nếu bạn luôn đọc toàn bộ dữ liệu thì zero-copy không có lợi thế — chọn theo mẫu truy cập thật.
Nguồn
- Google — FlatBuffers: https://flatbuffers.dev/
- Cap'n Proto (zero-copy, tác giả của Protobuf v2): https://capnproto.org/
- Go — google/flatbuffers (Go): https://pkg.go.dev/github.com/google/flatbuffers/go
Phần sau là bài tổng kết loạt: một bảng so sánh mọi định dạng đã đo (JSON, Protobuf, gob, MessagePack, CBOR, zero-copy) và cây quyết định thực dụng — bài toán nào thì chọn định dạng nào, và khi nào cứ dùng JSON là đủ.
