Xuyên suốt loạt bài, ta đã đo: Protobuf nhỏ hơn JSON khoảng 2 lần. Nhưng có một biến số mà các so sánh thường bỏ qua: trong thực tế, dữ liệu thường được nén trước khi gửi — HTTP có Content-Encoding: gzip, Kafka nén message, file log được nén khi lưu. Vậy câu hỏi thực sự là: sau khi nén, khoảng cách giữa JSON và Protobuf còn lại bao nhiêu? Bài này (phần 9 loạt Serialization) chạy thật để trả lời — và kết quả có thể thay đổi cách bạn chọn định dạng.
Vì sao JSON nén tốt hơn Protobuf
Chìa khóa nằm ở độ dư thừa (redundancy). Bộ nén như gzip/zstd hoạt động bằng cách tìm và loại bỏ các phần lặp lại. JSON đầy phần lặp:
- Tên field lặp mỗi bản ghi: 1000 đơn hàng thì "id", "ma", "khach_hang", "so_luong"... xuất hiện 1000 lần.
- Dấu ngoặc, dấu phẩy, dấu nháy, khoảng trắng — lặp khắp nơi.
Đây chính xác là thứ gzip giỏi nhất. Protobuf thì ngược lại: nó đã loại tên field (chỉ giữ số thứ tự), nén số bằng varint — dữ liệu entropy cao, ít phần lặp cho bộ nén khai thác. Nói cách khác: Protobuf đã làm sẵn một phần việc của bộ nén, nên nén thêm được ít hơn.
// nén bằng thư viện chuẩn + zstd
w, _ := gzip.NewWriterLevel(&buf, gzip.BestCompression)  // gzip mức 9
w.Write(data); w.Close()

w2, _ := zstd.NewWriter(&buf, zstd.WithEncoderLevel(zstd.SpeedBestCompression))
w2.Write(data); w2.Close()
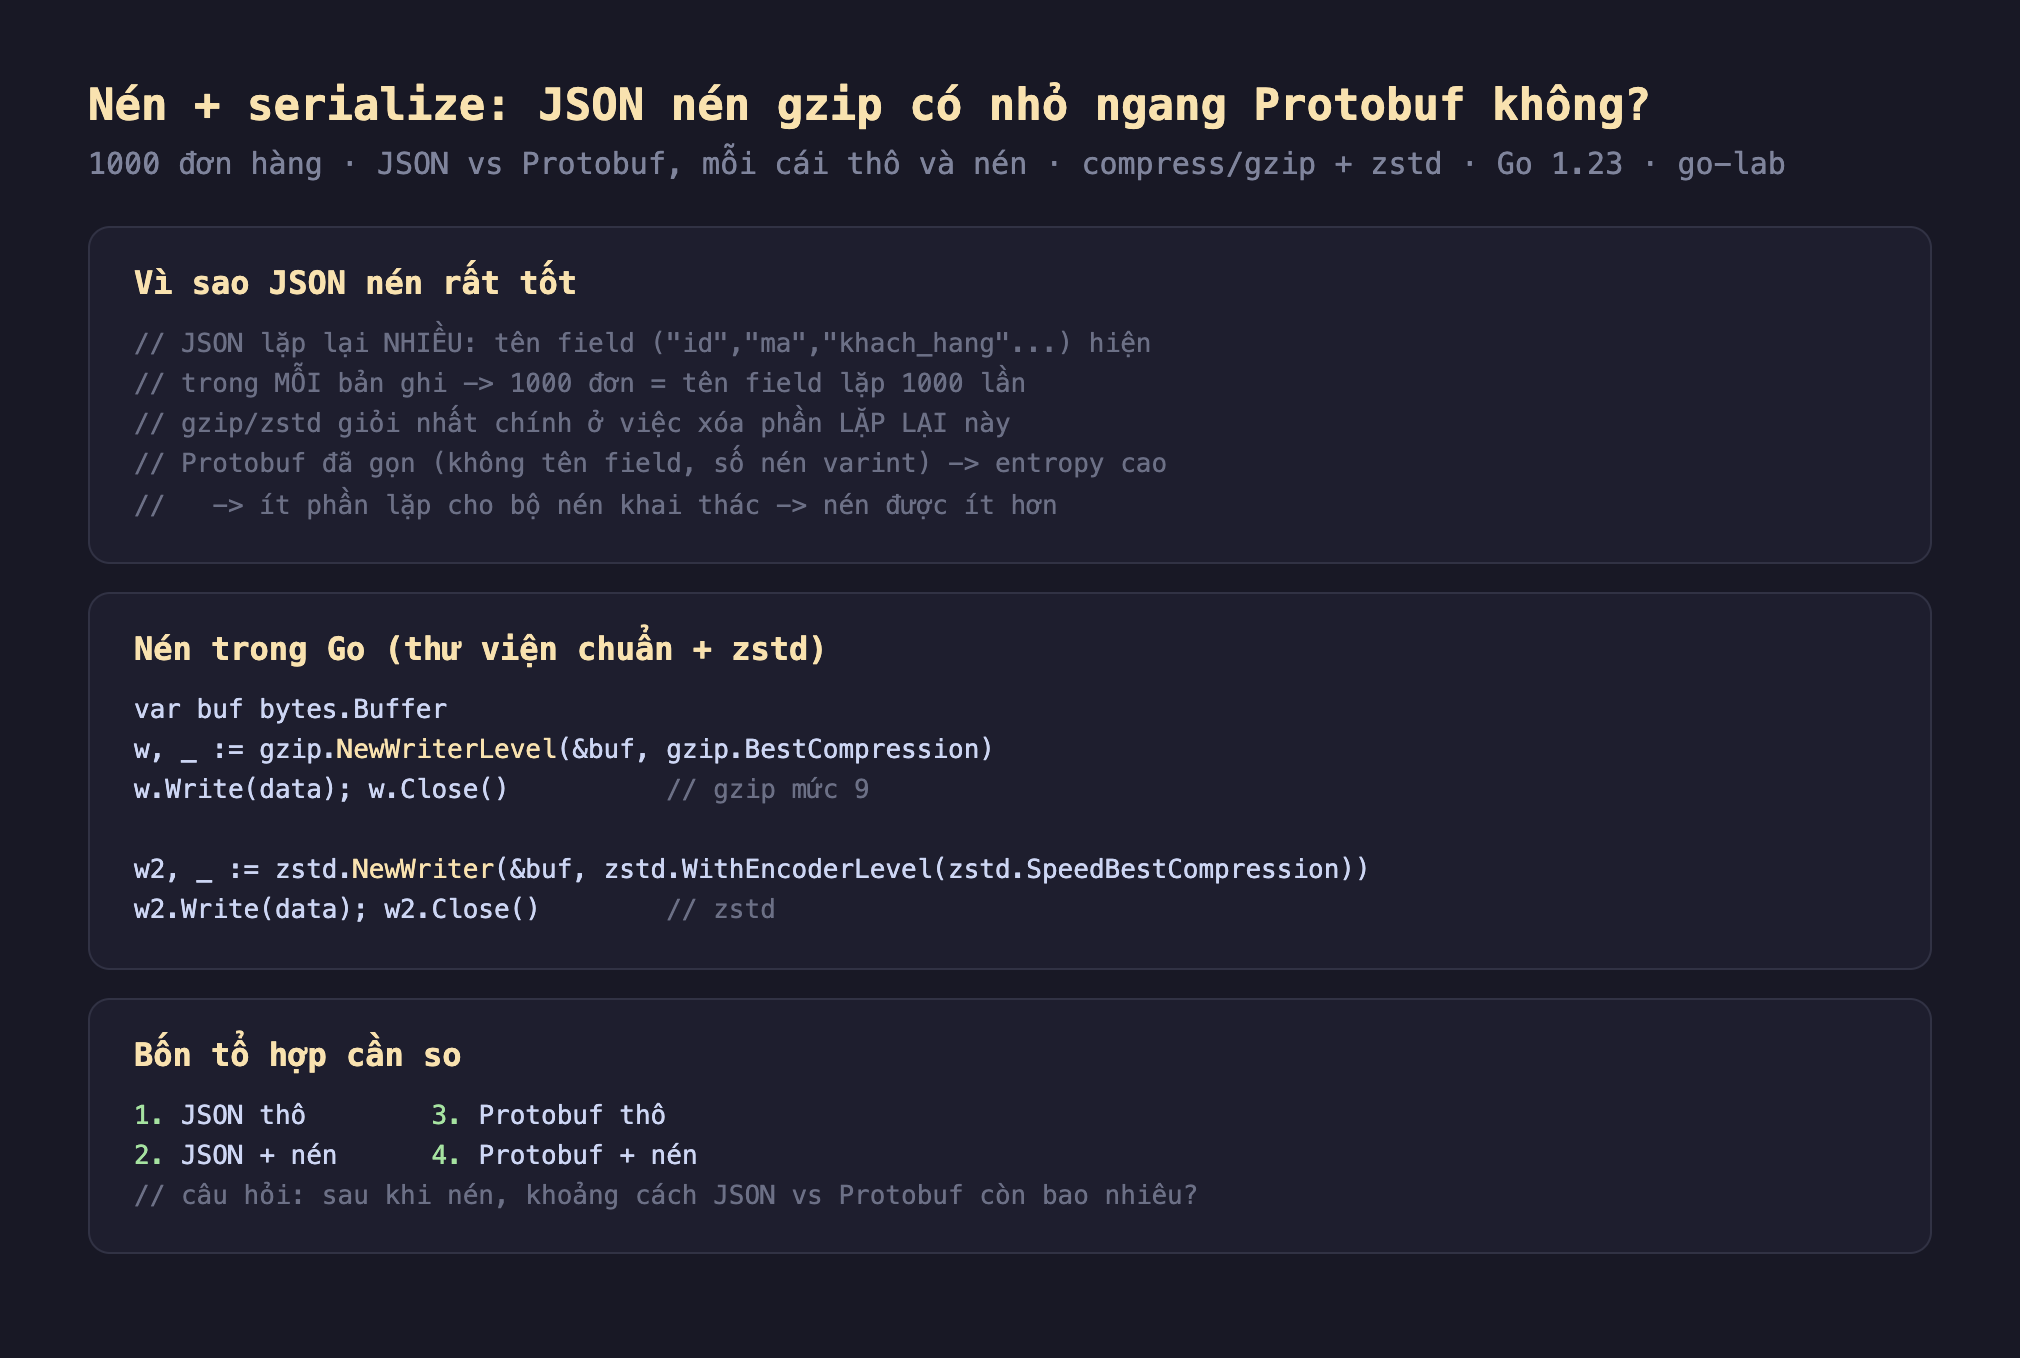
Hình 1: JSON dư thừa nhiều (tên field lặp mỗi bản ghi, dấu ngoặc/phẩy) — đúng thứ gzip/zstd xóa giỏi nhất; Protobuf đã gọn nên entropy cao, nén thêm được ít; ta so bốn tổ hợp JSON/Protobuf × thô/nén.
Đo thật: 1000 đơn hàng, bốn tổ hợp
Mình tạo 1000 đơn hàng dữ liệu đa dạng (tên khách, số mặt hàng, giá, trạng thái khác nhau — để tỉ lệ nén thực tế, không phóng đại), rồi mã hóa và nén cả hai cách:
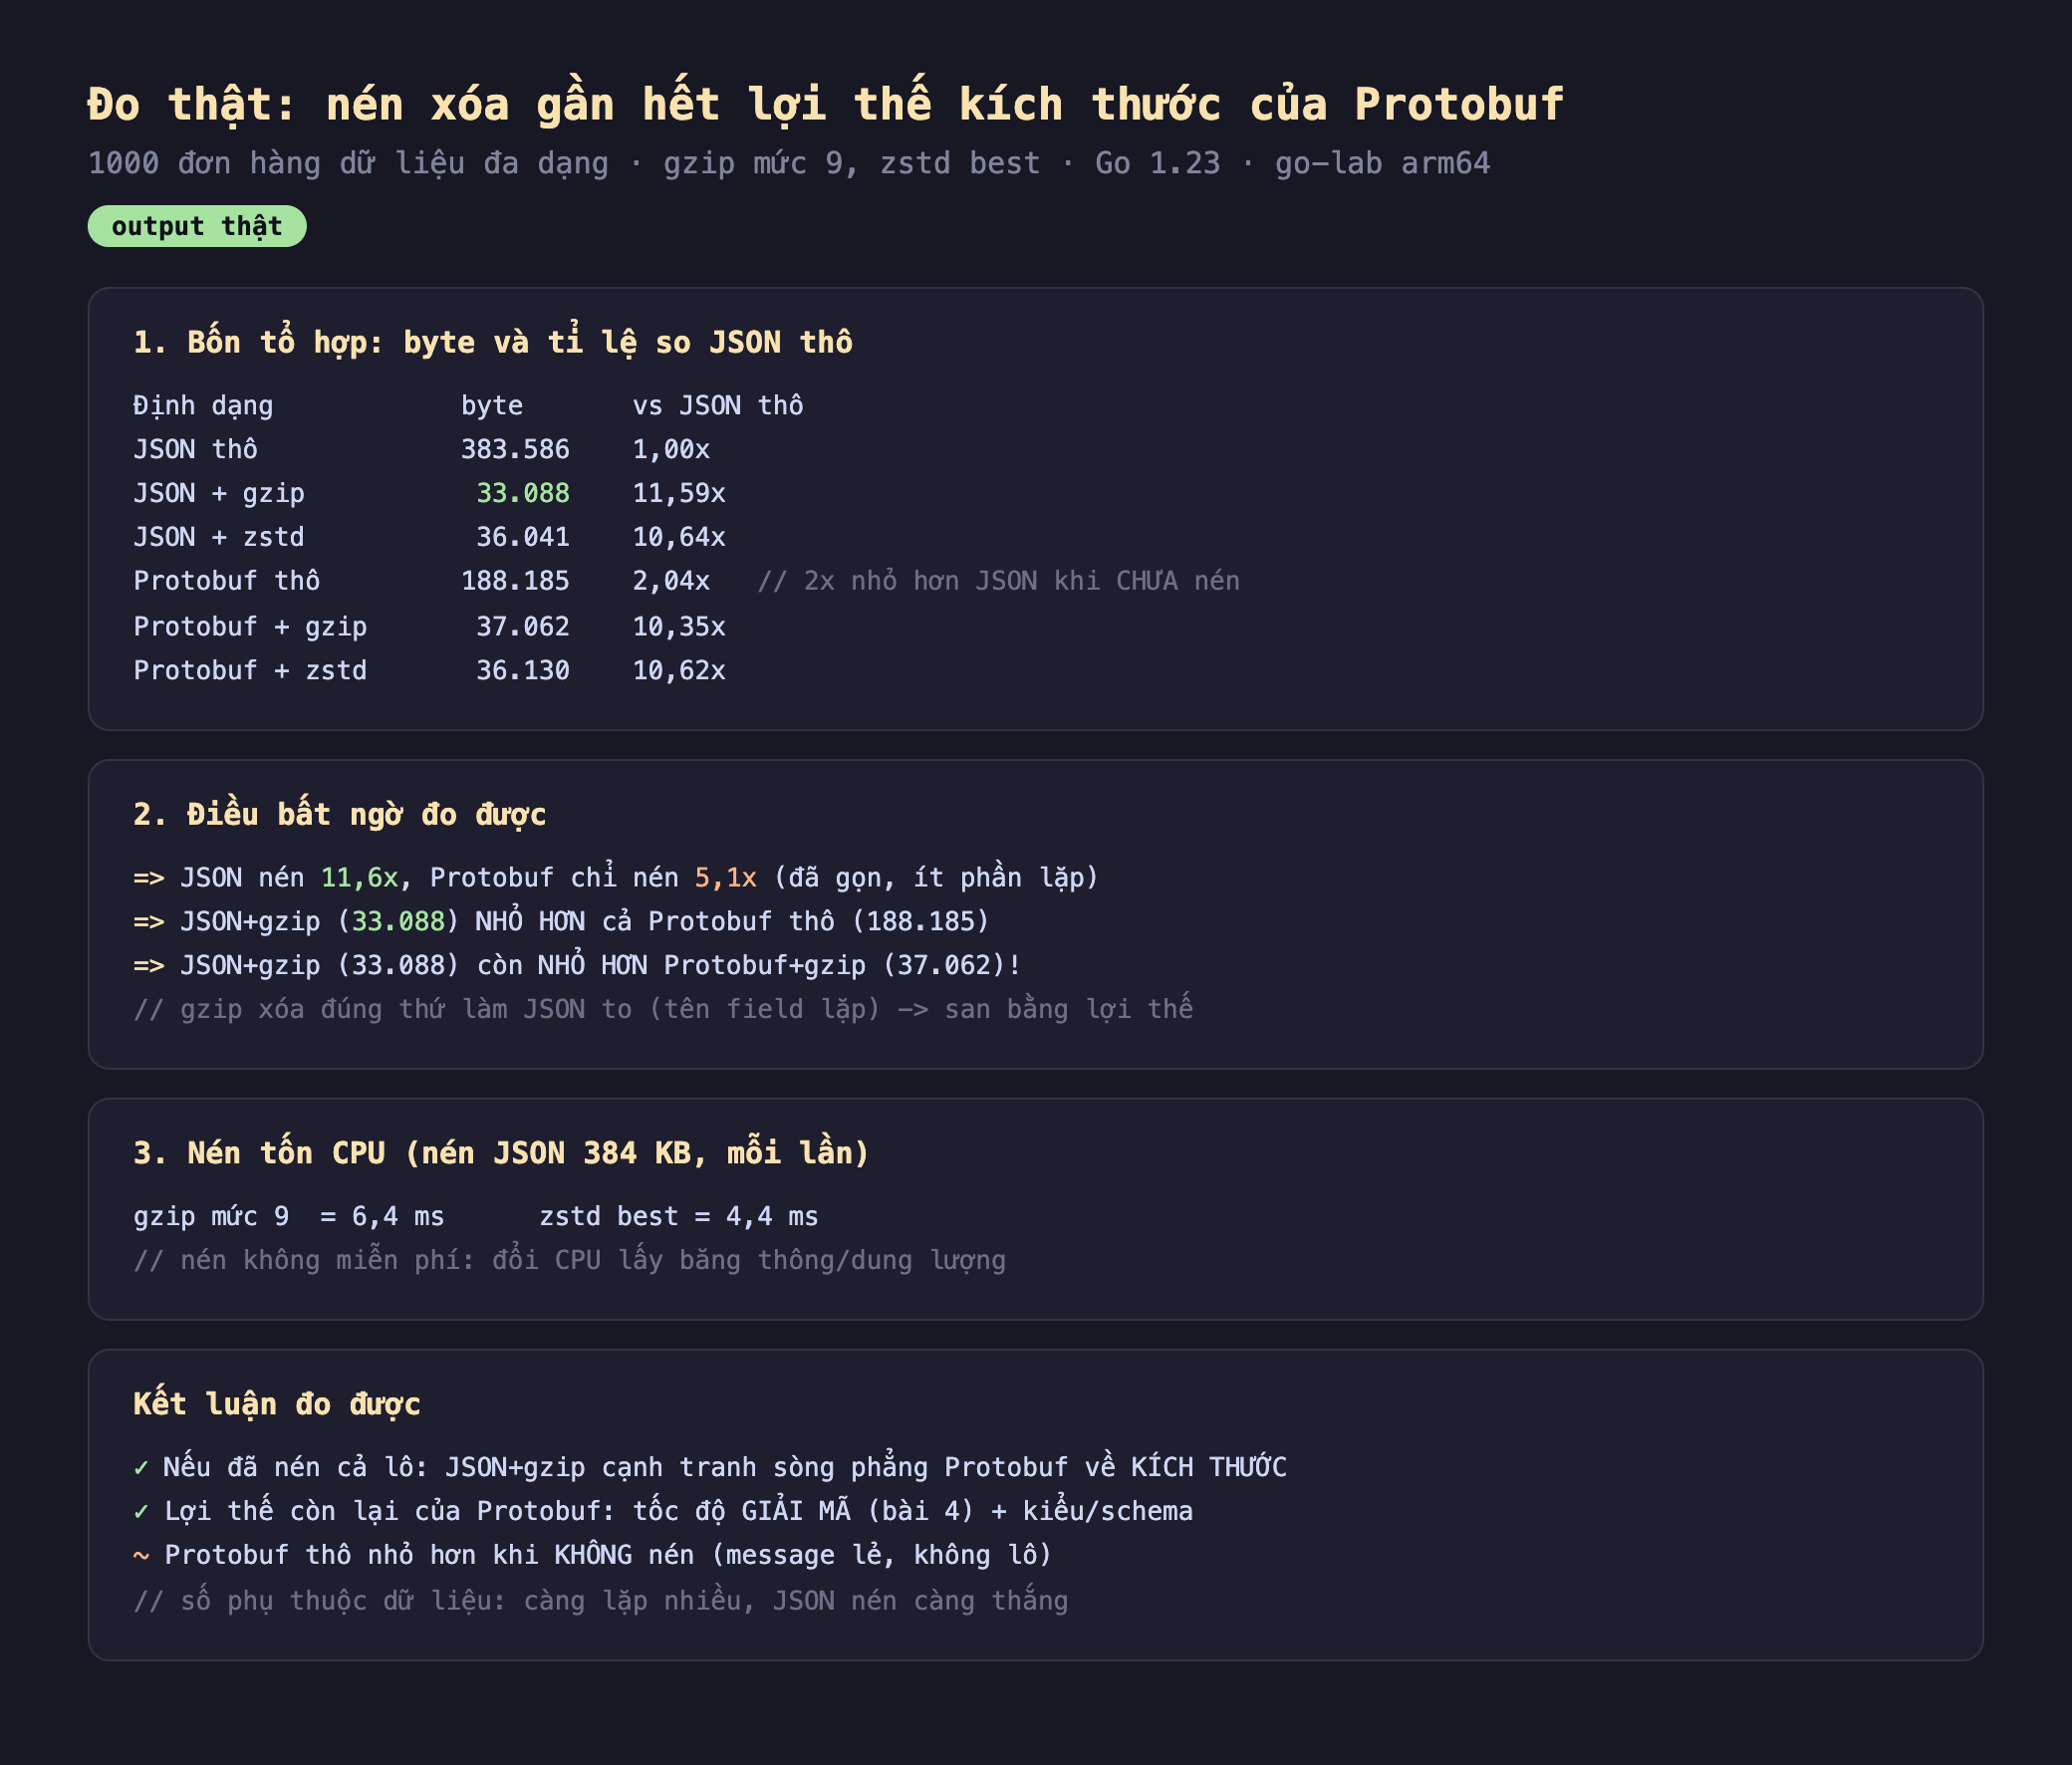
Hình 2: Chạy thật — JSON thô 383.586 byte, JSON+gzip 33.088 (nén 11,6x); Protobuf thô 188.185 (2,04x nhỏ hơn JSON), Protobuf+gzip 37.062 (nén chỉ 5,1x); JSON+gzip nhỏ hơn cả Protobuf+gzip; nén tốn CPU: gzip 6,4 ms, zstd 4,4 ms cho 384 KB.
Đọc kết quả đo được:
- JSON nén mạnh hơn Protobuf nhiều: JSON nén được 11,6 lần (383 KB → 33 KB), còn Protobuf chỉ 5,1 lần (188 KB → 37 KB). Đúng như dự đoán: JSON dư thừa nhiều nên có nhiều thứ để nén; Protobuf đã gọn nên ít.
- Kết quả bất ngờ — JSON+gzip thắng cả về kích thước cuối: JSON+gzip (33.088 byte) không chỉ nhỏ hơn Protobuf thô (188.185), mà còn nhỏ hơn cả Protobuf+gzip (37.062 byte)! Lý do: gzip loại bỏ tên field lặp lại — chính là lợi thế "không tên field" mà Protobuf mang lại. Sau khi nén, lợi thế đó bị san bằng, thậm chí đảo ngược.
- Nén không miễn phí: nén 384 KB JSON tốn 6,4 ms (gzip mức 9) hoặc 4,4 ms (zstd). Đây là CPU thật đánh đổi lấy băng thông/dung lượng — với dữ liệu nhỏ hoặc độ trễ cực thấp, chi phí này có thể không đáng.
Đánh đổi cần cân nhắc
Kết luận không phải "JSON tốt hơn Protobuf". Đây là điểm dễ hiểu nhầm. Đo này chỉ nói về kích thước sau nén khi gửi cả lô. Protobuf vẫn giữ hai lợi thế lớn mà nén không đụng tới: tốc độ giải mã (phần 4: nhanh ~9,7 lần JSON — nén rồi vẫn phải giải nén và parse) và an toàn kiểu qua schema. Nếu hệ của bạn nhạy CPU khi giải mã, Protobuf vẫn thắng dù kích thước sau nén tương đương.
Message lẻ, không nén thì Protobuf vẫn nhỏ hơn 2 lần. Kết quả "nén san bằng" chỉ đúng khi có nhiều bản ghi để bộ nén tìm mẫu lặp. Một message đơn lẻ nhỏ (một request API), nén gzip có overhead header riêng (~18 byte) và ít mẫu để nén — khi đó Protobuf thô nhỏ hơn JSON thô 2 lần vẫn là thật. Chọn theo cách bạn gửi: lô lớn đã nén, hay message nhỏ lẻ.
Số liệu phụ thuộc mạnh vào dữ liệu. Dữ liệu càng lặp (nhiều bản ghi giống nhau, nhiều field chung), JSON nén càng thắng. Dữ liệu entropy cao (nhiều chuỗi ngẫu nhiên, ID duy nhất, số thực) thì cả hai nén kém và Protobuf giữ lợi thế thô. Đừng lấy con số 11,6x ở đây làm chuẩn — hãy đo trên chính dữ liệu của bạn.
Ba ý mang về
- JSON nén tốt hơn Protobuf vì dư thừa nhiều: đo thật JSON nén 11,6 lần còn Protobuf chỉ 5,1 lần — gzip xóa tên field lặp và dấu câu, đúng thứ làm JSON to; Protobuf đã gọn nên ít thứ để nén.
- Nén san bằng lợi thế kích thước của Protobuf: đo thật JSON+gzip (33 KB) nhỏ hơn cả Protobuf thô (188 KB) lẫn Protobuf+gzip (37 KB) — nếu đã gzip cả lô, JSON cạnh tranh sòng phẳng về kích thước.
- Nhưng đừng bỏ Protobuf chỉ vì kích thước: lợi thế còn lại là tốc độ giải mã (~9,7 lần) và schema — nén không đụng tới; và với message lẻ không nén, Protobuf vẫn nhỏ hơn 2 lần; nén tốn CPU (6,4 ms/384 KB) nên cân theo cách gửi thật.
Nguồn
- Go docs — compress/gzip: https://pkg.go.dev/compress/gzip
- Go — klauspost/compress (zstd): https://pkg.go.dev/github.com/klauspost/compress/zstd
- RFC 1951 — DEFLATE Compressed Data Format: https://www.rfc-editor.org/rfc/rfc1951
Phần sau ta bàn một vấn đề vận hành sống còn: schema evolution — thêm và bớt field mà không làm hỏng các bên đang chạy phiên bản cũ; demo thật tương thích tiến/lùi bằng field number của Protobuf.
