Suốt sê-ri, một chủ đề lặp đi lặp lại: Redis xử lý một luồng (bài 1), nên mỗi lệnh chạy trọn vẹn trước lệnh sau. Đây là nguồn tốc độ và tính nguyên tử — nhưng cũng là một cạm bẫy: một lệnh chậm chặn TẤT CẢ. Hai thủ phạm phổ biến nhất gây ra sự cố này trong production là big key (một key chứa quá nhiều dữ liệu, thao tác lên nó là O(n)) và lệnh KEYS * (quét toàn bộ keyspace). Cả hai trông vô hại khi dữ liệu nhỏ, rồi làm khựng cả hệ thống khi dữ liệu lớn. Bài này (phần 11/12) đo thật tác hại của chúng và cách tránh.
MEMORY USAGE, big key, và SCAN
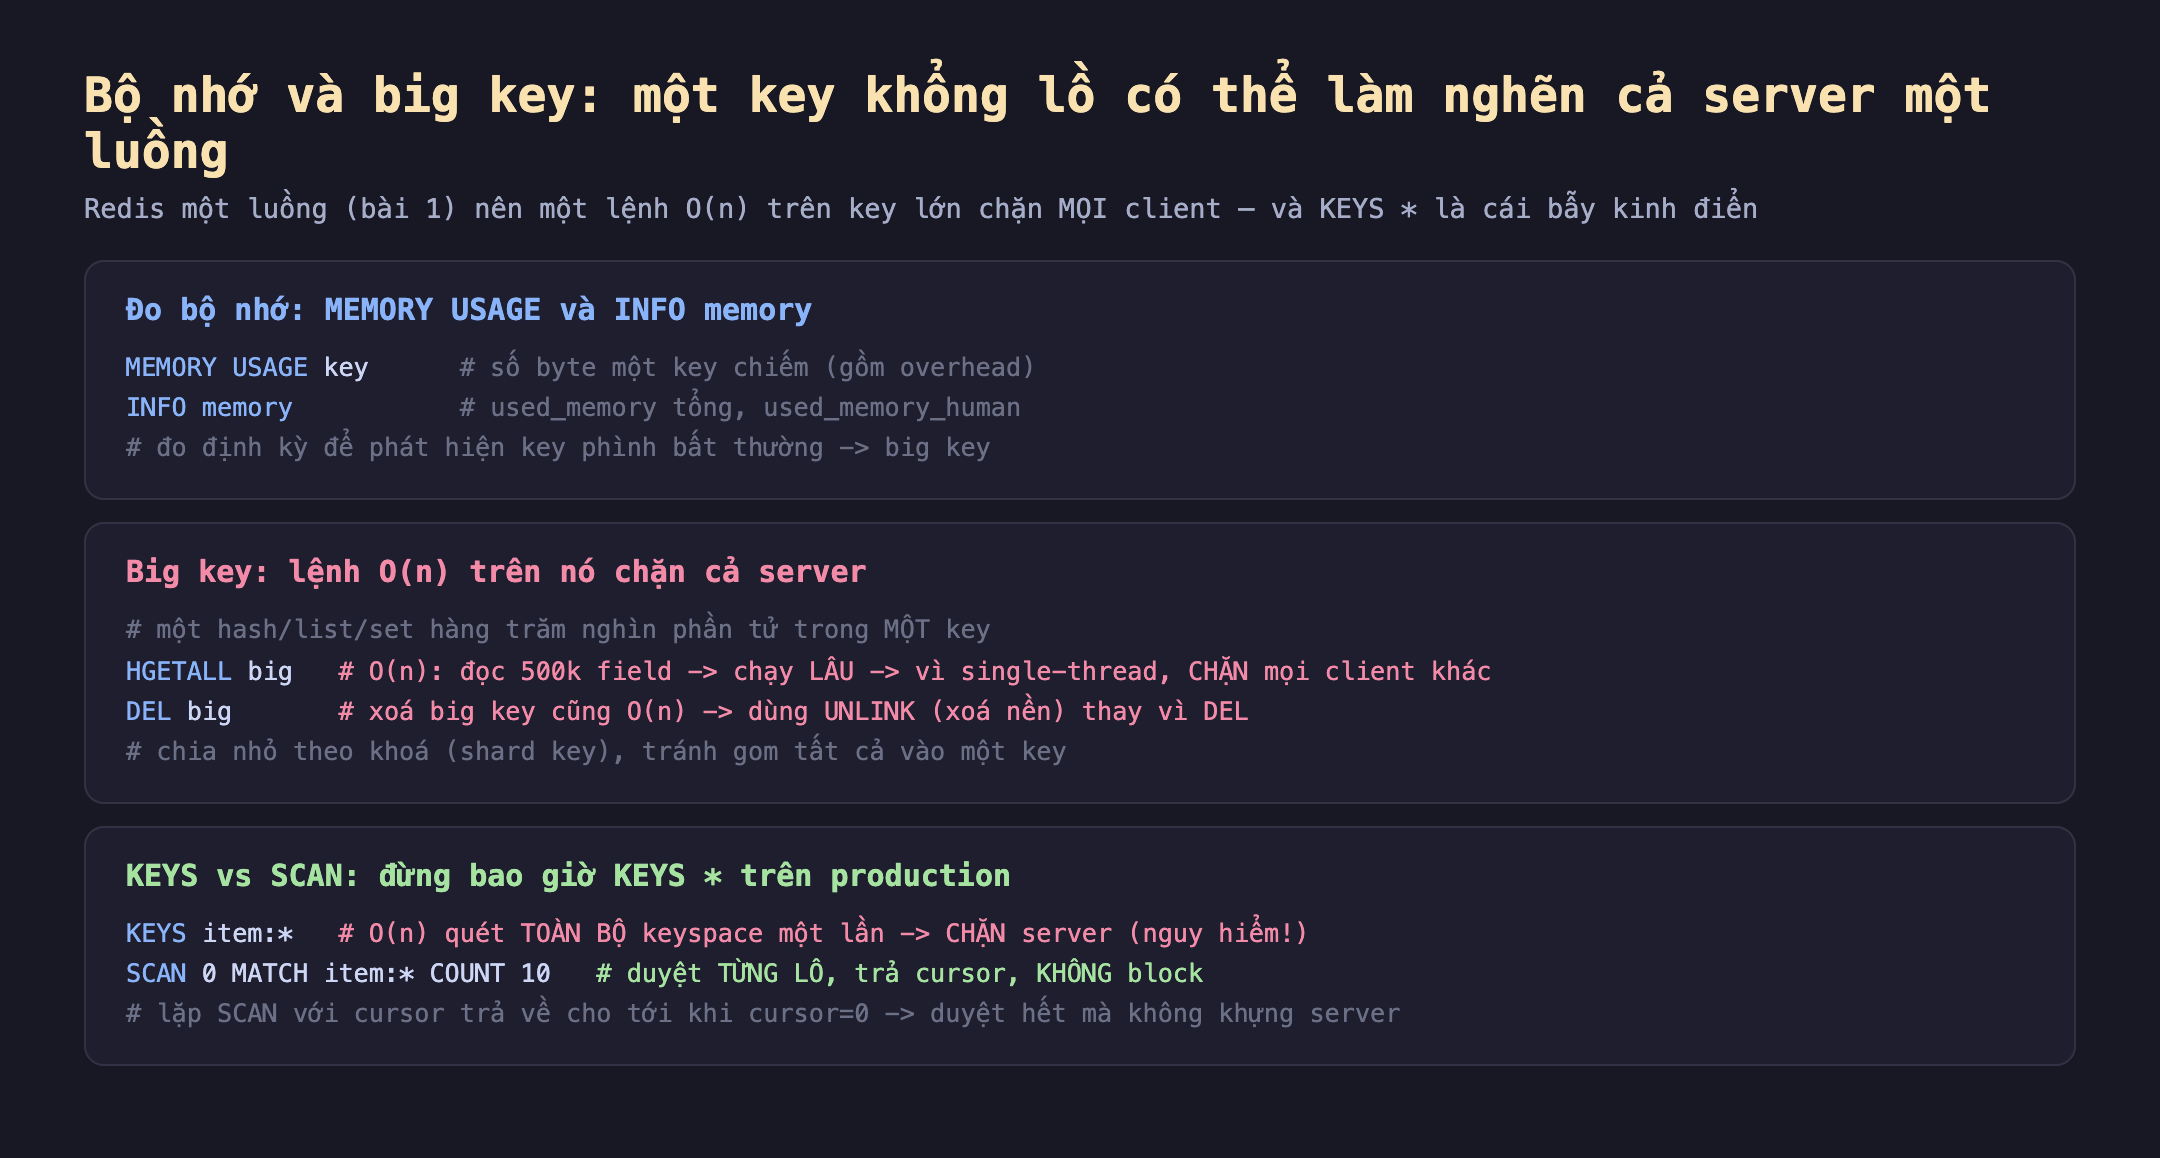
Hình 1: MEMORY USAGE đo byte mỗi key. Big key: lệnh O(n) (HGETALL, DEL) trên key khổng lồ chặn cả server một luồng — dùng UNLINK thay DEL, chia nhỏ key. KEYS * quét toàn bộ O(n) chặn server; SCAN duyệt từng lô không block.
- MEMORY USAGE: đo số byte một key chiếm (gồm overhead);
INFO memorychoused_memorytổng. Đo định kỳ để phát hiện key phình bất thường trước khi nó gây sự cố. - Big key: một hash/list/set hàng trăm nghìn phần tử trong một key. Thao tác O(n) lên nó (
HGETALL,LRANGE 0 -1, cảDEL) chạy lâu → vì single-thread, chặn mọi client khác. DùngUNLINK(xoá nền) thayDEL, và chia nhỏ theo khoá. - KEYS vs SCAN:
KEYS *quét toàn bộ keyspace O(n) trong một lệnh → chặn server (cực nguy hiểm trên production).SCANduyệt từng lô, trả cursor, không block.
Đo thật: big key và KEYS vs SCAN
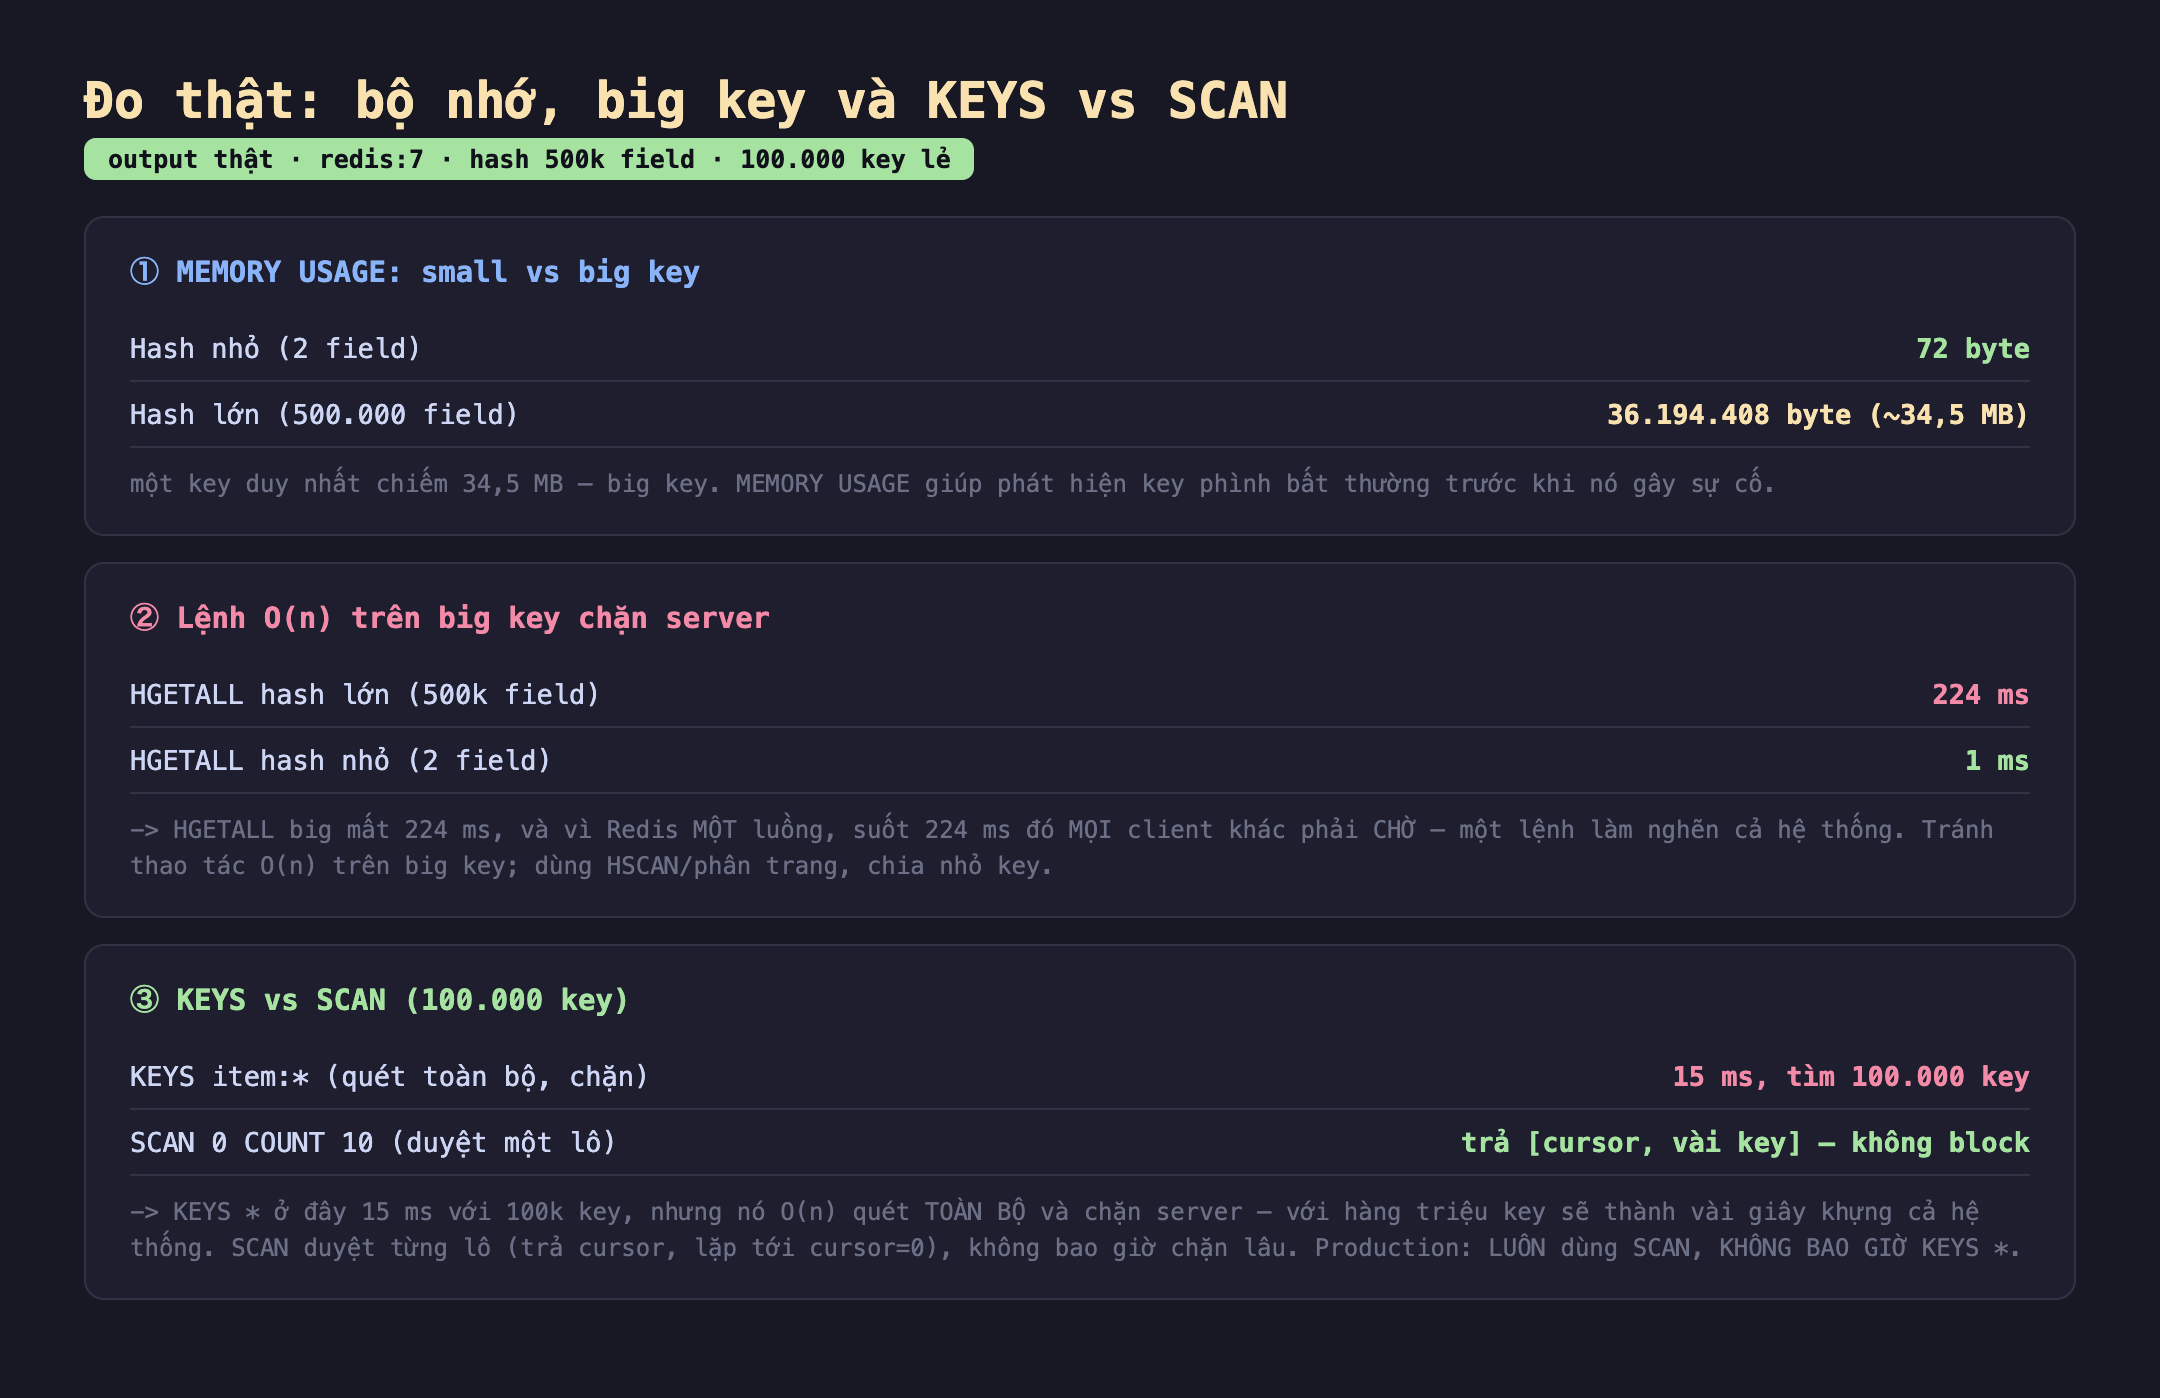
Hình 2: Đo thật. (1) MEMORY USAGE: hash nhỏ 72 byte vs hash lớn 500k field 34,5 MB. (2) HGETALL hash lớn 224ms vs nhỏ 1ms — big key chặn server suốt 224ms. (3) KEYS * (100k key) 15ms quét toàn bộ; SCAN duyệt từng lô không block.
Kết quả thật:
- ① MEMORY USAGE: hash nhỏ (2 field) chỉ 72 byte; hash lớn (500.000 field) chiếm 36.194.408 byte ≈ 34,5 MB — một big key.
MEMORY USAGEgiúp phát hiện key phình bất thường để xử lý trước khi nó gây sự cố. - ② Big key chặn server:
HGETALLtrên hash lớn mất 224 ms (so với 1 ms cho hash nhỏ). Và vì Redis một luồng, suốt 224 ms đó mọi client khác phải chờ — một lệnh duy nhất làm nghẽn cả hệ thống. Trong production, mộtHGETALLtrên một big key có thể gây đợt latency tăng vọt cho toàn bộ traffic. Tránh thao tác O(n) trên big key — dùngHSCAN/phân trang để đọc dần, và chia nhỏ key. - ③ KEYS vs SCAN:
KEYS item:*trên 100.000 key mất 15 ms, tìm 100.000 key. Nghe nhanh, nhưng nó O(n) quét toàn bộ keyspace và chặn server trong suốt thời gian đó — với hàng triệu key, 15 ms thành vài giây khựng cả hệ thống.SCANtrả về[cursor, vài key]theo từng lô, lặp với cursor tới khi cursor=0 — không bao giờ chặn lâu. Quy tắc production: luôn dùng SCAN, không bao giờ KEYS *.
Đánh đổi cần cân nhắc
SCAN đánh đổi tính nhất quán lấy không-block. Vì SCAN duyệt dần trong khi keyspace vẫn thay đổi, nó đảm bảo yếu: một key tồn tại suốt quá trình duyệt chắc chắn được trả (ít nhất một lần), nhưng key thêm/xoá giữa chừng có thể bị bỏ sót hoặc trả trùng. Đây là đánh đổi đúng: thà duyệt "gần đúng" mà không khựng server, còn hơn "chính xác tuyệt đối" mà chặn mọi thứ. Code dùng SCAN phải chịu được việc thấy key trùng (dùng set để khử) và không giả định ảnh chụp nhất quán.
Big key không chỉ chậm — còn gây lệch tải và khó nhân bản. Một big key nằm trên một shard (khi cluster), làm shard đó nóng hơn hẳn (hotspot) — phá vỡ cân bằng tải. Nó cũng làm replication và RDB/AOF (bài 10) nặng hơn (phải truyền/ghi cả khối lớn). Và nối với bài eviction: một big key bị eviction/expire có thể gây nhịp giật khi xoá O(n). Thiết kế để không có big key ngay từ đầu — chia theo khoá con, giới hạn kích thước collection.
Dùng UNLINK thay DEL cho key lớn. DEL một big key là thao tác đồng bộ O(n) — chặn server trong lúc giải phóng hàng trăm nghìn phần tử. UNLINK gỡ key khỏi keyspace ngay (nhanh) rồi giải phóng bộ nhớ ở luồng nền — không chặn. Với key lớn, luôn ưu tiên UNLINK. Tương tự, FLUSHALL ASYNC/FLUSHDB ASYNC xoá nền thay vì chặn.
Ba ý mang về
- Một luồng nghĩa là một lệnh chậm chặn tất cả — big key là thủ phạm chính. Đo thật: hash 500k field chiếm 34,5 MB, HGETALL trên nó mất 224ms (vs 1ms cho hash nhỏ), và suốt 224ms đó mọi client khác phải chờ. Tránh thao tác O(n) trên key lớn; chia nhỏ, dùng HSCAN/phân trang.
- KEYS * là cái bẫy — luôn dùng SCAN trên production. Đo thật: KEYS trên 100k key quét toàn bộ (15ms, scale lên vài giây với triệu key, chặn cả server); SCAN duyệt từng lô (trả cursor, lặp tới 0) không block. KEYS * là lệnh không được phép chạy trên Redis production.
- Đo bộ nhớ và dùng lệnh không-block. MEMORY USAGE phát hiện big key sớm; SCAN đánh đổi nhất quán lấy không-block (chịu được key trùng); UNLINK thay DEL cho key lớn (giải phóng nền). Big key còn gây hotspot và nặng replication — thiết kế để tránh từ đầu.
Nguồn
- Redis — MEMORY USAGE & memory optimization: https://redis.io/docs/latest/operate/oss_and_stack/management/optimization/memory-optimization/
- Redis — SCAN (vs KEYS): https://redis.io/commands/scan/
- Redis — UNLINK (non-blocking delete): https://redis.io/commands/unlink/
Phần sau là bài tổng kết sê-ri: khi nào dùng Redis khi nào không, Redis vs Memcached vs database, và một checklist vận hành đúc kết từ 11 bài đã đo.
