Suốt mười một bài, chúng ta đi từ "Redis là gì và vì sao nhanh" tới những chi tiết vận hành sâu: kiểu dữ liệu, pipeline, transaction/Lua, TTL/eviction, pub-sub/streams, cache stampede, distributed lock, rate limiting, persistence, và big key. Mỗi bài kèm một phép đo thật trong redis-lab. Nhưng kiến thức rời rạc không giúp bạn ra quyết định. Hai câu hỏi thực tế: dự án của tôi có nên dùng Redis không? và nếu có, cần lưu ý gì để vận hành an toàn? Bài cuối này (phần 12/12) gộp mọi thứ thành hai công cụ: một so sánh để chọn, và một checklist để triển khai.
Khi nào dùng Redis — và khi nào không
Redis mạnh và đa năng, nhưng có một ranh giới quan trọng: nó sống trong RAM và không thay thế database. Hiểu vị trí của nó so với Memcached và database giúp chọn đúng.
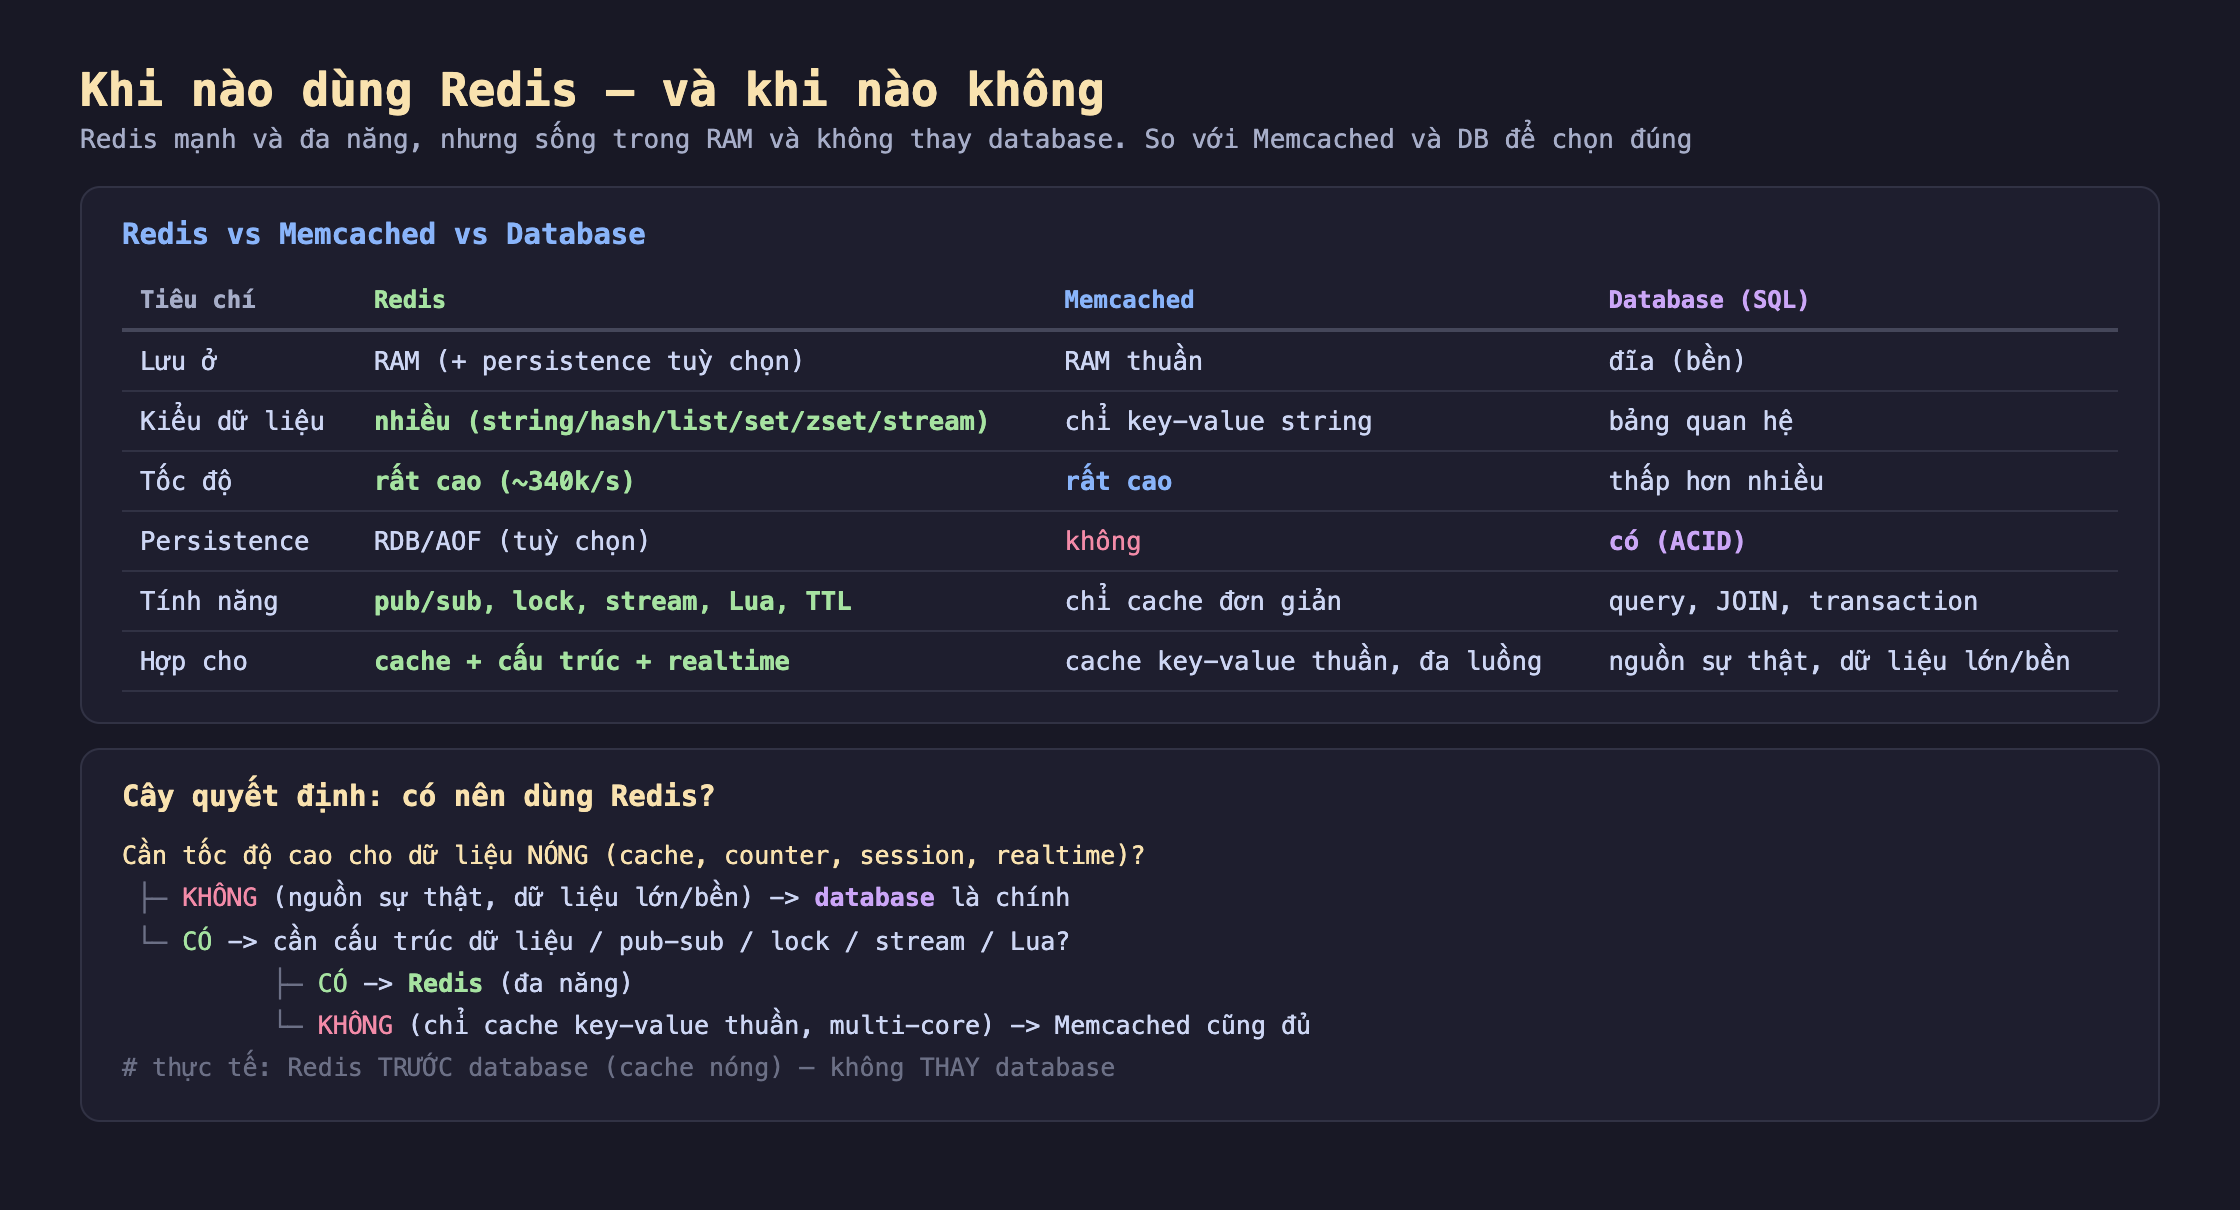
Hình 1: So sánh Redis với Memcached và database. Redis thắng ở đa dạng kiểu dữ liệu và tính năng (pub/sub, lock, stream, Lua); Memcached cho cache key-value thuần đa luồng; database cho nguồn sự thật/dữ liệu bền. Cây quyết định giúp chọn đúng.
Ba điểm từ bảng:
- Redis đa năng nhất: nhiều kiểu dữ liệu (string/hash/list/set/sorted set/stream), persistence tuỳ chọn, và cả một kho tính năng — pub/sub, lock, Lua, TTL, rate limit. Hợp khi bạn cần cache + cấu trúc dữ liệu + realtime trong một công cụ.
- Memcached đơn giản hơn: chỉ cache key-value string thuần, đa luồng. Nếu bài toán chỉ là cache key-value đơn giản và muốn tận dụng đa lõi tối đa, Memcached vẫn là lựa chọn gọn.
- Database là nguồn sự thật: lưu trên đĩa, ACID, query/JOIN/transaction mạnh. Redis không thay database — nó đặt trước database để tăng tốc dữ liệu nóng.
Cây quyết định gói gọn: Cần tốc độ cao cho dữ liệu nóng? Không → database là chính. Có → cần cấu trúc/pub-sub/lock/stream/Lua? Có → Redis; không (chỉ cache key-value thuần) → Memcached cũng đủ. Và nhớ nguyên tắc: Redis đi trước database, không thay database.
Checklist vận hành và số liệu đã đo
Nếu đã chọn Redis, đây là checklist đúc kết từ 11 bài — mỗi mục là một quyết định đã được giải thích và đo:
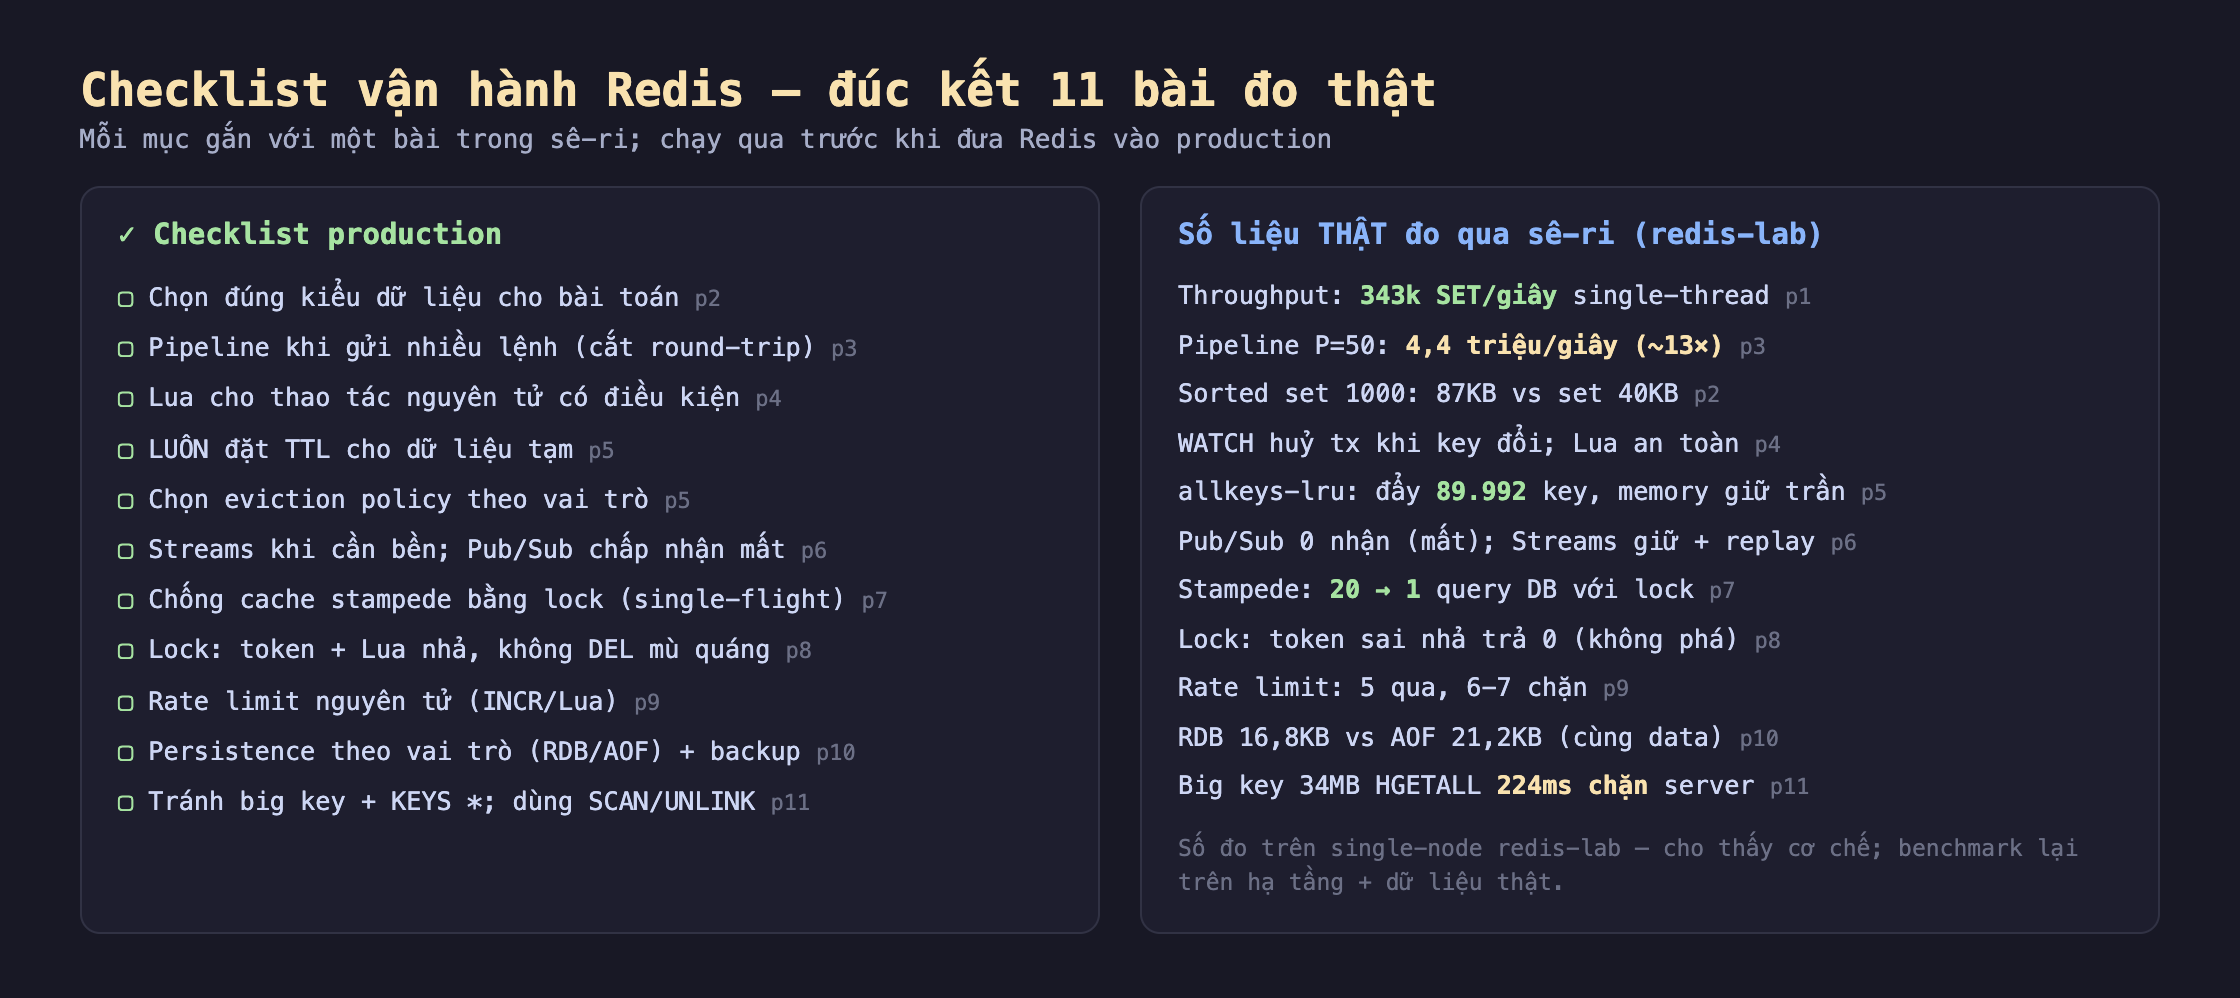
Hình 2: Bên trái — checklist vận hành production, mỗi mục trỏ về bài tương ứng. Bên phải — tổng hợp số liệu thật đo được qua sê-ri trong redis-lab.
Vài quyết định quan trọng nhất, nhắc lại ngắn gọn:
- Chọn đúng kiểu dữ liệu (bài 2): sorted set cho ranking, set cho quan hệ, hash cho object — chọn sai là vừa chậm vừa tốn RAM.
- Pipeline + Lua (bài 3, 4): gộp lệnh để cắt round-trip (13× throughput); Lua cho thao tác nguyên tử có điều kiện (nền cho lock, rate limit).
- TTL + eviction đúng vai trò (bài 5): luôn đặt TTL cho dữ liệu tạm; cache → allkeys-lru, store → noeviction.
- Lock và rate limit làm đúng (bài 8, 9): lock cần token + Lua nhả (không DEL mù quáng); rate limit phải nguyên tử (INCR/Lua).
- Tránh big key + KEYS * (bài 11): dùng SCAN/UNLINK, giám sát bộ nhớ — một key lớn hay một KEYS * làm nghẽn cả server một luồng.
Và các con số thật nhắc rằng Redis nhanh và mạnh: 343 nghìn SET/giây, pipeline đẩy lên 4,4 triệu/giây, lock chặn stampede từ 20 xuống 1 query DB. Nhưng cũng nhắc đo chứ đừng đoán — và vài bài học quan trọng chỉ rõ khi chạy thật: một big key HGETALL chặn server 224ms, allkeys-lru đẩy 89.992 key để giữ trần RAM, Pub/Sub âm thầm mất message khi không ai nghe.
Vài sự thật cần giữ thẳng thắn
Mọi con số trong sê-ri đo trên single-node redis-lab. Chúng cho thấy bản chất cơ chế và hướng (pipeline nhanh hơn, big key chặn server, lru giữ trần RAM), nhưng giá trị tuyệt đối trên hạ tầng thật sẽ khác: mạng, kích thước dữ liệu, tải đồng thời, cluster nhiều node. Dùng số của lab để quyết định kiến trúc, benchmark lại trên môi trường và dữ liệu gần production để lấy con số dung lượng.
Redis mạnh dễ bị lạm dụng thành "database thứ hai". Vì Redis nhanh và tiện, có cám dỗ nhét mọi thứ vào nó — kể cả dữ liệu không được mất, dữ liệu lớn không nóng. Nhưng Redis bị giới hạn bởi RAM (đắt), persistence không bằng ACID, và một big key làm nghẽn server. Giữ Redis cho đúng vai: dữ liệu nóng, cấu trúc phù hợp, chấp nhận giới hạn RAM. Database vẫn là nguồn sự thật.
Vận hành Redis có những cái bẫy chết người đơn giản. Sê-ri cho thấy nhiều lỗi dễ mắc mà hậu quả lớn: KEYS * trên production, nhả lock bằng DEL, quên TTL (rò rỉ RAM), chọn sai eviction policy (cache dùng noeviction thì ngừng nhận dữ liệu khi đầy), big key. Những thứ này trông vô hại trong dev rồi gây sự cố ở quy mô thật. Checklist ở Hình 2 chính là để tránh chúng.
Ba ý mang về
- Redis đi trước database, không thay database. Đa năng (nhiều kiểu dữ liệu + pub/sub/lock/stream/Lua) và nhanh (343k/giây), hợp cho dữ liệu nóng/cấu trúc/realtime; nhưng giới hạn RAM và persistence không bằng ACID. Memcached cho cache thuần, database cho nguồn sự thật.
- Vận hành Redis đúng là một checklist, không phải một mẹo. Chọn kiểu dữ liệu, pipeline, Lua nguyên tử, TTL + eviction đúng vai trò, Streams khi cần bền, lock/rate-limit làm đúng, persistence theo vai trò, tránh big key/KEYS — mỗi mục đã được đo; bỏ một mục thường mở một lỗ hổng.
- Đo chứ đừng đoán, và biết giới hạn phép đo. Sê-ri cho số thật (343k/giây, pipeline 13×, stampede 20→1, big key 224ms) nhưng trên single-node lab — chúng dạy cơ chế, không thay benchmark trên hạ tầng thật. Và cảnh giác các bẫy đơn giản: KEYS *, DEL lock, quên TTL, sai eviction.
Nguồn
- Redis — Documentation (toàn bộ): https://redis.io/docs/latest/
- Redis — Best practices & patterns: https://redis.io/docs/latest/develop/use/patterns/
- AWS — Redis vs Memcached (ElastiCache): https://aws.amazon.com/elasticache/redis-vs-memcached/
