Bài trước nói VACUUM "autovacuum tự lo" — nhưng "tự lo" không có nghĩa là "lo đúng". Autovacuum có một công thức quyết định khi nào chạy, và mặc định của công thức đó hoạt động tốt cho bảng nhỏ nhưng thất bại âm thầm trên bảng lớn, để bloat tích lũy tới hàng triệu dòng trước khi đụng tay vào. Bài này giải thích công thức, đo thật cạm bẫy trên bảng lớn, và chỉ cách chỉnh cùng theo dõi để autovacuum thực sự theo kịp tải ghi.
Công thức: khi nào autovacuum chạy
Autovacuum kích hoạt VACUUM cho một bảng khi số dead tuple vượt một ngưỡng động:
n_dead_tup > autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor × n_live_tup
Mặc định: threshold = 50, scale_factor = 0.2. Nghĩa là autovacuum đợi cho tới khi dead tuple đạt 50 cộng 20% số dòng sống. Với bảng 100.000 dòng, ngưỡng là 50 + 0.2 × 100000 = 20.050 dead tuple.
-- xem tham số hiện tại
SELECT name, setting FROM pg_settings
WHERE name LIKE 'autovacuum%';   -- threshold=50, scale_factor=0.2, naptime=60, max_workers=3
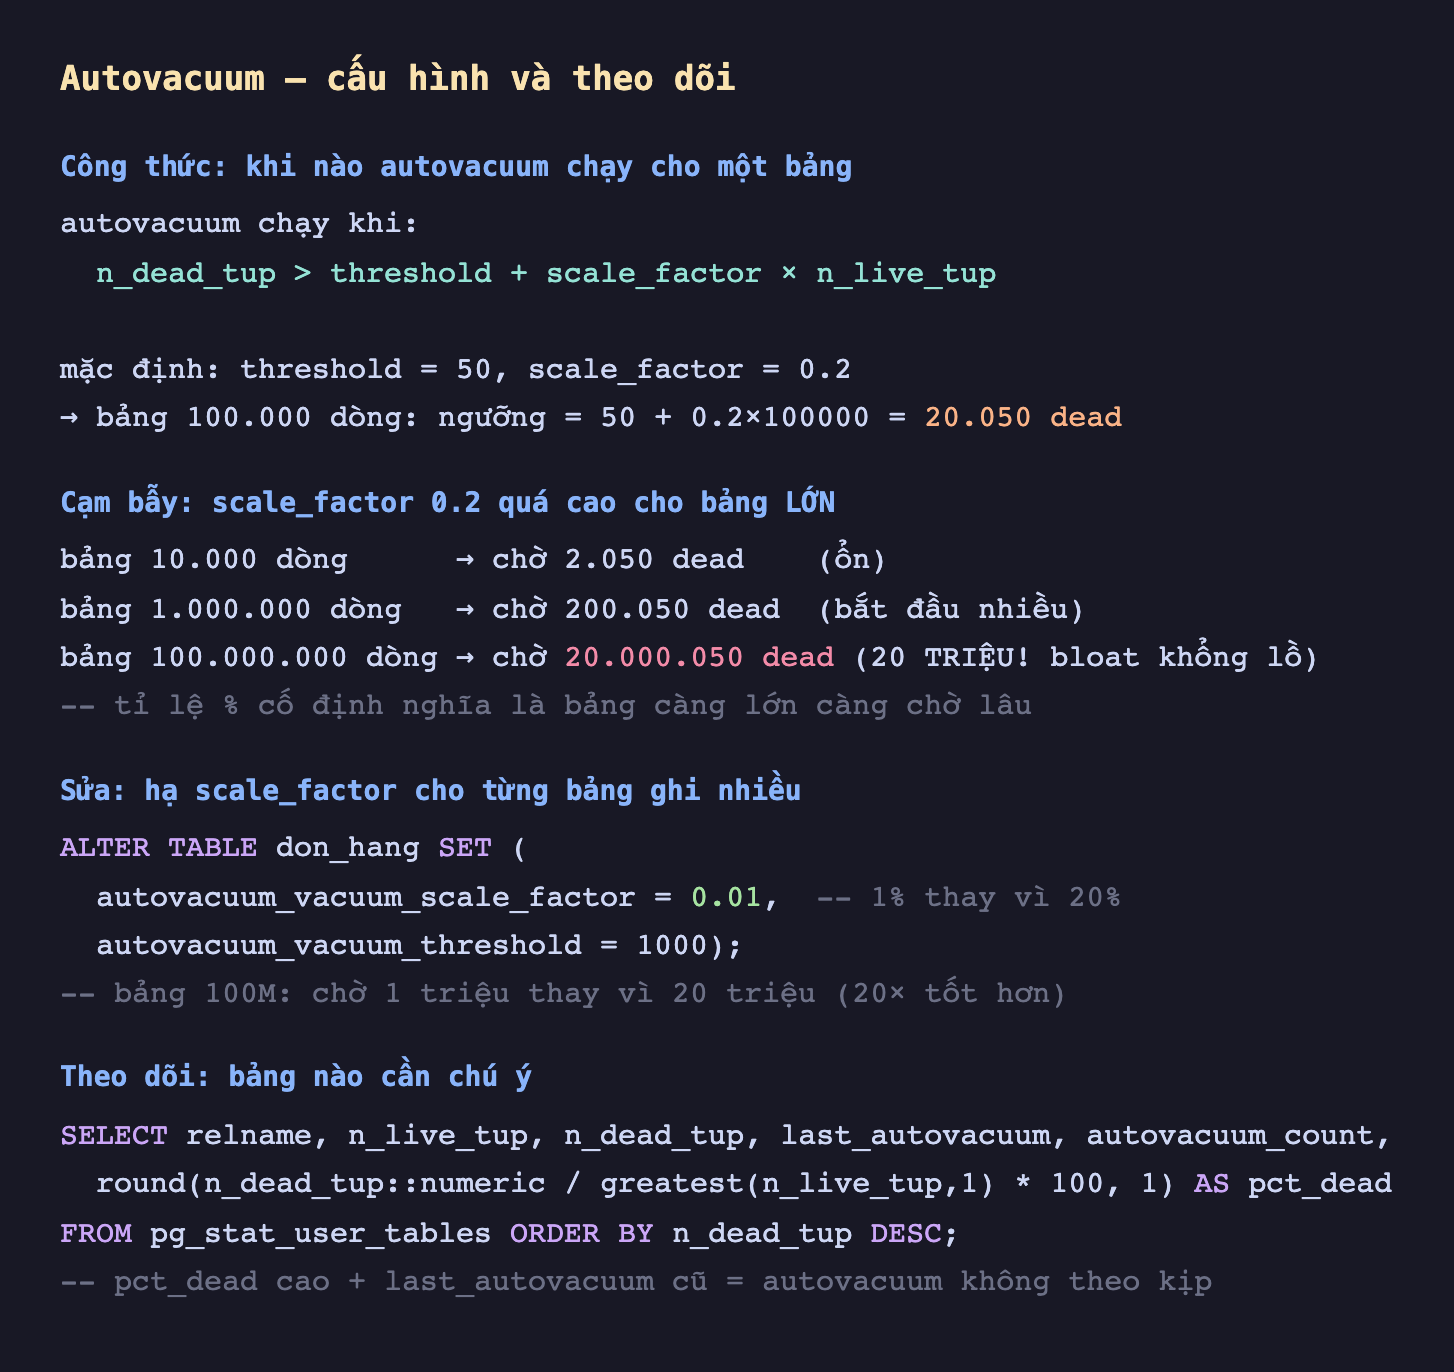
Hình 1: Autovacuum chạy khi dead tuple vượt threshold + scale_factor × n_live_tup. Vì scale_factor là tỉ lệ cố định, bảng càng lớn ngưỡng càng cao. Chỉnh per-table và theo dõi qua pg_stat_user_tables.
Đo thật: cạm bẫy scale_factor trên bảng lớn
scale_factor là một tỉ lệ phần trăm cố định, và đây chính là vấn đề. Bảng càng lớn, ngưỡng tuyệt đối càng cao — autovacuum càng đợi lâu, càng nhiều bloat tích lũy. Tính ngưỡng cho các cỡ bảng khác nhau:
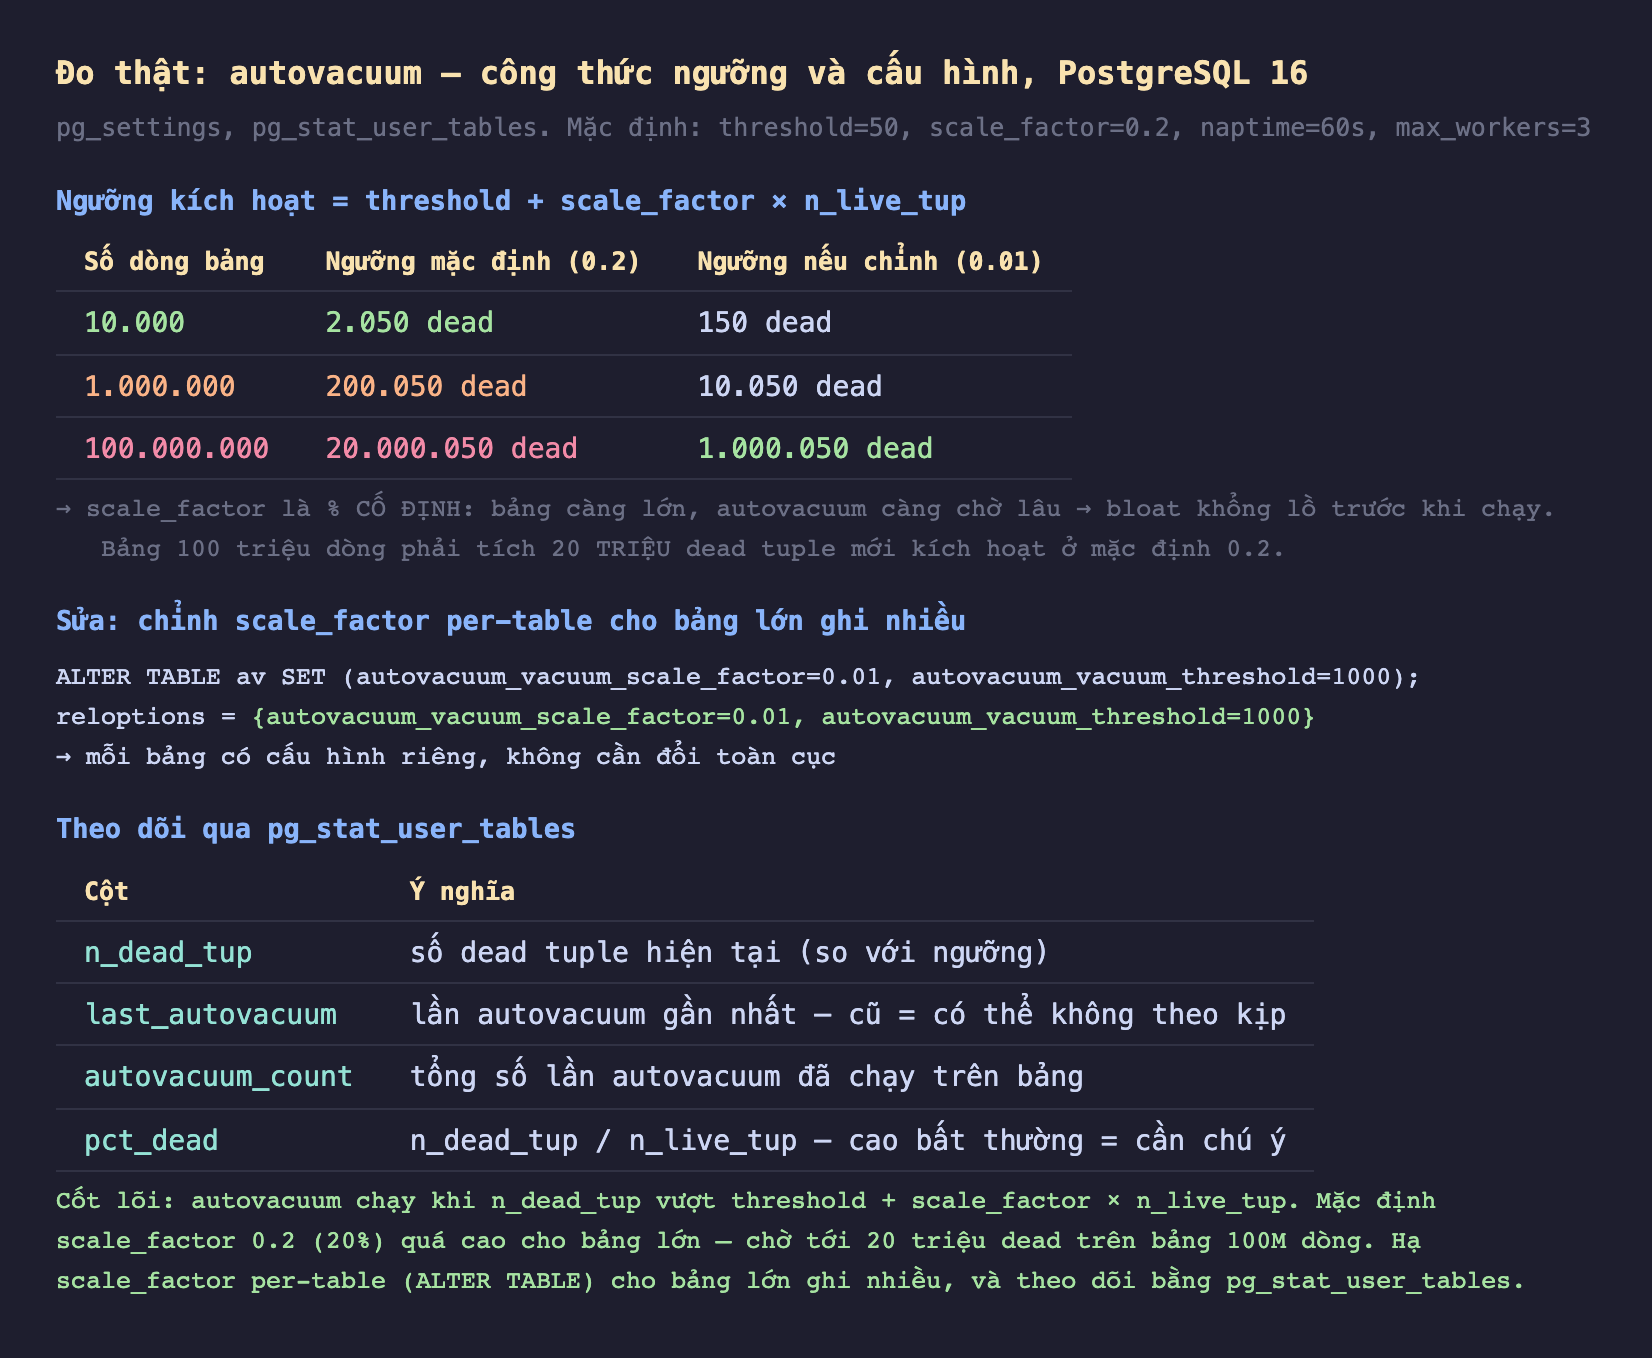
Hình 2: Với scale_factor mặc định 0.2: bảng 10.000 dòng chờ 2.050 dead (ổn), bảng 1 triệu chờ 200.050, bảng 100 triệu chờ 20.000.050 dead (20 triệu!). Hạ per-table xuống 0.01 giảm còn 1 triệu — tốt hơn 20 lần.
- 10.000 dòng: chờ 2.050 dead — ổn.
- 1.000.000 dòng: chờ 200.050 dead — bắt đầu nhiều.
- 100.000.000 dòng: chờ 20.000.050 dead — 20 triệu dòng chết tích lũy trước khi autovacuum động tay! Bảng phình khổng lồ, truy vấn chậm dần, mà không lỗi nào báo.
Đây là lý do bảng lớn ghi nhiều thường bị bloat dù autovacuum "đang bật": ngưỡng mặc định quá cao cho quy mô đó.
Sửa: chỉnh scale_factor per-table
Không cần đổi cấu hình toàn cục (ảnh hưởng mọi bảng). PostgreSQL cho phép chỉnh từng bảng:
ALTER TABLE don_hang SET (
  autovacuum_vacuum_scale_factor = 0.01,   -- 1% thay vì 20%
  autovacuum_vacuum_threshold = 1000);
Với scale_factor = 0.01, bảng 100 triệu dòng chỉ chờ ~1 triệu dead thay vì 20 triệu — tốt hơn 20 lần. Đo thật xác nhận cơ chế hoạt động: sau khi hạ scale_factor xuống 0.01 trên một bảng 100.000 dòng đang có 25.000 dead tuple (vượt ngưỡng mới 2.000), autovacuum chạy ngay trong chu kỳ tiếp theo — autovacuum_count tăng lên 1 và n_dead_tup về 0. Quy tắc: bảng càng lớn và ghi càng nhiều, scale_factor càng nên thấp.
Theo dõi: bảng nào cần chú ý
pg_stat_user_tables cho biết autovacuum có theo kịp không:
SELECT relname, n_live_tup, n_dead_tup, last_autovacuum, autovacuum_count,
  round(n_dead_tup::numeric / greatest(n_live_tup,1) * 100, 1) AS pct_dead
FROM pg_stat_user_tables ORDER BY n_dead_tup DESC;
Các cột quan trọng: n_dead_tup (so với ngưỡng), last_autovacuum (cũ = có thể không theo kịp), autovacuum_count (số lần đã chạy), và pct_dead (tỉ lệ chết). Một bảng có pct_dead cao và last_autovacuum lâu là dấu hiệu autovacuum tụt lại — cần hạ scale_factor hoặc tăng số worker.
Đánh đổi cần cân nhắc
Đừng hạ scale_factor toàn cục quá thấp. Nếu đặt scale_factor = 0.01 cho cả cụm, các bảng nhỏ sẽ bị vacuum quá thường xuyên (mỗi vài chục dead tuple), tốn CPU/IO vô ích. Chỉnh per-table cho những bảng lớn ghi nhiều là cách đúng — giữ mặc định cho phần còn lại.
Autovacuum có thể bị giới hạn tốc độ, không chỉ ngưỡng. Ngay cả khi ngưỡng đúng, autovacuum có thể chạy chậm vì autovacuum_vacuum_cost_delay/cost_limit bóp ga để không đè I/O. Trên máy chủ mạnh, tăng cost_limit (hoặc giảm cost_delay) giúp autovacuum dọn nhanh hơn khi tải ghi cao. Số worker (autovacuum_max_workers, mặc định 3) cũng giới hạn bao nhiêu bảng được vacuum song song.
Autovacuum để INSERT-only cũng cần từ PG13. Bảng chỉ INSERT (không UPDATE/DELETE) không sinh dead tuple, nhưng vẫn cần vacuum để freeze (chống wraparound) và cập nhật visibility map. PG13+ có autovacuum_vacuum_insert_scale_factor xử lý việc này — đừng cho rằng bảng chỉ chèn thì không cần autovacuum.
Ba ý mang về
- Autovacuum chạy theo công thức
threshold + scale_factor × n_live_tup: mặc định 50 + 20% số dòng sống — với bảng 100.000 dòng là 20.050 dead tuple, hợp lý cho bảng nhỏ. - scale_factor mặc định 0.2 là cạm bẫy cho bảng lớn: đo thật, bảng 100 triệu dòng phải tích 20 triệu dead tuple mới kích hoạt autovacuum — bloat khổng lồ tích lũy âm thầm; hạ
scale_factorper-table xuống 0.01 giảm còn 1 triệu (tốt hơn 20 lần). - Theo dõi qua
pg_stat_user_tables:n_dead_tup,last_autovacuum,autovacuum_count, và tỉ lệpct_deadcho biết autovacuum có theo kịp không — bảngpct_deadcao vớilast_autovacuumcũ cần chỉnh scale_factor hoặc tăng worker.
Phần sau ta xét công cụ mạnh nhưng nguy hiểm mà nhiều bài đã nhắc: Phần sau mổ xẻ VACUUM FULL — khi nào thật sự cần nó để thu hồi dung lượng, vì sao nó khóa toàn bảng, và các rủi ro cùng lựa chọn thay thế như pg_repack.
