Người đến từ MySQL, SQL Server hay Oracle mang theo một trực giác: char(n) cố định nhanh hơn varchar vì độ dài đều đặn, và varchar(n) tiết kiệm hơn text. Cả hai đều sai trong PostgreSQL. Ở đây, text và varchar là cùng một thứ bên trong, còn char(n) không nhanh hơn — nó tốn gấp đôi và gây bẫy. Bài này đo thật ba kiểu chuỗi và giải thích vì sao lời khuyên "dùng char cho cột độ dài cố định" là di sản từ các CSDL khác.
text và varchar: y hệt nhau bên trong
PostgreSQL lưu cả ba kiểu chuỗi bằng cùng một cấu trúc varlena (mảng byte có độ dài biến thiên kèm header). text và varchar dùng cùng cách lưu, cùng toán tử, cùng operator class cho index — không có khác biệt hiệu năng nào:
SELECT 'abc'::text = 'abc'::varchar;         -- t (TRUE)
SELECT pg_typeof('a'::varchar || 'b'::text); -- text
varchar(n) chỉ khác text ở một điểm: nó thêm một ràng buộc CHECK giới hạn độ dài. Không có gì hơn — không tối ưu lưu trữ, không nhanh hơn.
CREATE TEMP TABLE tv(v varchar(5));
INSERT INTO tv VALUES ('chuoi-qua-dai');
-- ERROR: value too long for type character varying(5)
text thì nhận mọi độ dài. Nên lựa chọn giữa text và varchar(n) thuần túy là câu hỏi "bạn có muốn CSDL ép giới hạn độ dài không", không phải câu hỏi hiệu năng.
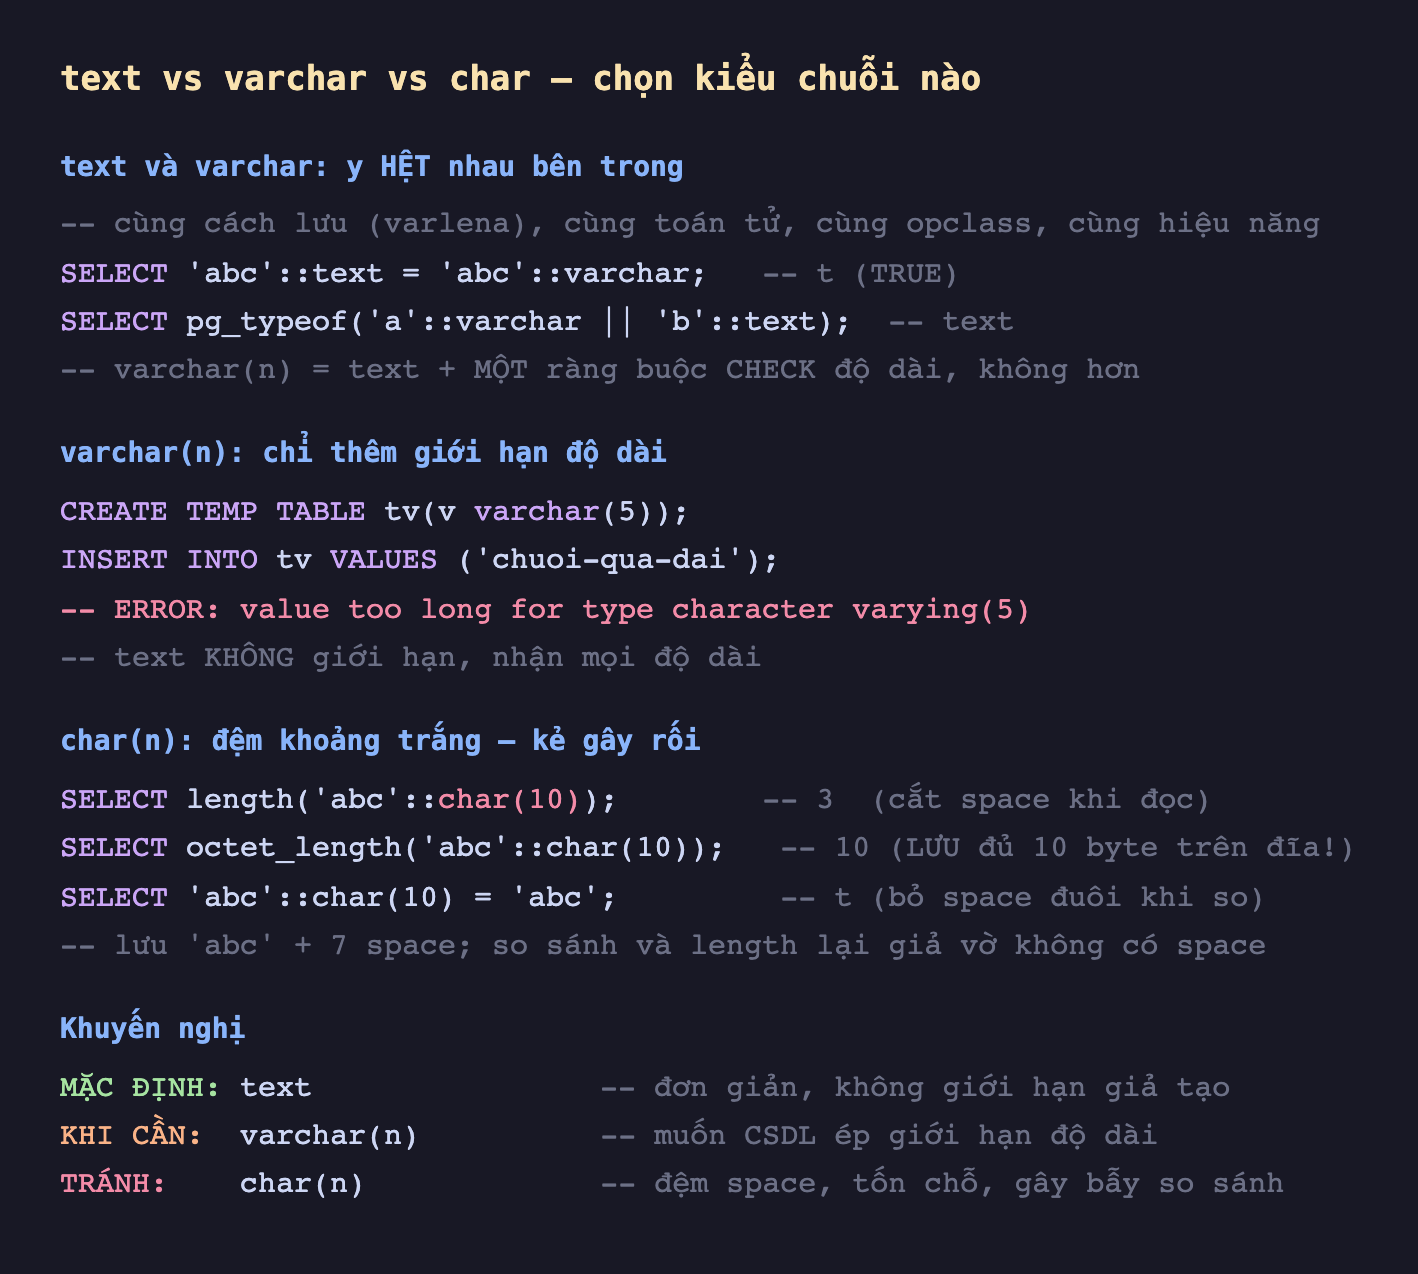
Hình 1: text và varchar dùng chung cách lưu và toán tử; varchar(n) chỉ thêm một CHECK độ dài. char(n) đệm khoảng trắng nên khác biệt và tệ hơn.
Đo thật: char(50) tốn gấp đôi
Trên bảng 5 triệu dòng chứa chuỗi ngắn ('ma123...', 5–9 ký tự), đo kích thước lưu trữ:
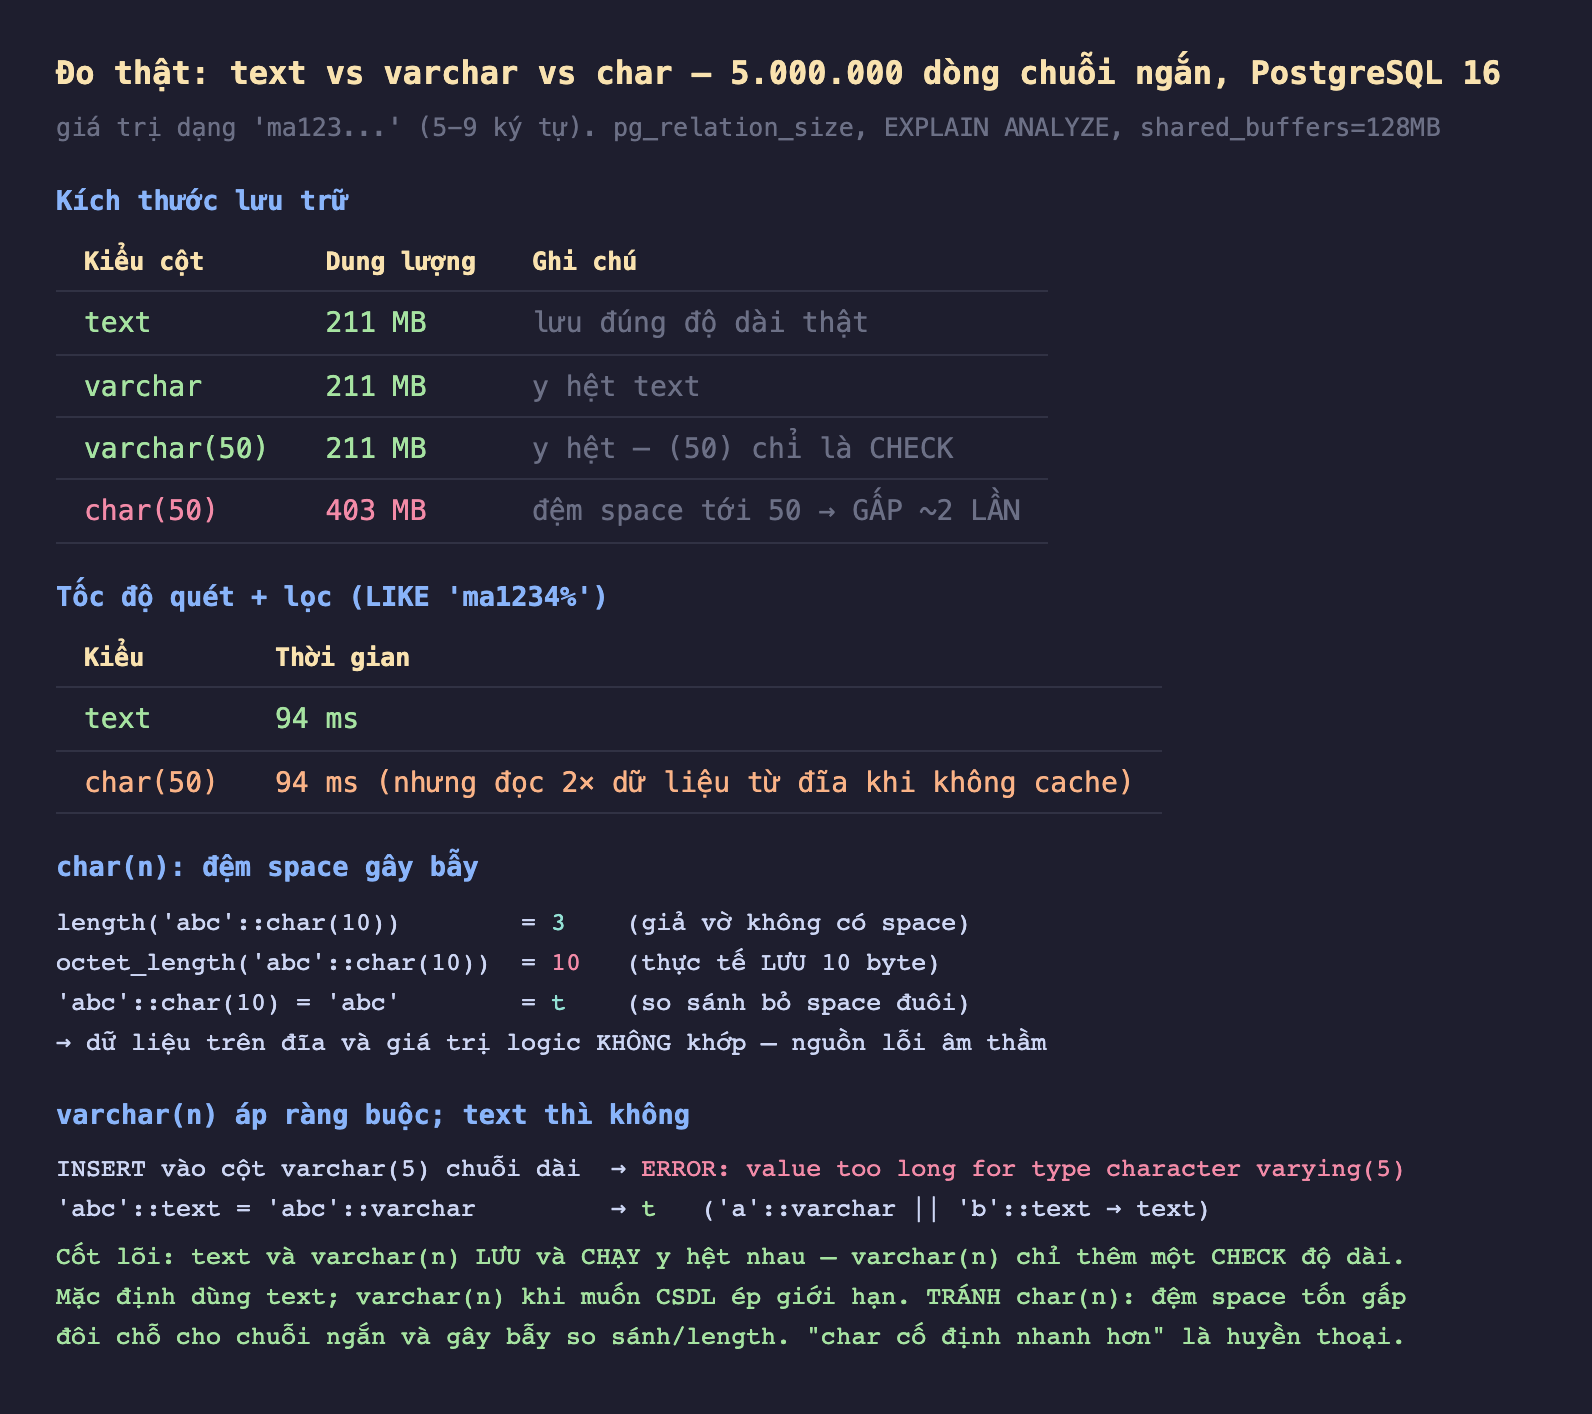
Hình 2: text, varchar, varchar(50) đều chiếm 211 MB (giống hệt); char(50) chiếm 403 MB — gấp đôi vì đệm khoảng trắng tới 50 ký tự cho mọi giá trị. Tốc độ quét tương đương khi cache, nhưng char đọc gấp đôi dữ liệu từ đĩa.
text,varchar,varchar(50): tất cả 211 MB — bằng nhau tuyệt đối, xác nhận chúng lưu y hệt.char(50): 403 MB — gấp đôi. Vìchar(n)đệm khoảng trắng mọi giá trị tới đúngnký tự. Chuỗi'ma5'(3 ký tự) được lưu thành'ma5'+ 47 khoảng trắng.
Tốc độ quét trong bộ nhớ tương đương (~94 ms cả hai), nhưng đây là khi dữ liệu đã cache. Trên bảng thật lớn hơn RAM, char(50) phải đọc gấp đôi số trang từ đĩa — chậm hơn theo đúng tỉ lệ dung lượng thừa.
char(n): cái bẫy đệm khoảng trắng
Ngoài tốn chỗ, char(n) còn nguy hiểm vì độ dài trên đĩa khác độ dài logic:
SELECT length('abc'::char(10));        -- 3   (cắt space khi đọc)
SELECT octet_length('abc'::char(10));  -- 10  (thực tế LƯU 10 byte)
SELECT 'abc'::char(10) = 'abc';        -- t   (so sánh bỏ space đuôi)
PostgreSQL lưu 'abc' + 7 khoảng trắng trên đĩa, nhưng length() và phép so sánh lại giả vờ các khoảng trắng đó không tồn tại. Sự không nhất quán này là nguồn lỗi âm thầm: dữ liệu bạn ghi ra (ví dụ nối chuỗi, xuất file) mang theo khoảng trắng thừa, trong khi truy vấn so sánh lại bỏ qua chúng. Khi ứng dụng đọc giá trị char(n) và so bằng == ở tầng code (không bỏ space), kết quả lệch với những gì SQL trả về.
Đánh đổi cần cân nhắc
text là mặc định đúng trong PostgreSQL. Không có lý do hiệu năng để chọn varchar(n) thay text. Chỉ dùng varchar(n) khi bạn thật sự muốn CSDL từ chối chuỗi quá dài như một ràng buộc dữ liệu (ví dụ mã bưu chính tối đa 10 ký tự). Ngay cả khi đó, nhiều người thích text + CHECK (length(v) <= 10) để kiểm soát thông báo lỗi rõ hơn.
Đổi varchar(n) sang giới hạn lớn hơn là thao tác nhẹ; thu nhỏ thì không. Tăng n (ví dụ varchar(50) → varchar(100)) chỉ đổi metadata, không viết lại bảng. Nhưng giảm n phải quét kiểm tra mọi dòng. Đây là lý do nữa nên dùng text khi giới hạn chưa chắc chắn.
char(n) chỉ hợp lý cho dữ liệu thật sự cố định độ dài và luôn đủ ký tự — như mã quốc gia char(2) ('VN', 'US') nơi mọi giá trị đúng đủ 2 ký tự, không bao giờ đệm. Nhưng ngay cả ở đây, text cũng chạy tốt như vậy mà không có bẫy khoảng trắng; lợi ích của char(n) gần như bằng không trong PostgreSQL.
Ba ý mang về
textvàvarcharlưu và chạy y hệt nhau trong PostgreSQL — đo thật cảtext,varchar,varchar(50)đều chiếm 211 MB;varchar(n)chỉ thêm một ràng buộcCHECKđộ dài, không hơn về hiệu năng hay lưu trữ.char(n)tốn gấp đôi vì đệm khoảng trắng: đo thậtchar(50)chiếm 403 MB so với 211 MB củatextcho cùng dữ liệu chuỗi ngắn, và đọc gấp đôi từ đĩa khi vượt cache — "char cố định nhanh hơn" là huyền thoại từ CSDL khác.char(n)còn gây bẫy so sánh: độ dài trên đĩa (octet_length= 10) khác độ dài logic (length= 3), khoảng trắng đuôi bị bỏ khi so sánh nhưng vẫn lưu — mặc định dùngtext,varchar(n)khi cần ép giới hạn, tránhchar(n).
Phần sau ta đào sâu chi tiết đã chạm ở bài kiểu số: Phần sau đo cách sắp thứ tự cột để giảm padding căn lề — vì sao cùng một bảng, thứ tự cột khác nhau cho kích thước khác nhau, và quy tắc sắp xếp tối ưu.
