Bạn có index trên cột email, viết WHERE lower(email) = 'abc@mail.com' để tra không phân biệt hoa thường — và truy vấn chậm bất ngờ. Index vẫn đó, nhưng PostgreSQL không dùng. Đây là một trong những lỗi tối ưu phổ biến và âm thầm nhất: bọc một hàm quanh cột trong WHERE làm index trên cột đó thành vô dụng. Bài này đo thật cái giá, giải thích khái niệm "sargable", và trình bày hai cách gỡ — một trong hai còn không cần index mới.
Vì sao index mất tác dụng: nó lưu cột, không lưu hàm
Nguyên tắc gốc rất đơn giản: một index trên email lưu giá trị nguyên gốc của cột — 'User777@Mail.com' — được sắp xếp. Nó không lưu lower(email). Khi bạn viết WHERE lower(email) = 'user777@mail.com', PostgreSQL không có cấu trúc nào sắp theo lower(email) để tra nhanh, nên nó buộc phải tính lower() cho từng dòng rồi so — tức quét cả bảng.
SELECT id FROM tk WHERE lower(email) = 'user777777@mail.com';  -- index vô dụng, Seq Scan
SELECT id FROM tk WHERE email = 'User777777@Mail.com';         -- cột trần, Index Scan tức thì
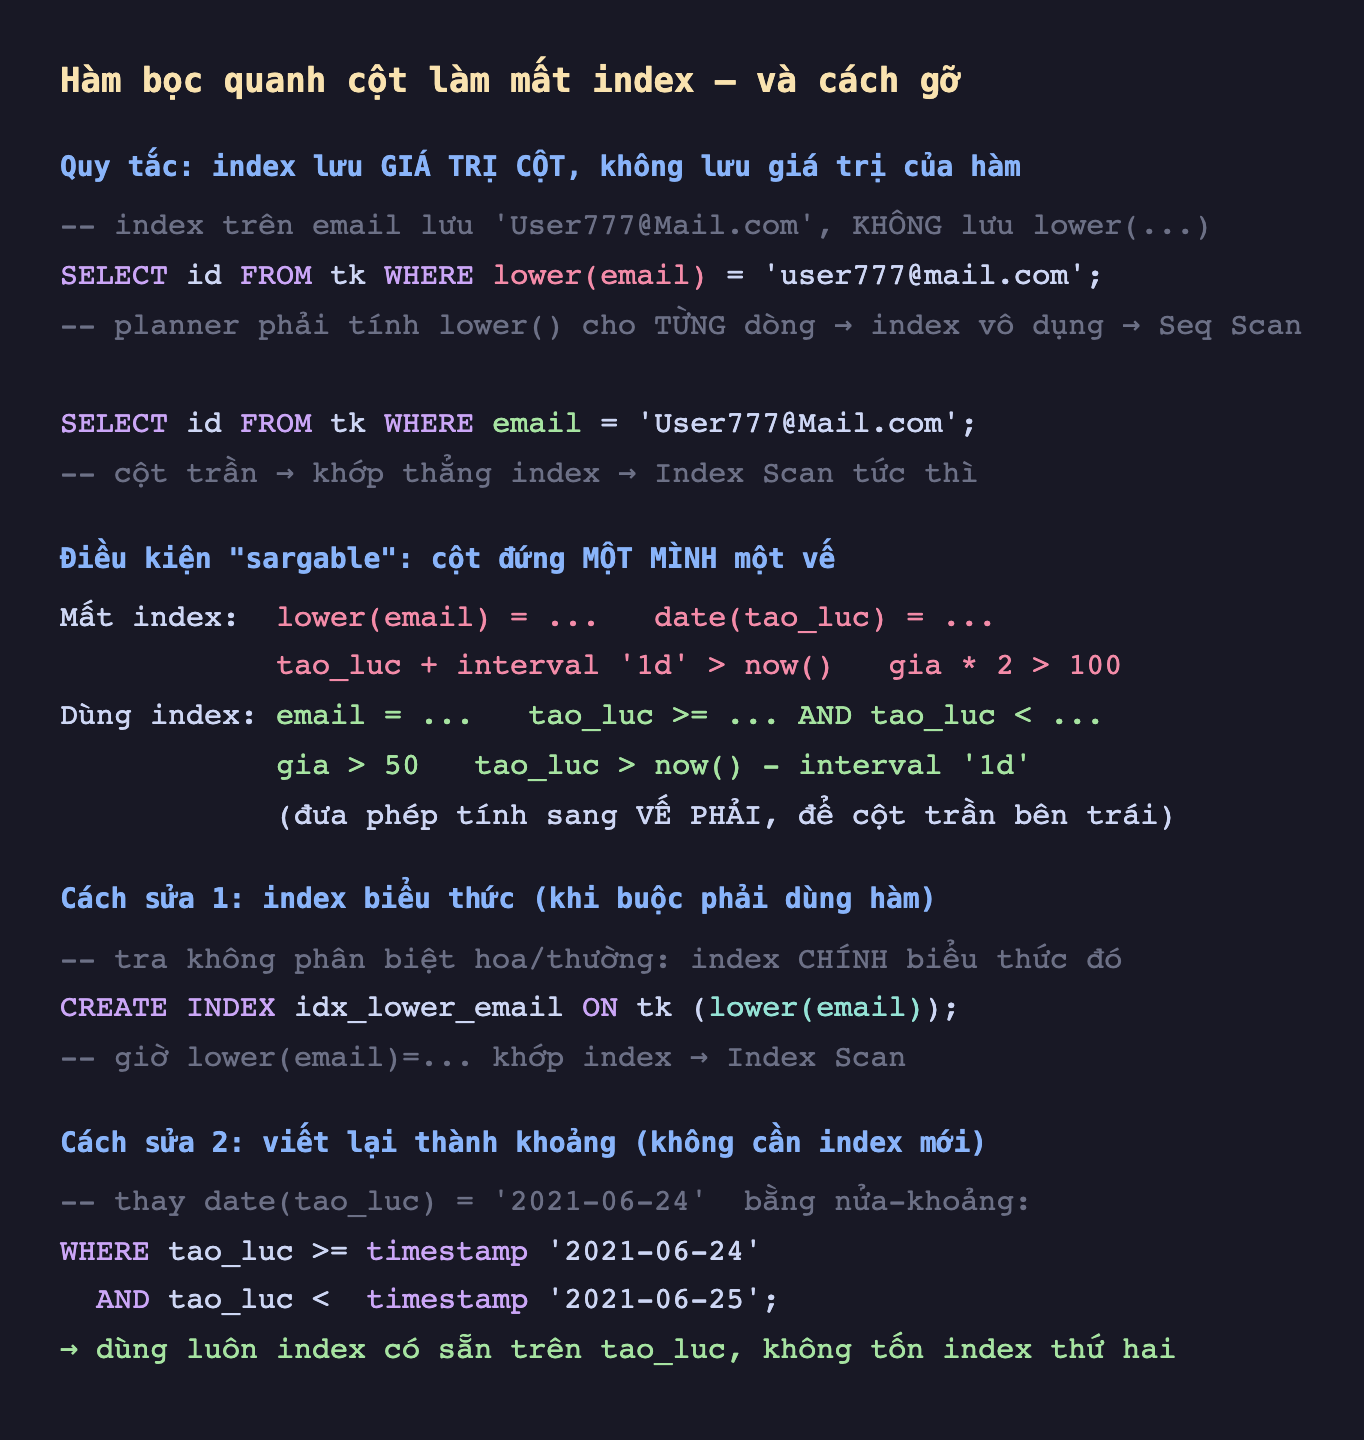
Hình 1: Index lưu giá trị cột nguyên gốc, không lưu giá trị hàm. Điều kiện "sargable" giữ cột đứng một mình một vế. Hai cách gỡ: index biểu thức, hoặc viết lại thành khoảng.
Đo thật: 160 ms so với 0,036 ms
Bảng tk 3 triệu dòng, có index trên email và tao_luc. Cùng ý định "tìm một tài khoản", hai cách viết:
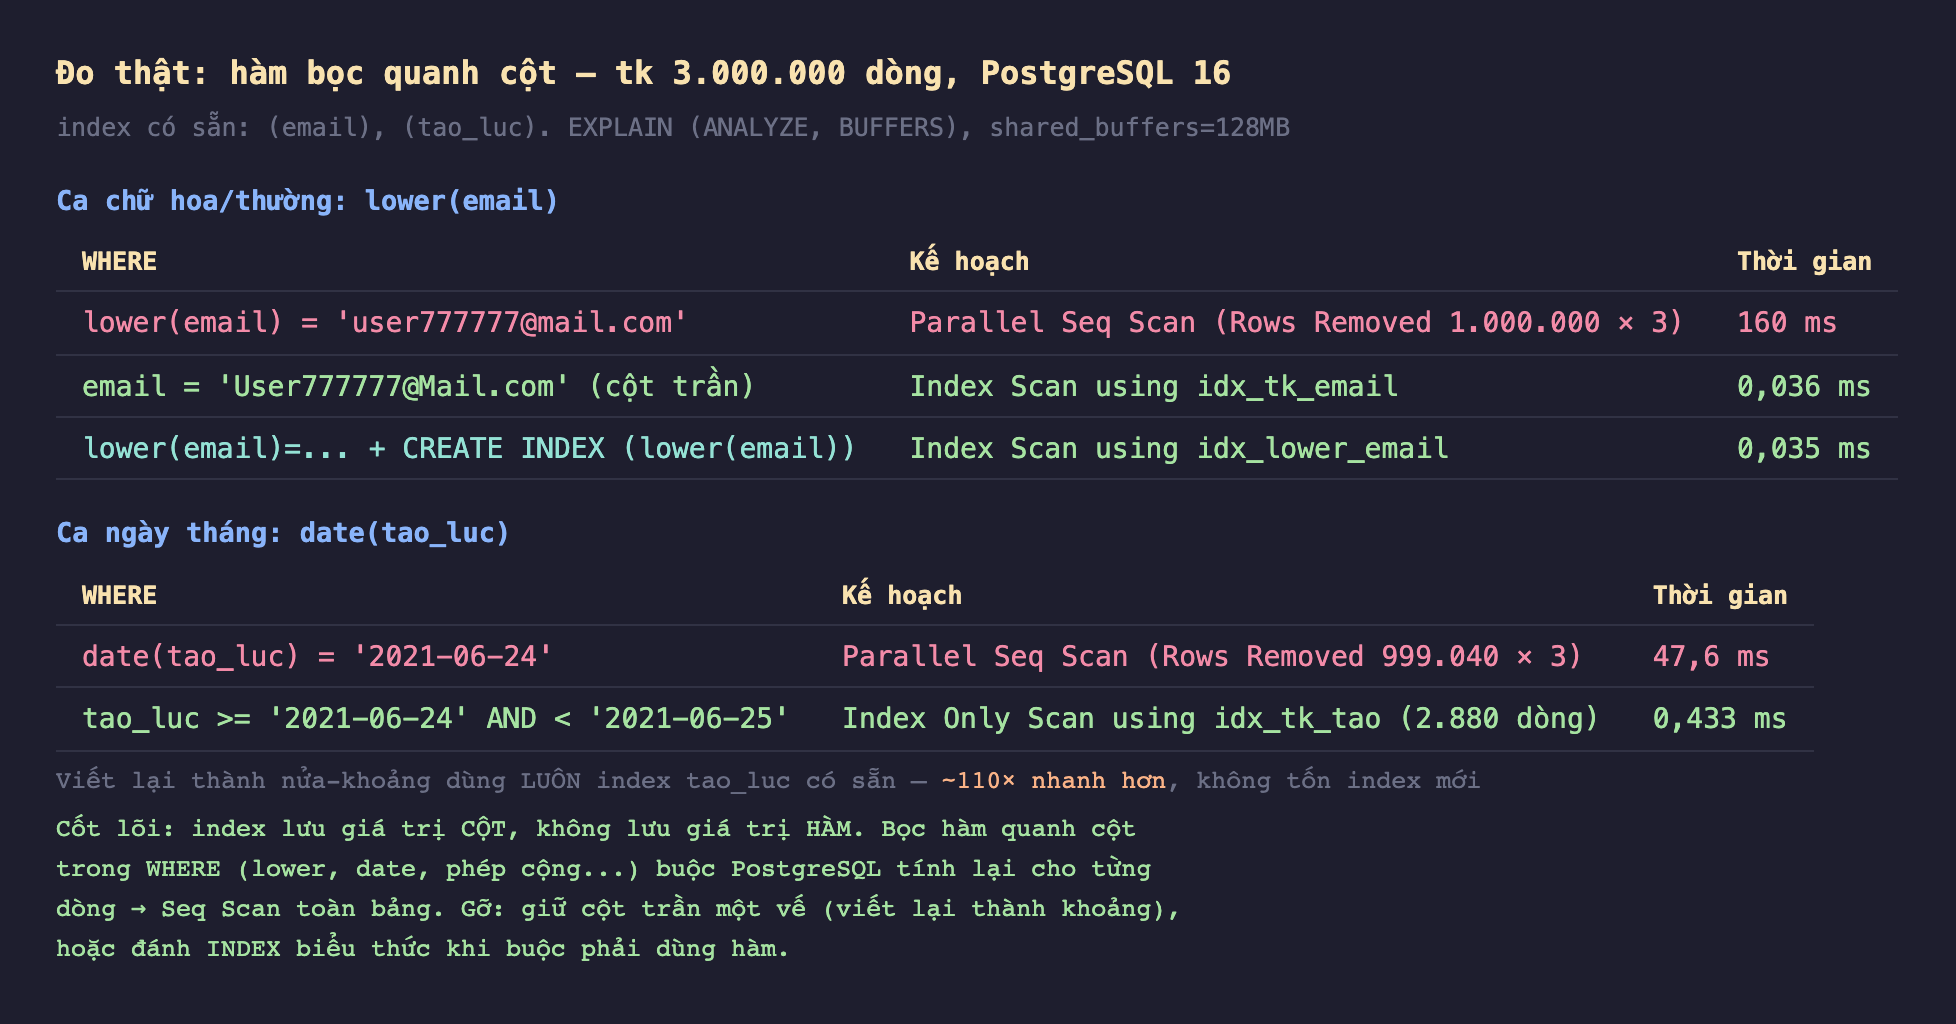
Hình 2: lower(email)=... chạy Parallel Seq Scan toàn bảng 160 ms; email=... cột trần dùng Index Scan 0,036 ms. Với ngày tháng, date(tao_luc)=... seq scan 47,6 ms so với viết lại thành khoảng Index Only Scan 0,433 ms — nhanh hơn ~110 lần, không cần index mới.
lower(email) = '...':Parallel Seq Scan,Rows Removed by Filter: 1.000.000mỗi worker — 160 ms. Index trênemailnằm im.email = '...'(cột trần, đúng chữ hoa):Index Scan using idx_tk_email— 0,036 ms. Nhanh hơn ~4.400 lần.
Điều đáng nói: chỉ khác nhau ở việc có lower() bọc quanh cột hay không. Bản thân cột và index không đổi.
Điều kiện "sargable": cột đứng một mình một vế
Từ chuyên môn cho "điều kiện dùng được index" là sargable (Search ARGument able). Quy tắc thực dụng: giữ cột trần ở một vế của phép so sánh, đưa mọi phép tính sang vế kia.
| Mất index (không sargable) | Dùng index (sargable) |
|---|---|
lower(email) = '...' |
email = '...' |
date(tao_luc) = '2021-06-24' |
tao_luc >= '2021-06-24' AND tao_luc < '2021-06-25' |
tao_luc + interval '1 day' > now() |
tao_luc > now() - interval '1 day' |
gia * 2 > 100 |
gia > 50 |
Mấu chốt: PostgreSQL không tự "đảo ngược" hàm để khôi phục dạng sargable — bạn phải tự viết lại. tao_luc + interval '1 day' > now() và tao_luc > now() - interval '1 day' cho cùng kết quả, nhưng chỉ dạng thứ hai dùng được index vì cột tao_luc đứng trần bên trái.
Cách sửa 1: index biểu thức
Khi bạn buộc phải dùng hàm — ví dụ tra email không phân biệt hoa thường là yêu cầu thật — đánh index thẳng lên chính biểu thức đó:
CREATE INDEX idx_lower_email ON tk (lower(email));
Giờ index lưu sẵn giá trị lower(email) đã sắp xếp, nên WHERE lower(email) = '...' khớp thẳng vào nó. Đo thật: sau khi tạo index này, cùng truy vấn chạy Index Scan using idx_lower_email — 0,035 ms, ngang với cột trần. Index biểu thức là công cụ chính cho tra không phân biệt hoa thường, tra theo date() cố định, hay bất kỳ hàm tất định nào.
Cách sửa 2: viết lại thành khoảng (không cần index mới)
Với hàm trên ngày tháng, thường có cách gỡ tốt hơn cả index biểu thức: viết lại thành nửa-khoảng. Thay vì date(tao_luc) = '2021-06-24', dùng:
WHERE tao_luc >= timestamp '2021-06-24' AND tao_luc < timestamp '2021-06-25';
Đo thật: date(tao_luc)=... seq scan 47,6 ms; bản viết lại chạy Index Only Scan using idx_tk_tao chỉ đọc 2.880 dòng đúng khoảng — 0,433 ms, nhanh hơn ~110 lần. Ưu điểm lớn: nó dùng index tao_luc đã có sẵn, không cần đánh thêm index thứ hai (tiết kiệm chi phí ghi và dung lượng). Với dữ liệu thời gian, đây thường là lựa chọn đầu tiên nên thử.
Đánh đổi cần cân nhắc
Index biểu thức có chi phí ghi và phải khớp chính xác. Nó phải được cập nhật mỗi lần INSERT/UPDATE như mọi index. Quan trọng hơn, truy vấn phải dùng đúng biểu thức đã index: index trên lower(email) không giúp upper(email) hay lower(trim(email)). Biểu thức trong truy vấn và trong index phải trùng khớp.
Viết lại thành khoảng chỉ áp dụng cho hàm "bảo toàn thứ tự". date(), cắt theo giờ, phép cộng/trừ hằng số — những hàm giữ nguyên thứ tự — viết lại được thành khoảng. lower() hay md5() thì không (chúng xáo trộn thứ tự), nên với chúng chỉ còn cách index biểu thức. Chọn công cụ theo bản chất hàm.
Cẩn thận ép kiểu ngầm — nó cũng là một dạng "hàm ẩn". Một điều kiện như cot_varchar = 123 (so cột text với số) khiến PostgreSQL chèn ép kiểu ngầm, và tùy phía nào bị ép mà index có thể mất tác dụng y như bọc hàm. Đó là chủ đề của bài sau.
Ba ý mang về
- Index lưu giá trị cột, không lưu giá trị hàm — bọc
lower(),date(), hay phép cộng quanh cột trongWHEREbuộc PostgreSQL tính lại cho từng dòng và rơi về Seq Scan: đo thậtlower(email)=...chạy 160 ms so với 0,036 ms của cột trần. - Giữ điều kiện sargable: cột đứng trần một vế, phép tính dồn sang vế kia —
tao_luc > now() - interval '1 day'dùng index, còntao_luc + interval '1 day' > now()thì không, dù cho cùng kết quả. - Hai cách gỡ: index biểu thức khi buộc phải dùng hàm (
CREATE INDEX ON tk(lower(email))đưa về 0,035 ms), hoặc viết lại thành khoảng cho hàm ngày tháng (date()=...47,6 ms thành khoảngIndex Only Scan0,433 ms, ~110 lần nhanh hơn, không cần index mới).
Phần sau ta xét một dạng "hàm ẩn" tinh vi hơn, không thấy bằng mắt: Phần sau đo vì sao so sánh cột với sai kiểu dữ liệu khiến PostgreSQL chèn ép kiểu ngầm và âm thầm vô hiệu hóa index.
