Nếu bạn đến từ thế giới ORM khác (Django, Hibernate, ActiveRecord), câu này khiến bạn rùng mình:
for r in recs:
    tong += r.diem
Lặp qua N bản ghi, mỗi vòng đọc một field — đây là công thức kinh điển của bug N+1 query: một query để lấy danh sách, cộng N query để lấy field từng cái. Nhưng trong Odoo, đoạn này không gây N+1. Đo thật trên 20 bản ghi, nó chỉ tốn đúng 1 câu SELECT. Bí mật tên là prefetch.
Đo thật: 20 bản ghi, 1 query
Để không nói suông, mình bọc cr.execute lại để đếm số câu SELECT thật sự chạm bảng, tạo 20 bản ghi test, xoá cache rồi lặp đọc field diem từng cái:
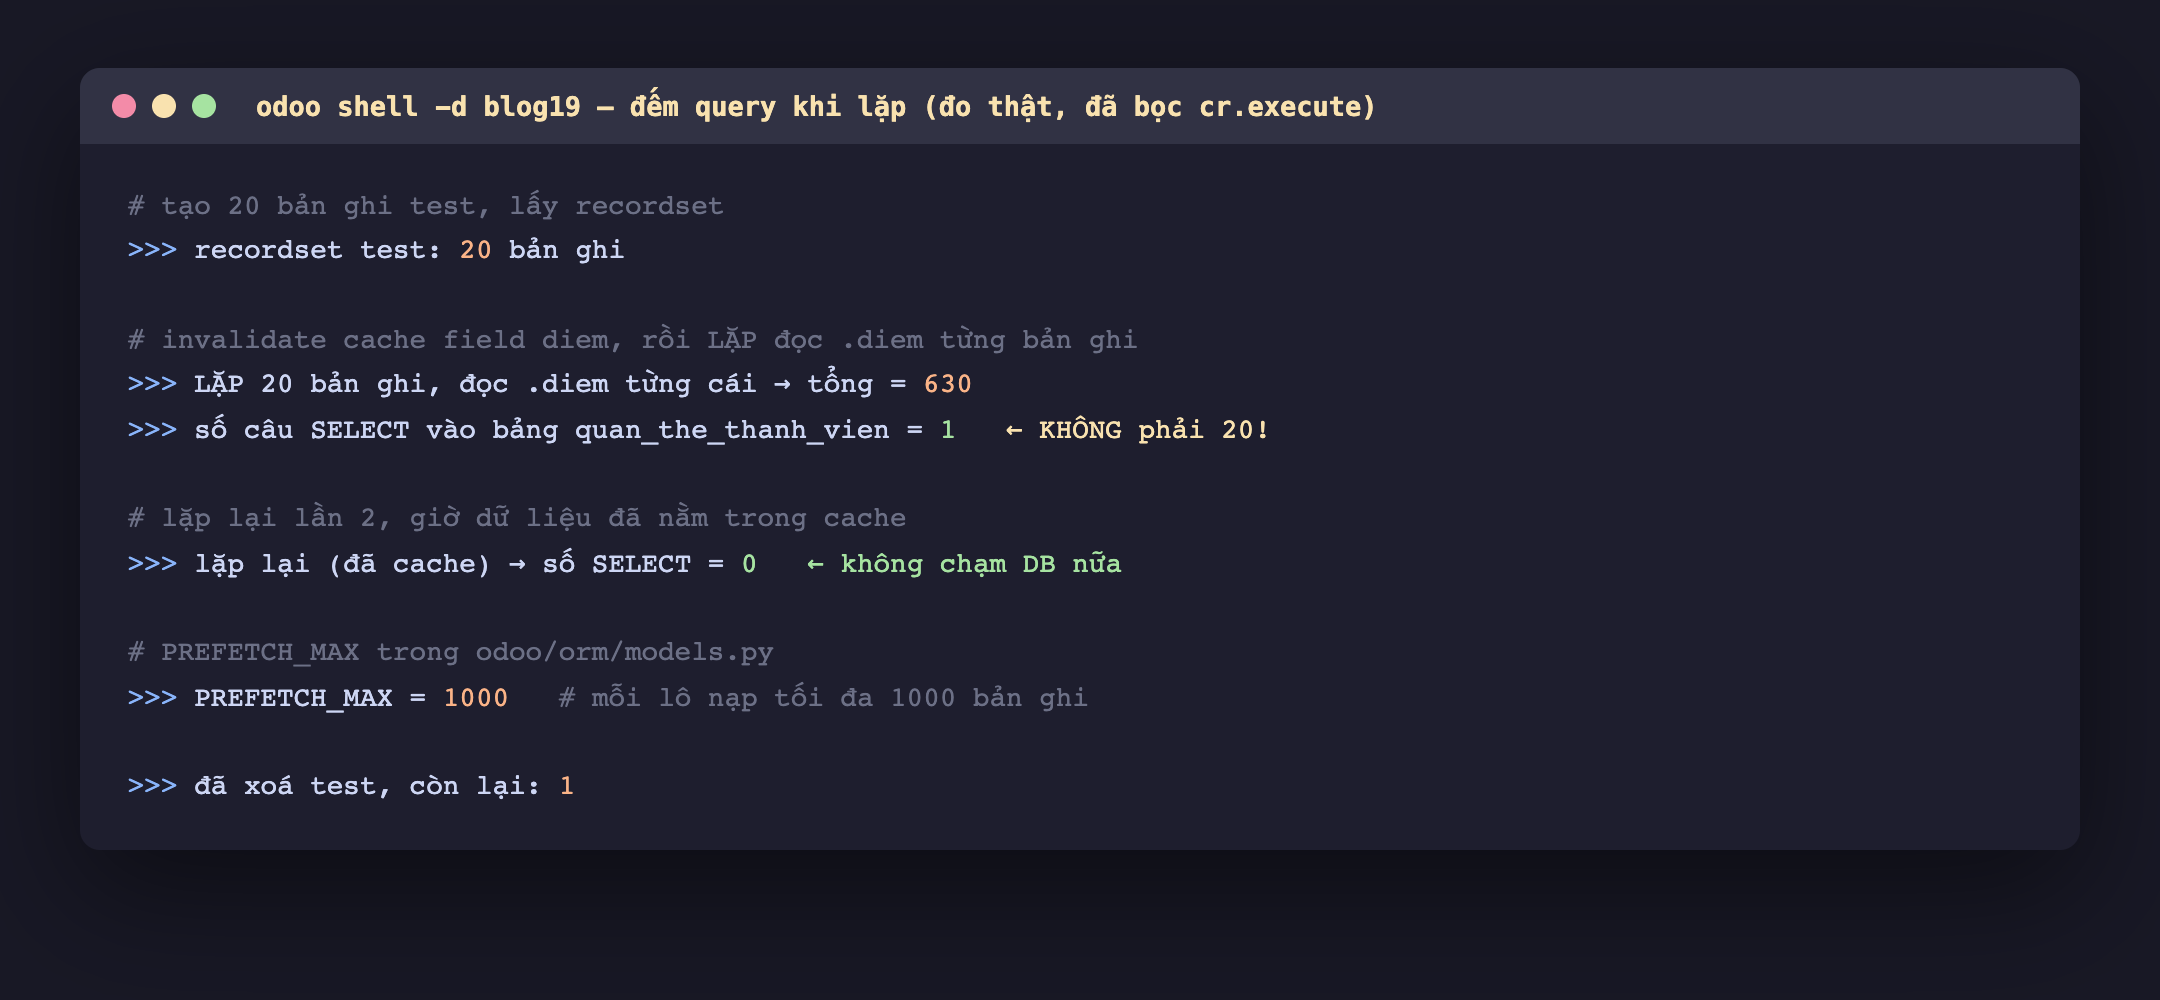
Hình 1: Đo trực tiếp. Lặp 20 bản ghi đọc .diem (tổng ra 630) — chỉ 1 câu SELECT, không phải 20. Lặp lần hai khi dữ liệu đã trong cache: 0 query. Sau đó dọn sạch bản ghi test.
Con số 1 (chứ không phải 20) chính là prefetch đang làm việc. Và con số 0 ở lần lặp thứ hai là cache (bài 48) tiếp sức: một khi đã nạp, đọc lại không tốn gì.
Prefetch hoạt động thế nào
Mấu chốt: recordset không phải là danh sách các bản ghi rời rạc — nó là một tập có ngữ cảnh chung. Khi bạn chạm .diem trên bản ghi đầu tiên trong vòng lặp, ORM không chỉ nạp diem của mình bản ghi đó. Nó nhìn cả recordset đang lặp và nạp diem cho toàn bộ các bản ghi trong đó, bằng một câu SELECT ... WHERE id IN (...) duy nhất, rồi bỏ hết vào cache.
19 vòng lặp còn lại đọc .diem từ cache — không query nào nữa. Đó là vì sao một vòng for trông "ngây thơ" lại nhanh.
Việc nạp theo lô có giới hạn: hằng PREFETCH_MAX trong odoo/orm/models.py bằng 1000. Recordset lớn hơn 1000 được nạp thành nhiều lô, mỗi lô một query — vẫn tốt hơn rất nhiều so với một query mỗi bản ghi.
Cái gì PHÁ prefetch (và đưa N+1 trở lại)
Prefetch dựa vào việc các bản ghi cùng nằm trong một recordset. Bạn phá nó khi tách một bản ghi ra khỏi ngữ cảnh đó:
for r in recs:
    r2 = M.browse(r.id)   # tạo recordset MỚI chỉ 1 phần tử → mất ngữ cảnh prefetch
    tong += r2.diem       # mỗi vòng một SELECT riêng — N+1 quay lại
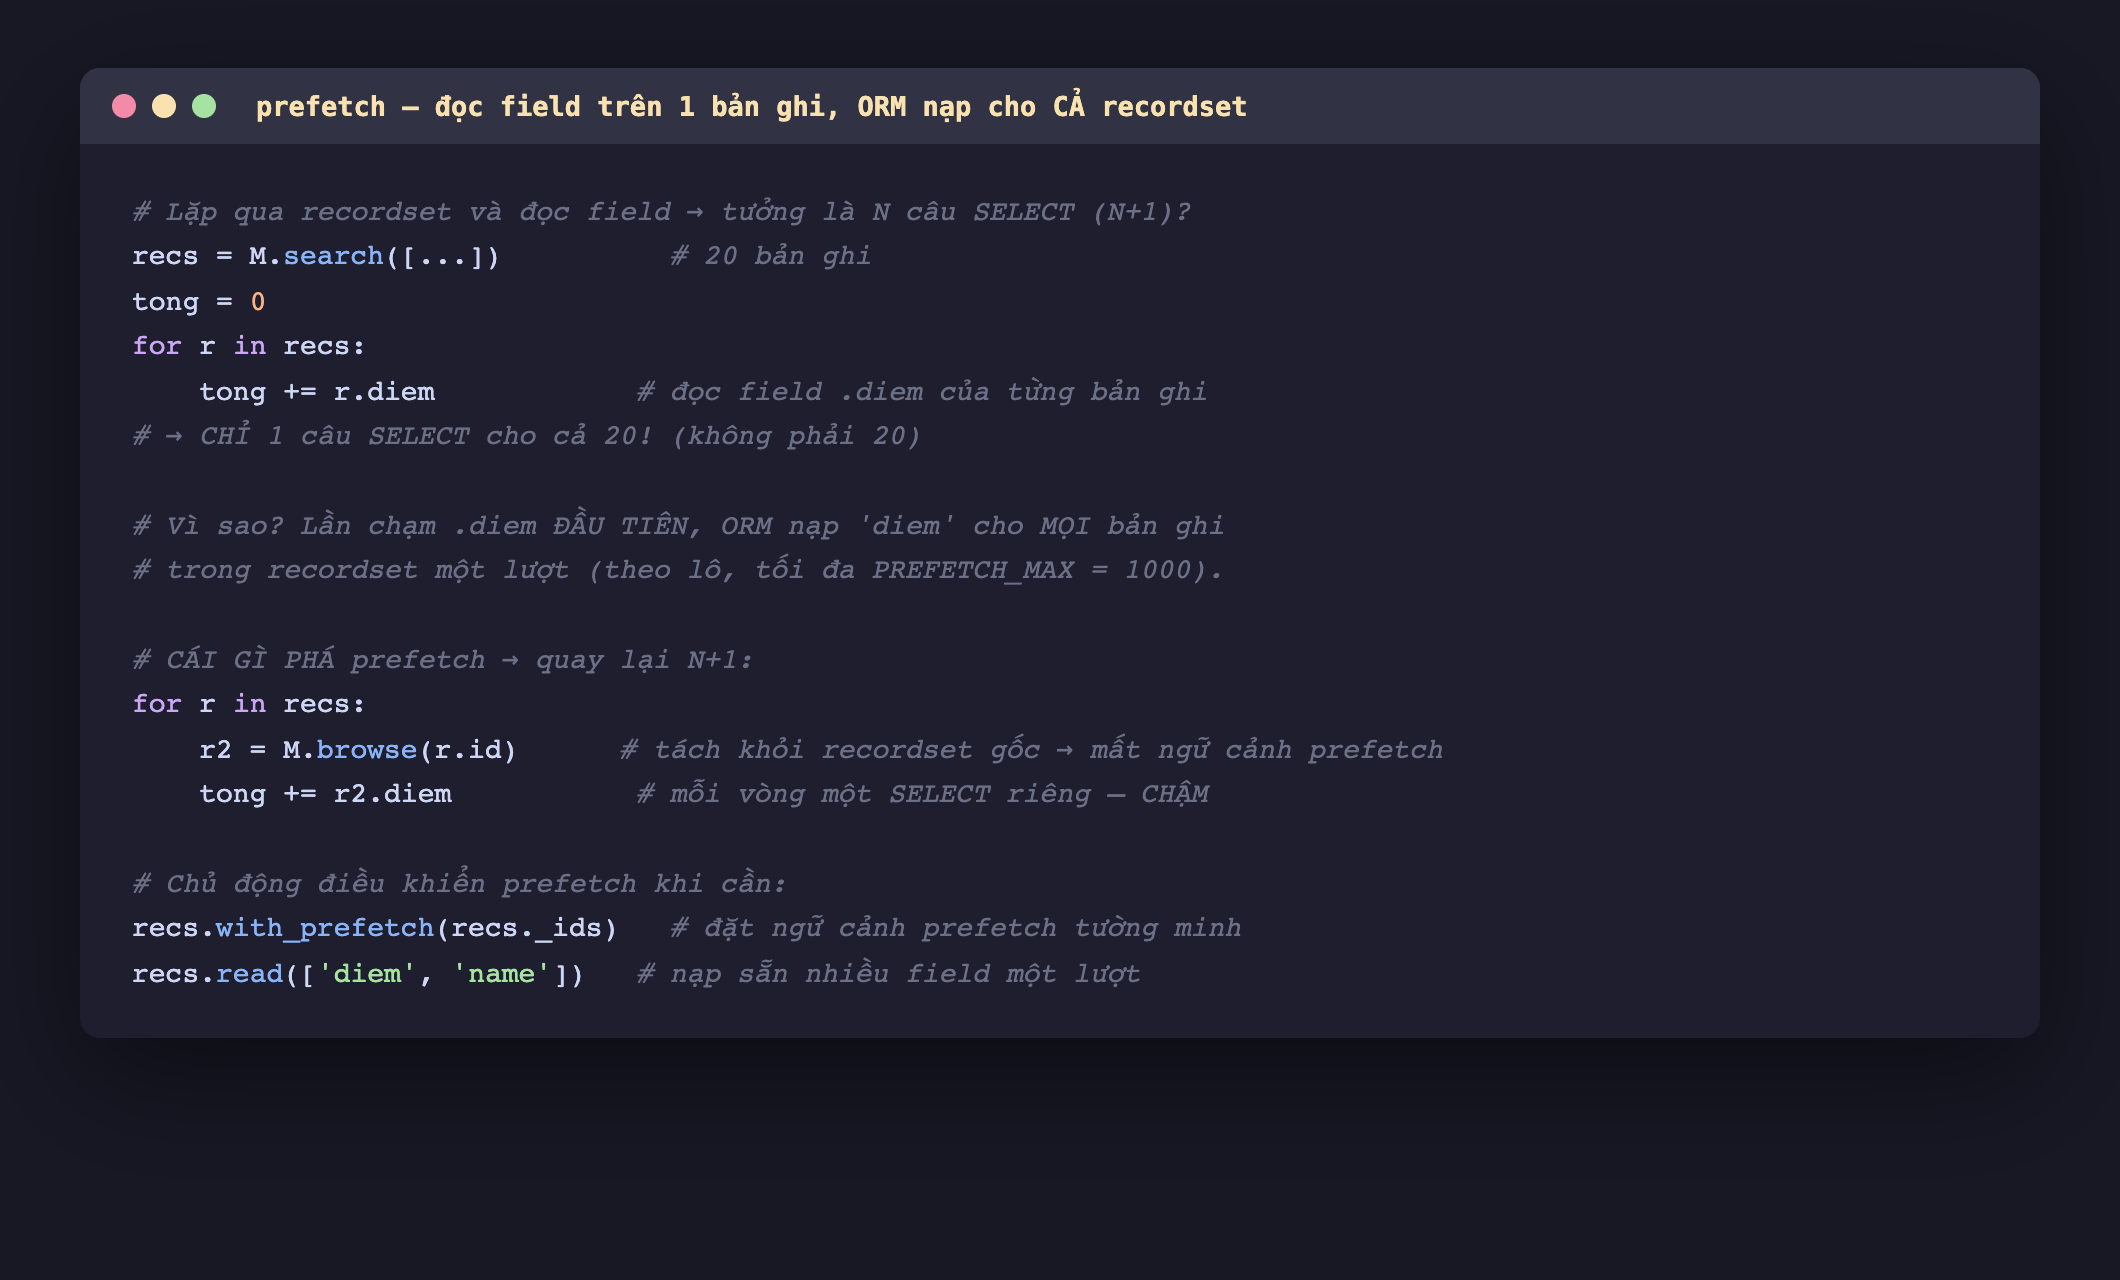
Hình 2: Prefetch và cách phá nó. Gọi browse(r.id) bên trong vòng lặp tạo một recordset một-phần-tử tách biệt, mất ngữ cảnh của recs, nên mỗi vòng lại bắn một query. Các thao tác đọc quan hệ (r.partner_id.name từng cái mà không gom) cũng dễ rơi vào N+1 tương tự.
Vài cách giữ và chủ động điều khiển prefetch:
- Đừng
browselại từng id trong vòng lặp. Cứ lặp thẳng trên recordset gốc. - Nạp trước nhiều field một lượt bằng
recs.read(['diem', 'name', ...])hoặcrecs.mapped('field')khi biết mình sẽ dùng. - Đọc quan hệ theo lô:
recs.mapped('partner_id')nạp tất cả partner một lần, thay vìr.partner_idtừng vòng. with_prefetch(ids)đặt ngữ cảnh prefetch tường minh khi bạn có lý do đặc biệt.
Khi nào bạn cần để ý
Với recordset bạn lấy tự nhiên từ search rồi lặp, prefetch tự lo — không cần làm gì. Bạn chỉ cần cảnh giác khi:
- Xây recordset thủ công bằng cách gộp nhiều
browsemột-phần-tử. - Đọc quan hệ sâu trong vòng lặp (
r.partner_id.parent_id.name) — cân nhắcmappedđể gom. - Xử lý lô cực lớn (>1000) và muốn hiểu vì sao có vài query thay vì một.
Nguyên tắc: giữ các bản ghi trong cùng một recordset càng lâu càng tốt, và đọc field theo nhóm.
Ba ý mang về
- Prefetch khiến vòng lặp đọc field không gây N+1: chạm field trên bản ghi đầu tiên, ORM nạp field đó cho cả recordset bằng một query (đo thật: 20 bản ghi → 1
SELECT, lặp lại → 0). - Nạp theo lô tối đa
PREFETCH_MAX = 1000(trongodoo/orm/models.py); recordset lớn hơn chia thành nhiều lô. - Phá prefetch = tách bản ghi khỏi recordset (điển hình
browse(id)trong vòng lặp). Giữ prefetch bằng cách lặp thẳng trên recordset gốc và đọc field/quan hệ theo nhóm (read,mapped).
Ta đã thấy ORM khéo léo thế nào. Lần sau đi tới lúc phải bước ra khỏi ORM: Phần sau nói về gọi SQL thô an toàn với cr.execute — khi nào nên, và làm sao tránh SQL injection cùng những cái bẫy cache/flush ta vừa học.
