Có một sự thật khó chịu mà nhiều team chỉ phát hiện khi nhận hoá đơn: observability có thể tốn hơn cả hệ thống nó giám sát. Một service nhỏ gọn đẩy ra hàng triệu điểm dữ liệu mỗi ngày; nhân với số instance, số metric, số nhãn, và giữ trong nhiều tháng — chi phí lưu trữ và xử lý metric phình ra ngoài tầm kiểm soát. Tệ hơn, nó phình âm thầm: mỗi lần ai đó thêm một nhãn "cho tiện", chi phí nhích lên mà không ai thấy, cho tới khi Prometheus OOM hoặc hoá đơn cloud gấp ba. Bài này (phần 11 loạt Observability) đo thật chi phí metric, phân tích nó thành các đòn bẩy, và ngoại suy ra quy mô production để thấy con số thật đáng sợ thế nào.
Công thức chi phí: bốn thừa số, bốn đòn bẩy
Dung lượng metric không phải một con số bí ẩn — nó là một phép nhân đơn giản:
Dung lượng ≈ số_chuỗi × (1 / scrape_interval) × bytes/sample × retention
Mỗi thừa số là một đòn bẩy bạn có thể kéo:
- số_chuỗi (cardinality) — bao nhiêu chuỗi thời gian phân biệt. Đòn bẩy mạnh nhất, vì nó nhân tuyến tính cả disk lẫn RAM (Prometheus giữ metadata mọi chuỗi trong bộ nhớ).
- scrape_interval — lấy mẫu dày hay thưa. Scrape 5s tạo gấp 12 lần số sample so với 60s.
- bytes/sample — Prometheus nén rất tốt (~1-2 byte/sample nhờ delta + XOR encoding), nên đây là thừa số bạn ít kiểm soát nhất.
- retention — giữ dữ liệu bao lâu. Giữ 90 ngày thay vì 15 là gấp 6 lần disk.
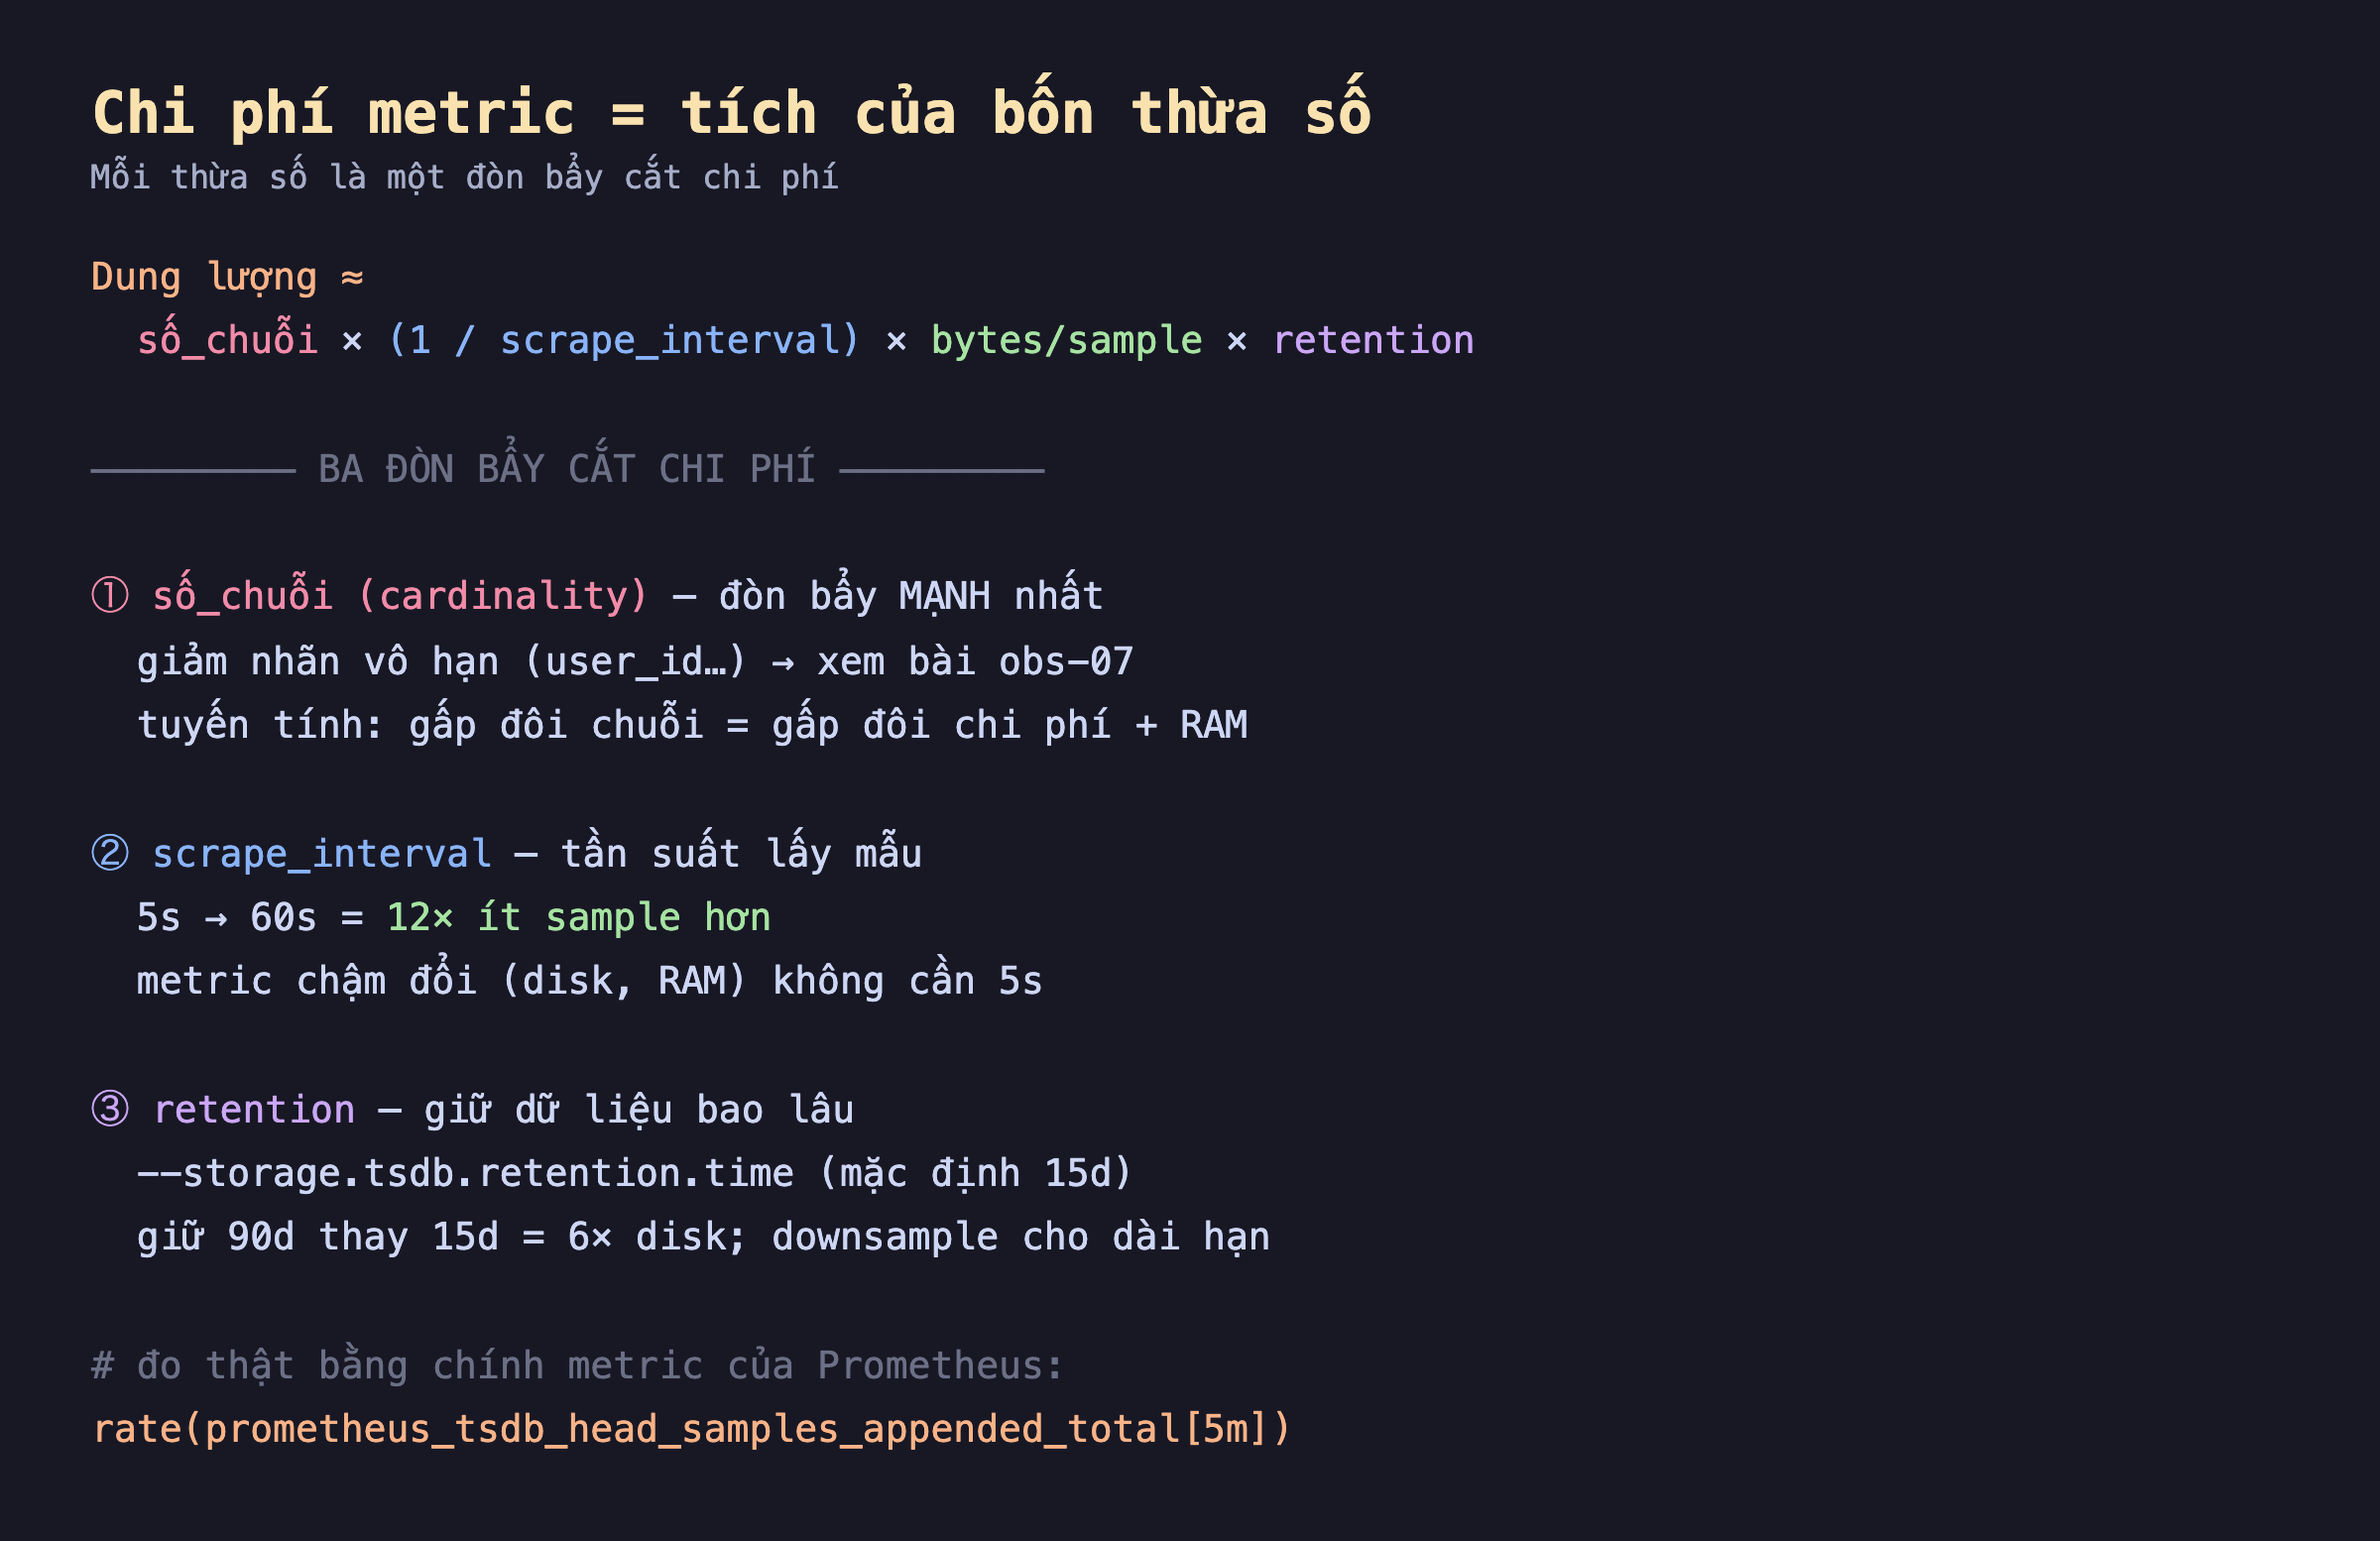
Hình 1: Chi phí metric là tích của bốn thừa số, mỗi cái một đòn bẩy. Cardinality nhân cả disk lẫn RAM (mạnh nhất); scrape_interval và retention là hai núm vặn an toàn; bytes/sample thì Prometheus đã nén tối ưu. Đo thật bằng chính metric nội bộ của Prometheus.
Đo thật: Prometheus tự khai chi phí của nó
Điều hay: Prometheus phơi bày chính chi phí của mình qua metric nội bộ. Mình query rate(prometheus_tsdb_head_samples_appended_total[5m]) và vài metric khác:
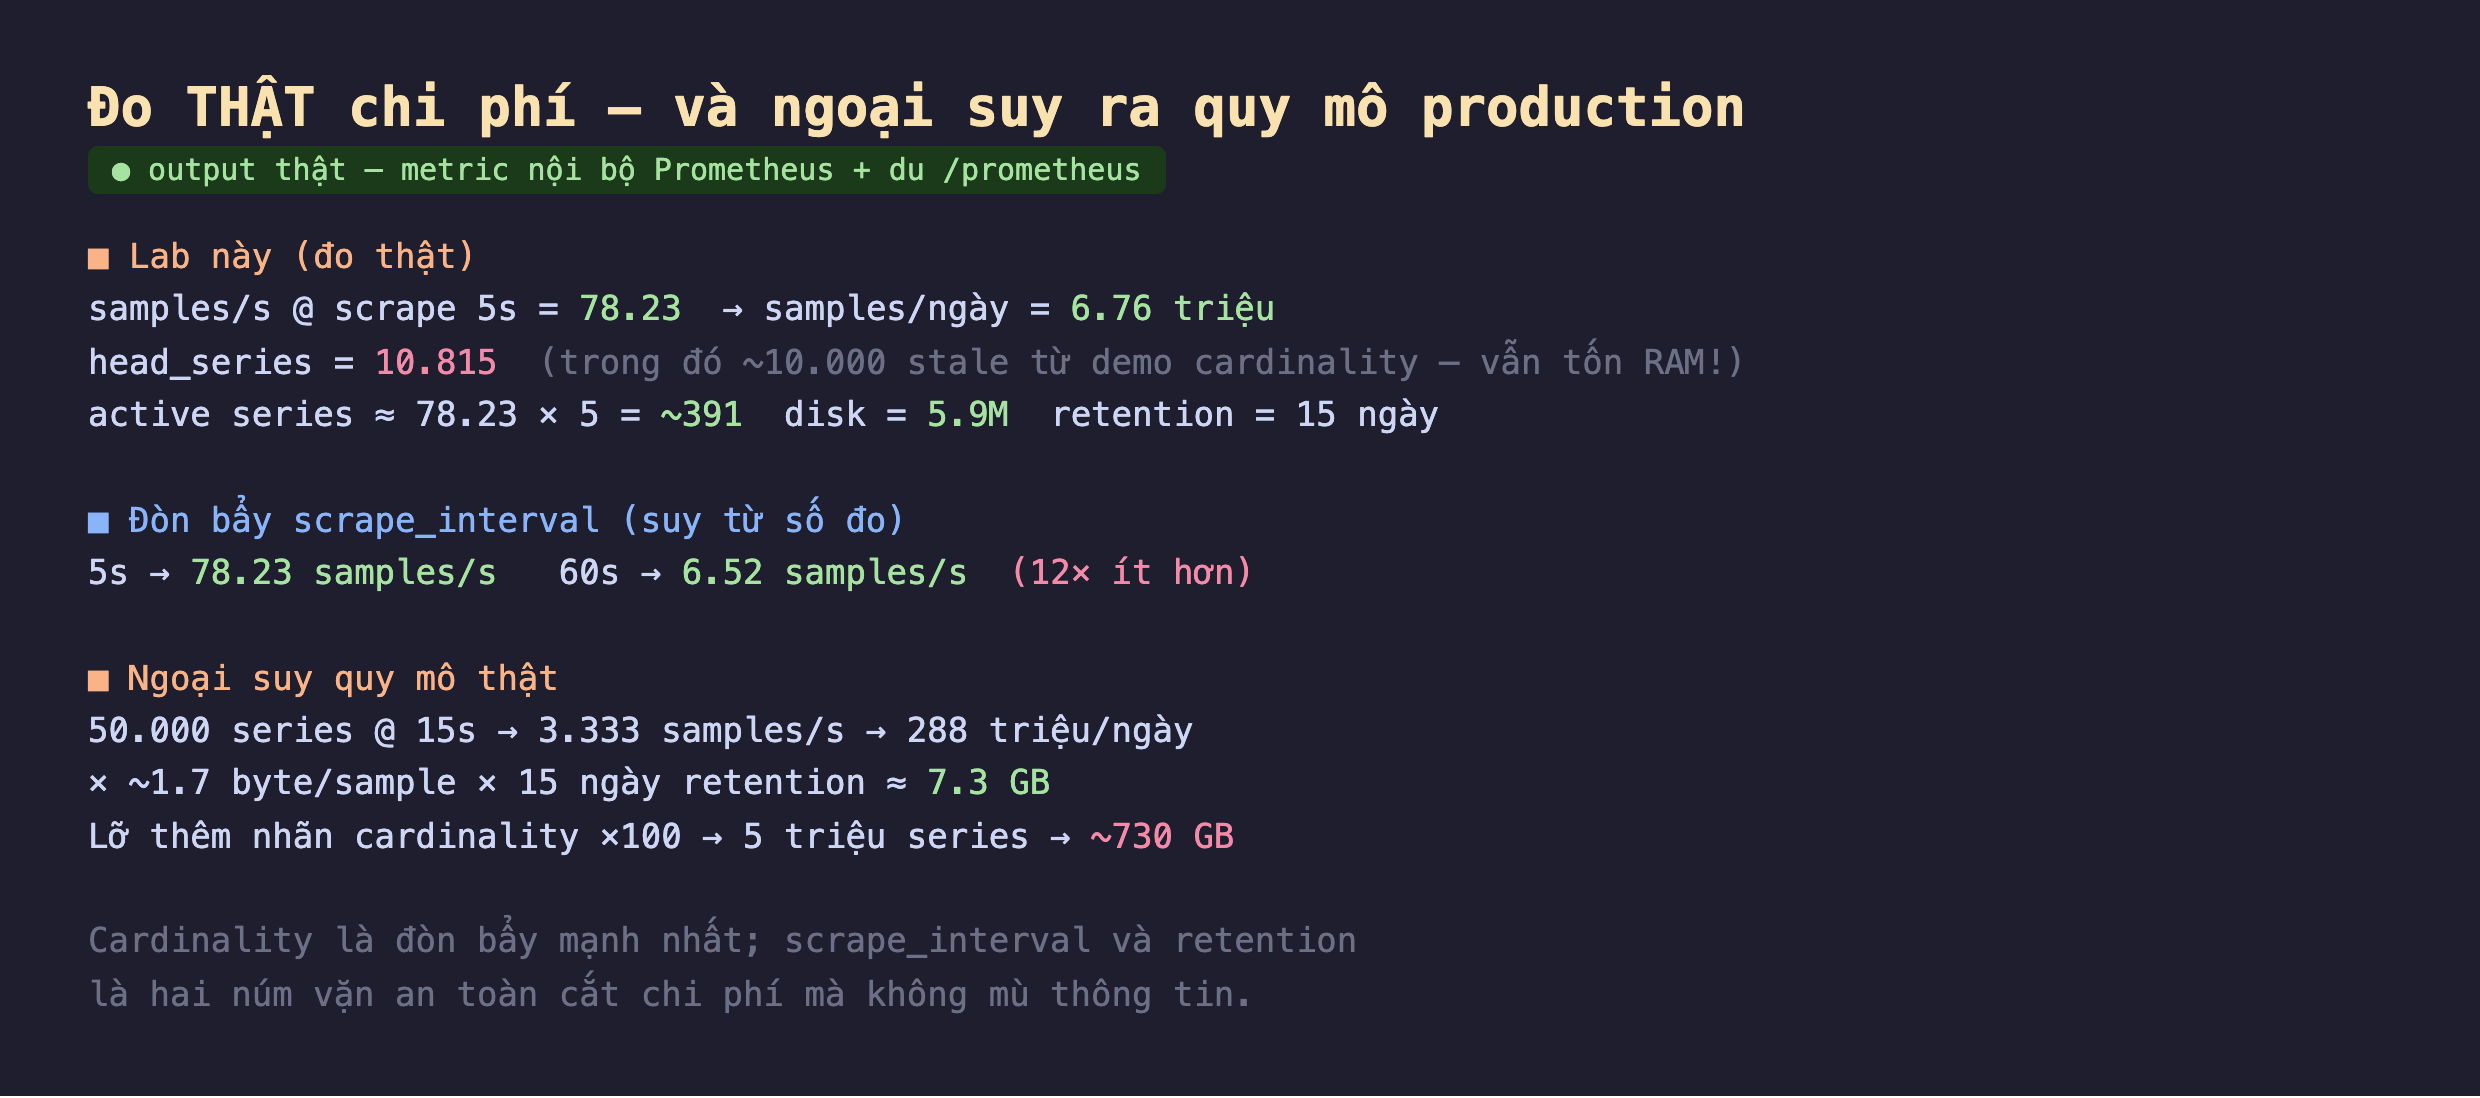
Hình 2: Đo thật. Lab nhỏ: 78.23 samples/s ở scrape 5s (= 6.76 triệu samples/ngày), head_series 10.815 — trong đó ~10.000 là chuỗi stale từ bài cardinality vẫn chiếm RAM. Đòn bẩy scrape_interval: 5s = 78.23/s, 60s = 6.52/s (12× ít). Ngoại suy quy mô thật: 50.000 series ở 15s ≈ 7.3 GB cho 15 ngày; lỡ thêm nhãn cardinality ×100 → ~730 GB.
Đọc kết quả:
- Lab nhỏ: chỉ ~391 chuỗi đang được scrape mà đã sinh 78.23 samples/s (ở scrape 5s) = 6.76 triệu samples/ngày. Con số này nhỏ vì lab nhỏ, nhưng tỉ lệ thì thật và ngoại suy được.
- Cardinality ám ảnh cả khi stale:
head_series= 10.815 dù chỉ 391 đang được scrape. ~10.000 chuỗi còn lại là stale — từ bài cardinality (obs-07), target đã tắt nhưng chuỗi vẫn nằm trong head block, vẫn chiếm RAM cho tới khi bị nén ra khỏi head. Đây là bằng chứng sống: cardinality không chỉ đắt lúc tạo, nó còn dai dẳng đắt. - Đòn bẩy scrape_interval: ở 5s đo được 78.23 samples/s; đổi sang 60s thì mỗi chuỗi lấy mẫu thưa 12 lần → 6.52 samples/s. Cùng lượng thông tin về xu hướng, 1/12 chi phí.
Ngoại suy ra quy mô thật: nơi con số trở nên đáng sợ
Lab này 6.76 triệu samples/ngày nghe nhỏ. Hãy ngoại suy ra một hệ thống thật khiêm tốn: 100 instance, mỗi instance 500 chuỗi = 50.000 chuỗi, scrape 15s:
- samples/s = 50.000 / 15 = 3.333/s
- samples/ngày = 3.333 × 86.400 = 288 triệu/ngày
- × ~1.7 byte/sample (sau nén) × 15 ngày retention ≈ 7.3 GB
Con số 7.3 GB còn quản lý được. Nhưng giờ hình dung một kỹ sư thêm một nhãn cardinality cao (như user_id trong bài obs-07) nhân số chuỗi lên 100 lần → 5 triệu chuỗi → ~730 GB cho cùng retention. Một dòng code biến chi phí từ hàng GB thành hàng trăm GB, và kéo RAM Prometheus theo. Đây là lý do cardinality là đòn bẩy quan trọng nhất — và là cái bẫy chi phí nguy hiểm nhất.
Đánh đổi cần cân nhắc
Scrape thưa làm mất độ phân giải sự kiện ngắn. Giảm scrape 5s→60s cắt 12× chi phí, nhưng một spike độ trễ 10 giây có thể lọt hoàn toàn giữa hai lần scrape 60s. Quy tắc: metric thay đổi chậm (disk usage, số kết nối, RAM) scrape thưa được; metric cần bắt spike (độ trễ, lỗi) cần dày hơn. Đừng áp một scrape_interval cho mọi thứ — phân tầng theo tốc độ thay đổi.
Retention ngắn mất khả năng điều tra lịch sử. Giữ 15 ngày rẻ, nhưng khi cần so sánh "tháng này với tháng trước" hay điều tra một sự cố 3 tuần trước thì dữ liệu đã mất. Giải pháp thật: downsampling — giữ dữ liệu độ phân giải cao ngắn hạn (15 ngày, scrape gốc) và dữ liệu đã gộp (5 phút/điểm) dài hạn (1 năm). Thanos/Cortex/Mimir làm việc này; Prometheus đơn lẻ thì không. Đừng chọn giữa "chi tiết" và "lịch sử" — downsample để có cả hai.
Cắt chi phí quá tay thành mù thông tin. Đòn bẩy rẻ nhất là xoá metric — nhưng xoá nhầm cái bạn cần lúc sự cố thì tiết kiệm vài đô để mất hàng giờ downtime. Ưu tiên cắt theo thứ tự: trước hết diệt cardinality vô dụng (nhãn không ai query), rồi giãn scrape metric chậm, rồi downsample dài hạn — chứ không xoá bừa metric cốt lõi. Mục tiêu là rẻ mà vẫn thấy, không phải rẻ bằng mọi giá.
Ba ý mang về
- Chi phí là tích của bốn thừa số: đo thật 78.23 samples/s ở scrape 5s (6.76 triệu/ngày) từ chỉ ~391 chuỗi active — dung lượng = số_chuỗi × (1/scrape_interval) × bytes/sample × retention, mỗi thừa số một đòn bẩy.
- Cardinality là đòn bẩy mạnh và nguy hiểm nhất: đo thật head giữ 10.815 chuỗi dù chỉ 391 đang scrape (10.000 stale vẫn tốn RAM); ngoại suy một nhãn sai ×100 biến 7.3 GB thành ~730 GB — cardinality đắt dai dẳng và nhân cả disk lẫn RAM.
- Scrape_interval và retention là hai núm vặn an toàn: đo thật 5s→60s cắt 12× sample; downsample để có cả chi tiết lẫn lịch sử; cắt theo thứ tự (cardinality vô dụng → giãn scrape → downsample) để rẻ mà vẫn thấy, không mù.
Nguồn
- Prometheus docs — Storage & TSDB sizing: https://prometheus.io/docs/prometheus/latest/storage/
- Robust Perception — How much RAM does Prometheus need?: https://www.robustperception.io/how-much-ram-does-prometheus-2-x-need-for-cardinality-and-ingestion/
- Grafana — Reduce Prometheus/Mimir cardinality & cost: https://grafana.com/docs/mimir/latest/manage/use-exemplars/
Phần sau là bài tổng kết loạt Observability: ghép ba trụ cột metric–trace–log thành một bức tranh thống nhất, đúc kết những bài học đo thật xuyên suốt 12 phần, và một checklist thực chiến để gắn observability vào service của bạn.
