Mười một phần qua, ta đã đi từ "ba trụ cột là gì" tới chi phí của việc vận hành chúng — mỗi bài một demo chạy thật, mỗi kết luận một con số đo được. Nhưng observability không phải ba công cụ rời rạc để dùng riêng lẻ; sức mạnh thật của nó đến khi ba trụ cột nối với nhau thành một hệ thống điều tra liền mạch. Bài cuối này (phần 12, khép lại loạt Observability) làm đúng điều đó: chạy một demo tổng hợp cho một request duy nhất phát cả metric, trace và log cùng một trace_id, chứng minh bằng số thật rằng chúng thực sự dính vào nhau — rồi đúc kết toàn bộ bài học và đưa một checklist thực chiến.
Ba trụ cột trả lời ba câu hỏi khác nhau
Trước khi ghép, nhắc lại vì sao cần cả ba — không cái nào thay được cái nào:
- Metric trả lời "hệ thống có khoẻ không?" — rẻ, tổng hợp, luôn bật, hợp để cảnh báo. Nhưng nó là số gộp, không chỉ ra request cụ thể nào hỏng.
- Trace trả lời "request này chậm ở đâu?" — chi tiết một request xuyên nhiều service, chỉ đúng span thủ phạm. Nhưng đắt, phải lấy mẫu.
- Log trả lời "chuyện gì đã xảy ra?" — ngữ cảnh chi tiết từng sự kiện. Nhưng rời rạc nếu không có định danh chung.
Mắt xích nối ba cái lại là trace_id đóng vai correlation id: khi metric báo động, bạn mở dashboard thấy service nào lỗi (RED), lấy một dòng log lỗi của nó, copy trace_id, dán vào Jaeger — và thấy chính xác request đó đã đi qua đâu, kẹt ở span nào. Ba tín hiệu rời rạc biến thành một đường điều tra.
Đo thật: một request, ba tín hiệu, một trace_id
Mình dựng một service hợp nhất: handler /order khi nhận một request sẽ đồng thời tăng metric Prometheus, tạo span OpenTelemetry (gửi Jaeger), và ghi log JSON — tất cả mang cùng trace_id:
c, span := tr.Start(r.Context(), "POST /order")
tid := span.SpanContext().TraceID().String()
_, s2 := tr.Start(c, "queryDB"); /* ... */ s2.End()   // TRACE
reqs.WithLabelValues(status).Inc(); dur.Observe(d)      // METRIC
jlog.Info("xử lý đơn hàng", "trace_id", tid, "status", status) // LOG
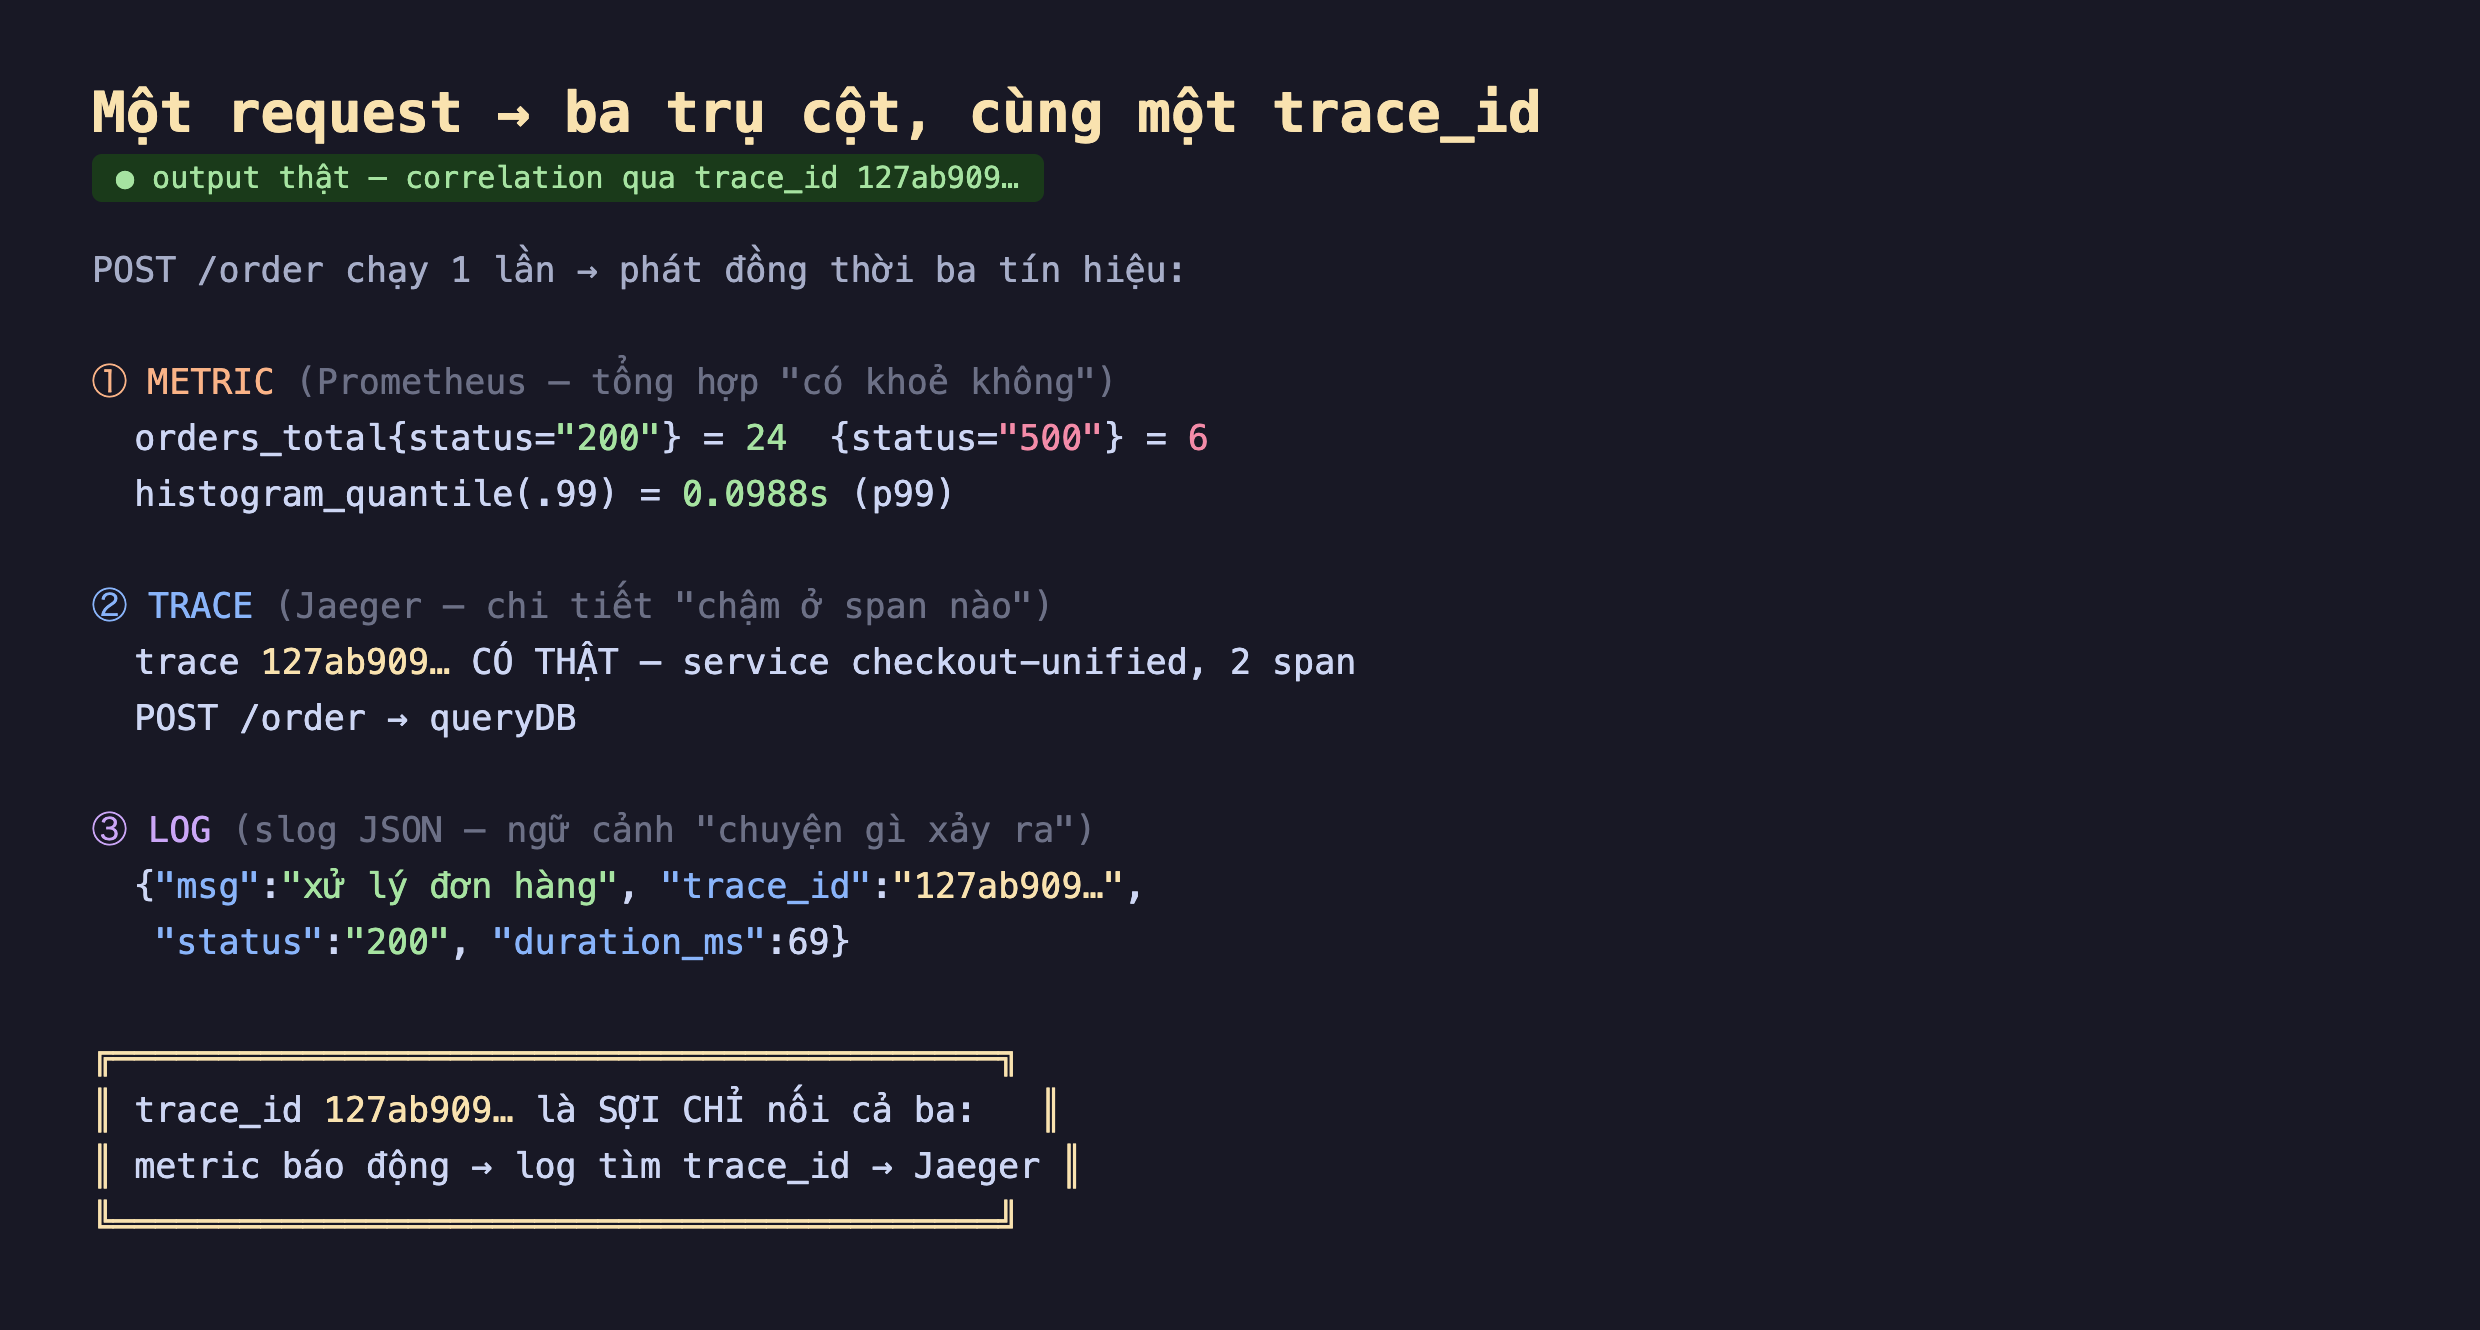
Hình 1: Một request POST /order phát đồng thời ba tín hiệu, cùng trace_id 127ab909…. METRIC: orders_total 200=24/500=6, p99=0.0988s (Prometheus đã scrape). TRACE: Jaeger xác nhận trace 127ab909… có thật (service checkout-unified, 2 span). LOG: dòng JSON mang đúng trace_id đó. Correlation được kiểm chứng thật, không bịa.
Đây là toàn bộ loạt bài gói trong một hình: trace_id 127ab909… xuất hiện trong log, và khi mình hỏi Jaeger bằng chính id đó, Jaeger trả về trace thật của request; cùng lúc metric cho bức tranh tổng. Metric chỉ cho bạn biết "có 6 request lỗi"; log cho biết "request này lỗi, trace_id X"; trace cho biết "request X kẹt ở queryDB". Ba câu hỏi, ba công cụ, một sợi chỉ.
Toàn bộ loạt bài: những con số đo thật
Điều mình tự hào nhất ở loạt này là không có con số nào bịa — mỗi kết luận đến từ một lần chạy thật trong container. Tổng hợp lại:
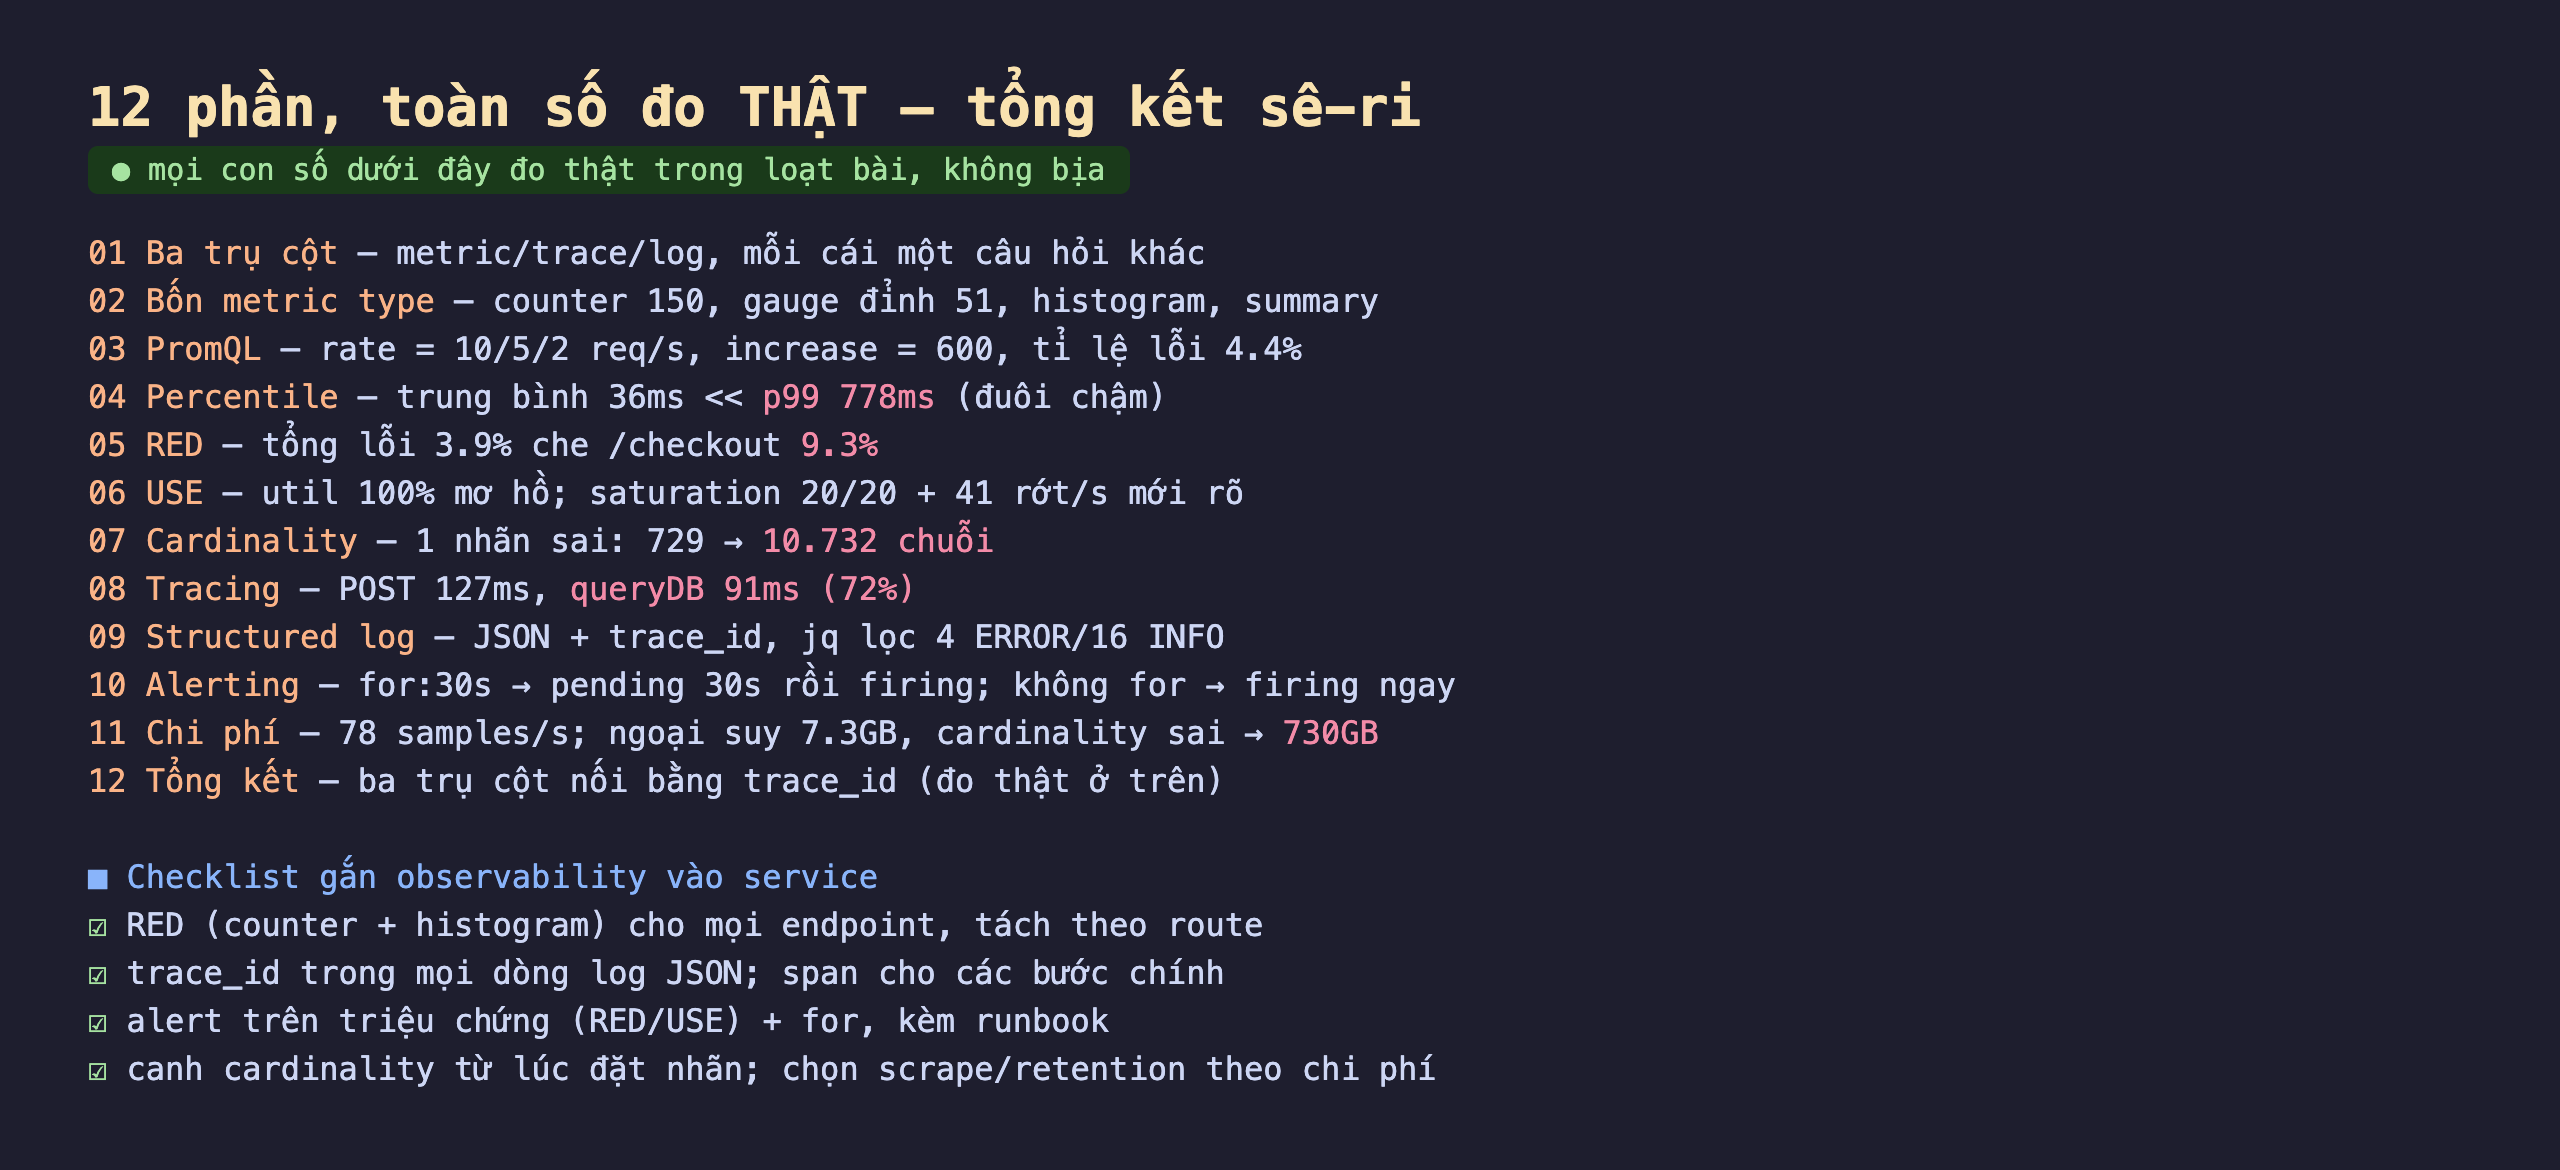
Hình 2: Tổng kết 12 phần — mọi con số đều đo thật trong loạt bài. Từ bốn loại metric, percentile phơi bày đuôi chậm (p99 778ms), RED/USE phát hiện và định vị, cardinality nổ (729→10.732), tracing chỉ span thủ phạm (queryDB 91ms), tới chi phí ngoại suy (730GB khi cardinality sai). Bên dưới là checklist gắn observability vào service.
Checklist thực chiến
Gộp bài học thành việc cần làm khi gắn observability cho một service mới:
- Instrument RED trước tiên — một counter
{route, status}và một histogram{route}cho mọi endpoint. Tách theo route (chuẩn hoá/user/{id}, đừng để id thật), vì số tổng hợp che mất endpoint hỏng (bài 05). - Chọn metric type đúng — counter cho cái tích luỹ, gauge cho trạng thái tức thời, histogram cho độ trễ (ưu tiên histogram hơn summary để gộp được p99 nhiều instance), và đặt bucket khớp vùng giá trị thật (bài 02, 04).
- Structured log + trace_id — log JSON (
slog), nhúngtrace_idvào mọi dòng để nối sang trace; đẩy dữ liệu cardinality cao (user_id, request_id) vào log chứ không làm nhãn metric (bài 07, 09). - Trace các bước chính — auto-instrument hạ tầng (HTTP/gRPC/DB), span thủ công cho logic nghiệp vụ; propagate context qua mọi ranh giới service; lấy mẫu để kiểm soát chi phí (bài 08).
- Alert trên triệu chứng, không trên nguyên nhân — cảnh báo theo RED/USE (tỉ lệ lỗi, p99, saturation) người dùng cảm nhận được, kèm
forchống nhiễu và một runbook cho mỗi alert (bài 05, 06, 10). - Canh chi phí từ đầu — theo dõi cardinality ngay khi đặt nhãn, chọn
scrape_interval/retention theo tốc độ thay đổi của metric, downsample cho dài hạn (bài 11).
Đánh đổi cần cân nhắc
Observability là đầu tư, không miễn phí — nhưng rẻ hơn downtime. Gắn đủ ba trụ cột tốn công instrument, tốn tiền lưu trữ, tốn kỷ luật duy trì. Nhưng cái giá của không có nó là những giờ mò mẫm lúc sự cố, quy tội sai, sửa nhầm chỗ. Cân bằng thực tế: bắt đầu bằng RED (rẻ, giá trị cao nhất), thêm trace và log có cấu trúc khi hệ phức tạp lên, và luôn hỏi "tín hiệu này có giúp tôi trả lời câu hỏi thật lúc 3h sáng không?" trước khi thêm.
Công cụ không thay được văn hoá. Dashboard đẹp và trace chi tiết vô dụng nếu không ai nhìn, không ai viết runbook, không ai điều tra alert. Observability là thực hành — review dashboard định kỳ, cập nhật alert khi hệ đổi, và biến mỗi sự cố thành một bài học gắn thêm tín hiệu còn thiếu. Loạt bài này dạy cơ chế; biến nó thành thói quen đội ngũ là phần việc của bạn.
Đừng quan sát mọi thứ — quan sát điều quan trọng. Cám dỗ lớn nhất sau khi học observability là instrument tất cả. Nhưng metric không ai nhìn, alert không ai xử lý, trace không ai mở chỉ tạo nhiễu và chi phí. Mục tiêu không phải nhiều dữ liệu nhất mà là trả lời được câu hỏi vận hành nhanh nhất với lượng tín hiệu tối thiểu. Ít mà đúng thắng nhiều mà loạn.
Ba ý mang về
- Ba trụ cột nối bằng trace_id thành một hệ thống: đo thật một request phát metric (orders 200=24/500=6, p99 99ms), trace (Jaeger xác nhận trace 127ab909…) và log (JSON cùng trace_id) — correlation id biến ba công cụ rời rạc thành một đường điều tra liền mạch.
- Mỗi trụ cột một câu hỏi, dùng đúng chỗ: metric cho "có khoẻ không" (cảnh báo, rẻ, luôn bật), trace cho "chậm ở span nào" (chi tiết, lấy mẫu), log cho "chuyện gì xảy ra" (ngữ cảnh) — không cái nào thay được cái nào, và chúng mạnh nhất khi dùng cùng nhau.
- Checklist: RED trước, trace_id trong log, alert trên triệu chứng, canh cardinality: toàn bộ 12 phần đo thật quy về vài nguyên tắc thực chiến — bắt đầu rẻ với RED, nối log↔trace bằng trace_id, cảnh báo cái người dùng cảm nhận kèm runbook, và kiểm soát chi phí/cardinality từ lúc đặt nhãn.
Nguồn
- Google SRE Book — Monitoring Distributed Systems: https://sre.google/sre-book/monitoring-distributed-systems/
- Charity Majors et al. — Observability Engineering (O'Reilly): https://www.honeycomb.io/blog/observability-a-manifesto
- OpenTelemetry — Observability primer: https://opentelemetry.io/docs/concepts/observability-primer/
- Cindy Sridharan — Distributed Systems Observability: https://unlimited.humio.com/rt/distributed-systems-observability
