Chín bài qua ta đã dựng metric, trace, log — nhưng tất cả vô dụng nếu lúc 3 giờ sáng hệ thống sập mà không ai biết. Alerting là cầu nối giữa quan sát và hành động: nó theo dõi metric liên tục và đánh thức con người khi có chuyện. Nghe đơn giản, nhưng alerting là nơi dễ sai nhất trong cả observability — và sai theo hướng nguy hiểm. Alert quá nhạy thì kêu loạn vì mọi gai nhọn nhất thời, kỹ sư bị alert fatigue (mệt mỏi vì báo động) rồi tắt thông báo — và bỏ lỡ sự cố thật. Alert quá chậm thì sự cố cháy rồi mới biết. Ranh giới giữa hai thái cực đó, trong Prometheus, nằm gọn ở một từ khoá: for. Bài này (phần 10 loạt Observability) dựng thật alert rule và đo từng mốc chuyển trạng thái để thấy for làm gì.
Alert rule và vòng đời một alert
Một alert rule trong Prometheus là một biểu thức PromQL kèm điều kiện. Khi biểu thức trả về kết quả (điều kiện đúng), alert bắt đầu vòng đời của nó qua ba trạng thái:
- inactive — điều kiện sai, không có gì xảy ra.
- pending — điều kiện vừa trở nên đúng, nhưng chưa đủ lâu theo
for. Alert đang "chờ xem có phải thật không". - firing — điều kiện đã đúng liên tục đủ thời gian
for. Giờ mới thật sự báo động (gửi sang Alertmanager → Slack/PagerDuty).
for chính là khoảng pending — thời gian điều kiện phải đúng liên tục trước khi chuyển sang firing. Nó là bộ lọc chống nhiễu: một gai nhọn 5 giây sẽ đưa alert vào pending rồi rút lui về inactive khi gai qua, không bao giờ firing. Chỉ vấn đề dai dẳng mới vượt qua for.
groups:
  - name: service-alerts
    rules:
      # CÓ for → chờ 30s mới báo, chống nhiễu
      - alert: HighErrorRate
        expr: sum(rate(http_requests_total{status="500"}[1m]))
            / sum(rate(http_requests_total[1m])) > 0.05
        for: 30s          # điều kiện phải đúng LIÊN TỤC 30s
        labels: {severity: critical}
      # KHÔNG for → firing NGAY khi vượt ngưỡng (dễ báo giả)
      - alert: InstantNoFor
        expr: (…giống hệt…) > 0.05
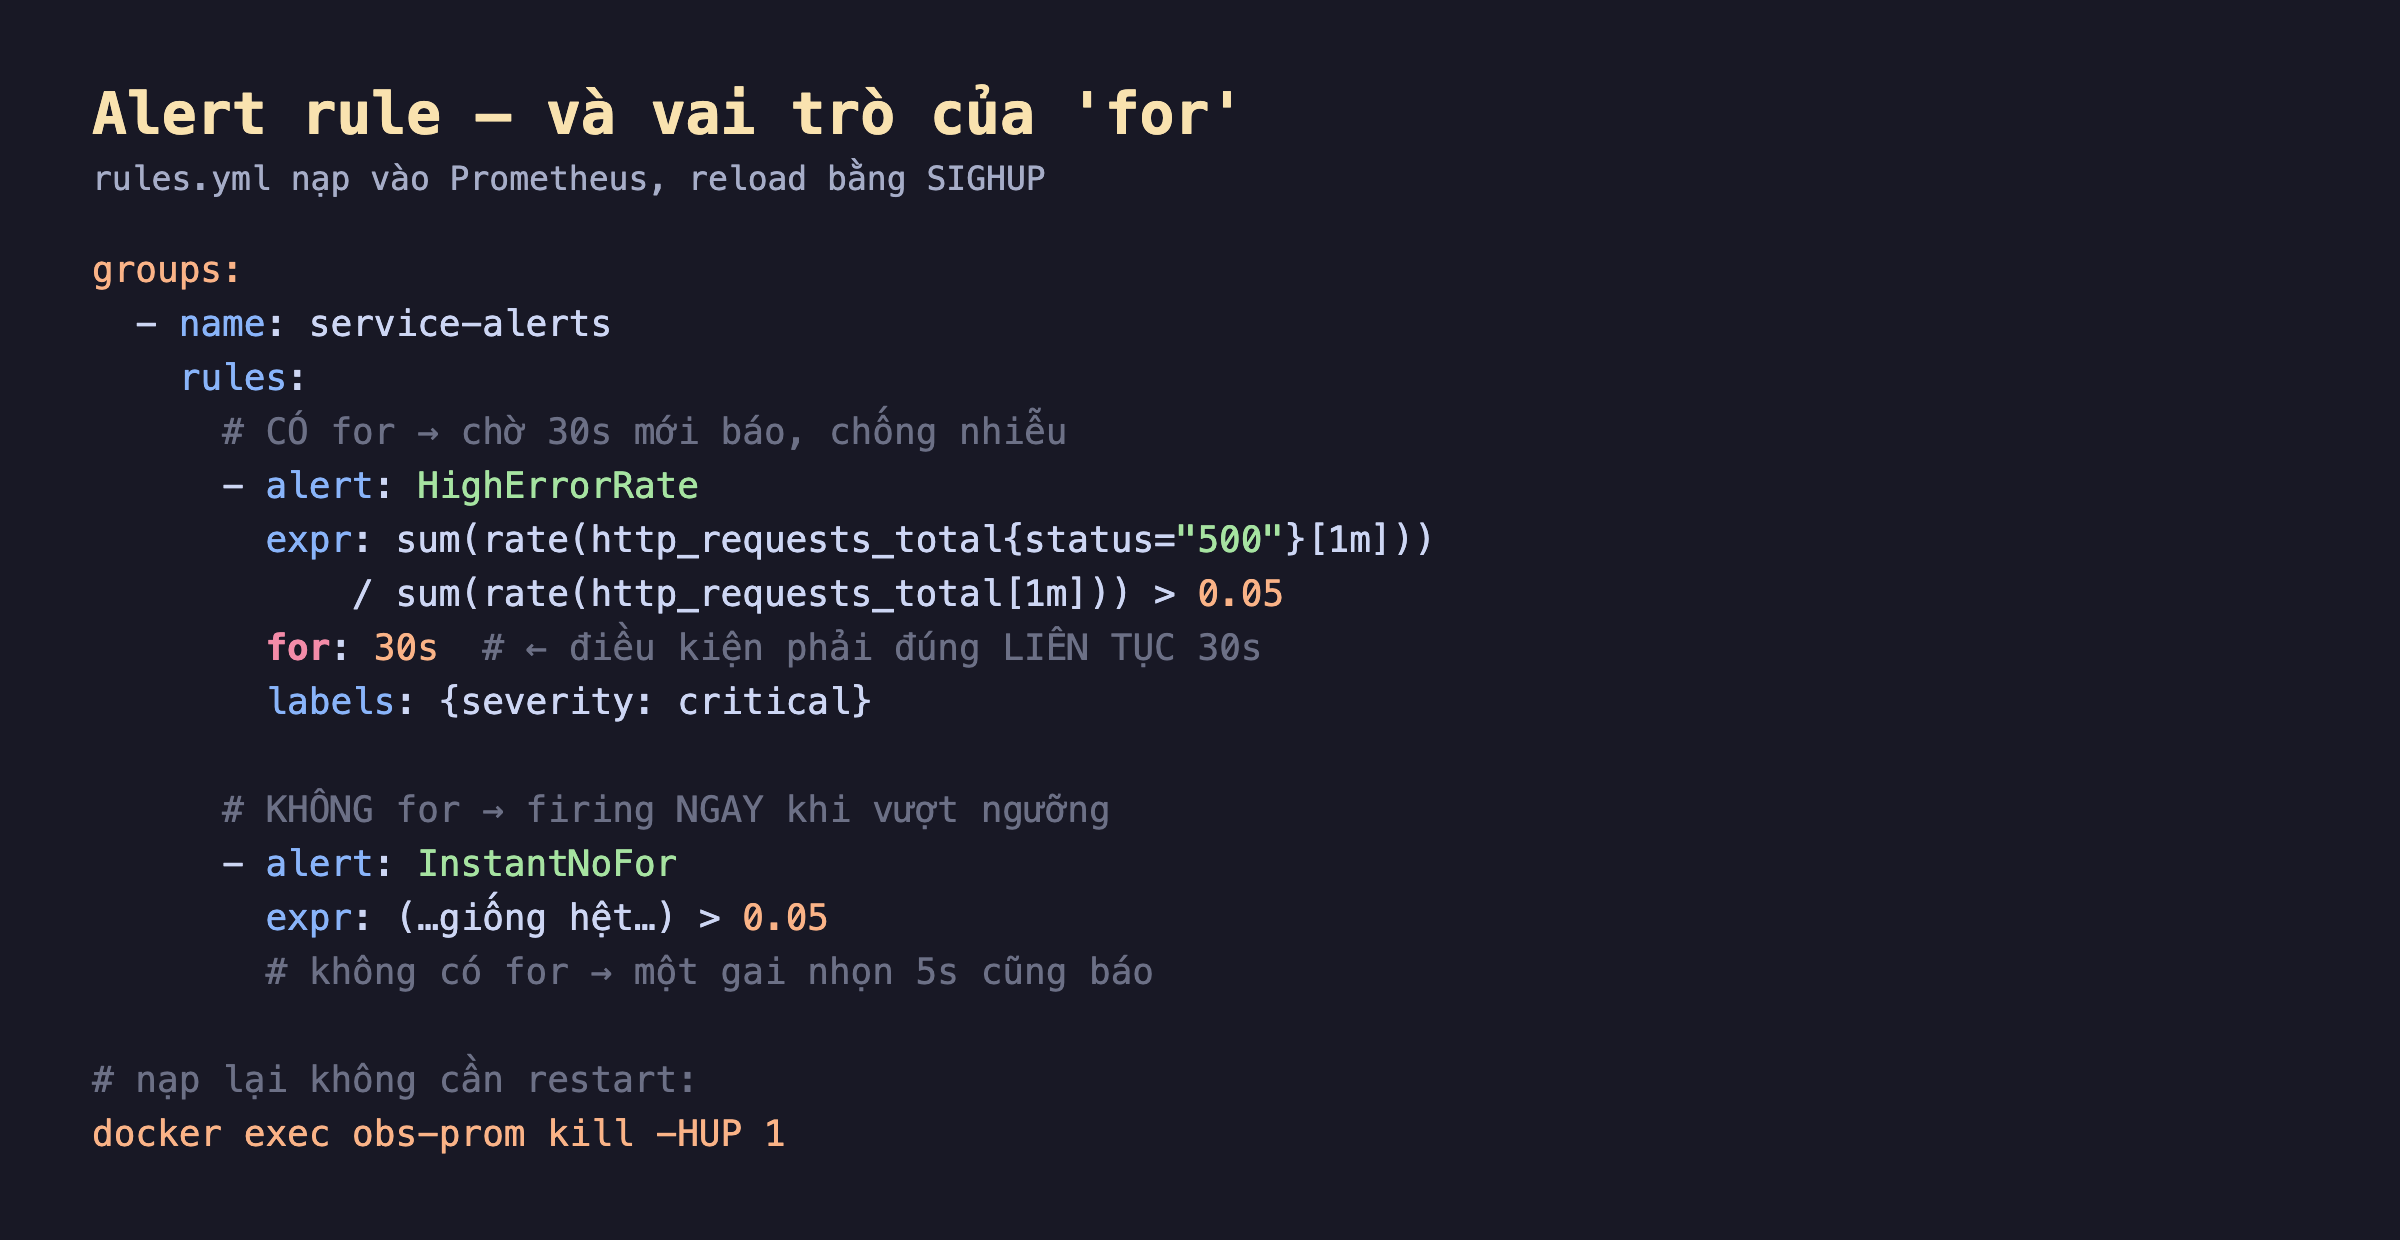
Hình 1: Hai alert cùng biểu thức (tỉ lệ lỗi 5xx > 5%), khác nhau duy nhất ở for. HighErrorRate có for: 30s nên điều kiện phải đúng liên tục 30 giây mới firing; InstantNoFor không có for nên firing ngay. Rule nạp lại bằng SIGHUP (kill -HUP 1), không cần restart.
Đo thật: hai alert, hai số phận
Mình chạy một app phát ~20% lỗi (tỉ lệ lỗi thật đo được 0.199, vượt xa ngưỡng 5%), nạp rule vào obs-prom, rồi query /api/v1/alerts liên tục để bắt từng mốc chuyển trạng thái:
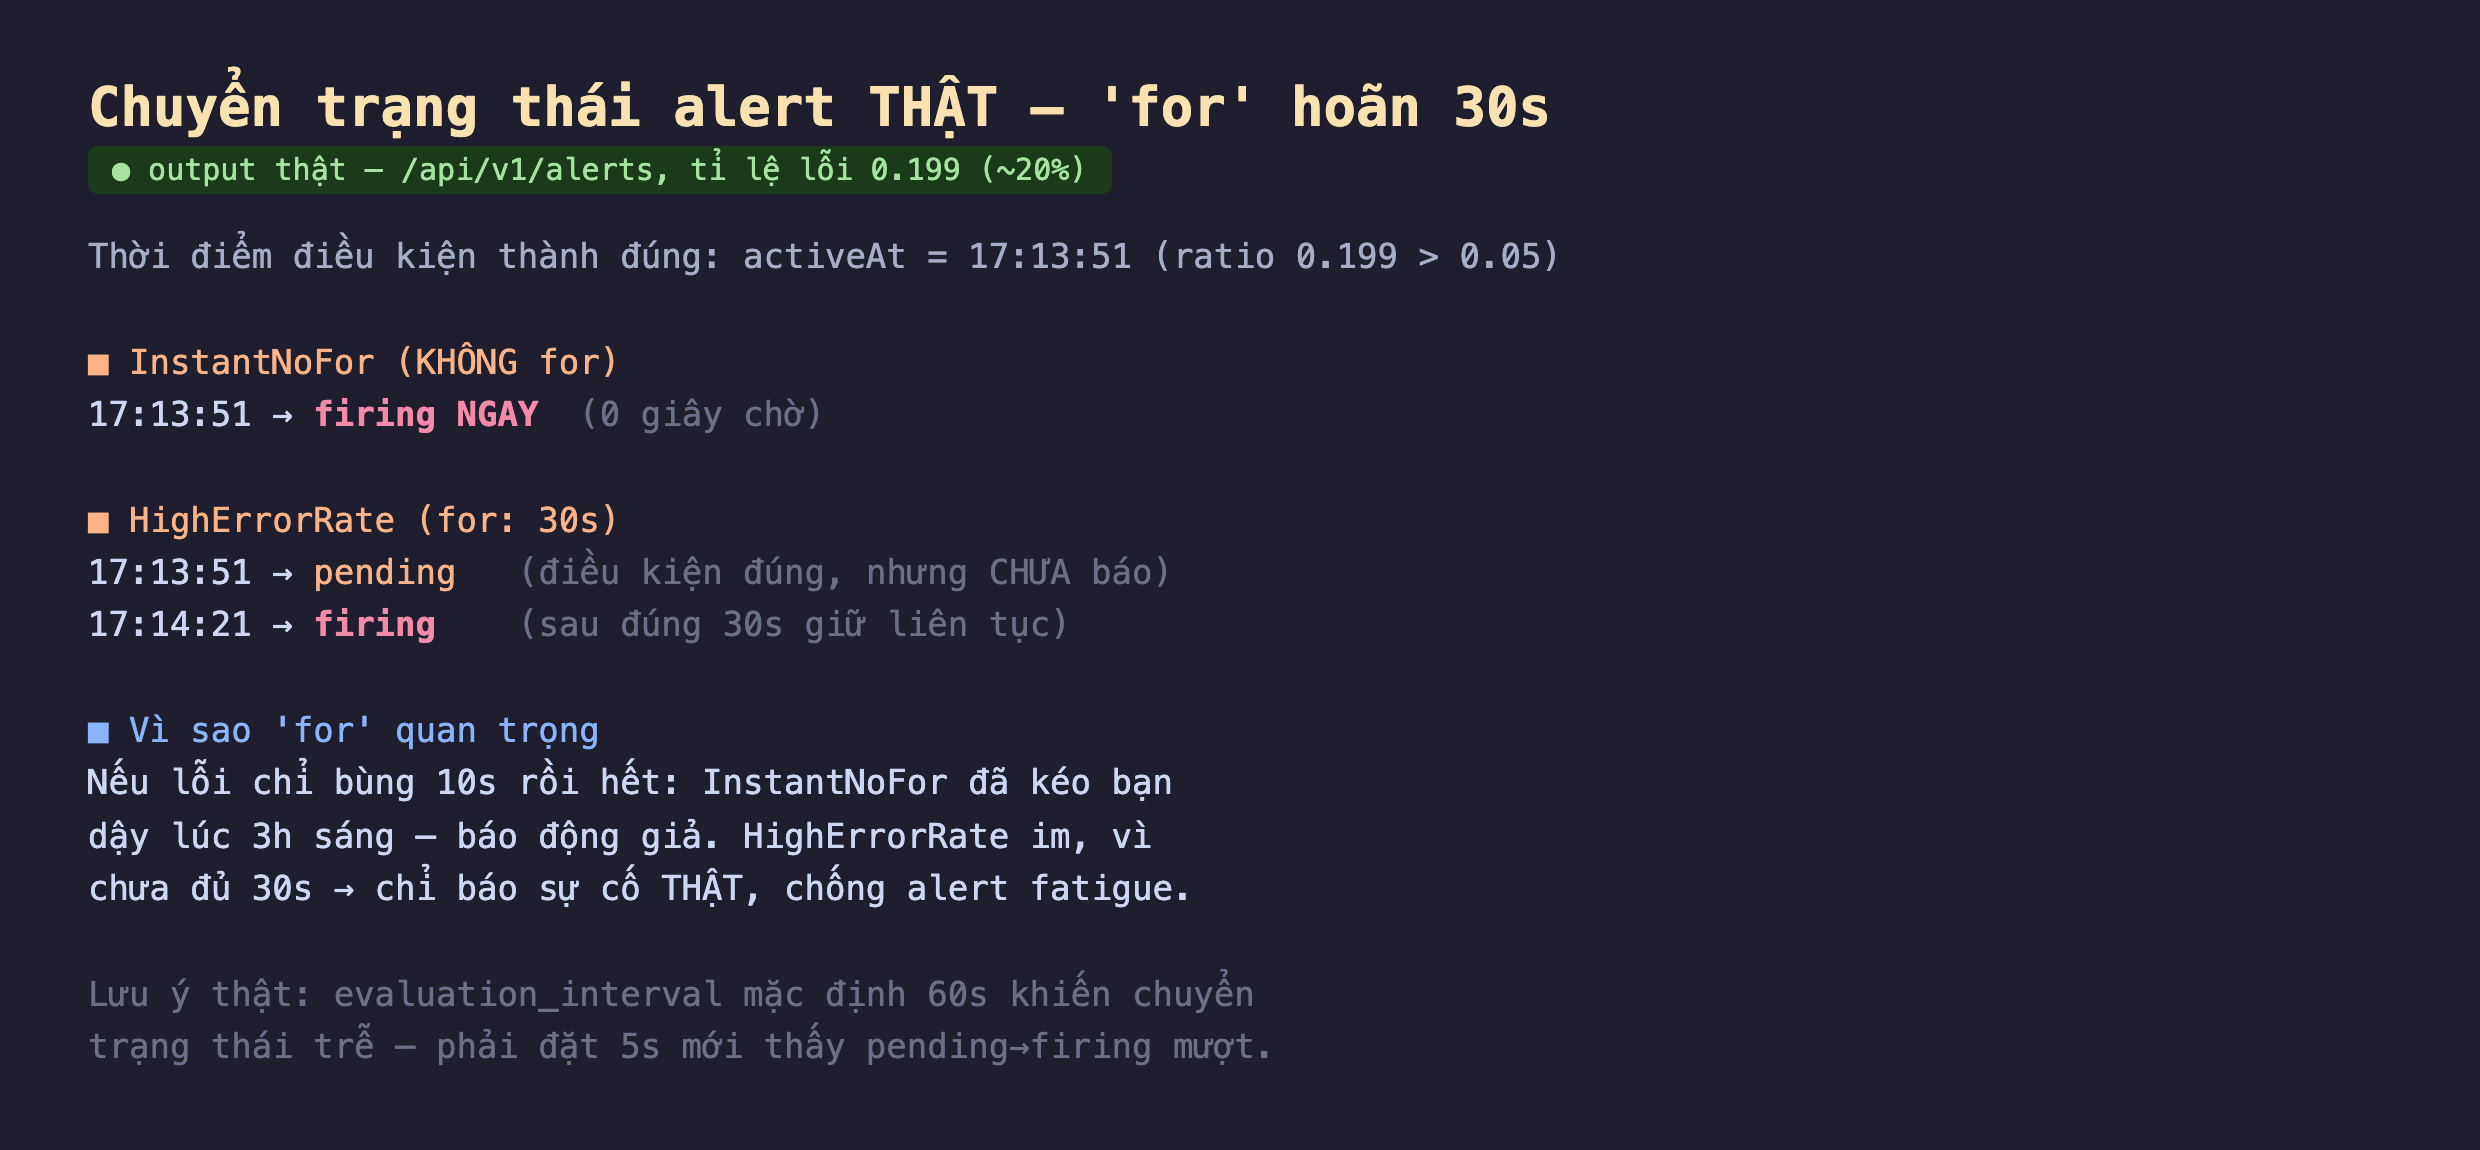
Hình 2: Chuyển trạng thái thật. Điều kiện trở nên đúng tại activeAt = 17:13:51 (ratio 0.199 > 0.05). InstantNoFor (không for) firing ngay tại 17:13:51. HighErrorRate (for: 30s) ở pending tại 17:13:51, rồi chuyển firing tại 17:14:21 — đúng sau 30 giây giữ liên tục.
Đọc kết quả:
InstantNoForfiring ngay tại 17:13:51 — khoảnh khắc tỉ lệ lỗi vượt 5%, không chờ một giây. Nghe "nhạy" có vẻ tốt, nhưng đó là cạm bẫy.HighErrorRatepending tại 17:13:51, firing tại 17:14:21 — cùng điều kiện, cùng thời điểm bắt đầu, nhưng nó chờ đúng 30 giây (khoảngfor) trước khi báo động thật. Trong 30 giây đó nó ở trạng thái pending: "tôi thấy có vấn đề, nhưng để chắc chắn đã".
Vì sao khác biệt này quyết định? Hình dung tỉ lệ lỗi bùng lên 10 giây rồi tự hết (một lần deploy, một GC pause, một spike nhất thời). InstantNoFor đã kéo bạn dậy lúc 3 giờ sáng cho một sự cố đã tự khỏi — báo động giả. HighErrorRate thì im lặng: nó vào pending, nhưng gai nhọn qua trước 30 giây nên nó rút về inactive, không ai bị đánh thức. for lọc nhiễu nhất thời, chỉ để lọt sự cố dai dẳng — đó chính là thứ chống alert fatigue.
Một chi tiết thật phải nói thẳng: evaluation_interval
Lần chạy đầu tiên, HighErrorRate kẹt ở pending mãi không chịu firing, dù đã quá 30 giây. Lý do không phải for sai — mà vì Prometheus đánh giá rule theo evaluation_interval, mặc định 60 giây. Rule chỉ được tính lại mỗi phút, nên giữa hai lần đánh giá, trạng thái không đổi; for: 30s không thể chuyển firing nếu lần đánh giá kế tiếp mãi 60 giây sau mới tới. Mình phải đặt evaluation_interval: 5s thì mới thấy chuyển pending→firing mượt như hình. Bài học thật: for được đo tại các mốc đánh giá, không liên tục — chọn evaluation_interval quá thưa làm alert trễ hơn bạn tưởng. Đây là loại chi tiết chỉ lộ ra khi chạy thật, không có trong tài liệu tóm tắt.
Đánh đổi cần cân nhắc
for dài chống nhiễu nhưng làm chậm phản ứng. for: 30s lọc gai nhọn, nhưng cũng nghĩa là với sự cố thật, bạn biết trễ 30 giây. Với dịch vụ quan trọng, 30 giây có thể là nhiều. Cân bằng theo mức nghiêm trọng: alert "service sập hoàn toàn" nên for ngắn (hoặc 0) vì mọi giây đều quý; alert "độ trễ hơi cao" nên for dài hơn để tránh nhiễu. Không có giá trị for đúng cho mọi alert.
Ngưỡng tĩnh là nguồn gốc alert fatigue. > 0.05 là ngưỡng cứng. Nhưng 5% lỗi có thể bình thường với dịch vụ này mà thảm hoạ với dịch vụ kia; và tải thay đổi theo giờ (đêm ít request, một lỗi cũng đẩy tỉ lệ lên cao). Ngưỡng tĩnh hoặc kêu loạn lúc tải thấp, hoặc bỏ sót lúc tải cao. Cách tốt hơn: alert trên budget tiêu thụ (error budget burn rate) thay vì tỉ lệ tức thời — nhưng đó là chủ đề nâng cao hơn; điểm cần nhớ là ngưỡng tĩnh luôn là thoả hiệp.
Alert phải actionable, nếu không nên xoá. Một alert firing mà người nhận không biết làm gì chỉ tạo nhiễu và dạy người ta phớt lờ. Mỗi alert nên gắn với một hành động cụ thể (runbook) và báo một triệu chứng người dùng cảm nhận được (tỉ lệ lỗi, độ trễ — theo RED/USE của các bài trước), không phải một nguyên nhân nội tại (CPU cao — có thể hoàn toàn vô hại). Alert tốt ít mà đúng; alert tồi nhiều và bị tắt tiếng.
Ba ý mang về
forlà ranh giới giữa báo đúng và báo loạn: đo thậtInstantNoFor(khôngfor) firing ngay tại 17:13:51, cònHighErrorRate(for: 30s) pending rồi firing tại 17:14:21 —forlọc gai nhọn nhất thời, chỉ để lọt sự cố dai dẳng, chống alert fatigue.forđo tại mốc đánh giá, không liên tục: đo thật alert kẹt pending vìevaluation_intervalmặc định 60s; phải đặt 5s mới thấy pending→firing đúng lúc — chọn interval quá thưa làm alert trễ hơn tưởng.- Ngưỡng tĩnh và alert không actionable là nguồn gốc mệt mỏi: ngưỡng cứng
>5%kêu loạn lúc tải thấp/bỏ sót lúc tải cao; mỗi alert phải báo triệu chứng người dùng cảm nhận (RED/USE) kèm runbook,forcân theo mức nghiêm trọng — alert tốt ít mà đúng.
Nguồn
- Prometheus docs — Alerting rules: https://prometheus.io/docs/prometheus/latest/configuration/alerting_rules/
- Google SRE Book — Alerting on SLOs / burn rate: https://sre.google/workbook/alerting-on-slos/
- Prometheus docs — Configuration (evaluation_interval): https://prometheus.io/docs/prometheus/latest/configuration/configuration/
Phần sau ta nhìn observability từ góc tiền bạc: vì sao giám sát có thể tốn hơn cả hệ thống nó giám sát, và các đòn bẩy thật để cắt chi phí — sampling, retention, cardinality — mà không mù thông tin.
