Bài trước lo chuyện đúng đắn (không mất, không trùng). Bài này lo chuyện quy mô: khi một consumer xử lý không kịp lượng message đổ về, làm sao tăng tốc? Câu trả lời của Kafka là consumer group — nhiều consumer cùng một group chia nhau tải, mỗi consumer ôm một phần dữ liệu. Nghe như "cứ thêm consumer là nhanh hơn", nhưng thực tế có một trần cứng mà nhiều người chỉ phát hiện khi thêm consumer mà throughput không nhúc nhích. Trần đó là số partition. Bài này (phần 3 loạt Message Queue) chạy thật để thấy partition chia cho consumer ra sao, và điều gì xảy ra khi bạn vượt trần.
Partition là đơn vị song song
Một topic Kafka chia thành nhiều partition — mỗi partition là một log có thứ tự riêng. Trong một consumer group, Kafka áp một quy tắc sắt: mỗi partition được giao cho đúng một consumer trong group tại một thời điểm. Hệ quả trực tiếp:
- Nhiều consumer trong group → mỗi consumer ôm một tập con partition → xử lý song song → throughput tăng.
- Nhưng vì mỗi partition chỉ thuộc một consumer, số consumer hoạt động tối đa = số partition. Thêm consumer quá số partition → consumer dư thừa không được giao gì, ngồi không.
Đây là lý do số partition là quyết định kiến trúc quan trọng: nó đặt trần cho mức độ song song của consumer. Chọn quá ít partition, bạn không thể scale consumer dù máy còn rảnh.
# tạo topic 6 partition — tối đa 6 consumer chạy song song
kafka-topics.sh --create --topic mq03-demo --partitions 6
# nhiều consumer CÙNG group (chạy nền)
for i in 1 2 3; do docker exec -d kafka-lab \
  kafka-console-consumer.sh --topic mq03-demo \
  --group gshow --consumer-property client.id=c$i; done
# xem phân bổ partition cho từng member
kafka-consumer-groups.sh --describe --group gshow --members
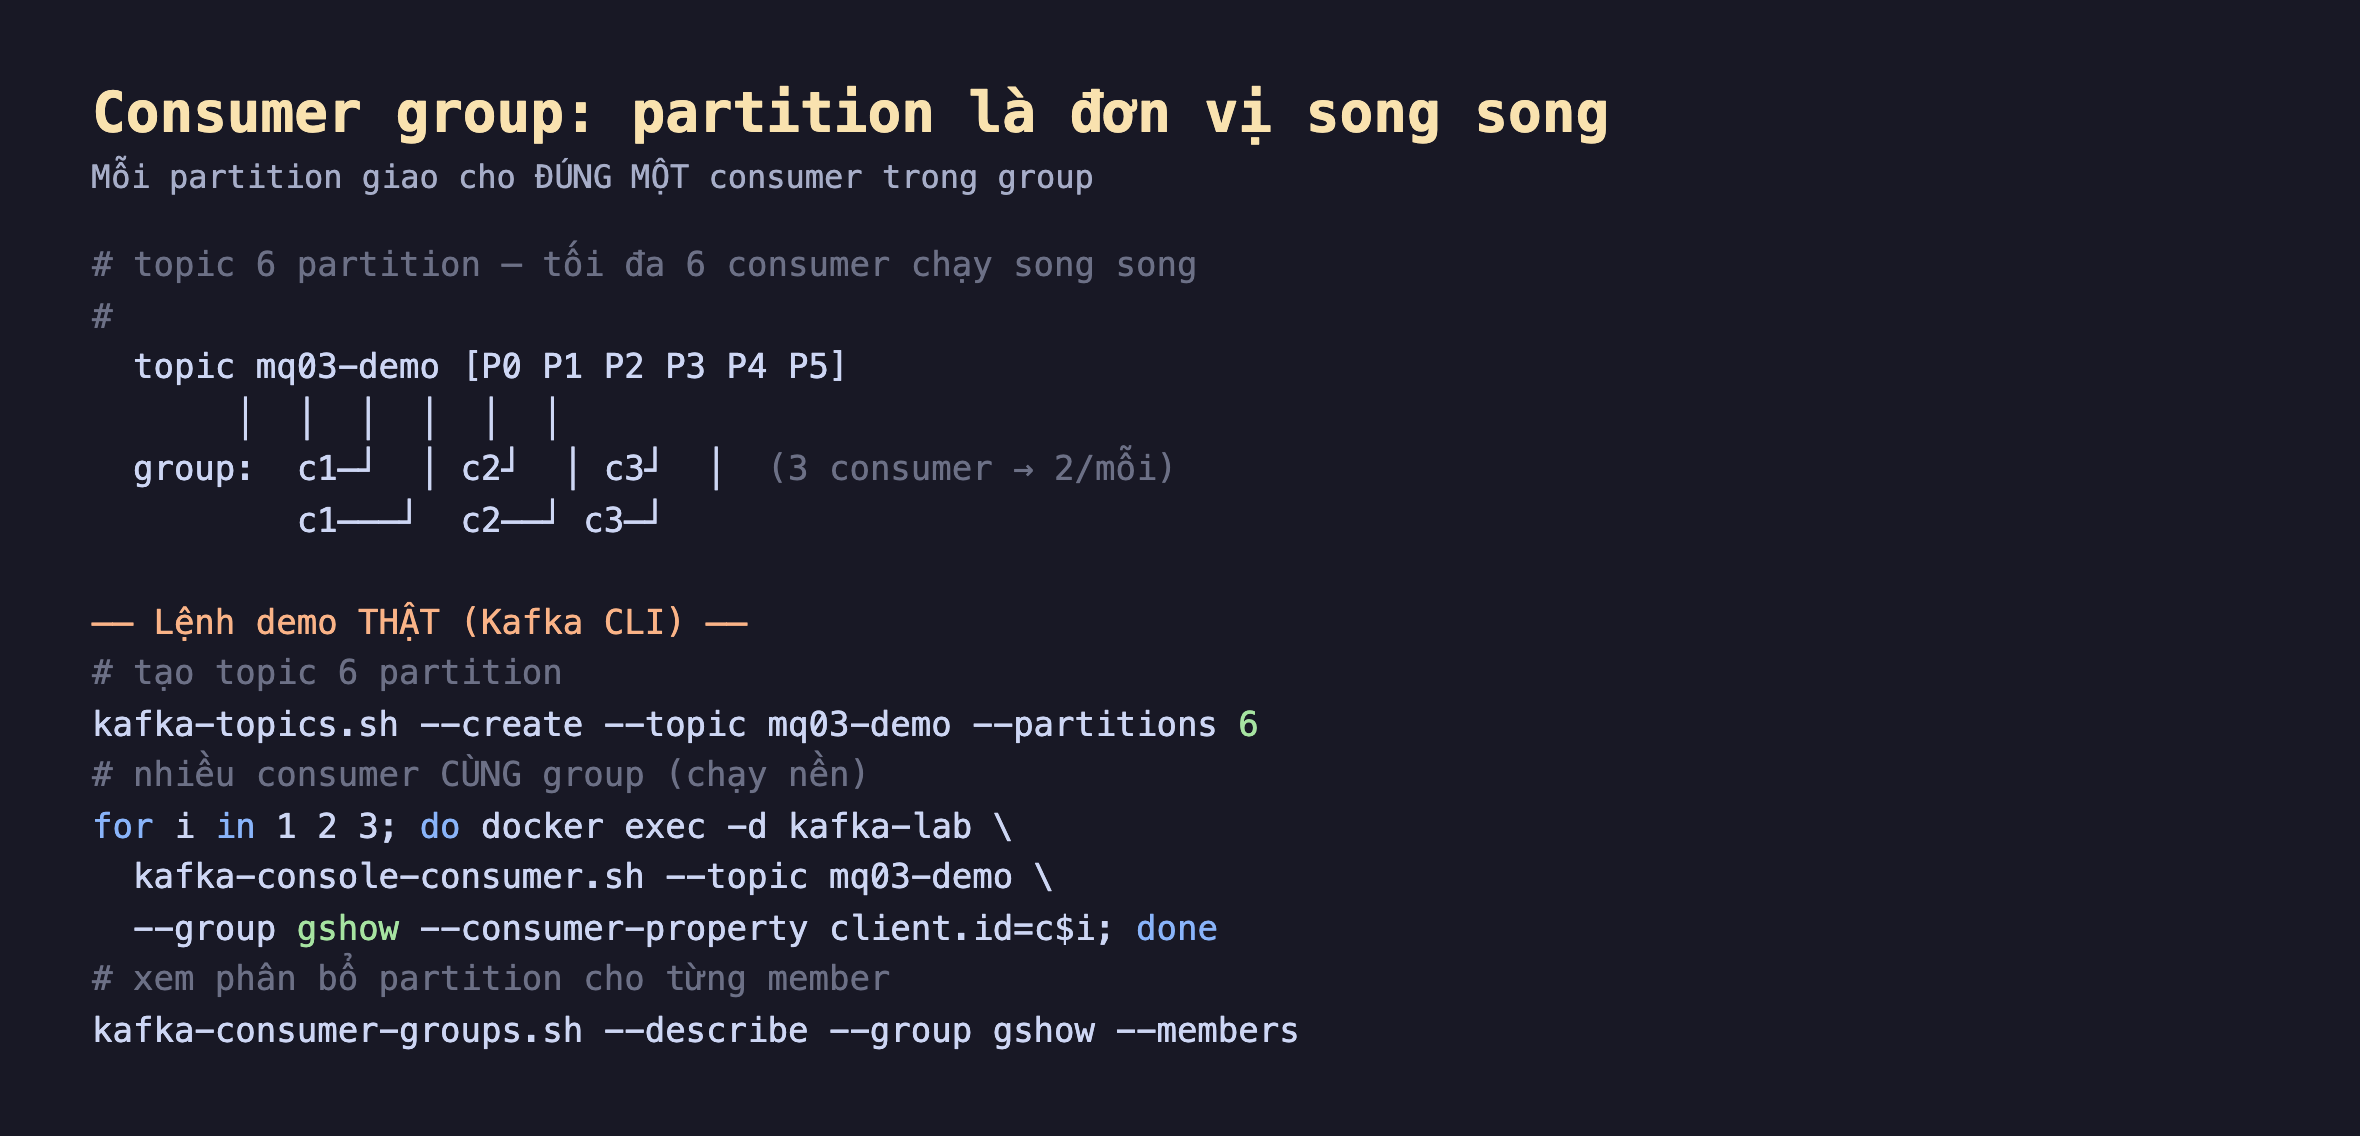
Hình 1: Topic 6 partition; trong một consumer group, mỗi partition giao cho đúng một consumer. Nhiều consumer cùng group chia nhau partition để xử lý song song. Bên dưới là các lệnh Kafka CLI tạo topic 6 partition, chạy nhiều consumer nền cùng group, và xem phân bổ partition.
Đo thật: 3 consumer chia đều, consumer thứ 7 ngồi không
Mình tạo topic mq03-demo 6 partition, produce 600.000 message (producer đạt 730.000 msg/s), rồi khởi động nhiều consumer cùng group và xem Kafka phân bổ partition:
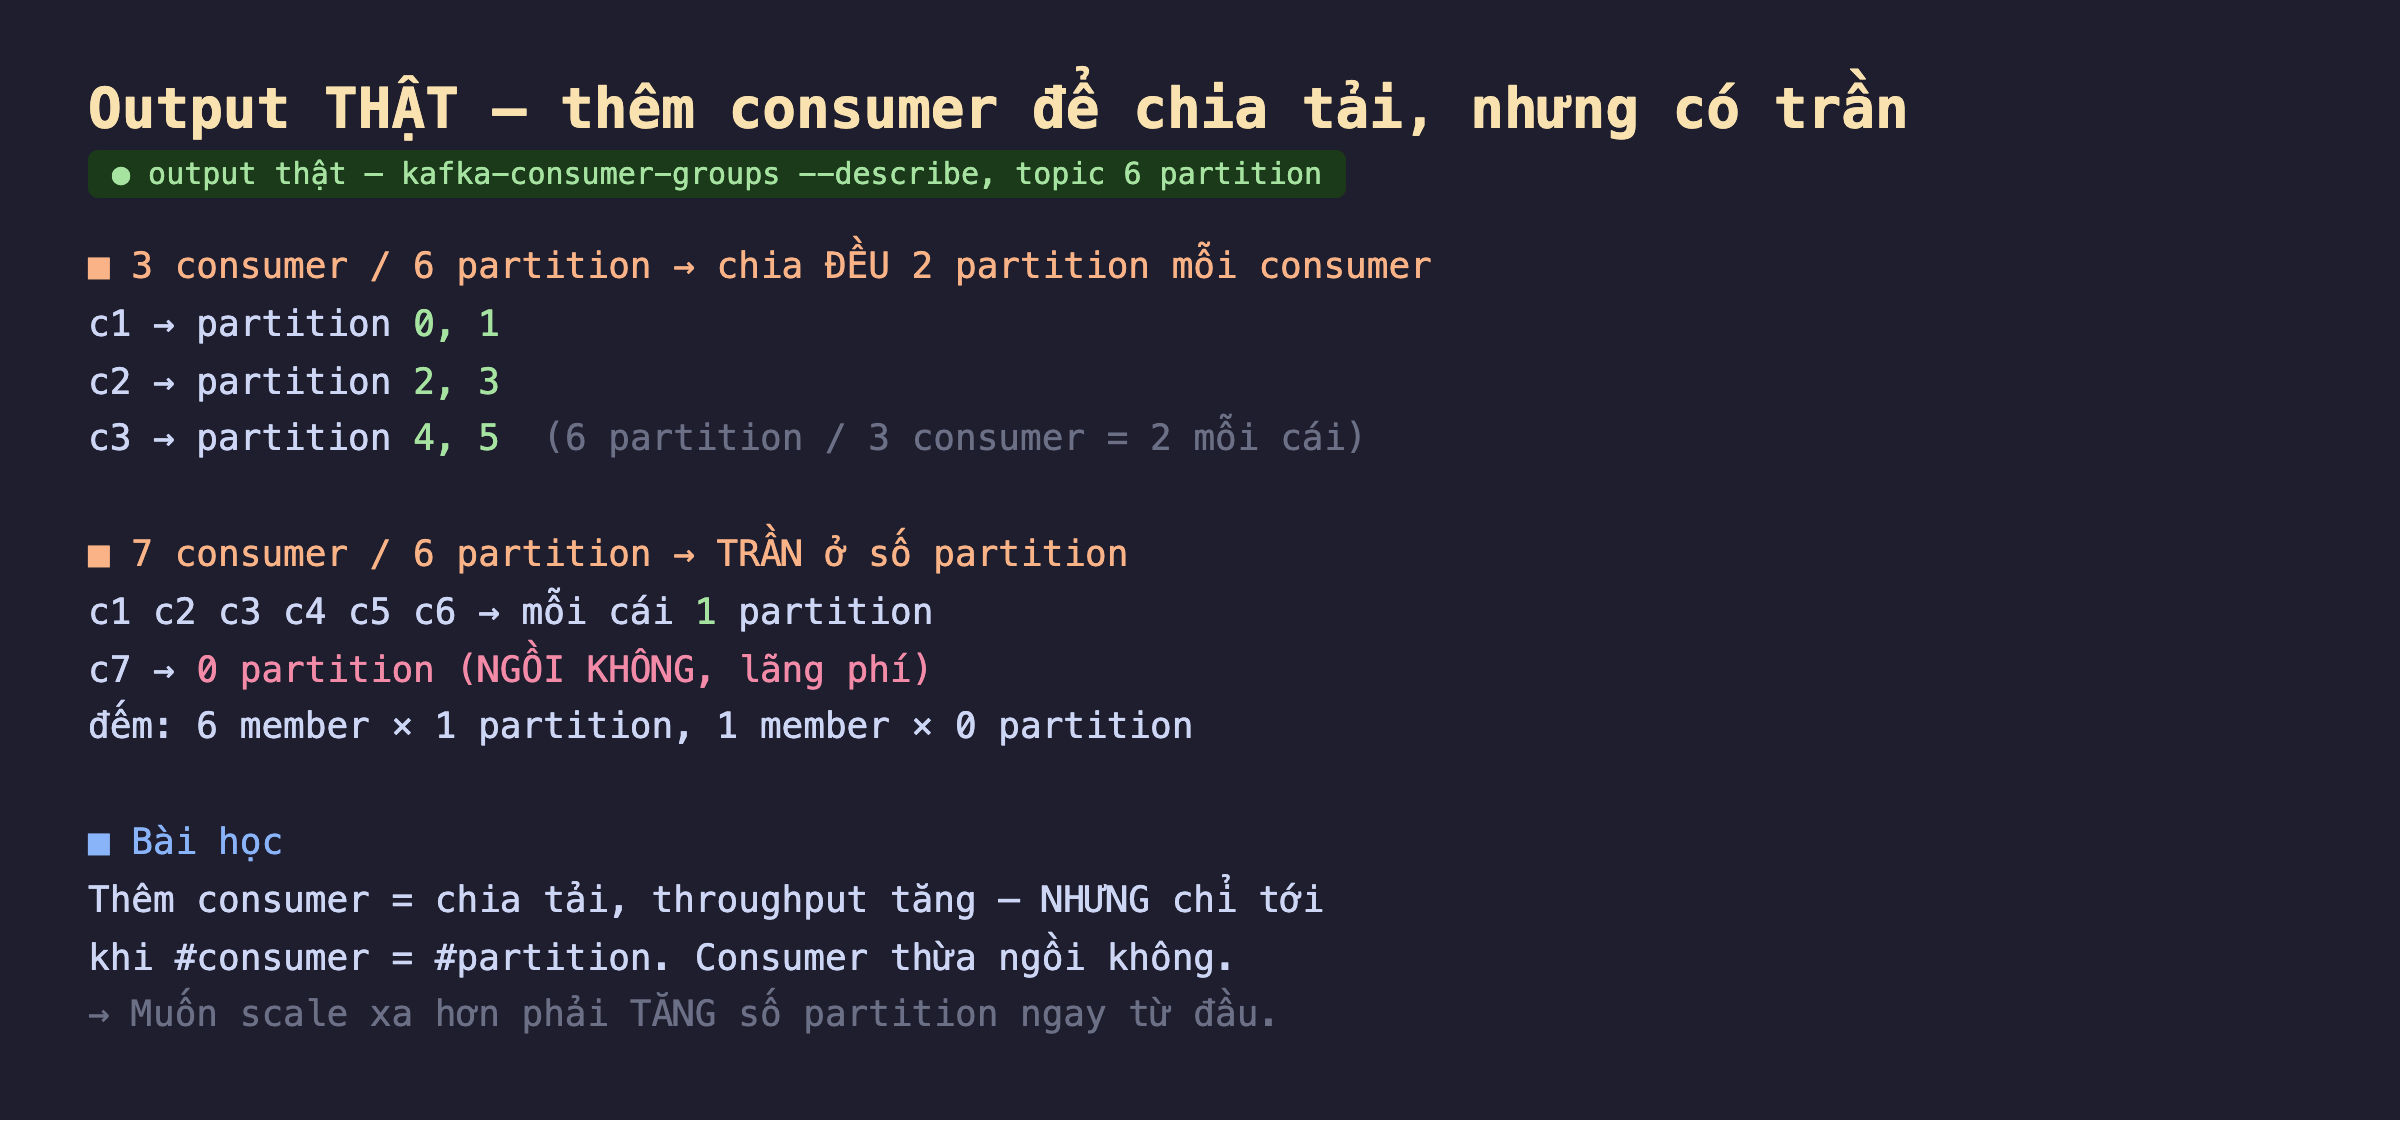
Hình 2: Kết quả thật. Với 3 consumer trên 6 partition, Kafka chia đều: c1 nhận partition 0-1, c2 nhận 2-3, c3 nhận 4-5. Khi tăng lên 7 consumer trên cùng 6 partition: 6 consumer mỗi cái nhận 1 partition, còn consumer thứ 7 nhận 0 partition — ngồi không, lãng phí tài nguyên.
Đọc kết quả:
- 3 consumer / 6 partition → chia đều 2 partition mỗi cái:
kafka-consumer-groups --describecho thấy c1 ôm partition {0,1}, c2 ôm {2,3}, c3 ôm {4,5}. Tải chia đều và độc lập — ba consumer xử lý ba đôi partition song song. Đây là cơ chế scale thật: muốn nhanh gấp đôi, thêm consumer để mỗi cái ôm ít partition hơn. - 7 consumer / 6 partition → trần cứng: khi thêm consumer lên 7, chỉ 6 consumer được giao mỗi cái 1 partition; consumer thứ 7 nhận 0 partition và hoàn toàn ngồi không. Nó không làm gì, không tăng throughput, chỉ tiêu tốn tài nguyên và giữ một kết nối vô ích. Đây là trần: số consumer hoạt động ≤ số partition.
Hệ quả thực chiến: nếu bạn dự đoán cần scale tới 20 consumer trong tương lai, phải tạo topic với ít nhất 20 partition ngay từ đầu. Tăng partition sau khi topic đã chạy là việc đau (ảnh hưởng ordering theo key, cần rebalance dữ liệu) — nên người ta thường over-provision partition ngay lúc tạo.
Rebalancing: cái giá ẩn của việc thêm/bớt consumer
Có một chi tiết thật mình vấp phải khi đo: khi thử đo throughput với 1, 2, 3 consumer bằng công cụ perf-test, con số gần như không đổi (~182.000 msg/s cả ba) — không phải vì scale không hoạt động, mà vì mỗi lần nhóm thay đổi thành viên, Kafka chạy rebalancing (phân bổ lại partition), tốn ~3,1 giây cố định trong mỗi phép đo ngắn, nuốt mất phần throughput tăng thêm. Đây là bài học quan trọng: mỗi lần consumer tham gia/rời group, cả group dừng tiêu thụ trong lúc rebalance (gọi là "stop-the-world rebalance" ở giao thức cũ). Với group lớn hay consumer hay chết/sống, rebalancing liên tục có thể giết throughput — thêm consumer nhiều khi phản tác dụng nếu chúng không ổn định. (Kafka mới có cooperative/incremental rebalance giảm đau này.)
Đánh đổi cần cân nhắc
Nhiều partition hơn không miễn phí. Partition là trần của song song, nên "cứ tạo 100 partition cho chắc" nghe hợp lý — nhưng mỗi partition tốn tài nguyên broker (file handle, bộ nhớ, thời gian bầu leader khi broker chết) và làm chậm việc phục hồi. Partition cũng là đơn vị đảm bảo thứ tự (bài sau): nhiều partition hơn = thứ tự toàn cục yếu hơn. Quy tắc: ước lượng throughput đỉnh cần, chia cho throughput một consumer, cho dư một chút — đừng tạo hàng nghìn partition "cho chắc".
Partition thừa cũng lãng phí như consumer thừa. Nếu topic 50 partition nhưng chỉ bao giờ chạy 3 consumer, 47 partition kia chỉ thêm overhead mà không cho song song thật (mỗi consumer ôm ~17 partition, không nhanh hơn ôm 1 partition lớn là bao nếu consumer đã là nút thắt). Cân bằng số partition với số consumer thực tế sẽ chạy, không phải con số lý thuyết.
Scale consumer không sửa được consumer chậm. Nếu một consumer chậm vì xử lý mỗi message tốn thời gian (gọi API ngoài, query DB nặng), thêm consumer chia tải giúp — tới trần partition. Nhưng nếu nút thắt là downstream (DB chỉ chịu được X ghi/s), thêm consumer chỉ dồn tải lên DB và làm mọi thứ chậm hơn. Trước khi scale consumer, xác định nút thắt thật nằm ở đâu.
Ba ý mang về
- Partition là đơn vị song song, mỗi partition thuộc đúng một consumer: đo thật 3 consumer trên 6 partition chia đều 2 partition mỗi cái (c1:0-1, c2:2-3, c3:4-5) — thêm consumer để mỗi cái ôm ít partition hơn là cách scale throughput.
- Số partition là trần cứng của scale consumer: đo thật 7 consumer trên 6 partition → consumer thứ 7 nhận 0 partition, ngồi không; muốn scale tới N consumer phải tạo ≥ N partition từ đầu vì tăng partition sau rất đau.
- Rebalancing và nút thắt downstream là cái giá ẩn: đo thật mỗi thay đổi thành viên tốn ~3,1s rebalance (cả group dừng tiêu thụ); và thêm consumer không cứu được nếu nút thắt là xử lý mỗi message hay downstream — xác định nút thắt trước khi scale.
Nguồn
- Kafka docs — Consumer groups & partition assignment: https://kafka.apache.org/documentation/#intro_consumers
- Confluent — How to choose the number of partitions: https://www.confluent.io/blog/how-choose-number-topics-partitions-kafka-cluster/
- Kafka docs — Consumer rebalance protocol: https://kafka.apache.org/documentation/#consumerconfigs_group.protocol
Phần sau ta xử lý hệ quả của at-least-once từ bài 2: idempotency — làm sao để xử lý một message trùng mà kết quả vẫn đúng, demo thật consumer nhận message hai lần nhưng chỉ tác động một lần nhờ dedup key.
