Bài 2 kết luận: mặc định thực tế là at-least-once — thà trùng còn hơn mất. Bài 3 cho thấy cái giá của scale cũng kéo theo rebalancing và tái xử lý. Cả hai dẫn tới cùng một sự thật không tránh được: consumer của bạn sẽ nhận message trùng. Không phải "có thể", mà "chắc chắn" — chỉ là khi nào. Nếu consumer xử lý mỗi lần nhận như một sự kiện mới, hậu quả tùy nghiệp vụ: nhẹ thì thống kê sai, nặng thì trừ tiền khách hai lần hoặc gửi hai email xác nhận. Lời giải không phải cố làm message không bao giờ trùng (bất khả) mà làm cho việc xử lý trùng trở nên vô hại — gọi là idempotency. Bài này (phần 4 loạt Message Queue) chạy thật để thấy một consumer ngây thơ sai thế nào và consumer idempotent sửa ra sao.
Idempotent nghĩa là xử lý nhiều lần = xử lý một lần
Một thao tác idempotent là thao tác mà làm nhiều lần cho kết quả giống hệt làm một lần. "Đặt số dư = 100" là idempotent (làm 10 lần vẫn 100). "Cộng 100 vào số dư" thì không (làm 2 lần thành +200). Phần lớn xử lý message là kiểu cộng dồn không idempotent sẵn, nên ta phải làm cho nó idempotent bằng cách khử trùng theo một định danh duy nhất của message:
- Mỗi message mang một id duy nhất (id thanh toán, id đơn hàng, hay một key nghiệp vụ).
- Trước khi xử lý, consumer kiểm tra id này đã xử lý chưa. Nếu rồi → bỏ qua. Nếu chưa → xử lý và ghi dấu id.
- Phép kiểm-tra-và-ghi-dấu phải nguyên tử để an toàn khi nhiều consumer chạy song song. Redis
SETNX(SET if Not eXists) làm đúng việc đó: trả 1 nếu key vừa được tạo (message mới), 0 nếu key đã tồn tại (trùng).
# NGÂY THƠ — tác động mỗi lượt giao
for msg in deliveries:
    balance += msg.amount        # trùng → cộng 2 lần!

# IDEMPOTENT — khử trùng theo id
for msg in deliveries:
    if redis.SETNX("dedup:" + msg.id, 1):   # mới → 1, trùng → 0
        balance += msg.amount    # chỉ chạy lần ĐẦU cho mỗi id
    else:
        skip                     # id này xử lý rồi
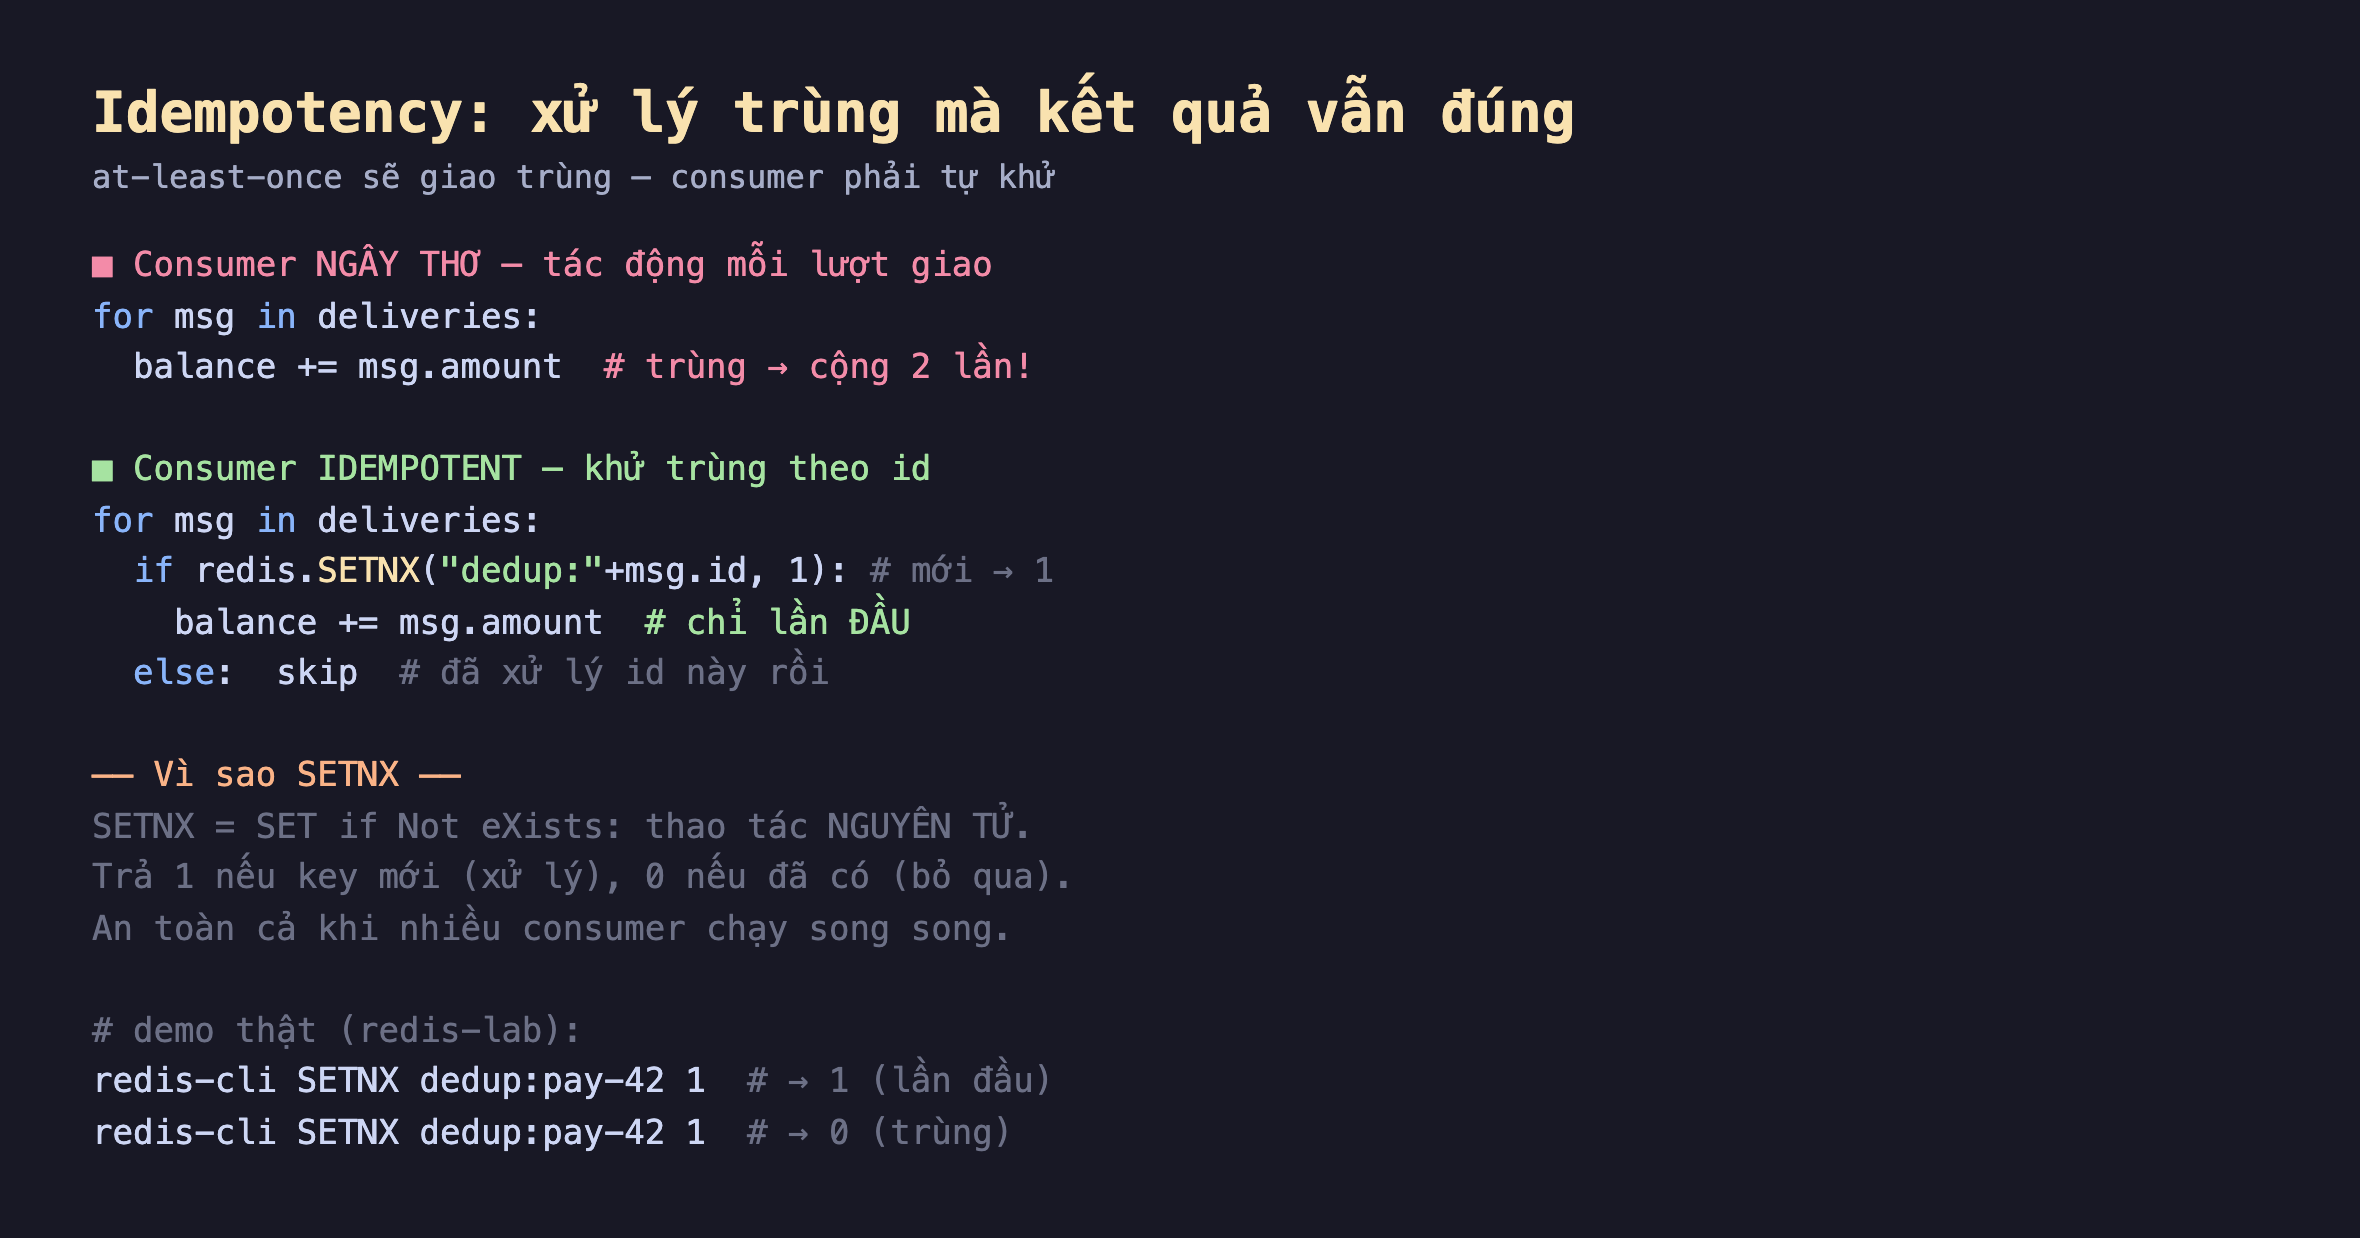
Hình 1: Consumer ngây thơ cộng cho mọi lượt giao (trùng → cộng hai lần); consumer idempotent dùng SETNX dedup:<id> để chỉ xử lý lần đầu cho mỗi id. SETNX nguyên tử nên an toàn cả khi nhiều consumer chạy song song — đúng một consumer "thắng" việc tạo key và xử lý.
Đo thật: trừ tiền hai lần vs khử trùng
Mình produce 1000 thanh toán (mỗi cái +100) vào kafka-lab, mô phỏng at-least-once đúng như bài 2 (consume hai lần không commit → 2000 lượt giao, 1000 id duy nhất — con số thật từ Kafka), rồi cho hai consumer xử lý cùng luồng trùng này, dùng redis-lab để khử trùng:
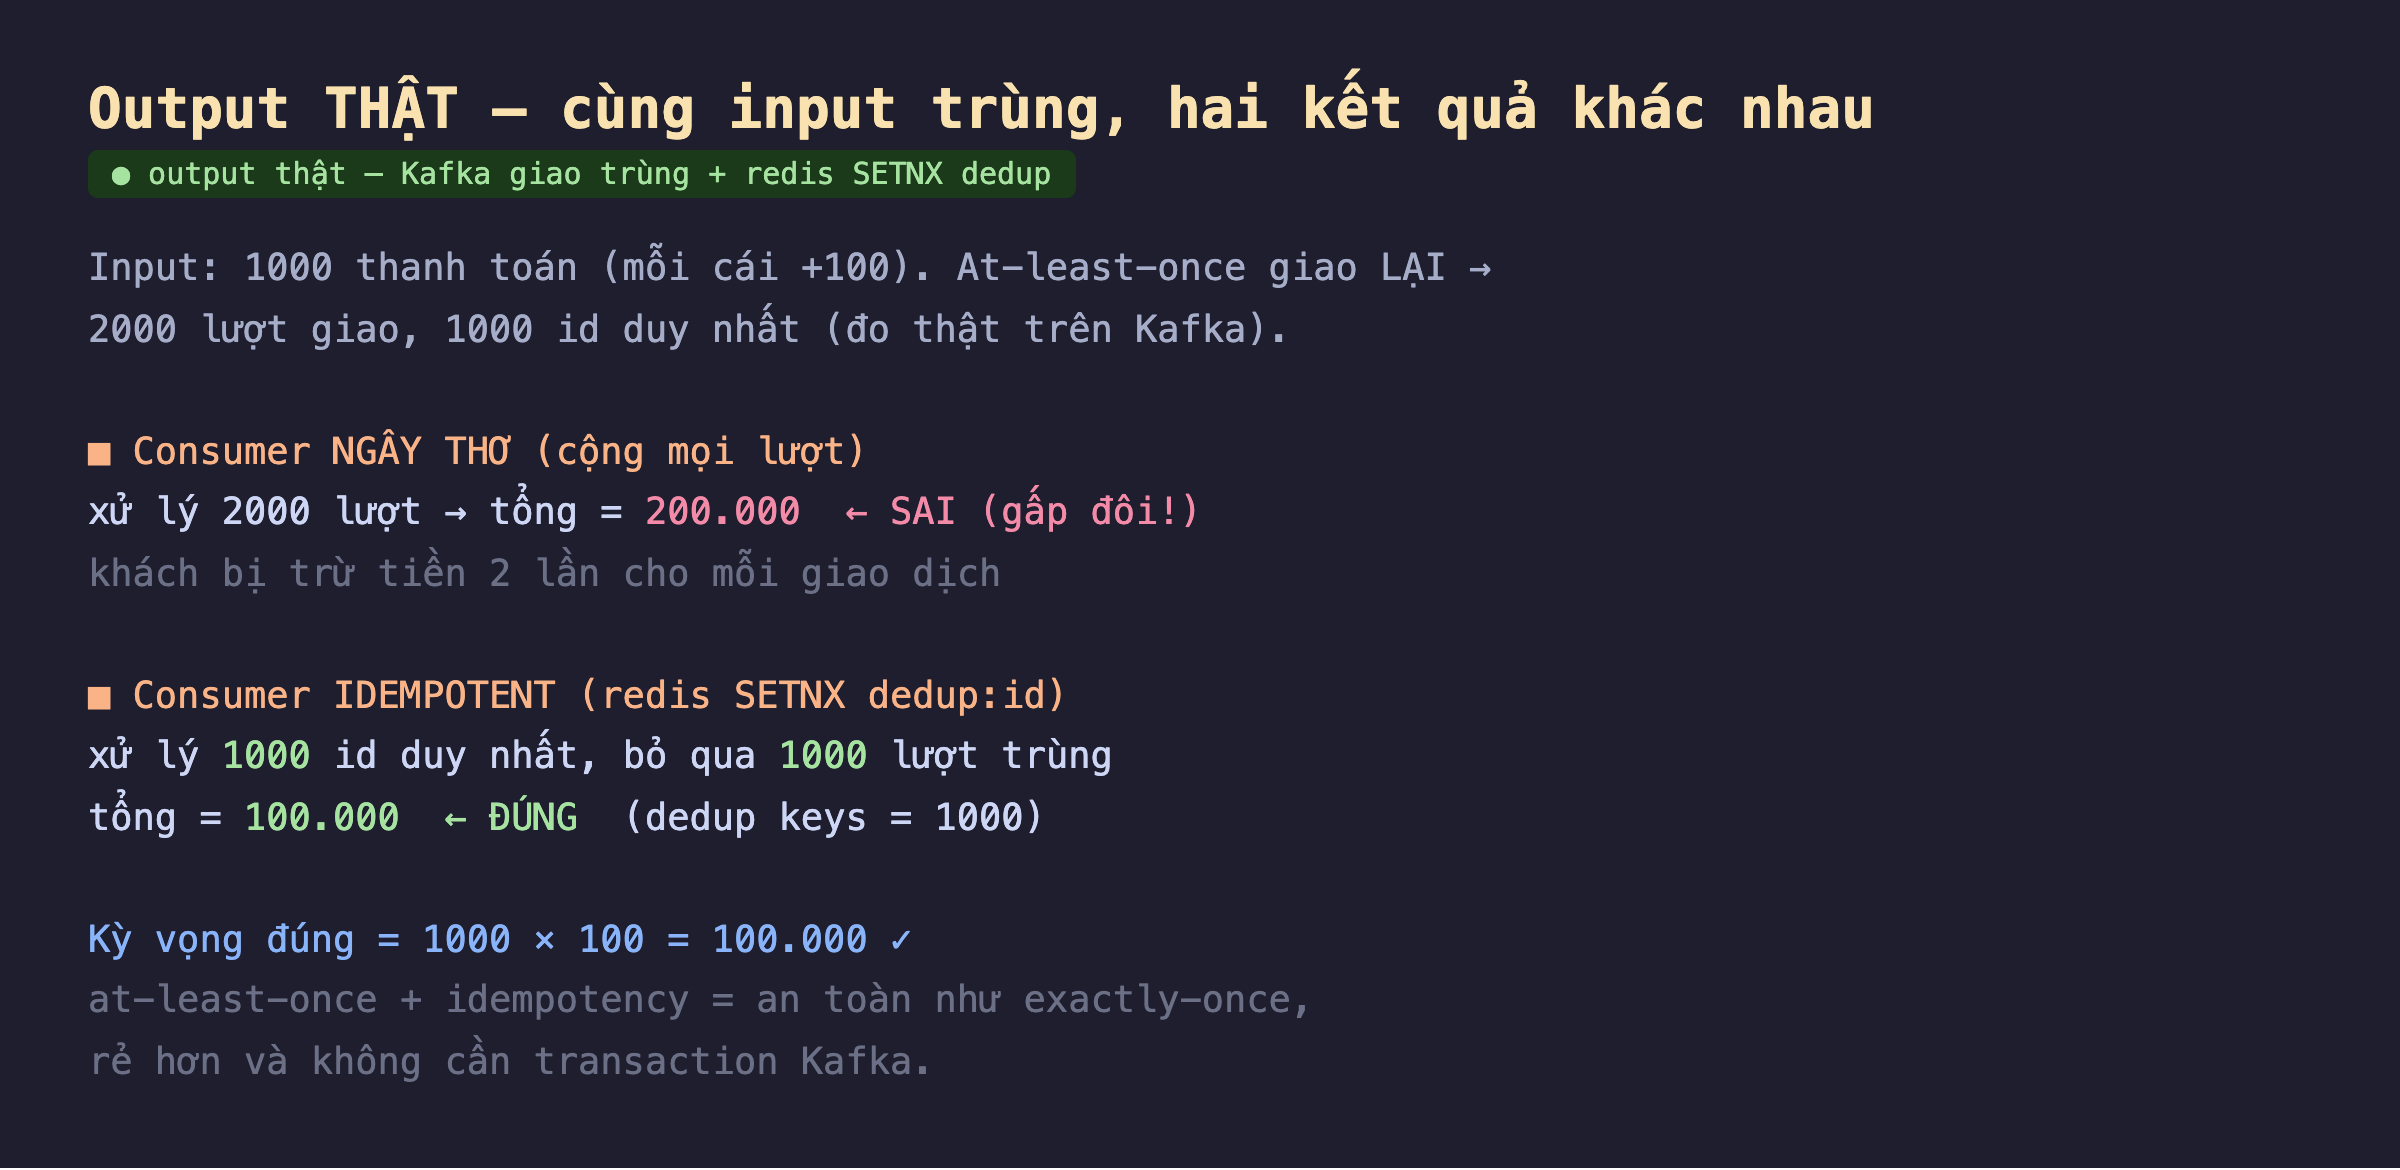
Hình 2: Kết quả thật. Cùng luồng 2000 lượt giao (1000 trùng): consumer ngây thơ cộng cho mọi lượt → tổng 200.000 (sai gấp đôi — khách bị trừ tiền hai lần). Consumer idempotent dùng redis SETNX xử lý đúng 1000 id duy nhất, bỏ qua 1000 lượt trùng → tổng 100.000 (đúng kỳ vọng 1000 × 100), với 1000 dedup key trong Redis.
Đọc kết quả:
- Ngây thơ → 200.000 (sai): consumer cộng amount cho mọi lượt nhận. Vì at-least-once giao 2000 lượt, nó cộng 2000 × 100 = 200.000. Trong một hệ thanh toán, đây là thảm hoạ: mỗi khách bị trừ tiền đúng hai lần, và không có lỗi nào báo — hệ vẫn "chạy bình thường", chỉ là số liệu sai.
- Idempotent → 100.000 (đúng): trước khi cộng, consumer gọi
SETNX dedup:<id>. Lần đầu thấy một id → key được tạo (trả 1) → cộng. Lần thứ hai thấy đúng id đó → key đã tồn tại (trả 0) → bỏ qua. Kết quả: đúng 1000 id được xử lý, 1000 lượt trùng bị chặn, tổng = 100.000 — đúng kỳ vọng. Redis giữ 1000 dedup key làm "trí nhớ" đã-xử-lý.
Điểm mấu chốt: cùng một input trùng, hai consumer cho hai kết quả khác hẳn — khác biệt nằm hoàn toàn ở việc có khử trùng hay không. Đây là lý do idempotency không phải tính năng "nên có" mà là bắt buộc cho mọi consumer at-least-once xử lý việc có tác động thật.
At-least-once + idempotency = exactly-once "thực dụng"
Nhớ lại bài 2: exactly-once đầy đủ của Kafka cần idempotent producer + transaction + read_committed, đắt và phức tạp. Idempotency ở consumer cho bạn kết quả tương đương — xử lý đúng một lần về mặt hiệu ứng — mà rẻ hơn nhiều: chỉ cần một dedup key và một phép SETNX. Đây là lý do công thức phổ biến nhất trong thực tế là at-least-once + consumer idempotent, không phải EOS. Nó còn mạnh hơn EOS của Kafka ở một điểm: idempotency bảo vệ cả khi consumer gọi ra hệ ngoài (API thanh toán, DB khác) — nơi transaction của Kafka không với tới được.
Đánh đổi cần cân nhắc
Dedup key phải sống đủ lâu — và điều đó tốn bộ nhớ. Redis giữ 1000 key cho demo nhỏ; hệ thật xử lý hàng triệu message/ngày sẽ tích hàng triệu dedup key. Phải đặt TTL cho key (ví dụ SET dedup:id 1 EX 86400 — giữ 1 ngày) để Redis không phình vô hạn. Nhưng TTL quá ngắn thì một message trùng đến sau khi key hết hạn sẽ lọt qua. Chọn TTL = khoảng thời gian tối đa một message có thể bị giao lại (thường vài giờ tới vài ngày) — đánh đổi giữa bộ nhớ và cửa sổ bảo vệ.
Kiểm-tra-rồi-xử-lý vẫn có khe hở nếu không cẩn thận. SETNX giải quyết đua tranh ở bước ghi dấu, nhưng nếu consumer SETNX thành công rồi crash trước khi xử lý xong, id đã bị đánh dấu "đã xử lý" mà thực ra chưa → message bị mất (quay về lỗi at-most-once!). Giải pháp chắc hơn: xử lý và ghi dấu trong cùng một giao dịch với hệ đích (ví dụ ghi kết quả + dedup key vào cùng một transaction DB), hoặc đánh dấu sau khi xử lý xong với một cơ chế chịu được crash. Dedup bằng Redis riêng lẻ hợp khi "xử lý trùng nhẹ hơn mất".
Chọn đúng id khử trùng là phần khó nhất. Demo dùng id thanh toán có sẵn. Nhưng nếu message không mang id duy nhất ổn định thì sao? Dùng offset Kafka làm id không đúng (cùng một sự kiện nghiệp vụ có thể vào nhiều offset khi retry producer). Phải chọn một business key thật sự định danh sự kiện nghiệp vụ (id đơn hàng + loại thao tác), không phải định danh lần truyền. Chọn sai id là dedup sai — hoặc chặn nhầm message hợp lệ, hoặc để lọt trùng thật.
Ba ý mang về
- Consumer at-least-once bắt buộc phải idempotent: đo thật cùng luồng 2000 lượt giao (1000 trùng), consumer ngây thơ cho 200.000 (trừ tiền hai lần), consumer idempotent cho 100.000 đúng — khác biệt nằm hoàn toàn ở việc khử trùng theo id.
- SETNX cho dedup nguyên tử, rẻ và an toàn song song: đo thật
SETNX dedup:<id>xử lý đúng 1000 id duy nhất và chặn 1000 lượt trùng; at-least-once + idempotency cho hiệu ứng exactly-once mà rẻ hơn transaction, lại bảo vệ được cả khi gọi hệ ngoài. - TTL, thứ tự ghi dấu, và chọn id là ba cái bẫy: dedup key cần TTL để khỏi phình nhưng đủ dài để phủ cửa sổ giao lại; ghi dấu trước khi xử lý mà crash thì mất message; và phải chọn business key định danh sự kiện, không phải lần truyền.
Nguồn
- Confluent — Idempotent consumers & deduplication: https://developer.confluent.io/courses/kafka-streams/exactly-once/
- Redis docs — SET / SETNX: https://redis.io/docs/latest/commands/set/
- Gregor Hohpe — Enterprise Integration Patterns: Idempotent Receiver: https://www.enterpriseintegrationpatterns.com/patterns/messaging/IdempotentReceiver.html
Phần sau ta xử lý một bug tinh vi hơn: dual-write — khi service vừa ghi database vừa publish message, hai thao tác không nguyên tử dẫn tới lệch dữ liệu; outbox pattern giải quyết thế nào, demo thật.
