Mạng không đáng tin. Server đôi khi quá tải, restart, mất gói — những lỗi tạm thời mà thử lại một chút sau là thành công. Cách ngây thơ là viết vòng lặp retry bằng tay ở mỗi chỗ gọi: for i:=0;i<3;i++ { ... }. Nhưng làm thế là lặp code khắp nơi, dễ quên backoff (retry dồn dập làm server đang hồi phục chết hẳn), và dễ retry nhầm lỗi không nên retry. gRPC có cơ chế retry policy khai bằng cấu hình — framework tự thử lại, với backoff, chỉ cho các lỗi bạn chỉ định. Dựa trên status code chuẩn (bài trước), client biết lỗi nào đáng thử lại. Bài này (phần 9 loạt gRPC nâng cao) chạy thật để thấy retry tự động và vì sao chỉ retry lỗi tạm thời.
Retry policy: cấu hình, không phải code
gRPC cho khai retry qua service config (một JSON), truyền khi tạo client. Không cần viết vòng lặp retry trong logic:
cfg := `{"methodConfig":[{
  "name":[{"service":"demo.Svc"}],
  "retryPolicy":{
    "maxAttempts":4,                          // thử tối đa 4 lần
    "initialBackoff":"0.1s", "backoffMultiplier":2.0,   // chờ tăng dần
    "retryableStatusCodes":["UNAVAILABLE"]    // CHỈ retry code này
  }}]}`
grpc.NewClient(addr, grpc.WithDefaultServiceConfig(cfg))
Bốn tham số then chốt: maxAttempts (số lần thử tối đa), initialBackoff + backoffMultiplier (thời gian chờ giữa các lần, tăng dần để tránh dội server), và retryableStatusCodes (danh sách code được retry — chỉ những code tạm thời). gRPC tự lo phần còn lại: client gọi một lần, framework thử lại bên dưới tới khi OK hoặc hết lượt.
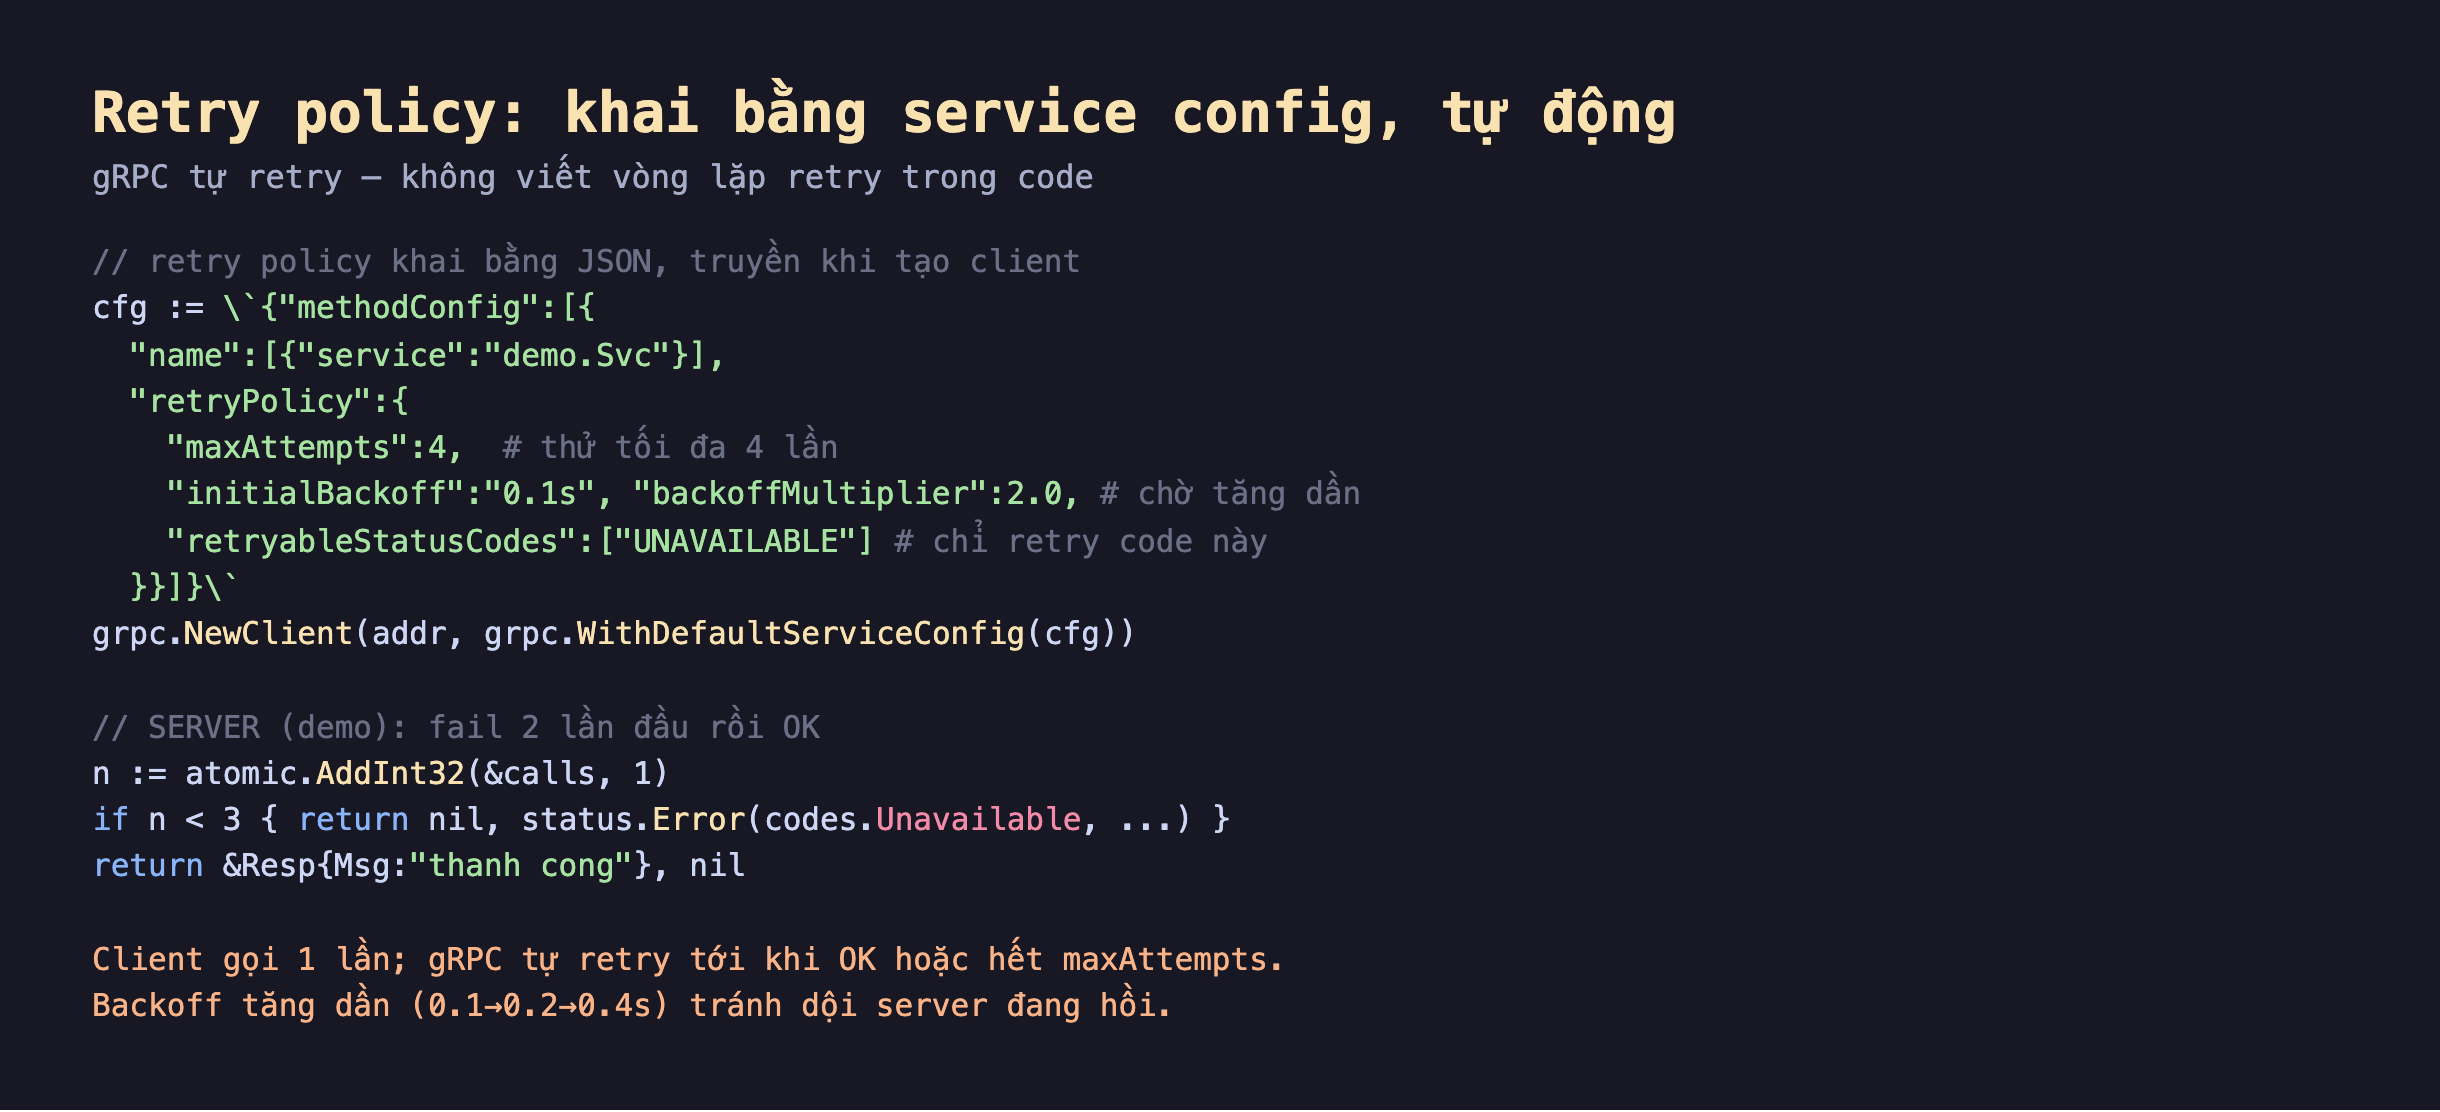
Hình 1: Retry policy khai bằng JSON service config, truyền qua WithDefaultServiceConfig. maxAttempts, initialBackoff+backoffMultiplier (backoff tăng dần), retryableStatusCodes (chỉ retry code tạm thời). Server demo fail 2 lần đầu với Unavailable rồi OK. Client gọi một lần; gRPC tự retry.
Đo thật: 3 lần gọi cho Flaky, 1 lần cho BadInput
Mình dùng counter thật trong server để đếm số lần nó thực sự bị gọi, trên go-lab:
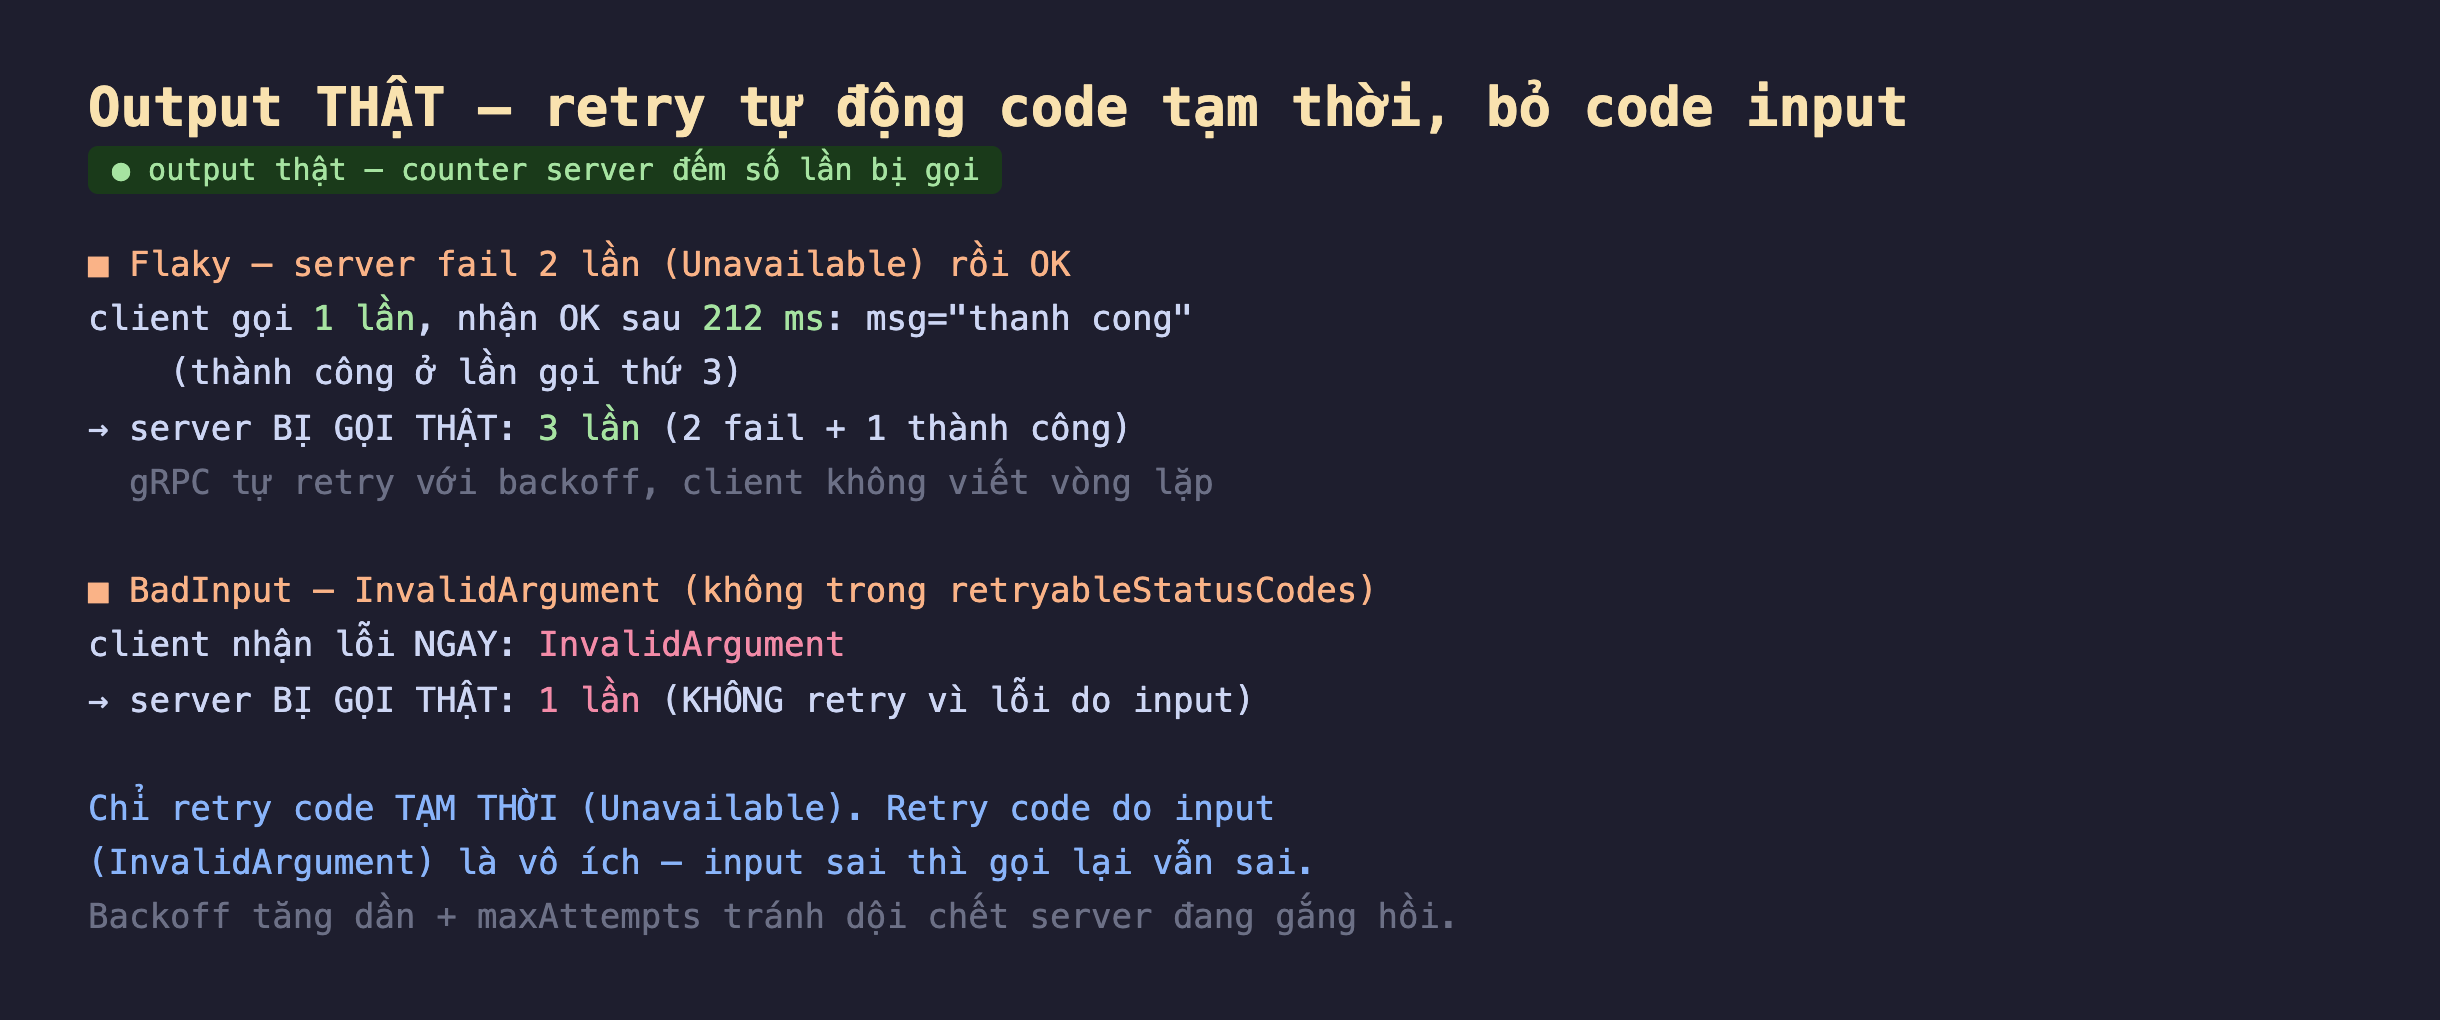
Hình 2: Kết quả thật. Flaky: server fail 2 lần (Unavailable) rồi OK; client gọi một lần, nhận OK sau 212ms (thành công ở lần gọi thứ 3) — server bị gọi thật 3 lần. BadInput: InvalidArgument không nằm trong retryableStatusCodes → client nhận lỗi ngay, server bị gọi thật 1 lần (không retry).
Đọc kết quả:
- Flaky → retry tự động, 3 lần gọi thật: server fail 2 lần đầu với
Unavailable, OK ở lần 3. Client chỉ gọi một lần trong code, nhưng counter server cho thấy nó thực sự bị gọi 3 lần — gRPC tự retry 2 lần. Client nhận OK sau 212ms (gồm backoff: ~0.1s sau fail 1 + ~0.2s sau fail 2). Không một dòng vòng lặp retry nào trong code client — toàn bộ do policy. Đây là điều cứu hệ khỏi lỗi tạm thời một cách trong suốt. - BadInput → không retry, 1 lần gọi thật: server trả
InvalidArgument— không nằm trongretryableStatusCodes. Client nhận lỗi ngay, counter server = 1 lần. gRPC không retry. Điều này đúng:InvalidArgumentnghĩa là input sai, gọi lại với cùng input sẽ vẫn sai — retry chỉ phí tài nguyên và làm chậm phản hồi lỗi cho client.
Thông điệp cốt lõi: retry policy tự động hoá việc thử lại với backoff, và phân biệt lỗi đáng retry (tạm thời) với lỗi vô ích retry (do input) — dựa trên chính status code chuẩn của bài trước. Counter server chứng minh bằng số thật: đúng 3 lần với Unavailable, đúng 1 lần với InvalidArgument.
Vì sao backoff tăng dần quan trọng
Chi tiết backoffMultiplier: 2.0 không phải trang trí. Nếu server đang quá tải và trả Unavailable, mà mọi client cùng retry ngay lập tức và dồn dập, chúng tạo một đợt tải mới dội vào server đang ngắc ngoải — làm nó chết hẳn (retry storm). Backoff tăng dần (0.1s → 0.2s → 0.4s) cho server thời gian thở giữa các đợt retry. Nâng cao hơn, nên thêm jitter (ngẫu nhiên hoá backoff một chút) để các client không retry đồng loạt cùng thời điểm — nếu không, dù có backoff, 1000 client vẫn dội cùng lúc. Backoff + jitter là khác biệt giữa retry cứu hệ và retry giết hệ.
Đánh đổi cần cân nhắc
Chỉ retry được thao tác idempotent — nếu không, retry gây tác dụng phụ trùng. Đây là ràng buộc quan trọng nhất. Retry một thao tác GET an toàn (đọc lại không hại). Nhưng retry một Charge (trừ tiền) có thể trừ hai lần nếu lần đầu thực ra đã thành công nhưng response bị mất trên đường về (client thấy Unavailable và retry). gRPC không biết thao tác có idempotent không — bạn phải tự đảm bảo: chỉ bật retry cho RPC idempotent, hoặc dùng idempotency key (nhớ loạt Message Queue) để thao tác chịu được retry. Bật retry cho thao tác có tác dụng phụ mà không idempotent là công thức gây lỗi dữ liệu.
Retry che giấu vấn đề và tăng tải ẩn. Retry làm lỗi tạm thời vô hình với người dùng — tốt cho trải nghiệm, nhưng cũng nghĩa là bạn không thấy server đang chập chờn nếu chỉ nhìn tỉ lệ lỗi phía client. Phải giám sát số lần retry (như một metric riêng) để biết hệ thực sự khoẻ hay đang được retry cứu liên tục. Ngoài ra, mỗi retry là một call thật — bật retry rộng rãi nhân tải lên server. maxAttempts giới hạn điều này, nhưng phải đặt hợp lý, không "cho chắc" quá cao.
retryableStatusCodes phải chọn cẩn thận. Chỉ các code thật sự tạm thời mới nên vào danh sách: Unavailable (server tạm sập), đôi khi ResourceExhausted (nhưng cần backoff dài). Không bao giờ retry InvalidArgument, NotFound, PermissionDenied, FailedPrecondition — chúng không tự khỏi khi gọi lại. Và cẩn thận với DeadlineExceeded: retry nó có thể vượt deadline tổng thể. Danh sách code sai làm retry hoặc vô dụng (retry cái không khỏi) hoặc nguy hiểm (retry cái gây tác dụng phụ).
Ba ý mang về
- Retry policy tự động hoá, khai bằng config không phải code: đo thật server fail 2 lần (Unavailable) rồi OK; client gọi một lần, gRPC tự retry → server bị gọi thật 3 lần, client nhận OK sau 212ms với backoff — không viết vòng lặp retry nào.
- Chỉ retry lỗi tạm thời, dựa trên status code: đo thật InvalidArgument (không trong retryableStatusCodes) → server chỉ bị gọi 1 lần, không retry — vì gọi lại input sai vẫn sai; code chuẩn (bài trước) là nền để phân biệt.
- Backoff + idempotency là điều kiện để retry an toàn: backoff tăng dần (+jitter) tránh retry storm dội chết server; chỉ retry thao tác idempotent (hoặc dùng idempotency key) để không gây tác dụng phụ trùng; và giám sát số lần retry để không che giấu hệ đang chập chờn.
Nguồn
- gRPC docs — Retry (service config): https://grpc.io/docs/guides/retry/
- gRFC A6 — Client retries design: https://github.com/grpc/proposal/blob/master/A6-client-retries.md
- AWS — Exponential backoff and jitter: https://aws.amazon.com/blogs/architecture/exponential-backoff-and-jitter/
Phần sau ta cân bằng tải phía client: nhiều backend, gRPC rải request thế nào qua chúng, và đo thật phân bổ request khi có nhiều server cùng phục vụ.
