Một trong những lỗi vận hành nguy hiểm nhất của hệ phân tán là call không có thời hạn. Client gọi server, server gọi database, database kẹt — và nếu không ai đặt giới hạn thời gian, call treo vô hạn. Mỗi call treo giữ một kết nối, một goroutine, một chút bộ nhớ; hàng nghìn call treo làm cạn tài nguyên và sập cả service (hiện tượng cascading failure). gRPC giải quyết bằng deadline: client đặt một thời hạn, gRPC lan truyền nó xuống toàn bộ chuỗi call qua context, và cả client lẫn server dừng khi hết hạn. Bài này (phần 7 loạt gRPC nâng cao) chạy thật để thấy deadline huỷ call đúng lúc và cứu tài nguyên server.
Cơ chế: context mang deadline, cả hai bên tôn trọng
gRPC dùng context.Context của Go làm phương tiện mang deadline:
- Client đặt deadline:
context.WithTimeout(ctx, 100ms)tạo một context sẽ "hết hạn" sau 100ms. Truyền context này vào call. - gRPC lan truyền: khi gửi request, gRPC tự gửi deadline sang server (qua một header metadata
grpc-timeout). Server nhận được một context cũng mang deadline đó. - Server tôn trọng: handler kiểm
ctx.Done()(hoặcctx.Err()) để dừng sớm khi deadline hết hoặc client huỷ — thay vì chạy tiếp cho một kết quả không ai nhận.
// CLIENT đặt deadline qua context
ctx, cancel := context.WithTimeout(ctx, 100*time.Millisecond)
defer cancel()
resp, err := client.Work(ctx, req)   // gRPC tự gửi deadline sang server

// SERVER kiểm ctx để dừng sớm khi bị huỷ
func Work(ctx, r) (*Resp, error) {
    select {
    case <-time.After(500*ms):       // việc chậm
        return &Resp{...}, nil
    case <-ctx.Done():               // client huỷ / hết deadline
        return nil, ctx.Err()        // dừng, không phí tài nguyên
    }
}
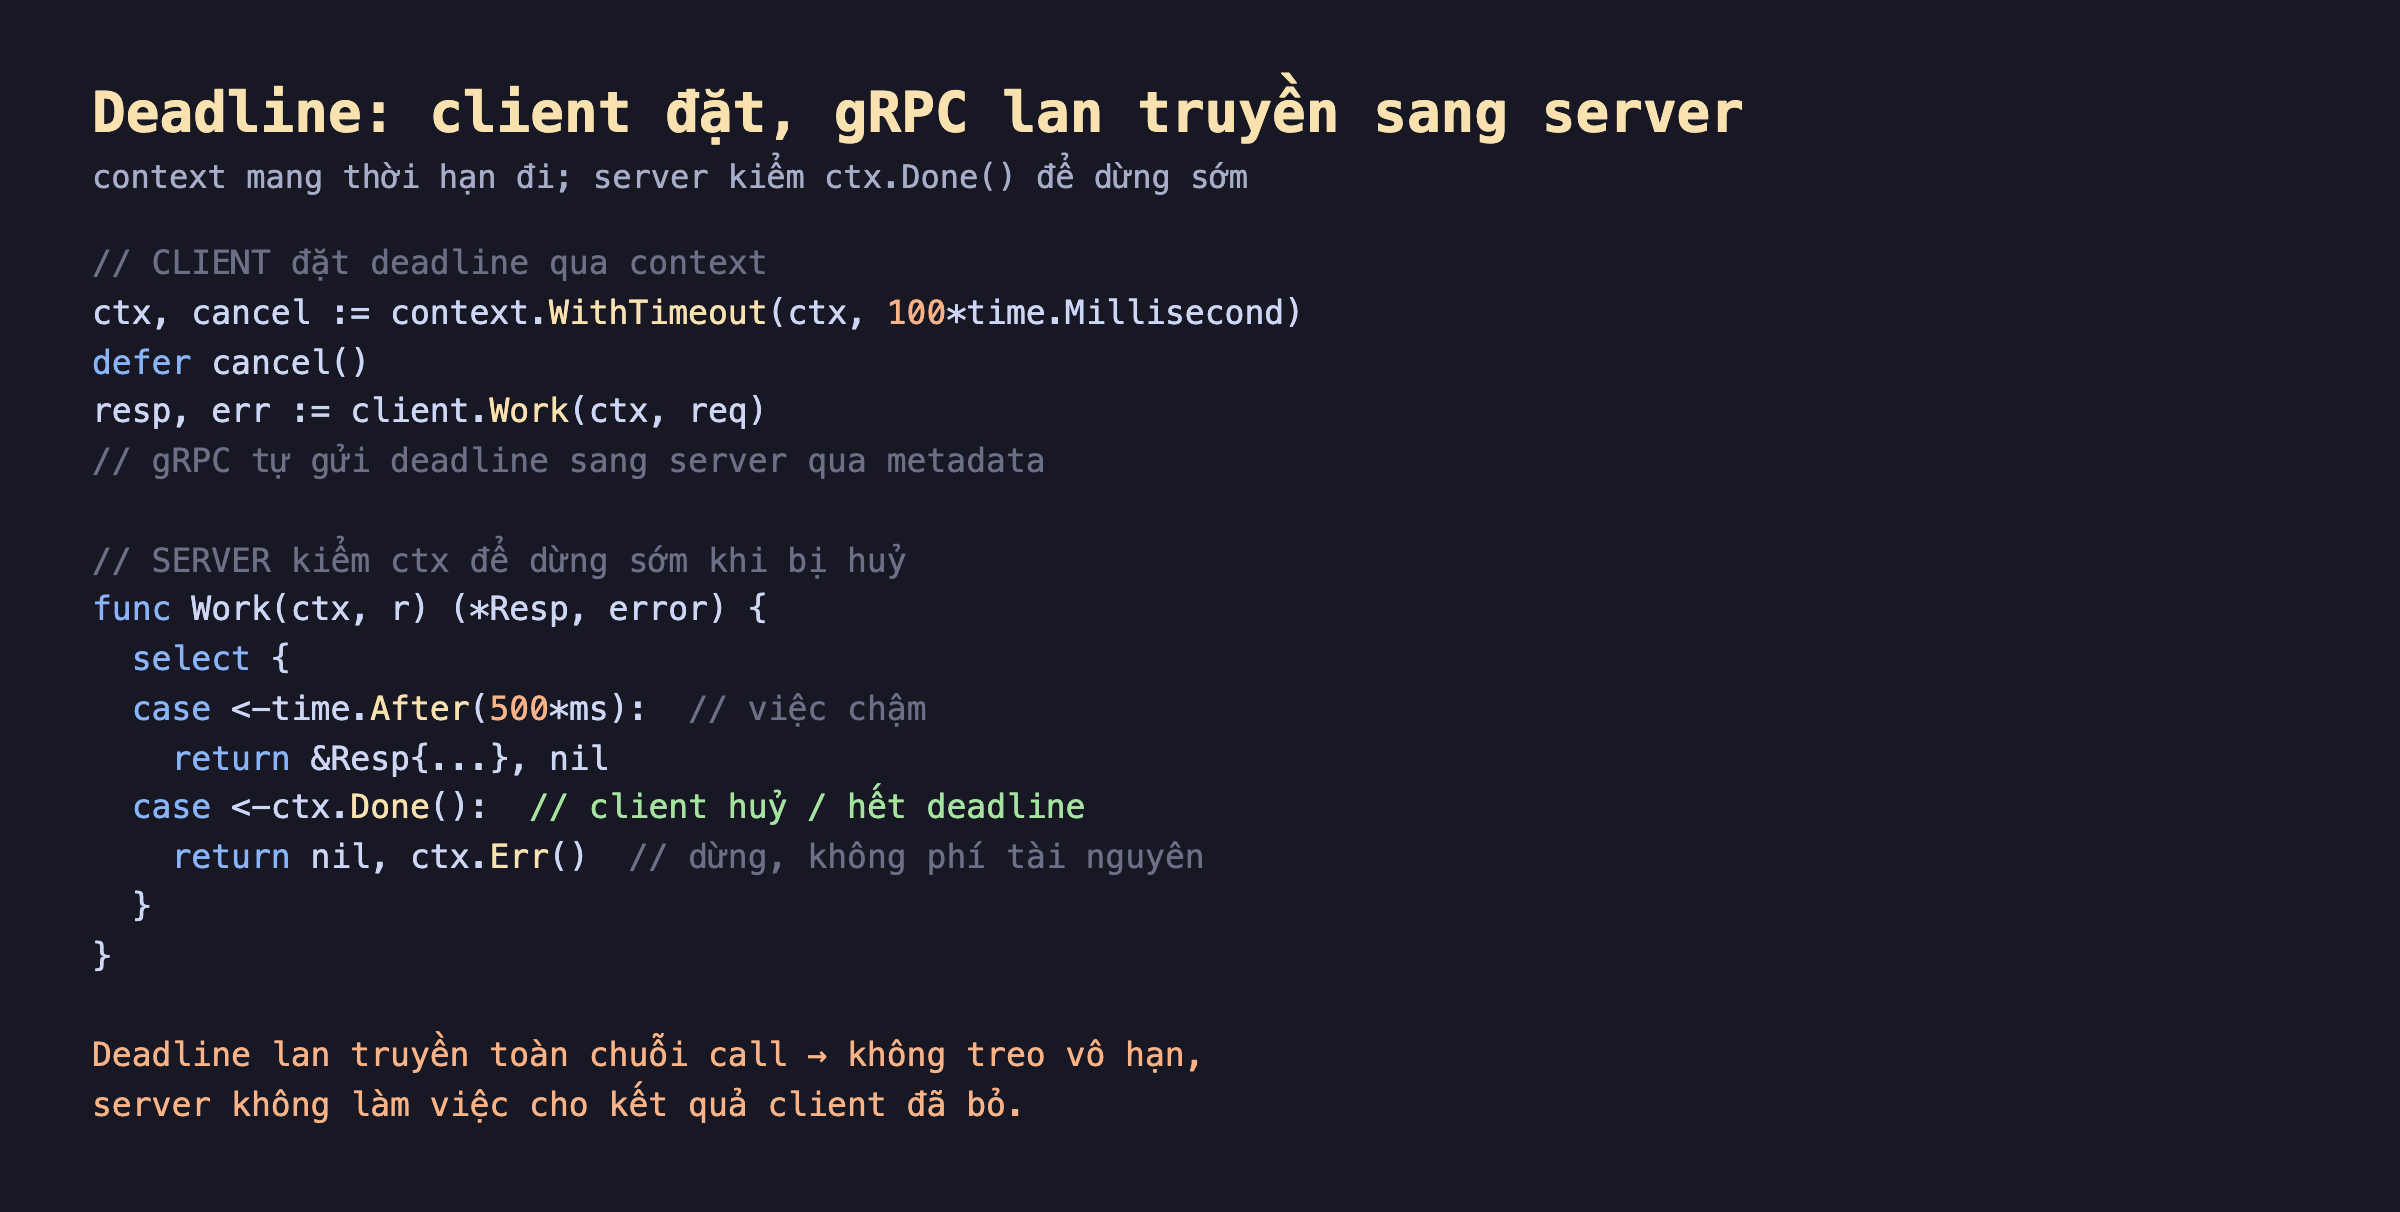
Hình 1: Client đặt deadline bằng context.WithTimeout; gRPC tự gửi deadline sang server qua metadata. Server dùng select trên ctx.Done() để dừng sớm khi hết hạn/bị huỷ, trả ctx.Err() thay vì chạy tiếp. Deadline lan truyền toàn chuỗi call.
Đo thật: huỷ sau 101ms, không chờ 500ms
Mình dựng server có handler tốn 500ms trên go-lab, gọi với hai deadline khác nhau:
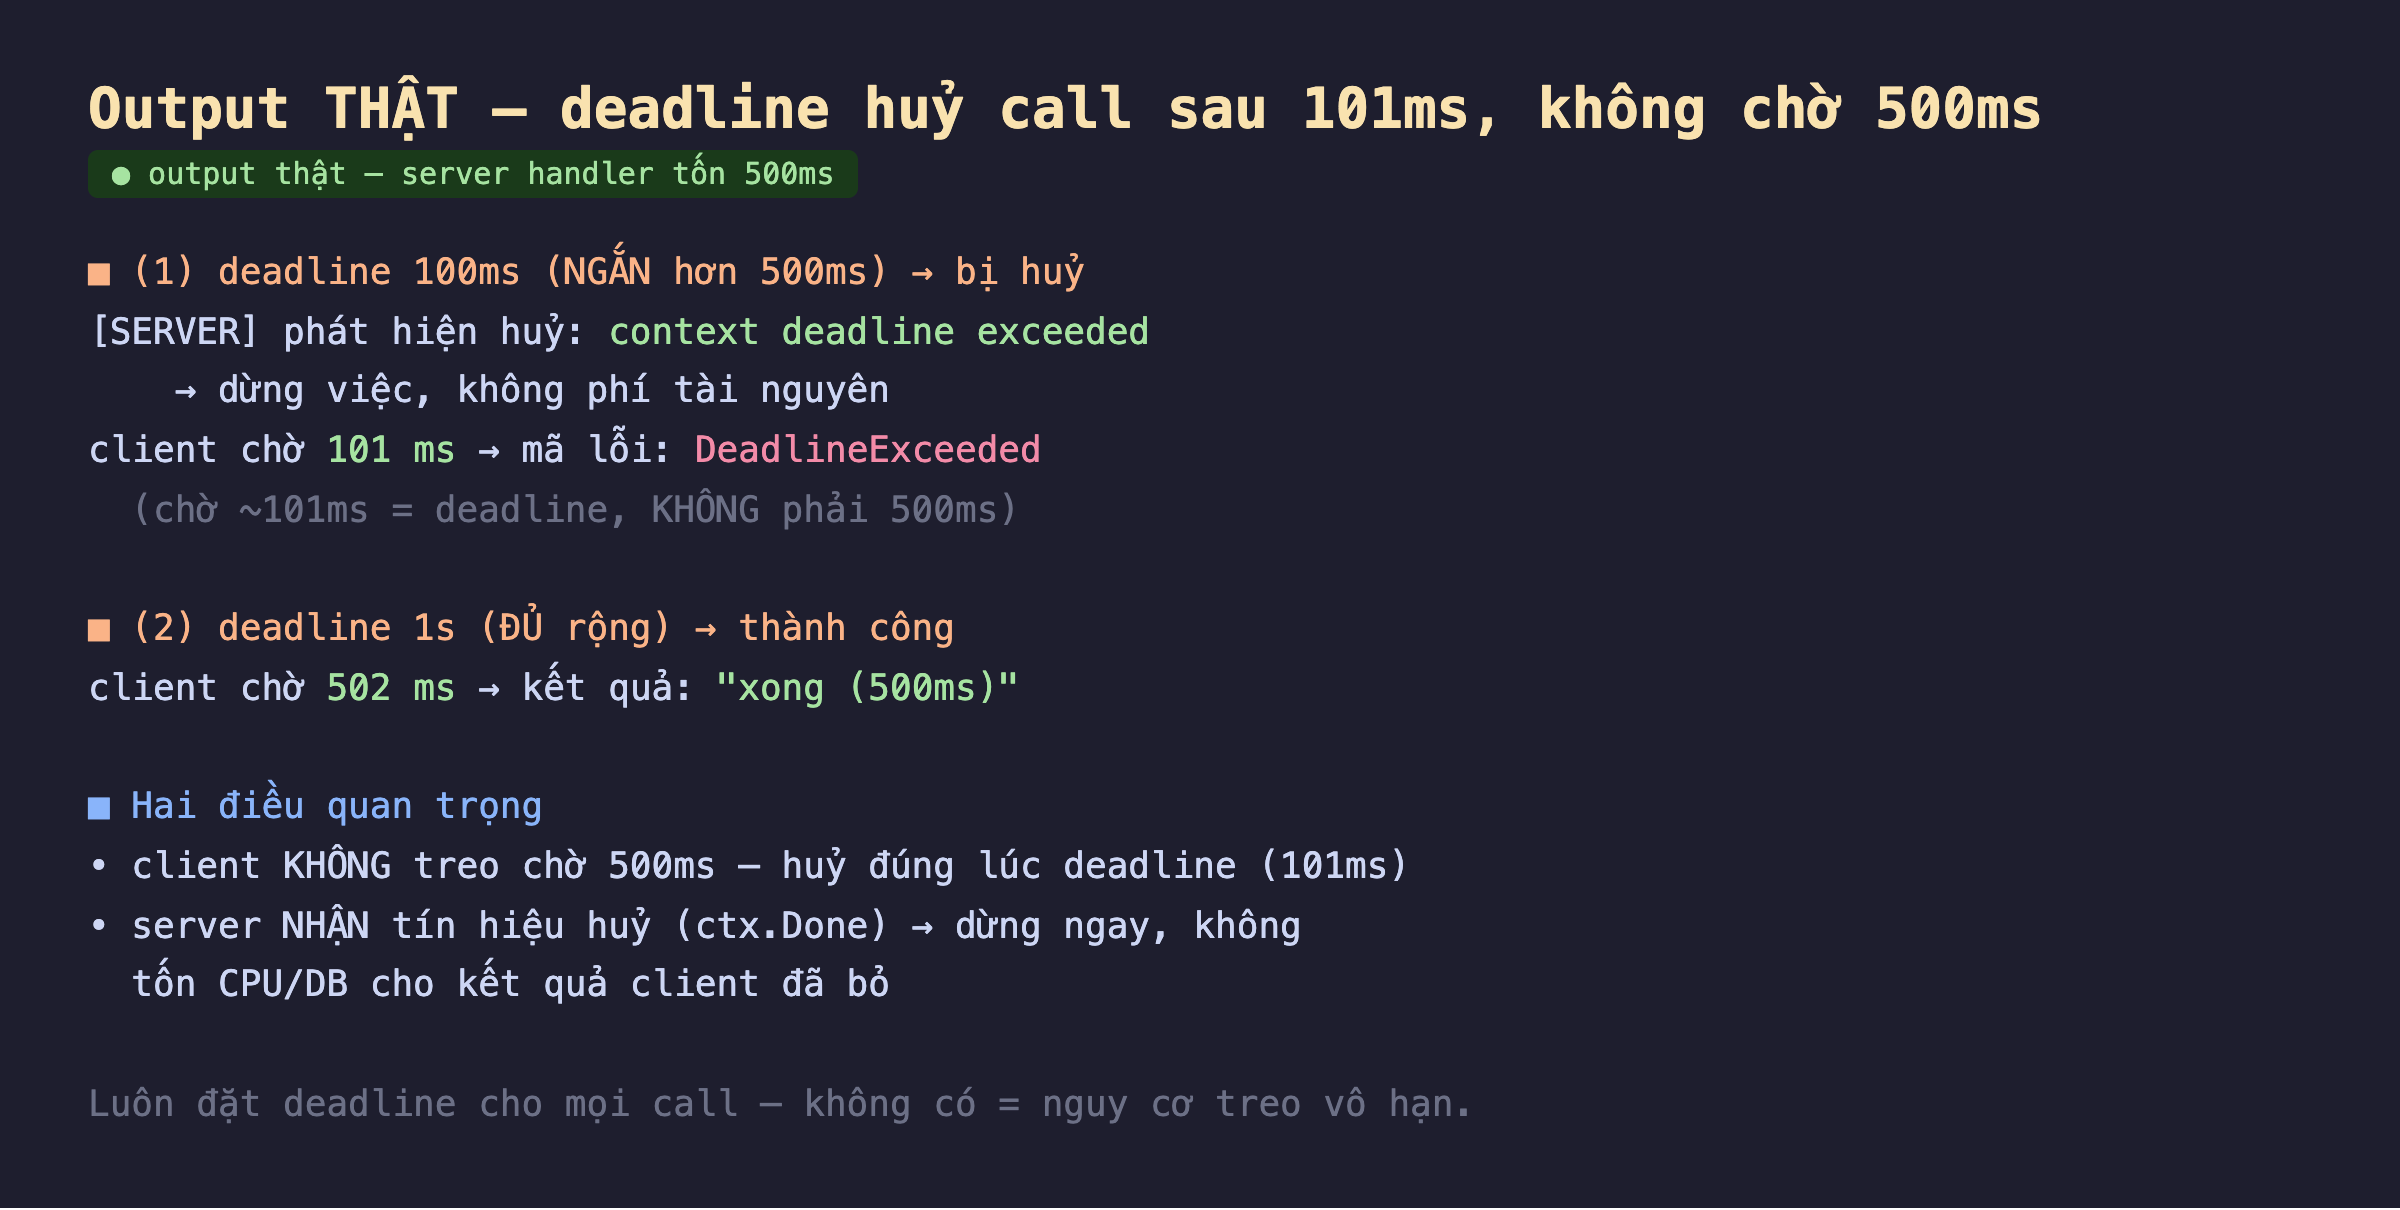
Hình 2: Kết quả thật. (1) Deadline 100ms < handler 500ms: client chờ 101ms rồi nhận DeadlineExceeded — không chờ hết 500ms; server phát hiện context deadline exceeded và dừng việc ngay. (2) Deadline 1s đủ rộng: client chờ 502ms và nhận kết quả thành công.
Đọc kết quả:
- Deadline 100ms → huỷ sau 101ms: handler cần 500ms, nhưng client đặt deadline 100ms. Kết quả: client chờ đúng ~101ms (bằng deadline, cộng chút overhead) rồi nhận mã lỗi
DeadlineExceeded— không treo chờ 500ms. Đây là điều cứu client khỏi treo: dù server chậm bao nhiêu, client tự giải phóng đúng lúc deadline. - Server dừng sớm, không phí tài nguyên: điểm quan trọng không kém. Server nhận context cũng mang deadline (nhờ gRPC lan truyền), và
selectcủa nó bắt đượcctx.Done()— nó in "phát hiện huỷ: context deadline exceeded" và dừng ngay, không chạy nốt 500ms. Nghĩa là server không tốn CPU/DB để tính một kết quả mà client đã bỏ. Đây là khác biệt lớn so với client timeout "mù" (client bỏ chờ nhưng server vẫn cày): deadline của gRPC dừng cả hai bên. - Deadline đủ rộng → thành công: với deadline 1s, call hoàn tất bình thường sau 502ms, trả "xong (500ms)". Deadline không làm chậm call hợp lệ — nó chỉ chặn call vượt ngưỡng.
Thông điệp cốt lõi: deadline biến một call "có thể treo vô hạn" thành một call "chắc chắn kết thúc trong X thời gian", và quan trọng là nó dừng cả server chứ không chỉ client — tiết kiệm tài nguyên toàn hệ.
Vì sao deadline lan truyền quan trọng hơn timeout thường
Điểm làm deadline của gRPC mạnh hơn timeout thủ công là lan truyền xuyên chuỗi. Trong một hệ microservice, A gọi B, B gọi C, C gọi database. Nếu A đặt deadline 1s, deadline đó đi theo qua B, C, tới database — và nếu đã dùng hết 1s ở A→B, thì C và database biết "chỉ còn 0ms" và không bắt đầu việc vô ích. Đây là deadline propagation: toàn chuỗi cùng tôn trọng một thời hạn tuyệt đối. Timeout thủ công ở từng service không làm được điều này — mỗi service đặt timeout riêng, cộng dồn lại có thể vượt xa thời gian client thực sự chờ. gRPC truyền deadline như một thời điểm tuyệt đối, nên mọi mắt xích đều biết chính xác còn bao lâu.
Đánh đổi cần cân nhắc
Không đặt deadline là lỗi, nhưng đặt sai cũng hại. Deadline quá ngắn huỷ nhầm call hợp lệ (call chậm bình thường bị cắt → lỗi giả, retry thừa). Deadline quá dài thì gần như vô dụng (vẫn treo lâu mới huỷ). Chọn deadline dựa trên p99 thực tế của endpoint (nhớ loạt Observability) cộng biên an toàn — không đoán. Và deadline nên đặt ở client ngoài cùng (nơi biết người dùng chịu chờ bao lâu), rồi để nó lan truyền xuống, thay vì mỗi service tự đặt.
Server PHẢI chủ động kiểm ctx — gRPC không tự dừng handler. Một hiểu lầm nguy hiểm: nghĩ rằng đặt deadline thì server tự bị dừng. Không. gRPC báo cho server qua ctx.Done(), nhưng nếu handler không kiểm ctx (ví dụ chạy một vòng lặp CPU hoặc query DB không truyền ctx), nó vẫn chạy nốt dù client đã bỏ. Phải truyền ctx xuống mọi lời gọi con (query DB với ctx, HTTP request với ctx) để huỷ lan tới tận cùng. Deadline chỉ hiệu quả nếu code hợp tác kiểm tra nó.
Cancellation cũng xảy ra khi client chủ động huỷ, không chỉ hết deadline. ctx.Done() kích hoạt cả khi deadline hết và khi client gọi cancel() (ví dụ user đóng tab, hoặc một trong nhiều call song song đã đủ kết quả). Server xử lý cả hai giống nhau: thấy ctx.Done() thì dừng. Đây là công cụ mạnh để huỷ việc không cần nữa — nhưng cũng nghĩa là handler phải sẵn sàng bị huỷ bất cứ lúc nào, không giả định sẽ chạy tới hết.
Ba ý mang về
- Deadline huỷ call đúng lúc, không treo vô hạn: đo thật deadline 100ms huỷ call sau 101ms (không chờ handler 500ms), client nhận DeadlineExceeded; deadline đủ rộng thì call hợp lệ vẫn thành công bình thường.
- Deadline dừng cả server, không chỉ client: đo thật server phát hiện
context deadline exceededquactx.Done()và dừng việc ngay — không tốn CPU/DB cho kết quả client đã bỏ, khác hẳn client timeout "mù" mà server vẫn cày. - Lan truyền xuyên chuỗi, nhưng cần code hợp tác: deadline đi theo context qua A→B→C như thời điểm tuyệt đối nên toàn chuỗi cùng tôn trọng; server phải chủ động kiểm ctx và truyền ctx xuống mọi call con — đặt deadline ở client ngoài cùng theo p99 thực tế.
Nguồn
- gRPC docs — Deadlines: https://grpc.io/docs/guides/deadlines/
- gRPC blog — Deadlines (best practices): https://grpc.io/blog/deadlines/
- Go docs — context package: https://pkg.go.dev/context
Phần sau ta mổ xẻ error model của gRPC: status code chuẩn và details có cấu trúc — cách trả lỗi để client biết chính xác chuyện gì xảy ra và xử lý đúng, thay vì một chuỗi lỗi mơ hồ.
