Test đơn vị có một điểm mù cố hữu: nó chỉ kiểm những input mà lập trình viên nghĩ tới. Bạn viết TestFoo với vài trường hợp bạn tưởng tượng ra — nhưng chính những input bạn không tưởng tượng (chuỗi rỗng, ký tự lạ, số âm, dữ liệu méo mó) mới là nơi bug ẩn nấp. Fuzzing giải đúng điểm mù đó: nó tự sinh hàng triệu input, kể cả những cái kỳ quái nhất, và chạy hàm của bạn với chúng để tìm panic hoặc kết quả sai.
Từ Go 1.18, fuzzing được tích hợp thẳng vào go test — không cần thư viện ngoài. Bạn viết một hàm Fuzz trong file _test.go, và go test -fuzz sẽ dùng coverage để dò thông minh, đột biến input, tìm ca làm sập, rồi tự rút gọn nó xuống tối giản. Bài này để fuzzing thật tìm ra một bug mà test thường bỏ lọt, và đo nó nhanh thế nào.
Hàm có bug ẩn
func TachKhuVuc(s string) (string, string) {
	parts := strings.Split(s, ":")
	return parts[0], parts[1] // BUG: parts[1] panic nếu không có ":"
}
Hàm tách "HN:5" thành ("HN", "5"). Trông ổn — nhưng nếu chuỗi không có dấu :, thì strings.Split trả về slice chỉ một phần tử, và parts[1] gây panic "index out of range".
Test thường: chỉ phủ case "đẹp"
func TestTachKhuVuc(t *testing.T) {
	khu, so := TachKhuVuc("HN:5") // chỉ thử input hợp lệ
	if khu != "HN" || so != "5" { t.Fatalf(...) }
}
Test này PASS — và đó chính là vấn đề. Lập trình viên viết test với input họ hình dung ("HN:5"), không bao giờ chạm tới input thiếu :. Bug lọt lưới hoàn toàn dù có test.
Fuzz test: máy tự sinh input
func FuzzTachKhuVuc(f *testing.F) {
	f.Add("HN:5")   // seed corpus: vài ví dụ mở đầu
	f.Add("SG:10")
	f.Fuzz(func(t *testing.T, s string) {
		TachKhuVuc(s) // gọi với vô số input tự sinh; panic = lỗi
	})
}
Khác biệt cốt lõi: f.Add cung cấp vài hạt giống (seed) mở đầu, còn f.Fuzz nhận một hàm được gọi với vô số input tự sinh. Engine fuzzing đột biến các seed, đo coverage sau mỗi lần chạy, giữ lại những input mở ra nhánh code mới — dò thông minh cho tới khi tìm được input làm hàm sập.
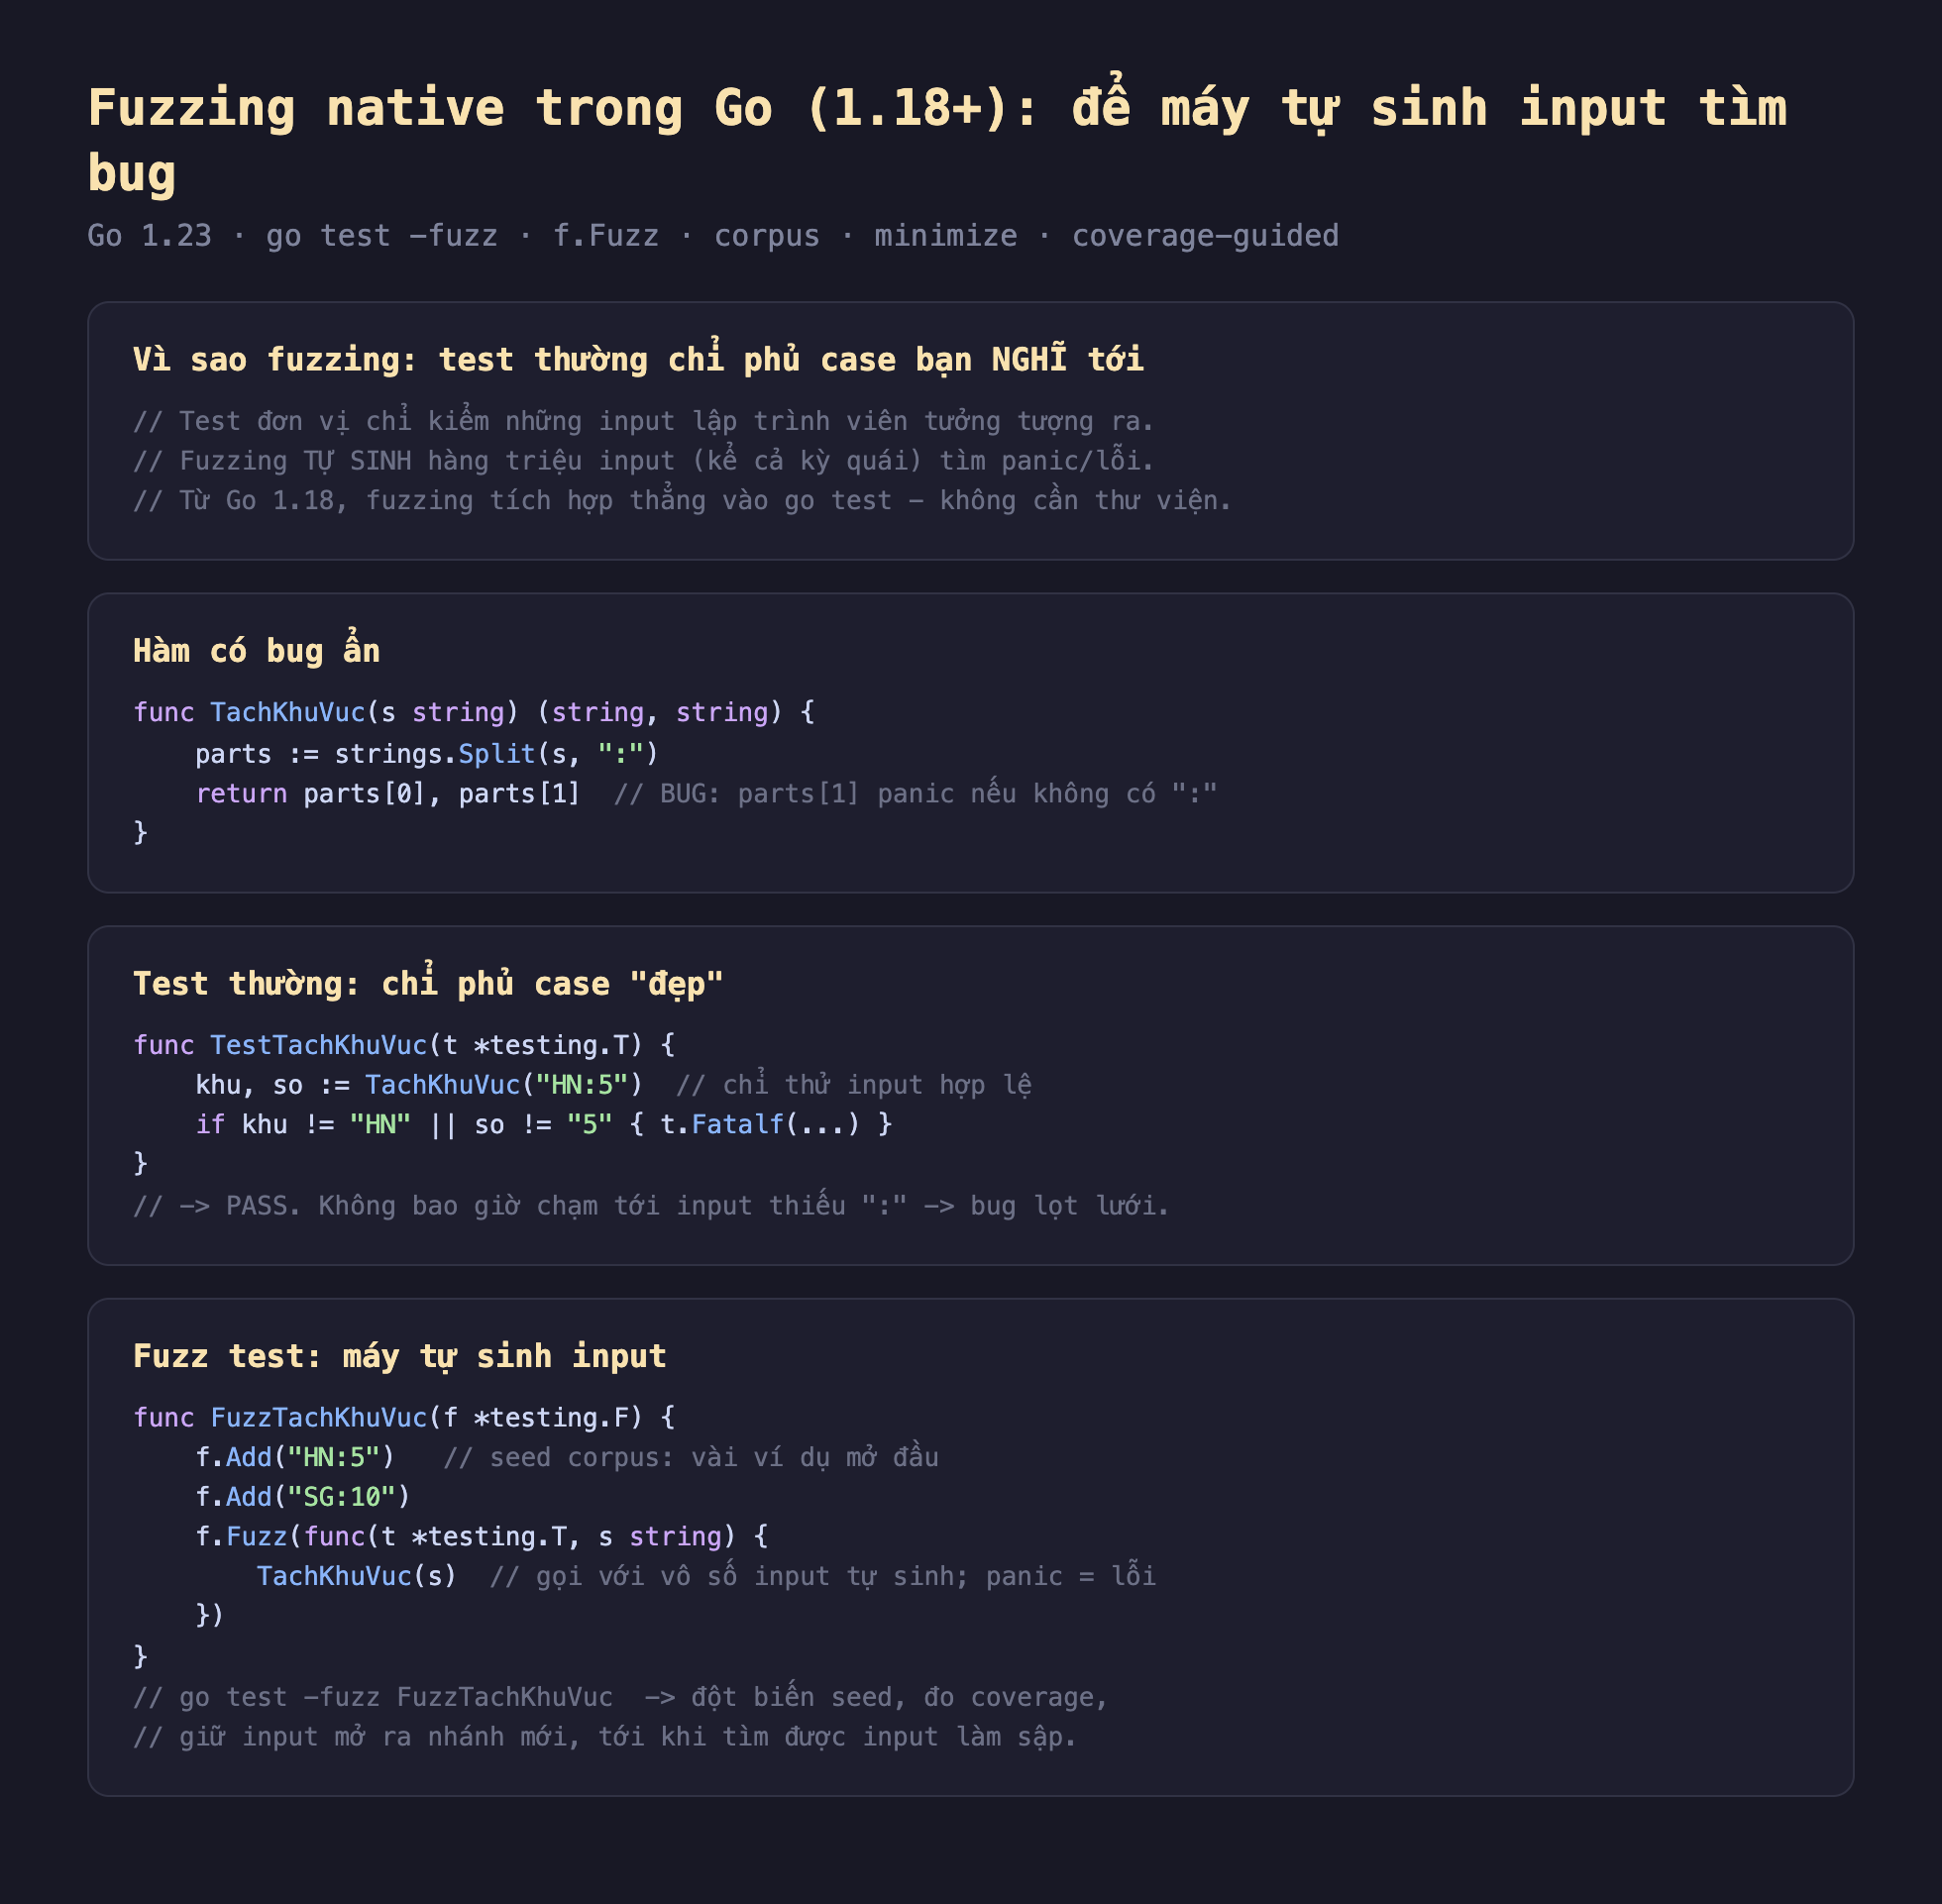
Hình 1: Fuzzing native trong Go — hàm TachKhuVuc có bug ẩn khi thiếu :; test thường chỉ thử "HN:5" nên PASS và bỏ lọt bug; fuzz test dùng f.Fuzz để engine tự sinh vô số input dò tìm ca làm sập.
Đo thật: fuzz tìm bug trong dưới 1 giây
Chạy test thường trước:
$ go test -run TestTachKhuVuc
PASS  ok  example.com/fz  0.001s
XANH — bug vẫn ẩn. Giờ chạy fuzzing:
$ go test -fuzz FuzzTachKhuVuc
fuzz: elapsed: 0s, gathering baseline coverage: 3/3 completed,
      now fuzzing with 10 workers
fuzz: elapsed: 0s, minimizing
--- FAIL: FuzzTachKhuVuc
panic: runtime error: index out of range [1] with length 1
    example.com/fz.TachKhuVuc(...) /work/t116/code.go:9
Engine đo coverage nền của các seed, rồi bắt đầu fuzz với 10 worker song song, và tìm ra panic gần như tức thì (elapsed 0s). Nó chỉ đúng dòng gây lỗi — code.go:9, tức parts[1].
Điều tinh vi nhất là bước minimize — Go tự rút gọn input làm sập xuống tối giản nhất:
Failing input written to testdata/fuzz/FuzzTachKhuVuc/771e938e...
$ cat testdata/fuzz/FuzzTachKhuVuc/771e938e...
go test fuzz v1
string("0")   // input tối giản: chuỗi "0" - KHÔNG có dấu ":"
Input làm sập được rút xuống chỉ còn "0" — một chuỗi một ký tự không có :. strings.Split("0", ":") trả ["0"] chỉ một phần tử, nên parts[1] vượt biên. Đây là reproducer tối giản, dễ hiểu ngay nguyên nhân. Và Go lưu nó vào testdata/fuzz/ — từ lần chạy go test sau, ca này tự động được chạy lại như một test hồi quy, chống bug tái phát.
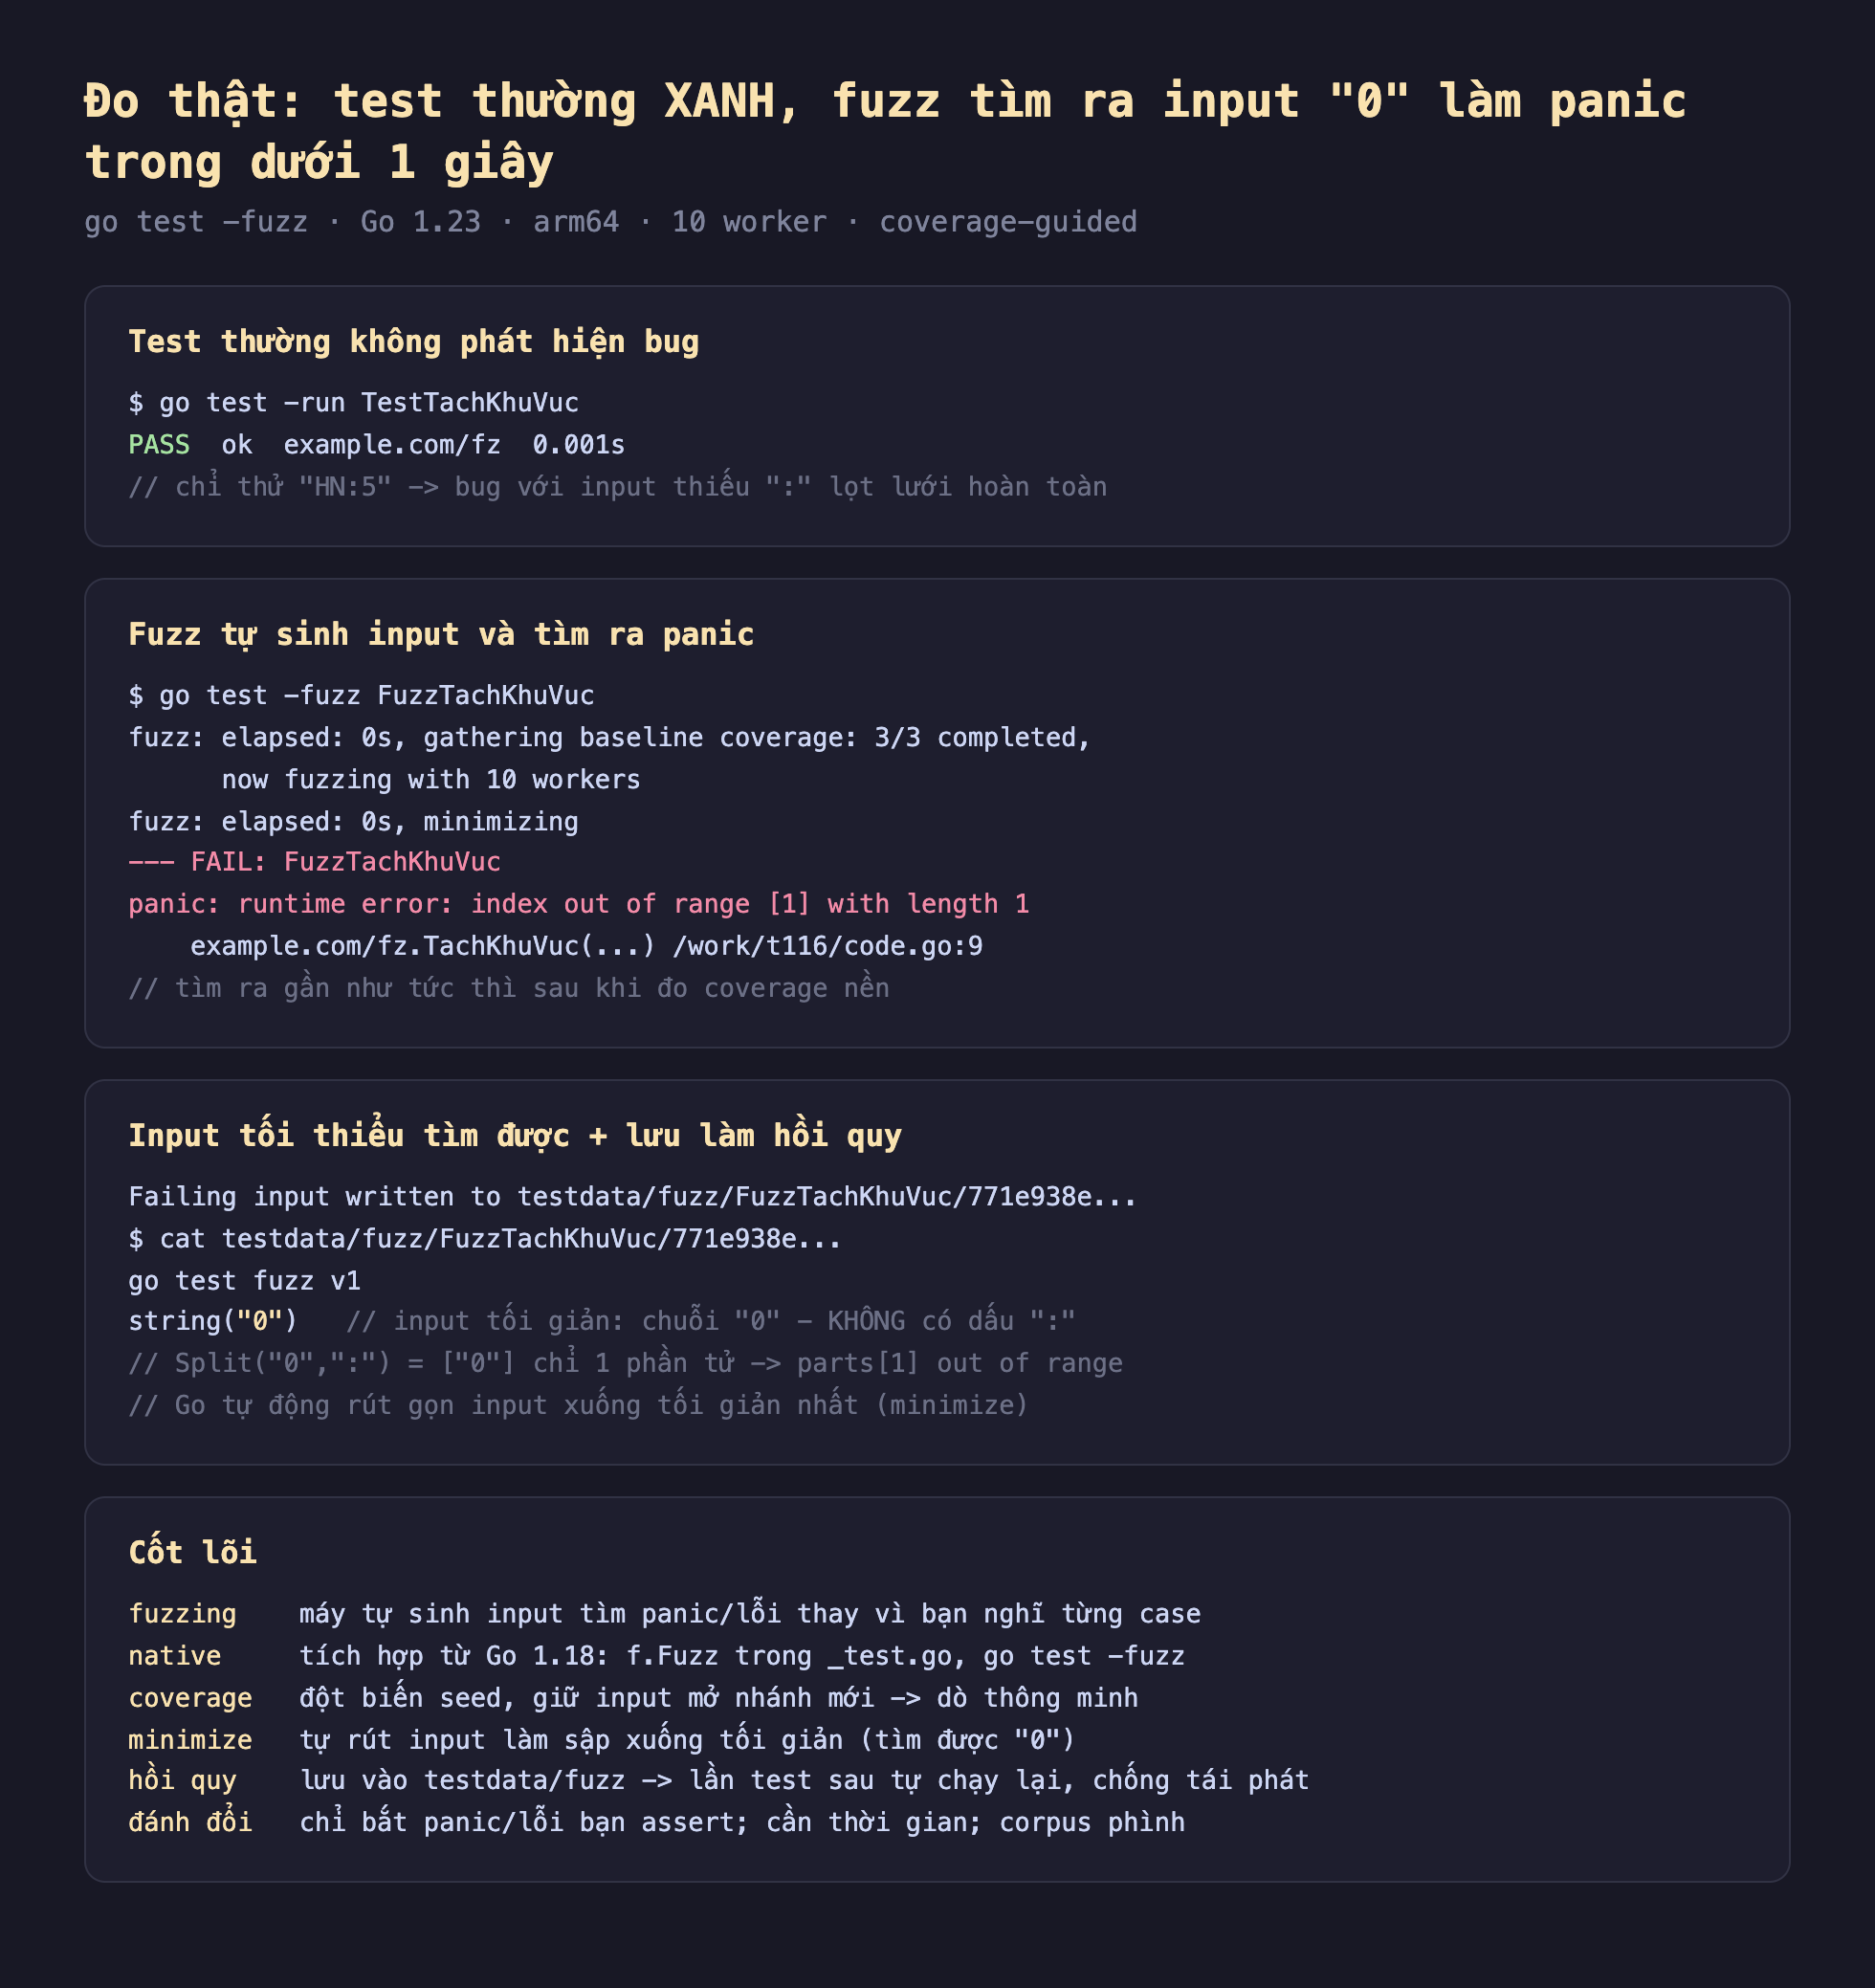
Hình 2: Đo thật — test thường XANH (bỏ lọt bug), fuzz tìm ra panic index out of range [1] with length 1 tại code.go:9 gần như tức thì với 10 worker; input làm sập được minimize xuống chuỗi "0" và lưu vào testdata/fuzz/ làm test hồi quy.
Đánh đổi cần cân nhắc
Fuzzing chỉ bắt được lỗi mà nó nhận ra là lỗi. Mặc định nó bắt panic và các lỗi runtime (index out of range, nil dereference). Nhưng một hàm trả về kết quả sai mà không panic thì fuzzing không tự biết — trừ khi bạn thêm kiểm chứng (assertion) trong hàm fuzz. Mẫu mạnh nhất là property-based hoặc round-trip: ví dụ "encode rồi decode phải ra input gốc" — fuzz với đủ input, nếu round-trip sai ở đâu, t.Errorf báo. Chủ đề bài sau. Fuzzing trần chỉ tìm crash; kết hợp với assertion mới tìm được lỗi logic.
Fuzzing cần thời gian và không bao giờ "xong". Không như test đơn vị chạy một lần rồi dừng, fuzzing chạy cho tới khi bạn dừng (-fuzztime giới hạn) hoặc tìm được lỗi. Trong CI thường chạy fuzz một khoảng ngắn (vài giây đến vài phút) như một lớp kiểm tra bổ sung; tìm bug sâu cần chạy lâu hơn (hàng giờ). Bug ở đây tìm ra tức thì vì nó nông; bug sâu ẩn sau nhiều nhánh cần engine dò lâu hơn nhiều.
Corpus phình theo thời gian. Engine lưu mọi input "thú vị" (mở nhánh coverage mới) vào cache corpus ($GOCACHE/fuzz). Corpus này lớn dần và giúp fuzz lần sau bắt đầu từ trạng thái đã khám phá — tốt cho hiệu quả nhưng chiếm dung lượng. Còn các input làm sập (trong testdata/fuzz/) thì commit vào repo làm test hồi quy; đừng xóa chúng.
Ba ý mang về
- Fuzzing tìm bug ở những input bạn không nghĩ tới — điểm mù cố hữu của test đơn vị: đo thật, một hàm có test XANH vẫn ẩn bug panic khi thiếu
:, và fuzz tìm ra input làm sập gần như tức thì với 10 worker song song, chỉ đúng dòng lỗi. - Native từ Go 1.18, coverage-guided và tự minimize: viết
f.Fuzztrong_test.go, chạygo test -fuzz— engine đột biến seed theo coverage, rút input làm sập xuống tối giản (tìm được"0"), và lưu vàotestdata/fuzz/làm test hồi quy tự chạy lại. - Nêu rõ giới hạn: fuzzing trần chỉ bắt panic/lỗi runtime — muốn tìm lỗi logic phải thêm assertion (property/round-trip, bài sau); nó cần thời gian và không bao giờ "xong" nên CI thường chạy giới hạn; corpus phình dần theo thời gian.
Bài tập làm thử
Bài 1 (đọc hiểu). Cho hàm sau, hãy chỉ ra chính xác input nào sẽ gây panic và giải thích tại sao:
func TachKhuVuc(s string) (string, string) {
	parts := strings.Split(s, ":")
	return parts[0], parts[1]
}
Đáp án
Bất kỳ chuỗi nào không chứa dấu : sẽ gây panic, ví dụ input "0" hoặc chuỗi rỗng "". Lý do: strings.Split(s, ":") khi s không có : sẽ trả về một slice chỉ có một phần tử (chính s), nên truy cập parts[1] vượt biên slice, gây panic "index out of range [1] with length 1" — đúng như bài đo được với input tối giản "0".
Bài 2 (sửa lỗi). Đoạn mã sau viết fuzz test nhưng thiếu seed corpus ban đầu. Bổ sung ít nhất một seed hợp lý theo mẫu của bài.
func FuzzTachKhuVuc(f *testing.F) {
	f.Fuzz(func(t *testing.T, s string) {
		TachKhuVuc(s)
	})
}
Đáp án
Thiếu f.Add(...) để cung cấp seed corpus — các ví dụ mở đầu giúp engine fuzzing bắt đầu đột biến từ đó thay vì hoàn toàn ngẫu nhiên. Theo mẫu bài:
func FuzzTachKhuVuc(f *testing.F) {
	f.Add("HN:5")
	f.Add("SG:10")
	f.Fuzz(func(t *testing.T, s string) {
		TachKhuVuc(s)
	})
}
Không có seed vẫn chạy được (engine tự sinh), nhưng seed tốt (mẫu hợp lệ thực tế) giúp engine dò coverage hiệu quả hơn ngay từ đầu.
Bài 3 (vận dụng thực tế). Đội của bạn viết một hàm parse chuỗi cấu hình dạng key=value và muốn dùng fuzzing để tìm bug. Sau khi chạy go test -fuzz, engine tìm ra một input làm hàm chạy chậm bất thường (không panic, không lỗi) nhưng trả về kết quả "hợp lý". Fuzzing trần có phát hiện được vấn đề "kết quả sai nhưng không sập" này không? Vì sao?
Đáp án
Không, fuzzing trần chỉ bắt panic và lỗi runtime (index out of range, nil dereference...). Bài nói rõ: "một hàm trả về kết quả sai mà không panic thì fuzzing không tự biết — trừ khi bạn thêm kiểm chứng (assertion) trong hàm fuzz." Muốn phát hiện lỗi logic (kết quả sai nhưng không sập), cần thêm assertion vào hàm fuzz, hoặc chuyển sang property-based testing (chủ đề bài kế tiếp) với các tính chất như round-trip.
Bài 4 (bẫy/đánh đổi). Sau khi fuzzing tìm ra bug và Go tự động lưu ca lỗi vào testdata/fuzz/FuzzTachKhuVuc/771e938e..., một thành viên trong nhóm đề xuất xóa file này đi vì "đã sửa bug rồi, không cần nữa". Đây có phải quyết định đúng theo bài không?
Đáp án
Không đúng. Bài nhấn mạnh: "các input làm sập (trong testdata/fuzz/) thì commit vào repo làm test hồi quy; đừng xóa chúng." File này trở thành một test hồi quy tự động chạy lại mỗi lần go test — nếu ai đó vô tình sửa code làm bug tái xuất hiện, test này sẽ bắt được ngay lập tức. Xóa nó đi là mất lưới an toàn chống bug tái phát mà chính vì tìm ra được input tối giản (minimize) này mới có giá trị.
Bài 5 (đọc hiểu output Go). Từ log đo thật: panic: runtime error: index out of range [1] with length 1 và tệp golden chứa string("0"). Giải thích cụ thể tại sao strings.Split("0", ":") cho ra một slice có độ dài 1, và điều đó dẫn tới lỗi index cụ thể như thế nào.
Đáp án
strings.Split("0", ":") tìm dấu phân cách : trong chuỗi "0" nhưng không tìm thấy, nên theo hành vi của strings.Split, nó trả về toàn bộ chuỗi gốc như một slice chỉ chứa một phần tử: ["0"] (độ dài 1). Khi hàm TachKhuVuc cố truy cập parts[1] (phần tử thứ hai, chỉ số 1), nhưng slice chỉ có độ dài 1 (chỉ số hợp lệ duy nhất là 0), Go runtime phát hiện truy cập vượt biên và panic với thông báo chính xác "index out of range [1] with length 1" — khớp hoàn toàn với log đo được.
Phần sau ta nâng fuzzing lên tầng mạnh hơn: property-based testing trong Go — thay vì kiểm từng ví dụ, ta khẳng định các tính chất luôn đúng (round-trip, bất biến) và để máy tìm phản ví dụ.
