Bài escape analysis đã dùng allocs/op để đo số lần thoát heap. Nhưng con số đó chỉ đáng tin khi benchmark được viết đúng — và cực kỳ dễ viết sai. Một benchmark có thể tự tin báo "0 cấp phát" trong khi hàm thực sự cấp 1KB mỗi lần, chỉ vì bạn quên một dòng. Bài này mổ xẻ hai cái bẫy phổ biến nhất, đo trực tiếp cách chúng làm benchmark nói dối, và cách viết benchmark cấp phát mà bạn có thể tin.
Hai con số: B/op và allocs/op
Khi chạy go test -bench=. -benchmem, mỗi dòng kết quả có thêm hai cột:
B/op: số byte trung bình được cấp phát trên heap cho mỗi thao tác (mỗi vòng lặpb.N).allocs/op: số lần gọi bộ cấp phát heap cho mỗi thao tác.
allocs/op thường quan trọng hơn B/op khi tối ưu, vì mỗi lần cấp phát là một lần chạm allocator + một mẩu việc cho GC về sau. Giảm allocs/op từ 3 xuống 0 thường tăng tốc rõ hơn giảm B/op.
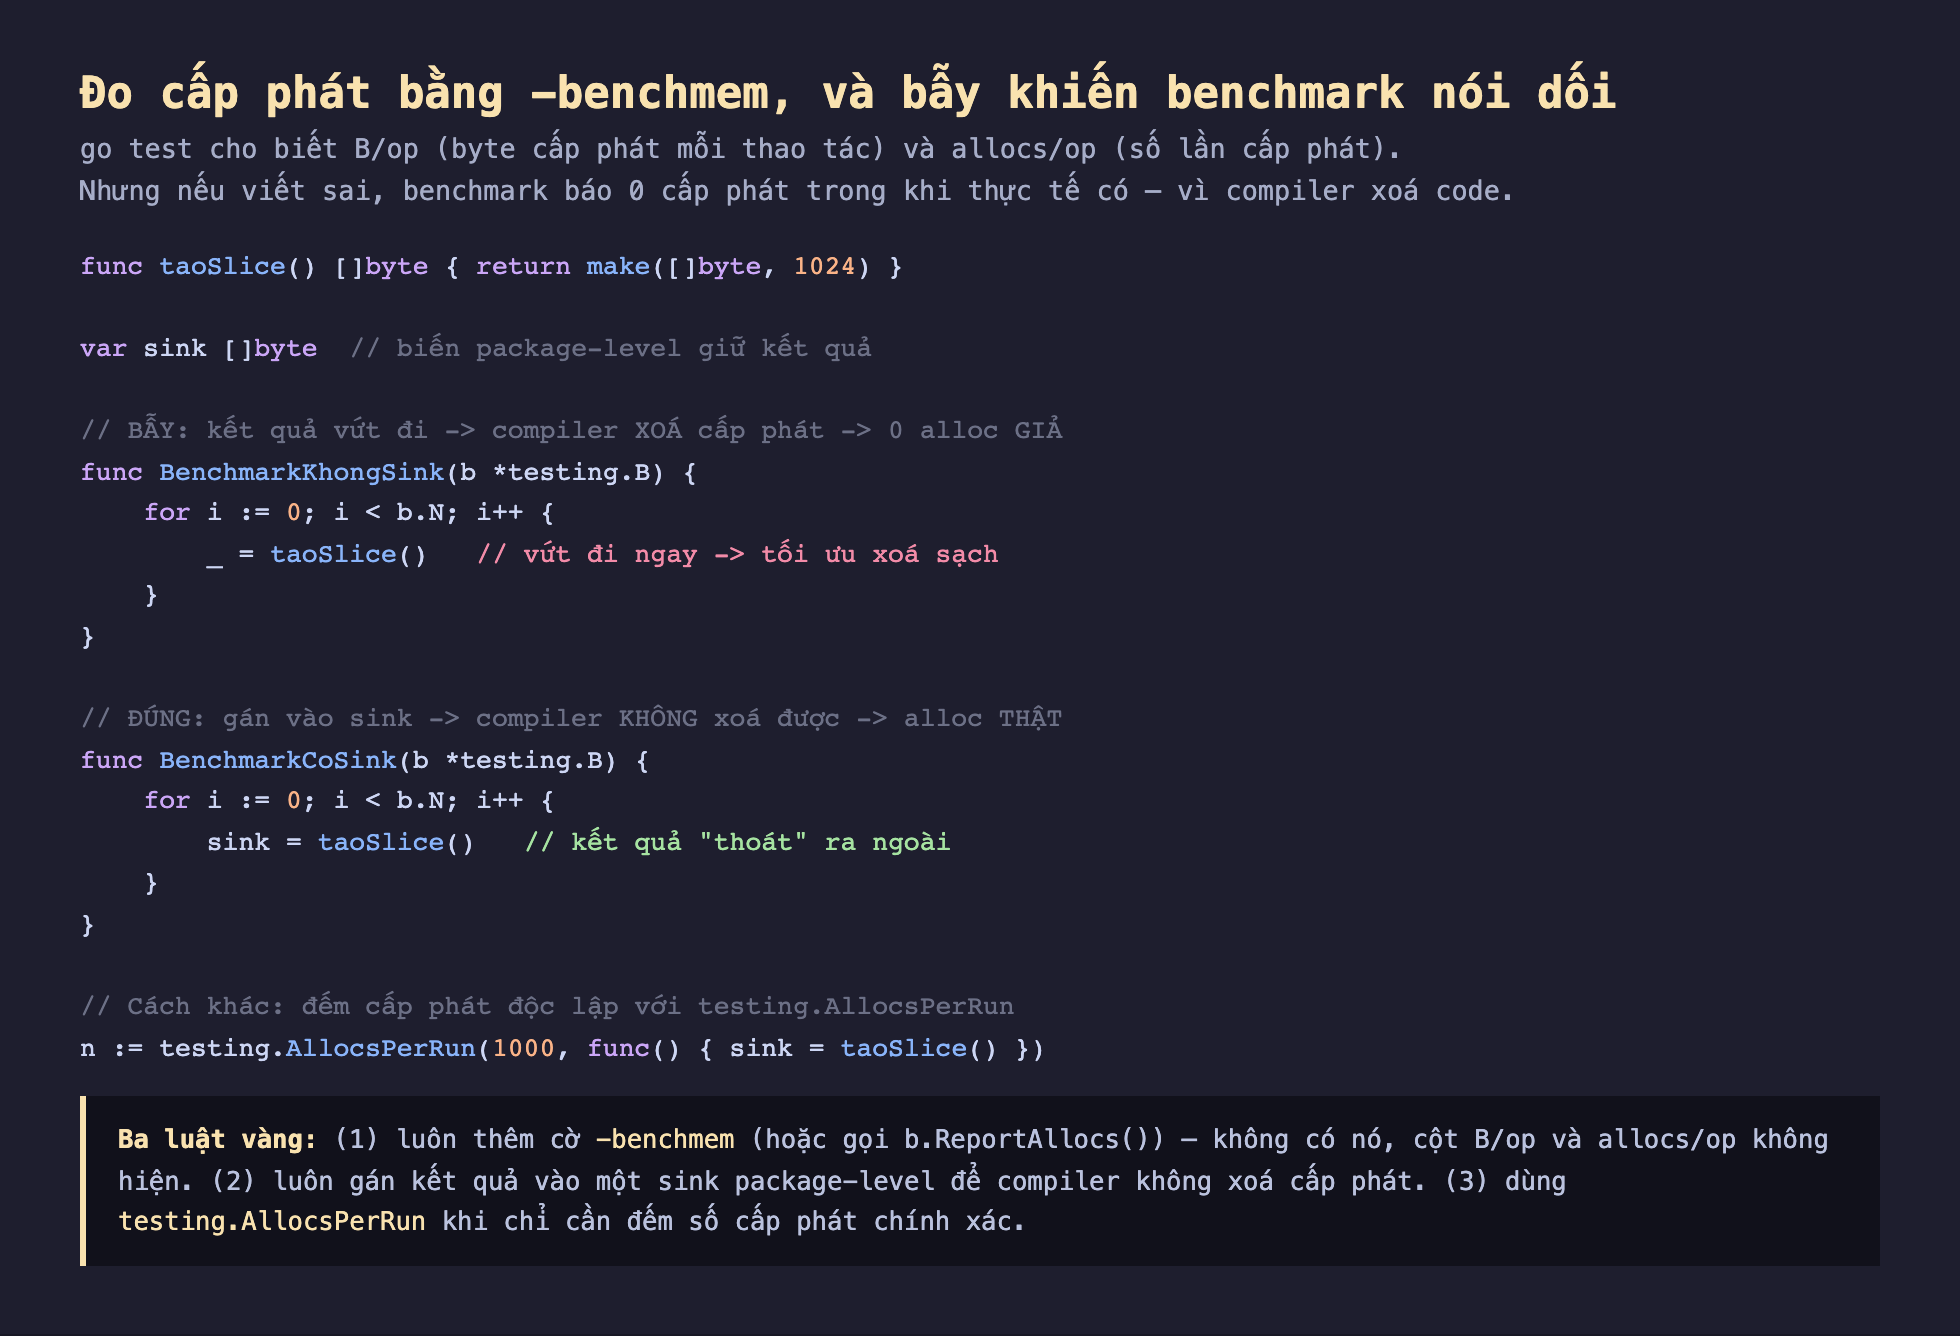
Hình 1: Hàm taoSlice cấp 1024 byte. Không có sink, compiler xoá cấp phát; có sink (biến package-level), cấp phát tồn tại thật. Ba luật vàng ở khối dưới.
Bẫy 1: thiếu -benchmem thì không thấy gì
Bẫy đầu tiên đơn giản nhất: nếu bạn quên cờ -benchmem (và không gọi b.ReportAllocs() trong code), kết quả benchmark không có cột B/op và allocs/op. Bạn chỉ thấy ns/op và tưởng như thế là đủ — trong khi hàm có thể đang cấp phát điên cuồng mà bạn không biết.
Bẫy 2: thiếu sink thì compiler xoá cấp phát
Đây là cái bẫy nguy hiểm hơn nhiều, vì nó cho ra con số sai chứ không phải thiếu. Xét hai benchmark gọi cùng hàm taoSlice() cấp 1024 byte:
func BenchmarkKhongSink(b *testing.B) {
    for i := 0; i < b.N; i++ { _ = taoSlice() }   // vứt kết quả
}
func BenchmarkCoSink(b *testing.B) {
    for i := 0; i < b.N; i++ { sink = taoSlice() } // gán vào sink
}
Đo thật với -benchmem:
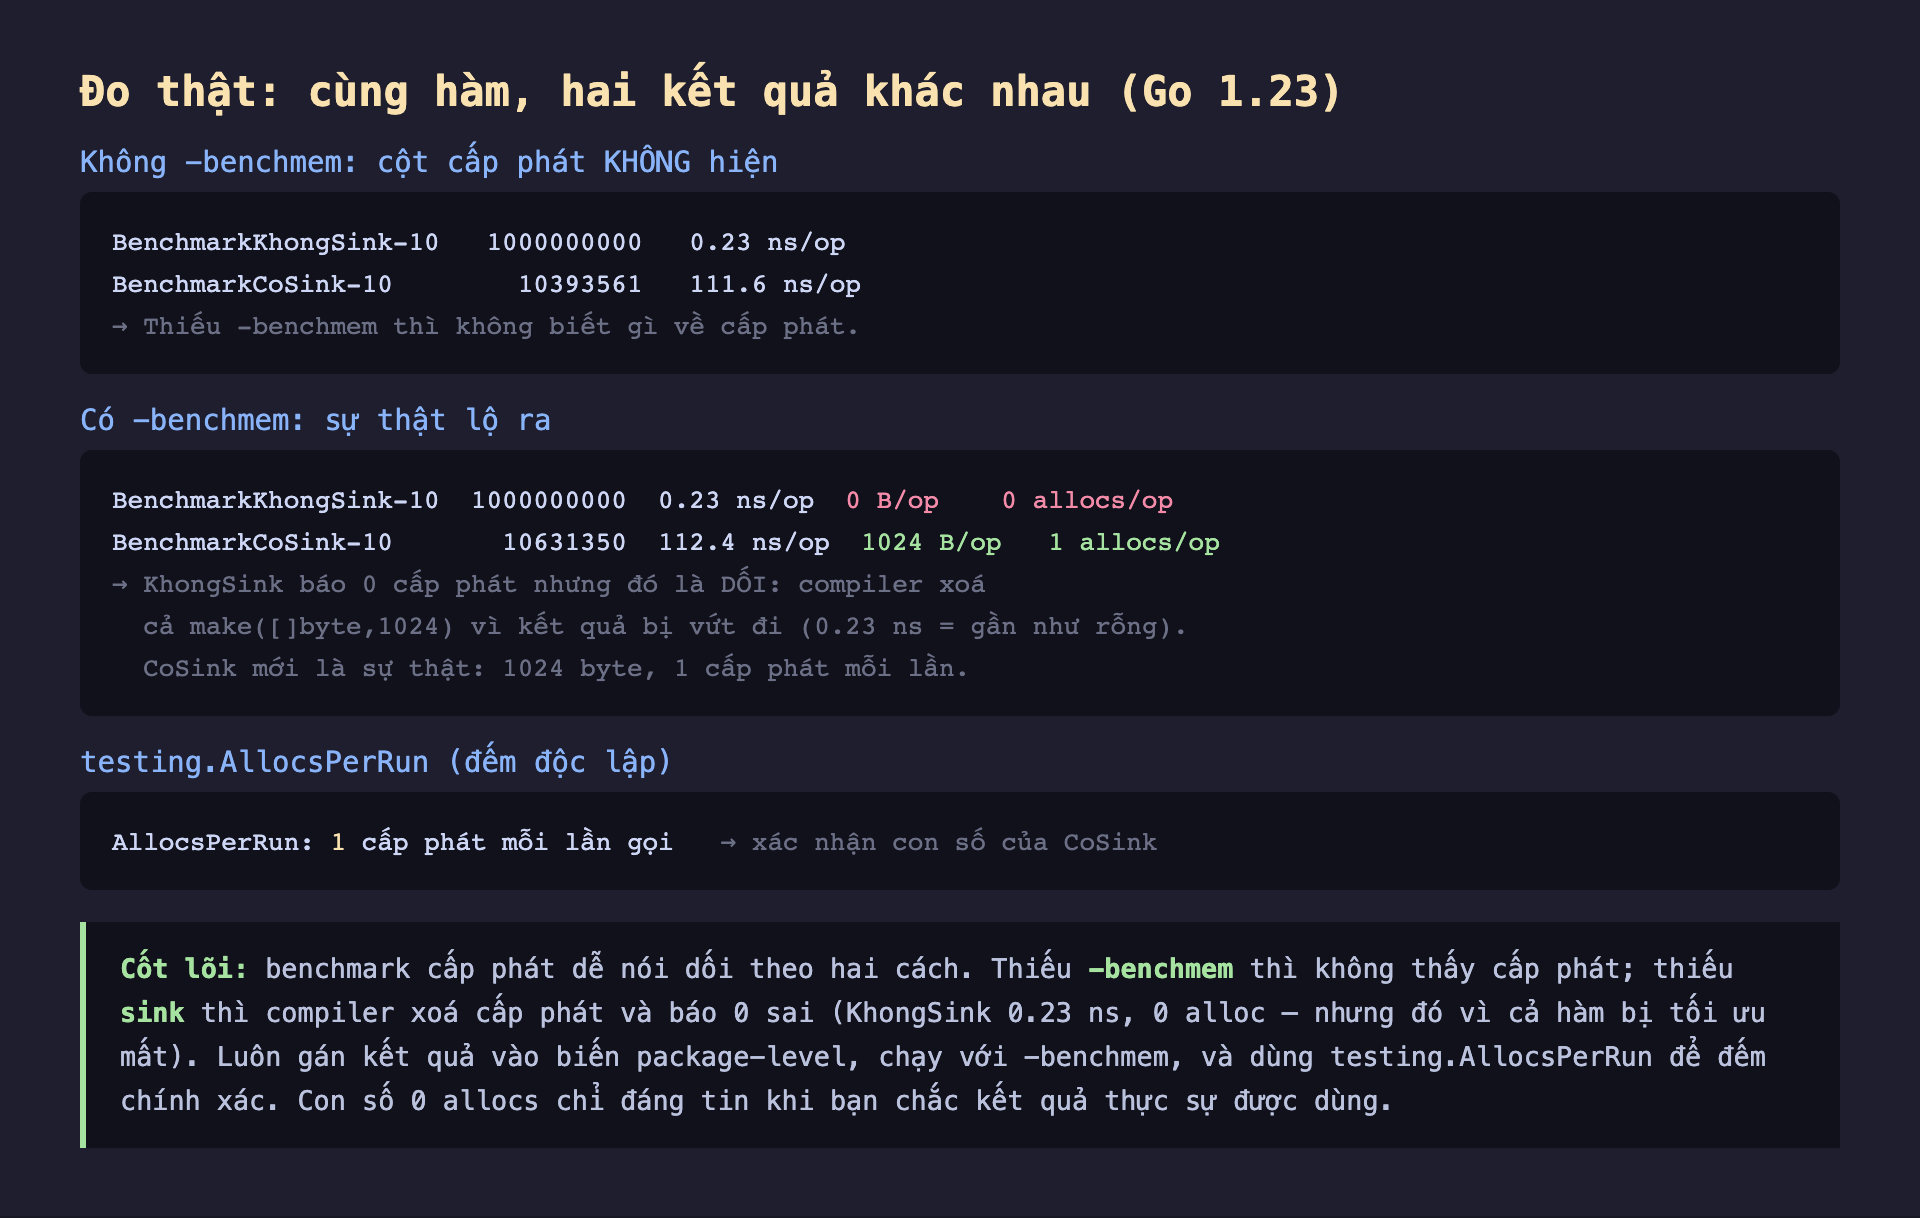
Hình 2: BenchmarkKhongSink báo 0 B/op, 0 allocs/op — DỐI, vì compiler xoá cả make([]byte,1024) khi kết quả bị vứt (0,23 ns nghĩa là gần như không làm gì). BenchmarkCoSink mới đúng: 1024 B, 1 cấp phát. AllocsPerRun xác nhận 1.
Kết quả gây sốc: cùng một hàm taoSlice(), nhưng:
BenchmarkKhongSink: 0,23 ns/op, 0 B/op, 0 allocs/op. Trông như hàm hoàn hảo không cấp phát gì! Nhưng đó là dối. Vì kết quảtaoSlice()bị_ =vứt đi ngay, trình biên dịch nhận ra không ai dùng nó và xoá luôn cả lời gọi (dead code elimination). Con số 0,23 ns (bằng đúng một vòng lặp rỗng) là dấu hiệu: hàm đã bị tối ưu biến mất.BenchmarkCoSink: 112,4 ns/op, 1024 B/op, 1 allocs/op. Đây mới là sự thật. Vì kết quả được gán vàosink(biến package-level), compiler không thể chứng minh nó vô dụng, nên phải giữ lại cấp phát.
Chênh lệch là toàn bộ sự thật về hàm. Nếu bạn tin BenchmarkKhongSink, bạn sẽ kết luận hàm không cấp phát và bỏ qua một nguồn 1KB/lần — sai hoàn toàn.
Cách đúng: sink + AllocsPerRun
Luôn gán kết quả vào một biến package-level (sink). Đây là cách chuẩn để chặn compiler xoá code. Biến phải ở cấp package (không phải local), nếu không compiler vẫn có thể chứng minh nó chết.
Dùng testing.AllocsPerRun khi chỉ cần đếm cấp phát. Hàm này chạy một closure N lần và trả về số cấp phát trung bình — độc lập với cơ chế benchmark, và cũng cần sink bên trong:
n := testing.AllocsPerRun(1000, func() { sink = taoSlice() })
// n = 1 — xác nhận con số của benchmark
Đo thật cho n = 1, khớp với BenchmarkCoSink. Đây là cách kiểm tra chéo tốt khi bạn nghi ngờ benchmark của mình bị tối ưu sai.
Ứng dụng thực tế
Nghi ngờ ngay khi thấy 0 allocs kèm ns/op cực thấp. Nếu một benchmark báo 0 allocs/op và thời gian chỉ ~0,2-0,3 ns (bằng vòng lặp rỗng), gần như chắc chắn hàm đã bị tối ưu biến mất. Một hàm thật sự làm việc mà không cấp phát vẫn tốn thời gian cho công việc đó. 0 allocs + ~0,25 ns = cờ đỏ.
Đưa kết quả ra ngoài benchmark, không chỉ dùng nội bộ. Ngay cả khi gán vào biến local rồi tính toán, compiler đôi khi vẫn tối ưu được. Cách chắc ăn là gán vào biến package-level và (nếu cần) đọc lại nó sau vòng lặp.
Chạy -count=N để kiểm độ ổn định. Một lần chạy có thể nhiễu. go test -bench=. -benchmem -count=10 chạy 10 lần; nếu allocs/op dao động thì kết quả không đáng tin (thường do GC hoặc tối ưu không nhất quán). allocs/op nên là số nguyên ổn định giữa các lần.
Đánh đổi cần cân nhắc
b.ReportAllocs() vs cờ -benchmem. Gọi b.ReportAllocs() trong code benchmark bật báo cáo cấp phát chỉ cho benchmark đó, kể cả khi quên -benchmem. Đây là cách phòng thủ tốt cho các benchmark mà cấp phát là điểm chính. Nhưng cờ -benchmem tiện hơn khi muốn xem mọi benchmark. Dùng cả hai không hại gì.
Sink có chi phí nhỏ. Việc gán vào biến package-level có một chi phí ghi bộ nhớ nhỏ, về lý thuyết làm ns/op cao hơn thực tế một chút. Với đo cấp phát thì không quan trọng (allocs/op không đổi), nhưng khi đo thời gian tinh vi, hãy ý thức rằng sink thêm một phép ghi.
Benchmark micro không phải sự thật toàn cục. allocs/op của một hàm đơn lẻ đúng cho hàm đó, nhưng inlining và tối ưu liên hàm có thể làm nó cấp phát khác khi gọi trong ngữ cảnh thật. Luôn kiểm lại bằng profiling trên chương trình thật (chủ đề pprof sau) khi tối ưu nghiêm túc.
Ba ý mang về
- Luôn dùng
-benchmem(hoặcb.ReportAllocs()) để thấyB/opvàallocs/op— thiếu nó thì benchmark im lặng về cấp phát, và bạn có thể bỏ sót nguồn cấp phát lớn. - Luôn gán kết quả vào một sink package-level: đo thật, cùng hàm cấp 1024 byte báo
0 allocs/op(dối, vì compiler xoá code khi kết quả bị vứt) so với1 allocs/op(thật, khi gán vào sink) — 0 allocs kèm ~0,25 ns là cờ đỏ hàm bị tối ưu mất. - Dùng
testing.AllocsPerRunđể đếm chéo và-count=Nđể kiểm ổn định:allocs/opnên là số nguyên ổn định; dao động nghĩa là kết quả không đáng tin.
Phần sau ta chuyển từ đo cấp phát sang giảm nó: Phần sau mổ xẻ kỹ thuật tái dùng buffer — cắt allocation bằng cách dùng lại slice, các mẫu [:0] và buffer sẵn, đo thật mức tiết kiệm.
