Bài trước dạy cách đo allocation cho đúng. Giờ ta giảm nó. Trong Go, phần lớn allocation dư thừa đến từ việc cấp mới một slice/buffer mỗi lần cần, dù có thể tái dùng cái cũ. Hai kỹ thuật đơn giản — mẫu [:0] và preallocation — cắt được phần lớn allocation trên đường nóng, không cần thư viện nào. Bài này đo chính xác chúng tiết kiệm bao nhiêu và giải thích cơ chế.
Slice, capacity, và vì sao append cấp phát
Một slice Go có ba thành phần: con trỏ tới mảng nền (backing array), độ dài (len), và dung lượng (cap). Khi bạn append vượt quá cap, runtime phải cấp một mảng nền mới lớn hơn (thường gấp đôi), copy dữ liệu cũ sang, rồi trỏ slice vào mảng mới. Mỗi lần như vậy là một cấp phát + một lần copy.
Điều này dẫn tới hai nguồn allocation lãng phí: (1) một slice bắt đầu từ nil phải nhân đôi capacity nhiều lần khi lớn dần, mỗi lần một cấp phát; (2) một hàm cấp slice mới mỗi lần được gọi, dù mảng nền của lần trước có thể tái dùng.
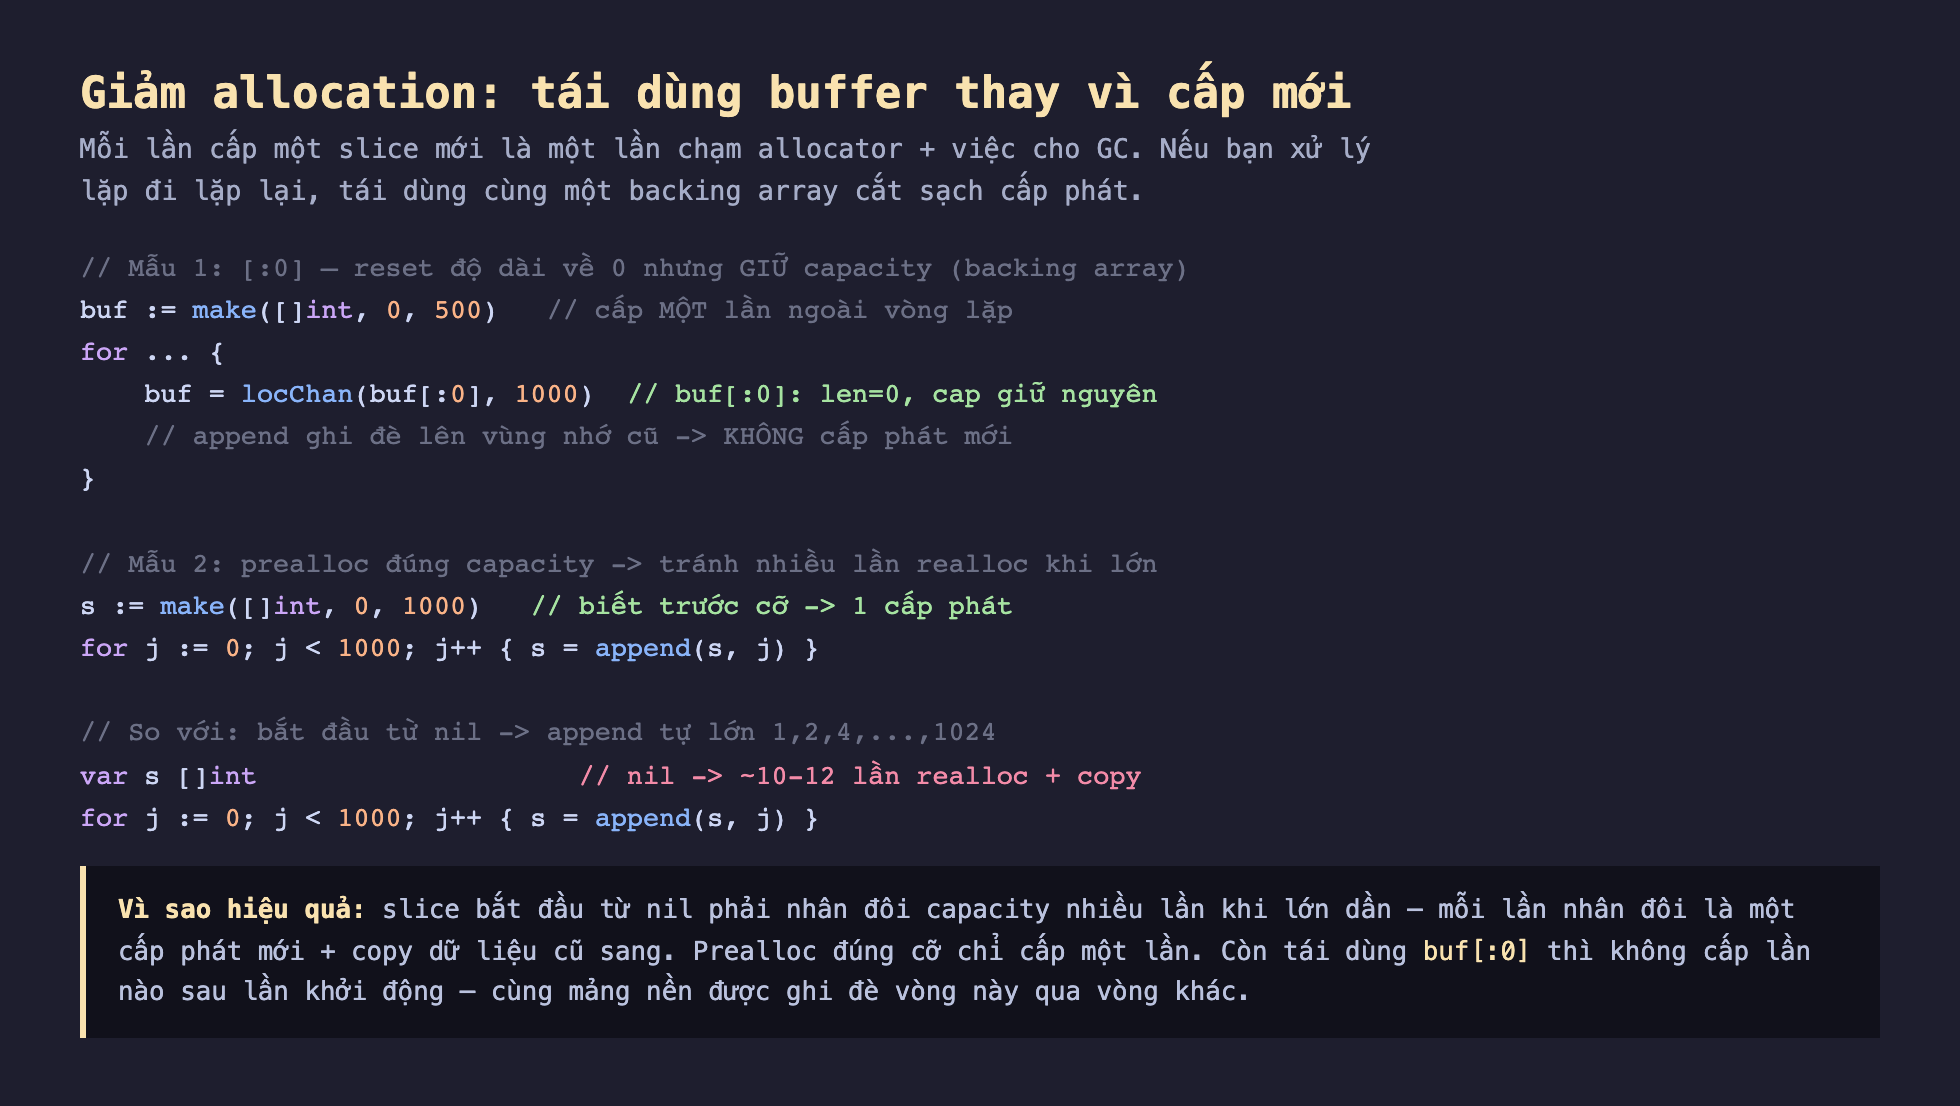
Hình 1: Mẫu buf[:0] reset độ dài về 0 nhưng giữ mảng nền, nên vòng lặp sau ghi đè thay vì cấp mới. Prealloc đúng cỡ chỉ cấp một lần.
Đo thật kỹ thuật 1: tái dùng với [:0]
Mẫu buf[:0] là biểu thức tạo một slice có len=0 nhưng giữ nguyên capacity (và mảng nền) của buf. Nghĩa là các append tiếp theo sẽ ghi đè lên vùng nhớ cũ thay vì cấp mảng mới. Cấp buffer một lần ngoài vòng lặp, rồi mỗi vòng dùng buf[:0]:
buf := make([]int, 0, 500)         // cấp MỘT lần
for i := 0; i < b.N; i++ {
    buf = locChan(buf[:0], 1000)   // reset len=0, giữ cap -> không cấp phát
    sink = buf
}
So với cấp slice mới (bắt đầu từ nil) mỗi lần:
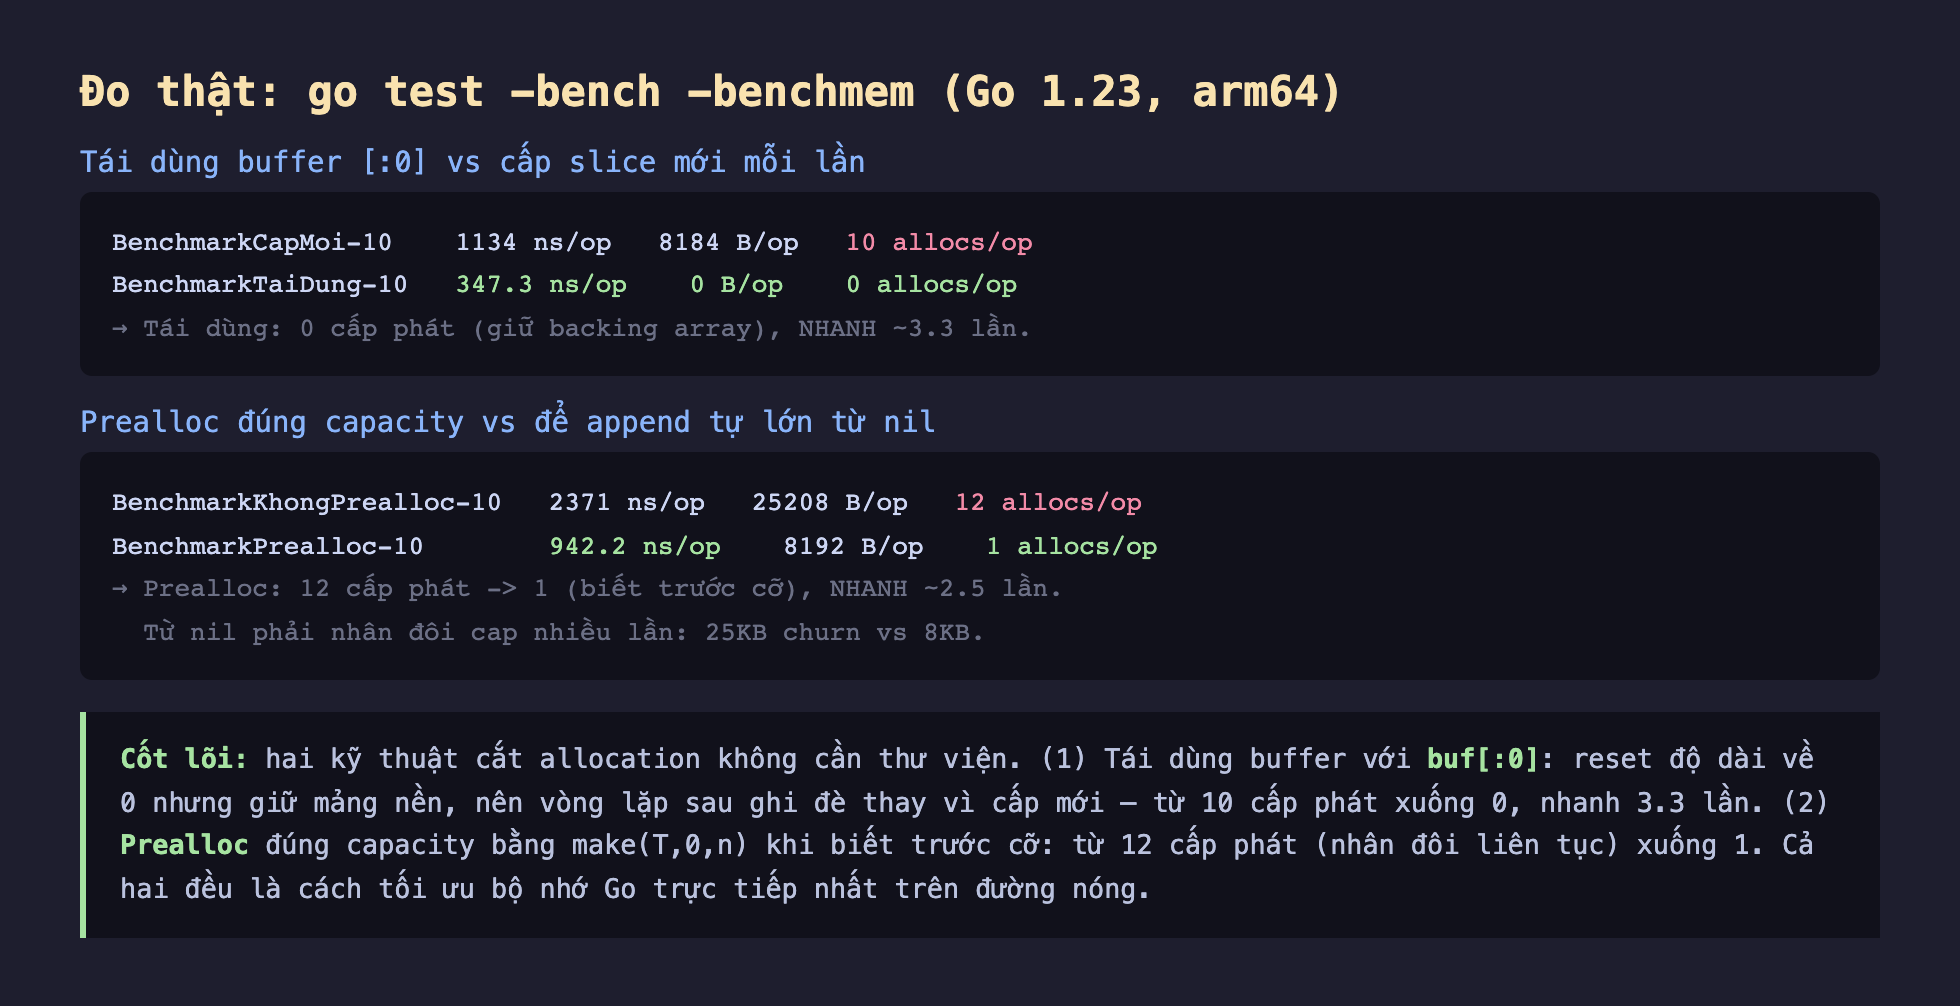
Hình 2: Tái dùng buf[:0]: 0 cấp phát, 347 ns — so với cấp mới 10 cấp phát, 1134 ns (nhanh ~3,3 lần). Prealloc: 1 cấp phát, 942 ns — so với để append tự lớn 12 cấp phát, 2371 ns (nhanh ~2,5 lần).
Kết quả: cấp slice mới mỗi lần tốn 10 cấp phát (append nhân đôi từ 1 lên 512) và 1134 ns. Tái dùng buf[:0] tốn 0 cấp phát và chỉ 347 ns — nhanh 3,3 lần, và không tạo việc gì cho GC. Sau lần khởi động đầu, cùng một mảng nền được dùng lại mãi.
Đo thật kỹ thuật 2: preallocation
Khi bạn biết trước (hoặc ước lượng được) kích thước cuối, make([]T, 0, n) cấp đúng capacity ngay từ đầu, tránh mọi lần nhân đôi:
s := make([]int, 0, 1000)   // biết trước 1000 phần tử -> 1 cấp phát
for j := 0; j < 1000; j++ { s = append(s, j) }
Đo thật: để append tự lớn từ nil tốn 12 cấp phát và 25.208 byte churn (vì nhân đôi qua nhiều capacity: 1, 2, 4, ..., 1024, mỗi lần cấp mới + copy). Prealloc đúng cỡ chỉ tốn 1 cấp phát, 8192 byte, và nhanh 2,5 lần. Chênh lệch byte (25KB so với 8KB) cho thấy phần lớn bộ nhớ bị phí vào các mảng trung gian bị vứt bỏ.
Ứng dụng thực tế
Buffer tái dùng trong vòng lặp xử lý. Nếu bạn xử lý từng dòng/từng bản ghi trong vòng lặp và mỗi lần build một slice kết quả, hãy cấp buffer một lần ngoài vòng lặp và dùng buf[:0] mỗi vòng. Đây là mẫu chuẩn trong parser, encoder, và pipeline xử lý dữ liệu — cắt allocation từ O(n) xuống O(1).
Prealloc khi biết hoặc ước lượng được cỡ. Đọc từ database trả về n dòng? make([]Row, 0, n). Xây map kết quả? make(map[K]V, n). Ngay cả ước lượng thô cũng giảm mạnh số lần realloc. bytes.Buffer.Grow(n) và strings.Builder.Grow(n) là cùng ý tưởng cho chuỗi.
bytes.Buffer và strings.Builder cho ghép chuỗi. Ghép chuỗi bằng += trong vòng lặp cấp phát mỗi lần (chuỗi bất biến). strings.Builder giữ một buffer tái dùng bên trong — cùng nguyên lý bài này, đóng gói sẵn.
Đánh đổi cần cân nhắc
Cẩn thận chia sẻ backing array. Đây là bẫy nguy hiểm nhất. Khi bạn tái dùng buf[:0], mọi slice cũ trỏ vào cùng mảng nền sẽ bị ghi đè ở vòng sau. Nếu bạn giữ lại (hoặc trả ra ngoài) một slice từ vòng trước rồi tái dùng buffer, dữ liệu cũ bị hỏng lặng lẽ. Chỉ tái dùng khi chắc chắn không ai còn giữ tham chiếu tới nội dung cũ; nếu cần giữ, phải copy ra.
Tái dùng buffer làm code phức tạp hơn — chỉ dùng ở đường nóng. Cấp mới mỗi lần là mã đơn giản, dễ đúng. Tái dùng buffer thêm trạng thái (buffer sống qua nhiều vòng) và rủi ro chia sẻ. Chỉ áp dụng khi profiler cho thấy allocation là nút thắt thật — đừng làm rối mọi hàm.
Prealloc sai cỡ có thể phản tác dụng. make([]T, 0, n) với n quá lớn cấp phí bộ nhớ bạn không dùng; quá nhỏ thì vẫn phải realloc. Ước lượng tốt mới có lợi; đoán bừa một số lớn "cho chắc" là lãng phí. Khi không rõ cỡ, để append tự lớn (nó đã khá tốt) hoặc đo phân phối cỡ thực tế.
Ba ý mang về
- Tái dùng buffer với
buf[:0]cắt allocation xuống 0: đo thật, xử lý lặp với buffer tái dùng tốn 0 cấp phát và nhanh 3,3 lần so với cấp slice mới mỗi lần (10 cấp phát) —buf[:0]giữ mảng nền, các vòng sau ghi đè thay vì cấp mới. - Prealloc đúng capacity cắt số lần realloc: đo thật,
make([]T,0,1000)tốn 1 cấp phát so với để append tự lớn từ nil (12 cấp phát, nhân đôi liên tục, 25KB churn) — nhanh 2,5 lần khi biết trước cỡ. - Cẩn thận chia sẻ backing array: tái dùng buffer ghi đè dữ liệu cũ, nên đừng giữ/trả ra slice từ vòng trước khi sắp tái dùng — chỉ áp dụng ở đường nóng profiler chỉ ra, vì nó thêm trạng thái và rủi ro.
Bài tập làm thử
Bài 1 (đọc hiểu). Bài viết đo được: cấp slice mới mỗi lần tốn 10 allocs/op và 1134 ns/op; tái dùng buf[:0] tốn 0 allocs/op và 347,3 ns/op. Giải thích vì sao con số allocs lại đúng bằng 10 ở trường hợp cấp mới (gợi ý: append bắt đầu từ slice rỗng, mỗi lần vượt capacity thì nhân đôi).
Đáp án
Khi bắt đầu từ một slice nil/rỗng và append liên tục tới 1000 phần tử, runtime phải cấp mảng nền mới mỗi lần vượt quá capacity hiện tại, và mỗi lần thường nhân đôi capacity (1, 2, 4, 8, ..., cho tới khi ≥1000, tức khoảng 1024). Chuỗi nhân đôi từ 1 lên 1024 mất khoảng 10 bước tăng gấp đôi (2^10 = 1024), nên có khoảng 10 lần cấp phát + copy dữ liệu cũ sang mảng mới. Với buf[:0], mảng nền được cấp sẵn một lần (make([]int, 0, 500)) ngoài vòng lặp, còn lại chỉ reset len về 0 và ghi đè lên vùng nhớ cũ — không có lần cấp phát nào nữa, nên allocs/op = 0.
Bài 2 (sửa lỗi). Đoạn code dưới đây định tái dùng buffer để giảm allocation, nhưng có một bug nguy hiểm liên quan tới chia sẻ backing array. Chỉ ra bug và sửa lại.
func XuLyTatCa(dong [][]byte) [][]int {
    buf := make([]int, 0, 100)
    var ketQua [][]int
    for _, d := range dong {
        buf = buf[:0]
        for _, b := range d {
            buf = append(buf, int(b))
        }
        ketQua = append(ketQua, buf) // lưu lại slice vừa build
    }
    return ketQua
}
Đáp án
Bug: mỗi phần tử của ketQua được lưu là buf — nhưng buf luôn trỏ vào cùng một mảng nền được tái dùng qua các vòng lặp (buf = buf[:0] chỉ reset len, giữ nguyên mảng nền). Ở vòng lặp sau, append(buf, ...) ghi đè lên đúng vùng nhớ mà phần tử trước đó của ketQua đang trỏ tới, nên tất cả phần tử trong ketQua cuối cùng đều trỏ chung một mảng nền và mang giá trị của lần lặp cuối cùng — dữ liệu các dòng trước bị hỏng lặng lẽ. Đây đúng là bẫy "chia sẻ backing array" mà bài viết cảnh báo: chỉ tái dùng buffer khi chắc chắn không ai giữ tham chiếu tới nội dung cũ. Sửa bằng cách copy ra một slice mới trước khi lưu:
func XuLyTatCa(dong [][]byte) [][]int {
    buf := make([]int, 0, 100)
    var ketQua [][]int
    for _, d := range dong {
        buf = buf[:0]
        for _, b := range d {
            buf = append(buf, int(b))
        }
        rieng := make([]int, len(buf))
        copy(rieng, buf)
        ketQua = append(ketQua, rieng)
    }
    return ketQua
}
Bài 3 (vận dụng). Bạn viết một hàm đọc từ database trả về đúng n dòng (biết trước n từ COUNT(*)), rồi build một slice []Row bằng cách append từng dòng một, bắt đầu từ var rows []Row. Áp dụng kỹ thuật prealloc từ bài viết, hãy sửa lại khai báo và giải thích lợi ích dựa trên số liệu đo được trong bài (trường hợp 1000 phần tử: 12 allocs → 1 alloc, nhanh 2,5 lần).
Đáp án
Sửa: rows := make([]Row, 0, n) thay vì var rows []Row (bắt đầu từ nil). Vì đã biết trước số lượng n, cấp đúng capacity ngay từ đầu giúp tránh toàn bộ chuỗi realloc-và-copy mà append phải làm khi tự lớn dần từ nil (nhân đôi capacity nhiều lần). Theo số liệu đo trong bài, với 1000 phần tử: để append tự lớn tốn 12 allocs/op và 25.208 B/op (2371 ns/op); prealloc đúng cỡ chỉ tốn 1 alloc/op và 8192 B/op (942,2 ns/op) — nhanh khoảng 2,5 lần và giảm hẳn "churn" bộ nhớ (các mảng trung gian bị vứt bỏ trong quá trình nhân đôi).
Bài 4 (bẫy/đánh đổi). Bài viết cảnh báo "prealloc sai cỡ có thể phản tác dụng". Nêu hai kịch bản prealloc sai và tác hại của từng kịch bản, đồng thời giải thích khi nào nên để append tự lớn thay vì prealloc.
Đáp án
Hai kịch bản sai:
nquá lớn (ví dụ đoán bừa "cho chắc" một con số lớn): cấp phát dư thừa bộ nhớ không dùng tới, lãng phí RAM dù không gây thêm cấp phát lần hai.nquá nhỏ: vẫn phải realloc thêm khi vượt capacity ban đầu, mất một phần lợi ích của prealloc (dù vẫn tốt hơn bắt đầu từ nil hoàn toàn).
Khi không rõ cỡ trước, bài viết khuyên nên để append tự lớn (cơ chế nhân đôi của Go "đã khá tốt" cho trường hợp không biết trước), hoặc đo phân phối cỡ thực tế của dữ liệu trước khi quyết định con số prealloc — thay vì đoán bừa.
Phần sau ta xét công cụ chuẩn của Go cho việc tái dùng object an toàn giữa nhiều goroutine: Phần sau mổ xẻ sync.Pool — cơ chế bể chứa object, cách nó tương tác với GC, và đo hiệu quả thật (khi nào giúp, khi nào không).
