Bài size classes cho thấy Go làm tròn cấp phát lên các lớp kích thước cố định, lớp nhỏ nhất là 8 byte. Vậy một object 1 byte — như *bool, *int8, hay một chuỗi một ký tự — sẽ tốn 8 byte? Nếu đúng thế thì lãng phí 87%. Go có một tối ưu riêng cho tình huống này: tiny allocator, gộp nhiều object tí hon vào chung một khối. Bài này đo chính xác cơ chế đó và ba điều kiện để một object được hưởng.
Vấn đề: object tí hon quá phổ biến
Trong code thực, object cực nhỏ xuất hiện khắp nơi: con trỏ tới một bool, một byte được lấy địa chỉ, phần tử nhỏ của cấu trúc dữ liệu. Nếu mỗi cái chiếm một slot của lớp kích thước nhỏ nhất (8 byte), thì cấp một triệu object 1-byte tốn 8MB thay vì ~1MB. Tiny allocator giải quyết bằng cách gộp nhiều object nhỏ liên tiếp vào chung một khối 16 byte, mỗi object dùng một phần của khối.
Có ba điều kiện để một object được gộp:
- Kích thước nhỏ hơn 16 byte.
- Không chứa con trỏ nào bên trong (noscan).
- Các cấp phát liên tiếp còn vừa chỗ trong khối 16-byte hiện tại.
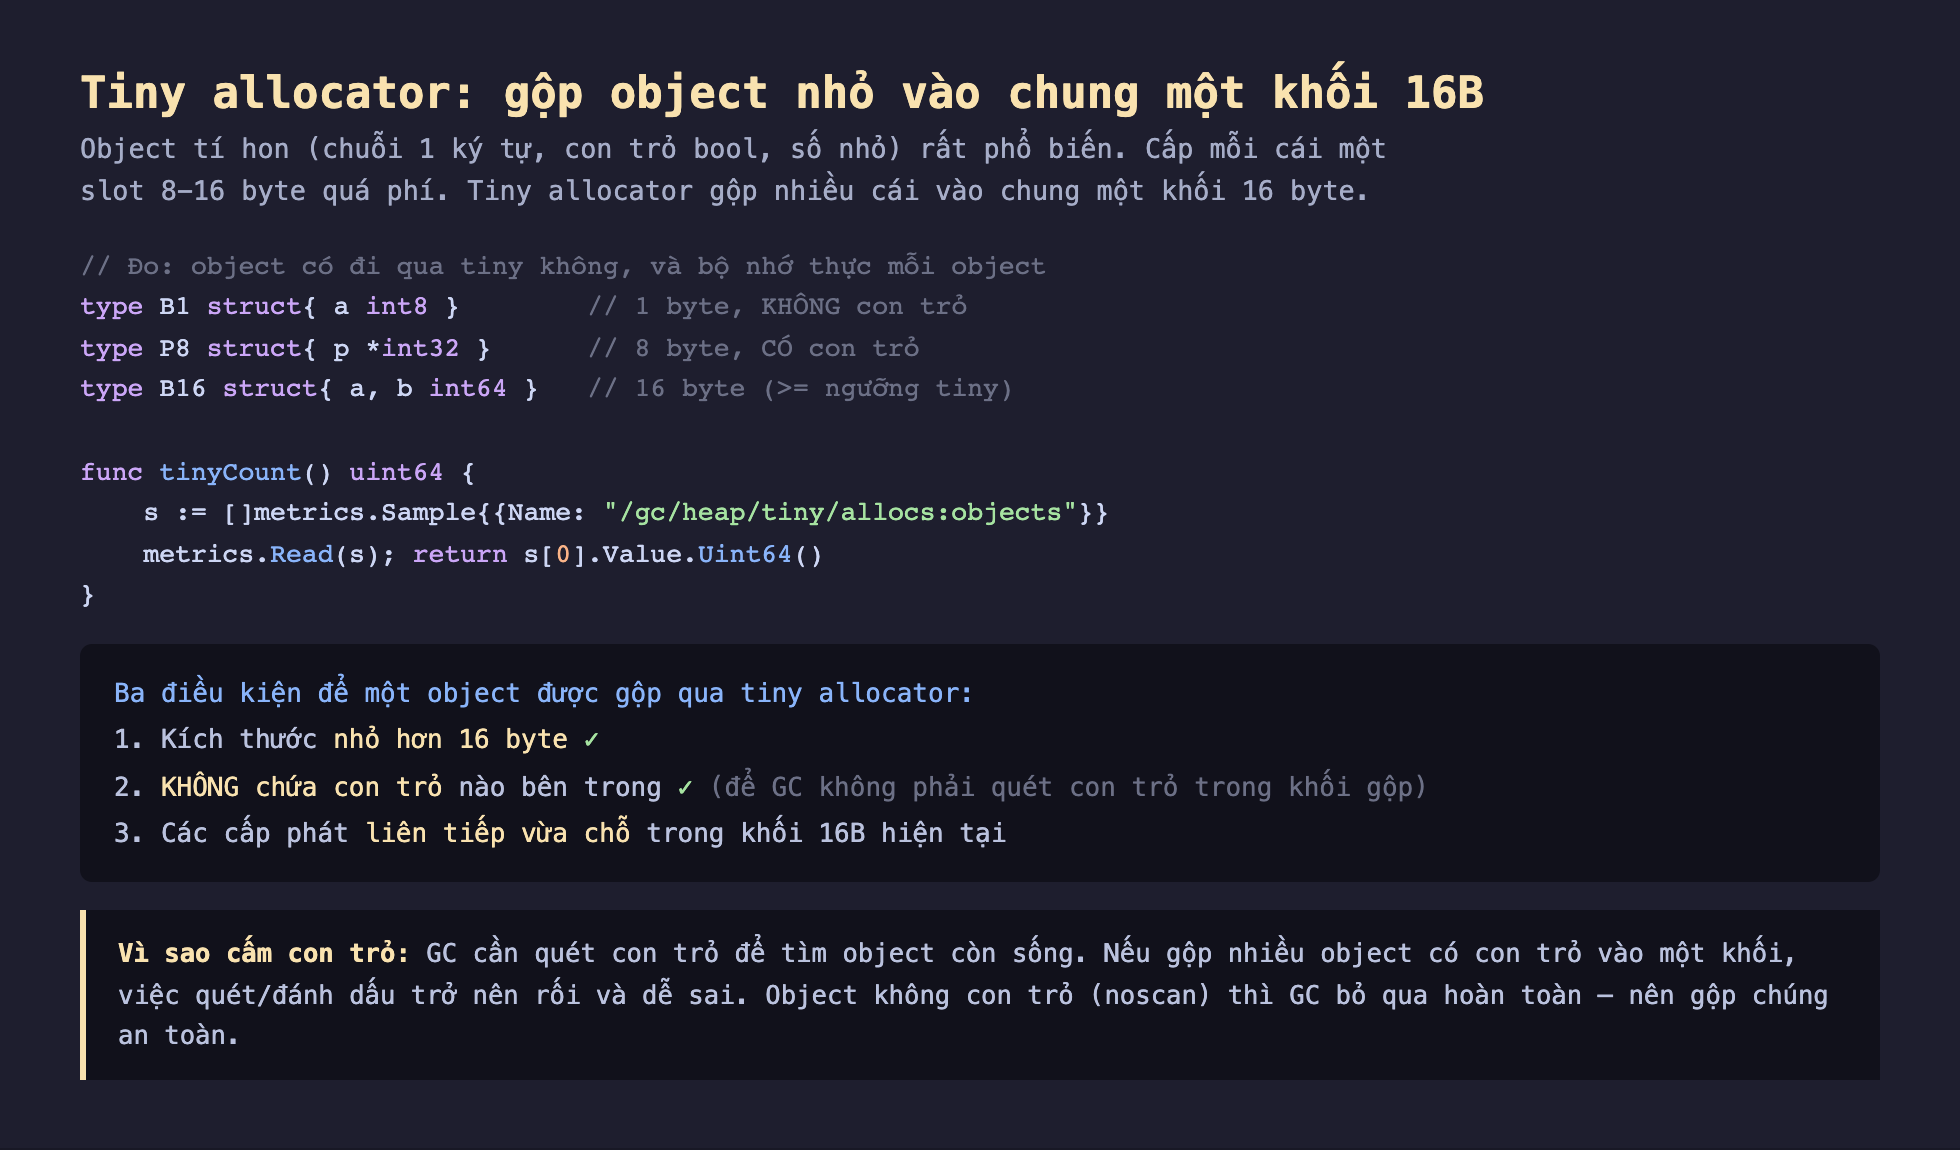
Hình 1: Ba điều kiện để object được gộp: nhỏ hơn 16B, không con trỏ, và các cấp phát liên tiếp vừa chỗ. Đọc /gc/heap/tiny/allocs:objects để biết object có qua tiny không.
Đo thật: một byte chỉ tốn một byte
Cấp 1 triệu object của bốn kiểu khác nhau, đọc metric /gc/heap/tiny/allocs:objects để biết object có đi qua tiny không, và đo HeapAlloc để biết bộ nhớ thực mỗi object:
func tinyCount() uint64 {
    s := []metrics.Sample{{Name: "/gc/heap/tiny/allocs:objects"}}
    metrics.Read(s)
    return s[0].Value.Uint64()
}
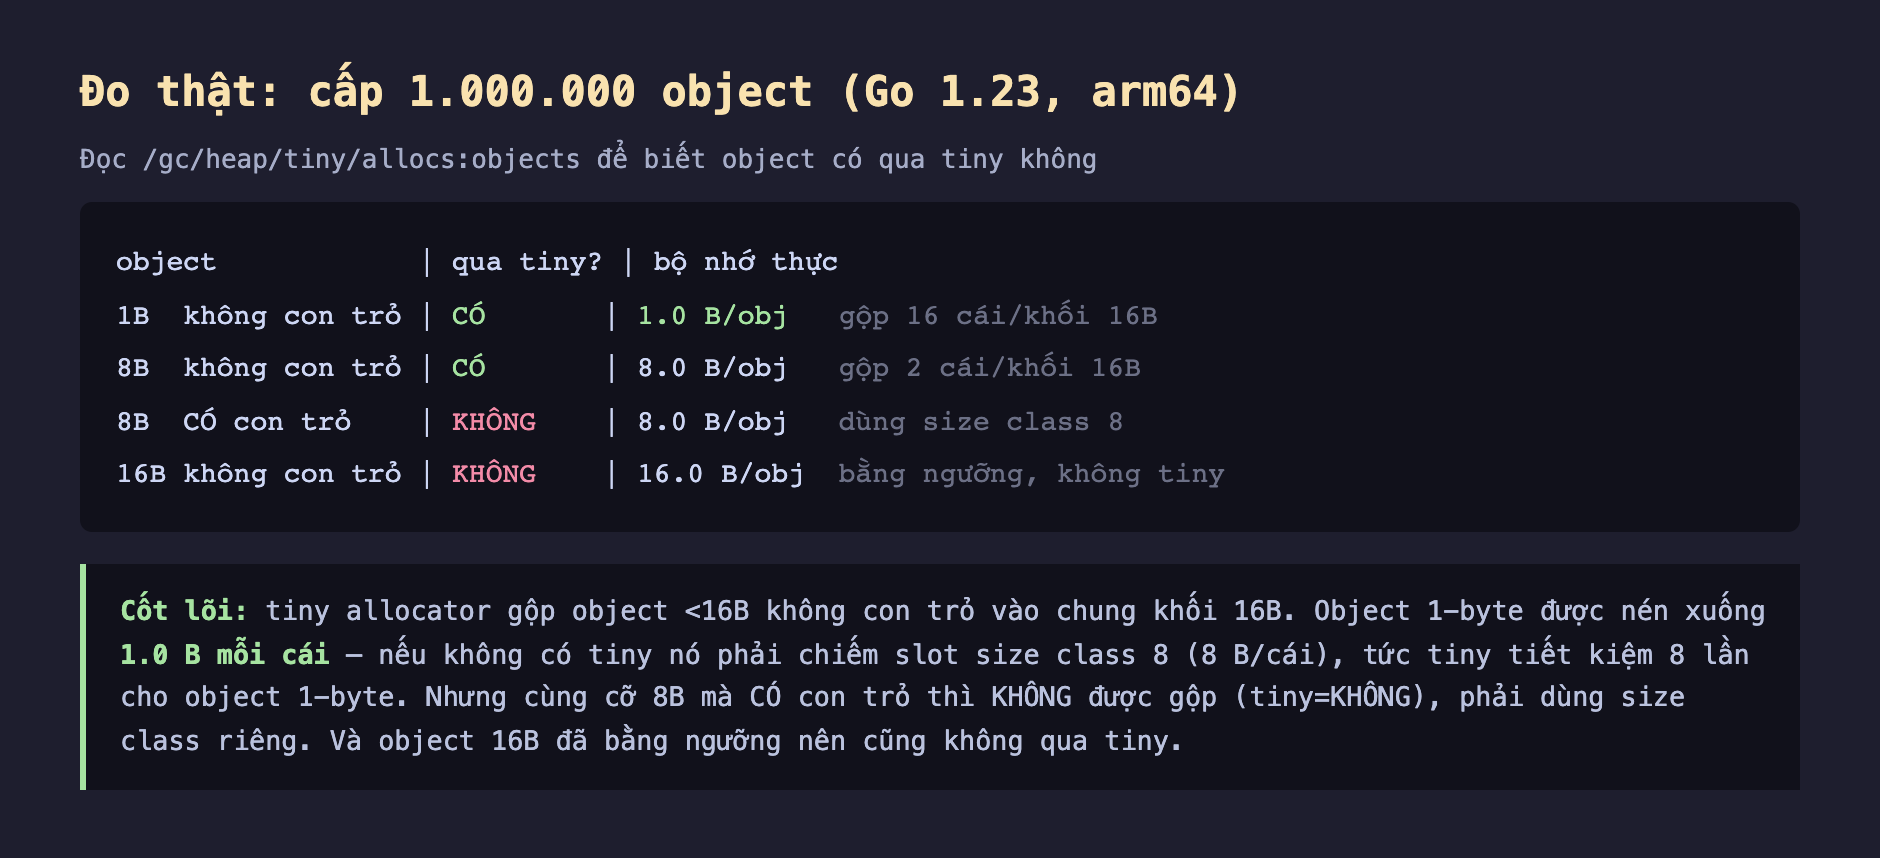
Hình 2: Object 1-byte không con trỏ → qua tiny, 1.0 B/object (gộp 16 cái/khối). 8B không con trỏ → tiny, 8 B/obj. 8B có con trỏ → KHÔNG tiny (size class 8). 16B → bằng ngưỡng, không tiny.
Kết quả xác nhận từng điều kiện:
- 1-byte không con trỏ: qua tiny, 1,0 byte mỗi object. 16 object 1-byte gộp vào một khối 16 byte. Không có tiny, mỗi cái phải chiếm slot lớp 8-byte → 8 byte. Tiny tiết kiệm 8 lần cho object 1-byte.
- 8-byte không con trỏ: qua tiny, 8 byte/object — hai cái gộp vào một khối 16 byte.
- 8-byte CÓ con trỏ: không qua tiny (metric = 0), phải dùng lớp kích thước 8 riêng. Cùng kích thước 8 byte với trường hợp trên, nhưng vì chứa con trỏ nên bị loại khỏi tiny.
- 16-byte không con trỏ: không qua tiny — 16 byte đã bằng ngưỡng (điều kiện là nhỏ hơn 16), nên dùng lớp kích thước 16.
Vì sao cấm con trỏ
Điều kiện "không con trỏ" là điểm tinh tế nhất. Bộ thu gom rác của Go phải quét các con trỏ để lần theo object nào còn sống. Nếu gộp nhiều object có con trỏ vào chung một khối, GC sẽ phải theo dõi con trỏ nằm ở đâu trong khối gộp — phức tạp và dễ sai. Ngược lại, object không con trỏ (gọi là noscan) được GC bỏ qua hoàn toàn khi quét, nên gộp chúng lại là an toàn tuyệt đối. Đây là lý do một struct 8-byte chỉ chứa số thì được gộp, còn một struct 8-byte chứa một con trỏ thì không.
Ứng dụng thực tế
Struct nhỏ không con trỏ hưởng lợi tự động. Nếu bạn cấp phát nhiều struct nhỏ chỉ chứa số/bool (như điểm dữ liệu, cờ, chỉ số), chúng được gộp mà bạn không phải làm gì. Đây là lý do các cấu trúc dữ liệu gọn (không nhét con trỏ vào mọi node) tốn ít bộ nhớ hơn nhiều.
Tránh con trỏ trong object nhỏ nếu muốn tiny. Nếu một struct nhỏ của bạn chứa con trỏ, nó mất quyền vào tiny allocator. Đôi khi có thể thiết kế lại: thay *int bằng int (nếu không cần chia sẻ), hoặc thay con trỏ bằng chỉ số (index) vào một slice — chỉ số là int không con trỏ, giữ object trong diện tiny và cũng thân thiện với cache.
Tiny giúp giảm áp lực GC gấp đôi. Object không con trỏ vừa được gộp (ít bộ nhớ), vừa được GC bỏ qua khi quét (ít việc cho GC). Với workload cấp phát nhiều object nhỏ, giữ chúng noscan là một trong những tối ưu bộ nhớ hiệu quả nhất.
Đánh đổi cần cân nhắc
Tiny chỉ gộp các cấp phát liên tiếp vừa chỗ. Khối tiny hiện tại được chia sẻ giữa các tiny alloc nối nhau; nếu một cấp phát không vừa phần còn lại của khối, một khối mới bắt đầu và phần đuôi khối cũ bị bỏ phí. Nên hiệu quả gộp thực tế phụ thuộc mẫu cấp phát — object 1-byte đều nhau gộp gần hoàn hảo (1,0 B/obj như đo được), nhưng cấp phát kích thước lẫn lộn có thể để lại lỗ hổng.
Đừng cố "ép" mọi thứ vào tiny. Lợi ích lớn nhất của tiny là tự động — bạn không cần và không nên vặn vẹo code để lách vào nó. Chỉ khi profiler cho thấy bộ nhớ từ object nhỏ là nút thắt thì mới cân nhắc bỏ con trỏ khỏi struct nhỏ.
Alignment vẫn được tôn trọng. Tiny allocator không nhồi bừa: nó căn lề mỗi object theo yêu cầu (một int64 8-byte cần căn 8-byte). Nên với các cỡ không chia hết 16, có thể có chút khoảng trống căn lề trong khối — vẫn tốt hơn nhiều so với mỗi cái một slot riêng.
Ba ý mang về
- Tiny allocator gộp object dưới 16 byte không con trỏ vào chung khối 16B: đo thật, object 1-byte nén xuống đúng 1,0 byte mỗi cái (16 cái/khối) — tiết kiệm 8 lần so với phải chiếm slot lớp 8-byte.
- Ba điều kiện để được gộp: nhỏ hơn 16 byte, không chứa con trỏ (noscan), và cấp phát liên tiếp vừa chỗ — đo thật, cùng cỡ 8 byte nhưng object có con trỏ thì bị loại (tiny=không), và object 16 byte đã bằng ngưỡng nên cũng không qua tiny.
- Cấm con trỏ vì GC: object không con trỏ được GC bỏ qua khi quét nên gộp an toàn — giữ struct nhỏ noscan (thay con trỏ bằng chỉ số khi hợp) vừa được gộp tiết kiệm bộ nhớ vừa giảm việc cho GC.
Bài tập làm thử
Bài 1 (đọc hiểu). Cho bốn kiểu dưới đây, hãy dự đoán kiểu nào được tiny allocator gộp (đi qua tiny) và ước lượng bộ nhớ thực tế mỗi object, dựa theo ba điều kiện và số liệu đo trong bài.
type B1 struct{ A int8 }             // 1 byte, không con trỏ
type P8 struct{ P *int32 }           // 8 byte, có con trỏ
type B16 struct{ A, B int64 }        // 16 byte, không con trỏ
type B8 struct{ A, B, C, D int8 }    // 4 byte thực tế, không con trỏ (giả sử không padding thêm)
Đáp án
B1(1 byte, không con trỏ): qua tiny — nhỏ hơn 16 byte và không con trỏ. Theo số liệu đo trong bài, object 1-byte không con trỏ nén xuống đúng 1,0 byte/object (16 cái gộp trong một khối 16B).P8(8 byte, có con trỏ): không qua tiny, dù kích thước 8 byte nhỏ hơn 16 — vì chứa con trỏ, bị loại khỏi điều kiện "noscan". Dùng lớp kích thước 8 riêng, tốn 8,0 byte/object (giống trường hợp "8B CÓ con trỏ" đo trong bài).B16(16 byte, không con trỏ): không qua tiny — điều kiện là kích thước nhỏ hơn 16 byte, mà 16 đã bằng ngưỡng nên không đủ điều kiện; dùng lớp kích thước 16, tốn 16,0 byte/object.B8(4 byte, không con trỏ, giả sử không có padding thêm): qua tiny — nhỏ hơn 16 byte và không con trỏ, tương tự trường hợp "8B không con trỏ" trong bài (dù kích thước khác, nguyên lý gộp vẫn áp dụng nếu vừa chỗ trong khối 16B hiện tại).
Bài 2 (sửa lỗi). Struct dưới đây được thiết kế để lưu một cờ trạng thái nhỏ, và lập trình viên muốn nó được tiny allocator gộp để tiết kiệm bộ nhớ khi cấp phát hàng triệu cái. Nhưng vì một trường, nó bị loại khỏi tiny. Hãy chỉ ra trường gây vấn đề và sửa lại.
type Co struct {
	BatTat bool
	NhanTag *string // trỏ tới tag mô tả, ví dụ "loi", "canh-bao"
}
Đáp án
Trường NhanTag *string là một con trỏ, khiến toàn bộ struct Co mất tính "noscan" — dù tổng kích thước có thể nhỏ hơn 16 byte, nó vẫn bị loại khỏi tiny allocator vì điều kiện thứ hai ("không chứa con trỏ nào bên trong") không thoả. Theo bài viết, hướng khắc phục là thay con trỏ bằng chỉ số (index) trỏ vào một slice chứa sẵn các nhãn, vì chỉ số là int (không con trỏ):
var danhSachTag = []string{"loi", "canh-bao", "..."}

type Co struct {
	BatTat  bool
	TagIdx  int8 // chỉ số vào danhSachTag, thay cho con trỏ
}
Cách này giữ Co trong diện noscan, được tiny allocator gộp, đồng thời thân thiện với cache hơn con trỏ rời rạc.
Bài 3 (vận dụng). Một hệ thống cần cấp phát 1 triệu object đánh dấu trạng thái, mỗi object chỉ là 1 byte (bool hoặc int8), không chứa con trỏ. Dựa vào số liệu đo trong bài (937.499 object qua tiny, HeapAlloc tăng ~9,03 byte/object thay vì 16), hãy ước tính tổng bộ nhớ tiết kiệm được so với trường hợp không có tiny allocator (mỗi object chiếm một slot lớp 8-byte riêng).
Đáp án
Theo bài viết, không có tiny allocator thì mỗi object 1-byte phải chiếm nguyên một slot của lớp kích thước nhỏ nhất là 8 byte, tức 1 triệu object tốn khoảng 8 triệu byte (~8 MB, đúng theo phần mở đầu bài viết: "cấp một triệu object 1-byte tốn 8MB thay vì ~1MB"). Có tiny allocator, đo thực tế 937.499 object được gộp, HeapAlloc chỉ tăng khoảng 9,03 byte mỗi object — nghĩa là tổng khoảng 9 MB cho gần 1 triệu object (con số này gồm cả một phần overhead đo đạc, không tuyệt đối bằng 1 byte × 1 triệu). So với 16 byte/object nếu mỗi object chiếm nguyên một khối riêng không được gộp, tiny tiết kiệm khoảng 44% — và so với kịch bản không có tiny hoàn toàn (8 byte/object theo lớp kích thước nhỏ nhất), tiny tiết kiệm khoảng 8 lần cho object 1-byte, đúng như kết luận "Tiny tiết kiệm 8 lần" nêu trong bài.
Bài 4 (bẫy/đánh đổi). Một lập trình viên viết: "Tôi sẽ cố tình chèn thêm các trường _ int8 (padding thủ công) vào mọi struct nhỏ trong hệ thống để ép chúng dưới 16 byte và không chứa con trỏ, nhằm buộc chúng luôn đi qua tiny allocator." Đánh giá cách làm này dựa trên bài viết, và nêu một giới hạn của tiny allocator mà cách làm này có thể bỏ qua.
Đáp án
Cách làm này đi ngược khuyến nghị của bài viết: "Đừng cố ép mọi thứ vào tiny" — lợi ích lớn nhất của tiny allocator là tự động (struct nhỏ không con trỏ tự nhiên được gộp mà không cần lập trình viên làm gì), và không nên vặn vẹo code chỉ để lách vào cơ chế này khi chưa có bằng chứng từ profiler rằng bộ nhớ từ object nhỏ là nút thắt thật sự.
Giới hạn bị bỏ qua: tiny allocator chỉ gộp các cấp phát liên tiếp vừa chỗ trong khối 16-byte hiện tại. Nếu một cấp phát không vừa phần còn lại của khối, một khối mới bắt đầu và phần đuôi khối cũ bị bỏ phí — nghĩa là hiệu quả gộp thực tế phụ thuộc vào mẫu cấp phát (thứ tự và kích thước các lần cấp liên tiếp), không đơn thuần chỉ cần "nhỏ hơn 16 byte và không con trỏ" là chắc chắn tiết kiệm tối đa như con số lý tưởng 1,0 B/object đo được với object đồng đều 1-byte.
Phần sau ta rời cơ chế cấp phát để học công cụ đo nó cho đúng: Phần sau mổ xẻ cách đo cấp phát bằng -benchmem — đọc B/op và allocs/op cho chuẩn, các bẫy khiến benchmark nói dối, và cách viết benchmark cấp phát đáng tin.
