Bài trước ta thấy allocator ba tầng của Go cấp đối tượng nhỏ cực nhanh nhờ mcache. Bí quyết đằng sau tốc độ đó là một sự đánh đổi: Go không cấp đúng số byte bạn xin, mà làm tròn lên một trong khoảng 68 "lớp kích thước" (size class) cố định. Điều này khiến việc quản bộ nhớ nhanh và đơn giản, nhưng đẻ ra phí phạm nội bộ (internal fragmentation). Bài này đo chính xác sự làm tròn đó và dạy bạn thiết kế struct để giảm phí.
Vì sao có lớp kích thước
Nếu allocator phải cấp đúng số byte tùy ý cho mọi yêu cầu (33, 57, 1001...), nó sẽ phải quản lý một mớ hỗn độn các khối kích thước bất kỳ — chậm và dễ phân mảnh. Thay vào đó, Go định nghĩa sẵn một tập cố định các kích thước và làm tròn lên lớp gần nhất. Điều này cho phép mỗi span (dải bộ nhớ) chứa toàn các slot bằng nhau, nên cấp/thu hồi chỉ là đánh dấu slot rảnh — không cần tìm khối vừa cỡ.
Các lớp kích thước nhỏ của Go: 8, 16, 24, 32, 48, 64, 80, 96, 112, 128, 144, ... cho tới 32KB (khoảng 68 lớp). Chú ý một chi tiết: sau 32 nhảy thẳng lên 48 — không có lớp 40.
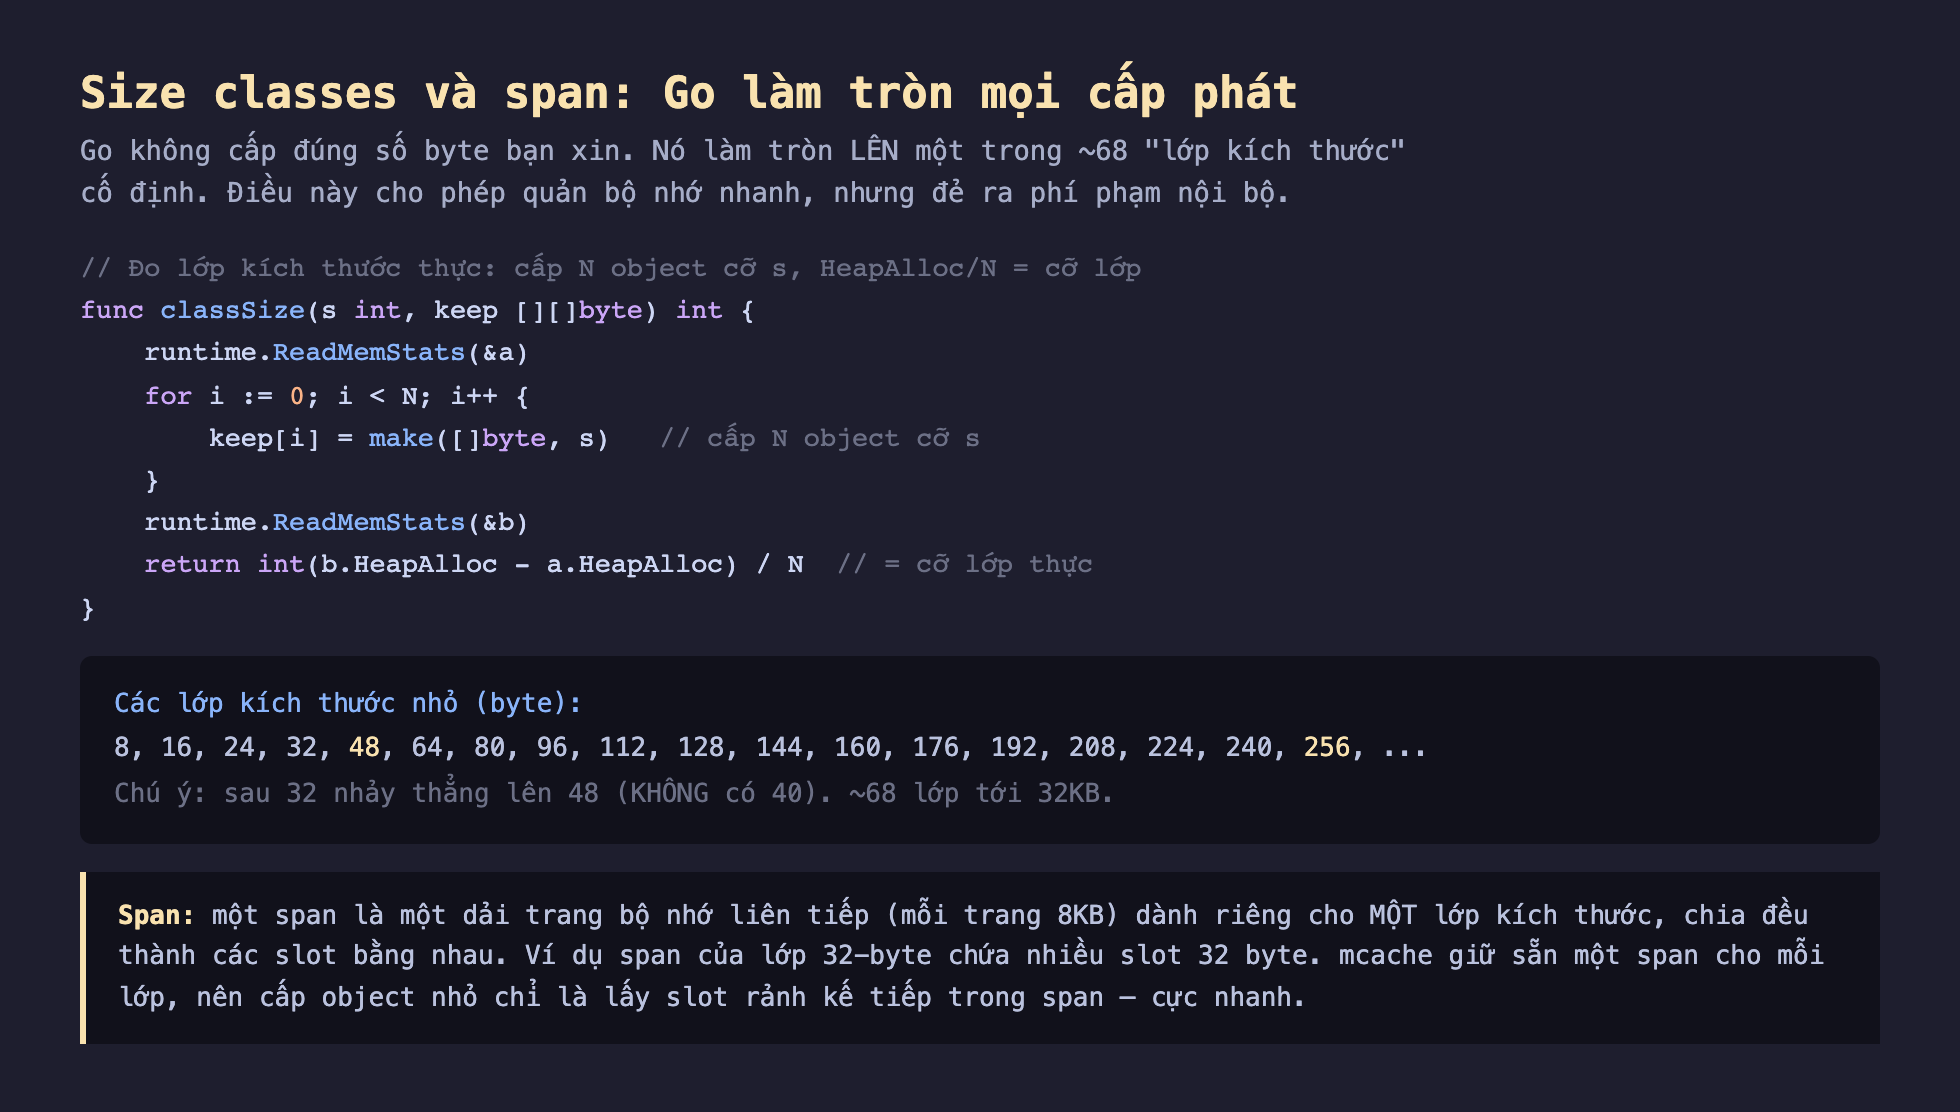
Hình 1: Go làm tròn mọi cấp phát lên lớp gần nhất. Một span là dải trang dành riêng cho một lớp, chia thành các slot bằng nhau — nên cấp object chỉ là lấy slot rảnh kế tiếp.
Đo thật: sự làm tròn và phí phạm
Cách đo trực tiếp: cấp 200.000 object của mỗi cỡ, đọc HeapAlloc trước/sau, chia cho số object ra kích thước lớp thực. (Lưu ý kỹ thuật: phải cấp mảng keep giữ tham chiếu trước khi đo, nếu không slice header của nó lẫn vào kết quả.)
runtime.ReadMemStats(&a)
for i := 0; i < N; i++ { keep[i] = make([]byte, s) }
runtime.ReadMemStats(&b)
return int(b.HeapAlloc-a.HeapAlloc) / N   // = kích thước lớp thực
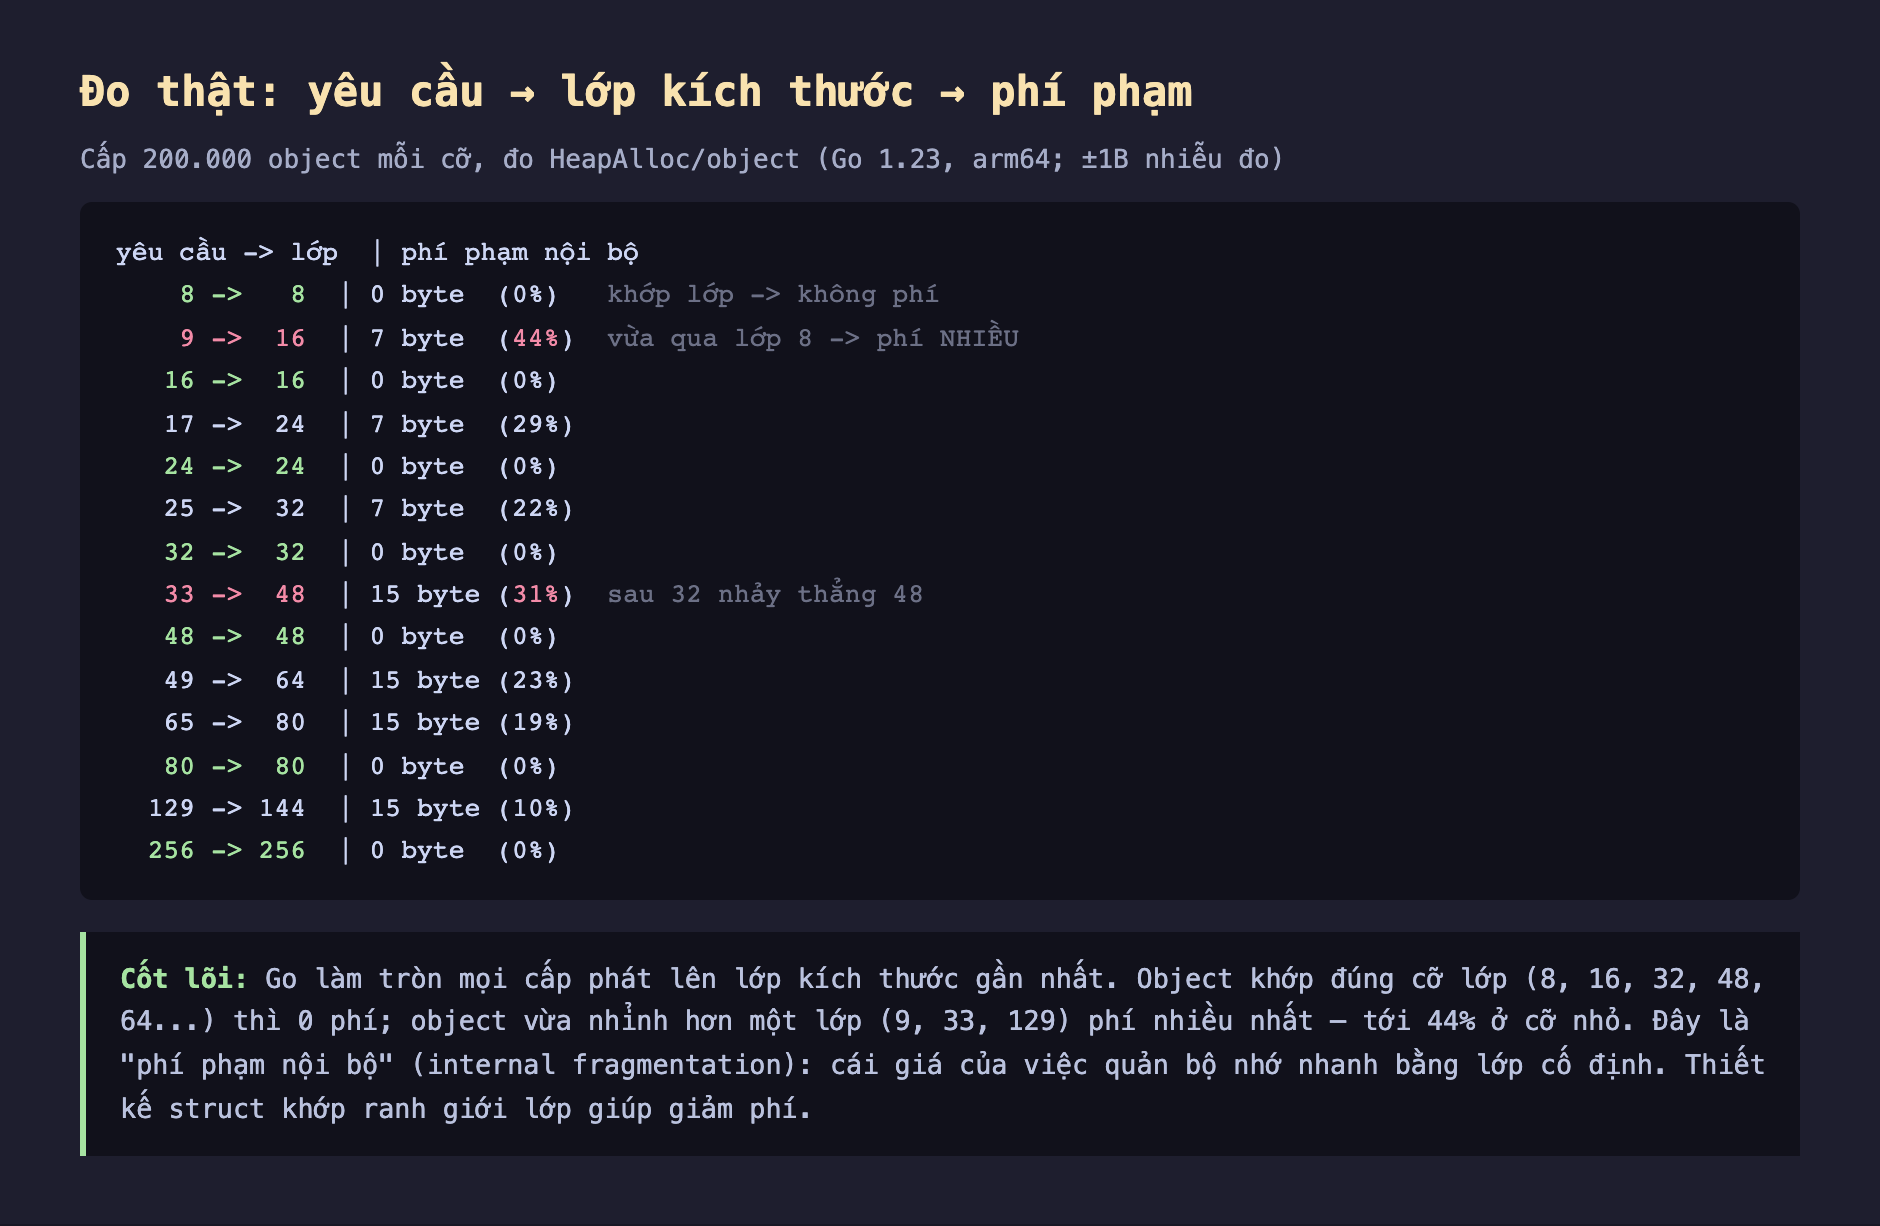
Hình 2: Object khớp lớp (8, 16, 24, 32, 48, 80, 256) tốn 0 phí. Object vừa nhỉnh hơn ranh giới lớp phí nhiều nhất: 9→16 (44%), 33→48 (31%), 49→64 (23%). Đo thật với ~1 byte nhiễu.
Kết quả rõ ràng một quy luật:
- Object khớp đúng cỡ lớp → 0 phí: xin 8 → tốn 8, xin 16 → 16, xin 32 → 32, xin 48 → 48, xin 80 → 80, xin 256 → 256.
- Object vừa nhỉnh hơn một lớp → phí nhiều nhất: xin 9 → tốn 16 (phí 7 byte, 44%!), xin 33 → tốn 48 (phí 15 byte, 31%), xin 129 → tốn 144 (10%).
Phần trăm phí giảm dần khi object lớn hơn (vì 15 byte thừa trên 256 byte chỉ là 6%), nhưng ở cỡ nhỏ nó có thể lên tới 44%. Đây chính là phí phạm nội bộ: bộ nhớ bạn trả tiền nhưng không dùng, cái giá của việc quản bộ nhớ nhanh bằng lớp cố định.
Span: đơn vị tổ chức bộ nhớ
Một span (mspan) là một dải các trang bộ nhớ liên tiếp (mỗi trang 8KB), dành riêng cho một lớp kích thước, chia đều thành các slot bằng nhau. Ví dụ, một span 8KB cho lớp 32-byte chứa 256 slot 32 byte. mcache giữ sẵn một span cho mỗi lớp, nên cấp một object nhỏ chỉ là "lấy slot rảnh kế tiếp trong span hiện tại" — không cần tính toán, không cần khoá. Khi span đầy, mcache xin span mới từ mcentral. Cấu trúc "một span, một lớp, slot bằng nhau" là thứ khiến cấp phát vừa nhanh vừa dễ cho GC quét (mọi object trong span cùng cỡ, cùng bố cục).
Ứng dụng thực tế
Thiết kế struct khớp ranh giới lớp. Nếu một struct của bạn là 33 byte, mỗi thể hiện tốn 48 byte — phí 15 byte. Cắt xuống 32 byte (khớp lớp) tiết kiệm 31% bộ nhớ cho object đó. Với struct cấp phát hàng triệu lần, chênh lệch này đáng kể cho cả bộ nhớ lẫn áp lực GC (ít byte hơn = ít cần thu gom).
Sắp xếp lại field để giảm kích thước struct. Kích thước struct phụ thuộc thứ tự field (do padding căn lề — chủ đề riêng). Đặt field lớn trước, gộp field nhỏ, có thể kéo struct từ 33 xuống 32 byte và nhảy về lớp thấp hơn. Dùng unsafe.Sizeof để kiểm.
Object đúng lũy thừa 2 hoặc bội của 16 thường khớp lớp. Buffer 64, 128, 256, 512 byte khớp chính xác các lớp — không phí. Nếu bạn tự do chọn kích thước buffer, chọn các cỡ này thay vì số lẻ như 100 hay 200.
Đánh đổi cần cân nhắc
Phí phạm nội bộ là cái giá của tốc độ — thường đáng. Đừng ám ảnh tối ưu từng byte. Lớp kích thước cố định là thứ khiến allocator nhanh và GC đơn giản; vài phần trăm phí là đổi lấy điều đó. Chỉ tối ưu khớp lớp khi struct được cấp phát ở quy mô rất lớn và profiler cho thấy bộ nhớ là nút thắt.
Không có lớp 40 (và các khoảng cách khác) là cố ý. Bộ lớp kích thước được chọn để cân bằng giữa số lượng lớp (nhiều lớp = ít phí nhưng nhiều metadata) và phí phạm. Các khoảng cách lớn hơn ở cỡ lớn (256, 288, 320...) chấp nhận nhiều phí tuyệt đối hơn vì phần trăm vẫn nhỏ.
Object >32KB không dùng size class. Chúng đi thẳng vào mheap và được cấp theo bội số trang (8KB), nên "phí phạm" của chúng là phần lẻ trang cuối. Quy tắc khớp-lớp chỉ áp cho object nhỏ và vừa (≤32KB).
Ba ý mang về
- Go làm tròn mọi cấp phát lên một trong ~68 lớp kích thước cố định (8, 16, 24, 32, 48, 64, 80...) — cho phép mỗi span chứa các slot bằng nhau, cấp/thu hồi cực nhanh và GC dễ quét.
- Object khớp cỡ lớp tốn 0 phí, object vừa nhỉnh hơn ranh giới phí nhiều nhất: đo thật, xin 9 byte tốn 16 (phí 44%), xin 33 tốn 48 (phí 31%), nhưng xin đúng 16/32/48/256 thì không phí gì.
- Thiết kế struct khớp ranh giới lớp giảm bộ nhớ và áp lực GC: kéo struct 33 byte xuống 32 tiết kiệm 31% cho object đó — nhưng chỉ đáng làm khi cấp phát ở quy mô lớn và profiler chỉ ra bộ nhớ là nút thắt.
Bài tập làm thử
Bài 1 (đọc hiểu / tính toán). Bài viết liệt kê các lớp kích thước nhỏ của Go: 8, 16, 24, 32, 48, 64, 80, 96, 112, 128, 144... (chú ý sau 32 nhảy thẳng lên 48, không có lớp 40). Nếu bạn make([]byte, 40), object này sẽ được làm tròn lên lớp nào, và phí phạm nội bộ là bao nhiêu byte / bao nhiêu phần trăm?
Đáp án
40 byte không khớp lớp nào, và lớp gần nhất lớn hơn 40 trong danh sách là 48 (vì sau 32 nhảy thẳng lên 48, không có 40). Vậy object 40 byte sẽ chiếm slot 48 byte: phí phạm = 48 − 40 = 8 byte, tương đương 8/40 = 20%.
Bài 2 (đọc hiểu số liệu). Theo bảng đo thật trong bài, hai yêu cầu "vừa nhỉnh hơn ranh giới lớp" bị phí phạm nặng nhất là gì, và tại sao phần trăm phí phạm lại giảm dần khi object lớn hơn (ví dụ xin 129 byte chỉ phí 10%)?
Đáp án
Hai trường hợp phí nặng nhất đo được: xin 9 byte → tốn 16 byte (phí 7 byte, 44%), và xin 33 byte → tốn 48 byte (phí 15 byte, 31%).
Lý do phần trăm giảm dần: số byte thừa tuyệt đối giữa các lớp liền kề có xu hướng tăng chậm hơn kích thước lớp (ví dụ chênh lệch 32→48 là 16 byte, nhưng ở lớp cao hơn như 129→144 vẫn chênh 15 byte) — cùng một lượng byte thừa tuyệt đối chiếm tỉ lệ nhỏ hơn hẳn khi so với một object đã lớn (15 byte thừa trên 256 byte chỉ là ~6%, so với 15 byte thừa trên 33 byte là 31%).
Bài 3 (sửa lỗi). Struct dưới đây chiếm 33 byte (giả sử không có padding thêm ngoài các trường), khiến mỗi thể hiện của nó bị làm tròn lên lớp 48 byte (phí 15 byte, 31%, theo số liệu đo trong bài). Hãy đề xuất cách chỉnh sửa struct để nó khớp về lớp 32 byte, khớp đúng cỡ lớp, không phí (dùng unsafe.Sizeof để kiểm chứng như bài viết gợi ý).
type BanGhi struct {
	ID      int64   // 8 byte
	DiemA   float64 // 8 byte
	DiemB   float64 // 8 byte
	TrangThai bool  // 1 byte
	// tổng logic 25 byte, nhưng padding căn lề có thể đẩy lên 33 hoặc hơn
	Co    [8]byte  // 8 byte đệm dư không cần thiết trong ví dụ này
}
Đáp án
Hướng sửa theo tinh thần bài viết ("Sắp xếp lại field để giảm kích thước struct" và "Thiết kế struct khớp ranh giới lớp"): bỏ trường đệm thừa (Co [8]byte không phục vụ mục đích gì rõ ràng ở đây) và sắp field lớn trước, field nhỏ sau để giảm padding:
type BanGhi struct {
	ID        int64   // 8 byte
	DiemA     float64 // 8 byte
	DiemB     float64 // 8 byte
	TrangThai bool    // 1 byte, được gộp padding ở cuối, tổng làm tròn về 32
}
Sau khi bỏ đệm thừa, tổng kích thước còn 25 byte logic, cộng padding căn lề sẽ được Go tự làm tròn lên bội số của trường lớn nhất (8 byte) thành 32 byte — khớp đúng lớp kích thước 32, không còn phí phạm nội bộ. Bước cuối cùng bắt buộc là dùng unsafe.Sizeof(BanGhi{}) để xác nhận con số thực tế, vì kích thước struct phụ thuộc padding chứ không chỉ tổng field.
Bài 4 (vận dụng). Bạn cần chọn kích thước cho một buffer dùng lặp lại hàng triệu lần trong chương trình. Giữa hai lựa chọn make([]byte, 100) và make([]byte, 128), cách nào tận dụng size class tốt hơn, và tiết kiệm được gì?
Đáp án
make([]byte, 128) tốt hơn vì 128 nằm đúng trong danh sách lớp kích thước nhỏ của Go (8, 16, 24, 32, 48, 64, 80, 96, 112, 128, 144...) — khớp lớp, 0 phí phạm nội bộ. Trong khi đó 100 byte không khớp lớp nào trong danh sách, sẽ bị làm tròn lên lớp lớn hơn tiếp theo (112), gây phí phạm không cần thiết. Bài viết khuyến nghị: nếu được tự do chọn cỡ buffer, ưu tiên các cỡ là luỹ thừa của 2 hoặc bội của 16 (64, 128, 256, 512...) thay vì số lẻ như 100 hay 200, vì các cỡ này thường khớp chính xác các lớp kích thước.
Bài 5 (bẫy/đánh đổi). Một lập trình viên xin bạn duyệt code, viết: "Em nhận thấy Go thiếu lớp kích thước 40, đây là một lỗ hổng cần báo cho team Go core sửa, và trong lúc chờ, em đã viết wrapper allocator riêng để tự quản các object 33-47 byte cho khỏi phí." Đánh giá đề xuất này dựa trên quan điểm của bài viết.
Đáp án
Đề xuất này đi ngược tinh thần bài viết. Bài viết nói rõ: "Không có lớp 40 (và các khoảng cách khác) là cố ý" — bộ lớp kích thước được chọn để cân bằng giữa số lượng lớp (nhiều lớp = ít phí nhưng nhiều metadata quản lý) và phí phạm, không phải lỗi hay thiếu sót. Đây không phải "lỗ hổng" cần báo cáo.
Về việc tự viết wrapper allocator: bài viết cũng cảnh báo "Đừng ám ảnh tối ưu từng byte" — phí phạm nội bộ là cái giá hợp lý đổi lấy tốc độ và đơn giản của allocator; chỉ nên tối ưu khớp lớp (ví dụ chỉnh struct) khi object được cấp phát ở quy mô rất lớn và profiler thực sự chỉ ra bộ nhớ là nút thắt — không nên tự dựng cơ chế cấp phát riêng chỉ để né vài phần trăm phí phạm mà chưa đo được lợi ích thật.
Phần sau ta soi kỹ tối ưu đã nhắc ở bài allocator: Phần sau mổ xẻ tiny allocator — cách Go gộp nhiều object dưới 16 byte không con trỏ vào chung một khối, và khi nào cơ chế này giúp (hoặc không giúp) bạn.
