Go dùng bộ thu gom rác, nhưng cấp phát bộ nhớ trong Go lại rất nhanh — nhanh tới mức make([]byte, 64) chỉ tốn khoảng 30 nanosecond. Bí mật nằm ở kiến trúc allocator ba tầng, lấy cảm hứng từ tcmalloc của Google. Bài này mổ xẻ ba tầng đó — mcache, mcentral, mheap — và đo trực tiếp điều làm nên tốc độ: đối tượng nhỏ được cấp mà không cần giành khoá nào.
Ba tầng, từ nhanh-không-khoá tới chậm-có-khoá
Ý tưởng cốt lõi giống một chuỗi kho: mỗi công nhân (P) có một tủ đồ riêng để lấy nhanh, và chỉ khi tủ cạn mới phải xuống kho chung (có người canh, tức có khoá).
- mcache — mỗi P một cái. Chứa sẵn các span (khối bộ nhớ) cho từng size class. Cấp một đối tượng nhỏ chỉ là lấy một slot từ đây — không khoá, vì không P nào khác chạm vào mcache của P này.
- mcentral — mỗi size class một cái, dùng chung cho mọi P. Khi mcache cạn một size class, nó xin một span mới từ mcentral. Bước này cần khoá (nhiều P có thể cùng xin).
- mheap — một cái duy nhất, quản toàn bộ các trang (page) bộ nhớ. Khi mcentral hết span, nó lấy trang từ mheap (cần khoá heap). mheap khi cạn thì xin thêm từ hệ điều hành (
mmap). Đối tượng lớn (>32KB) bỏ qua cache, đi thẳng vào mheap.
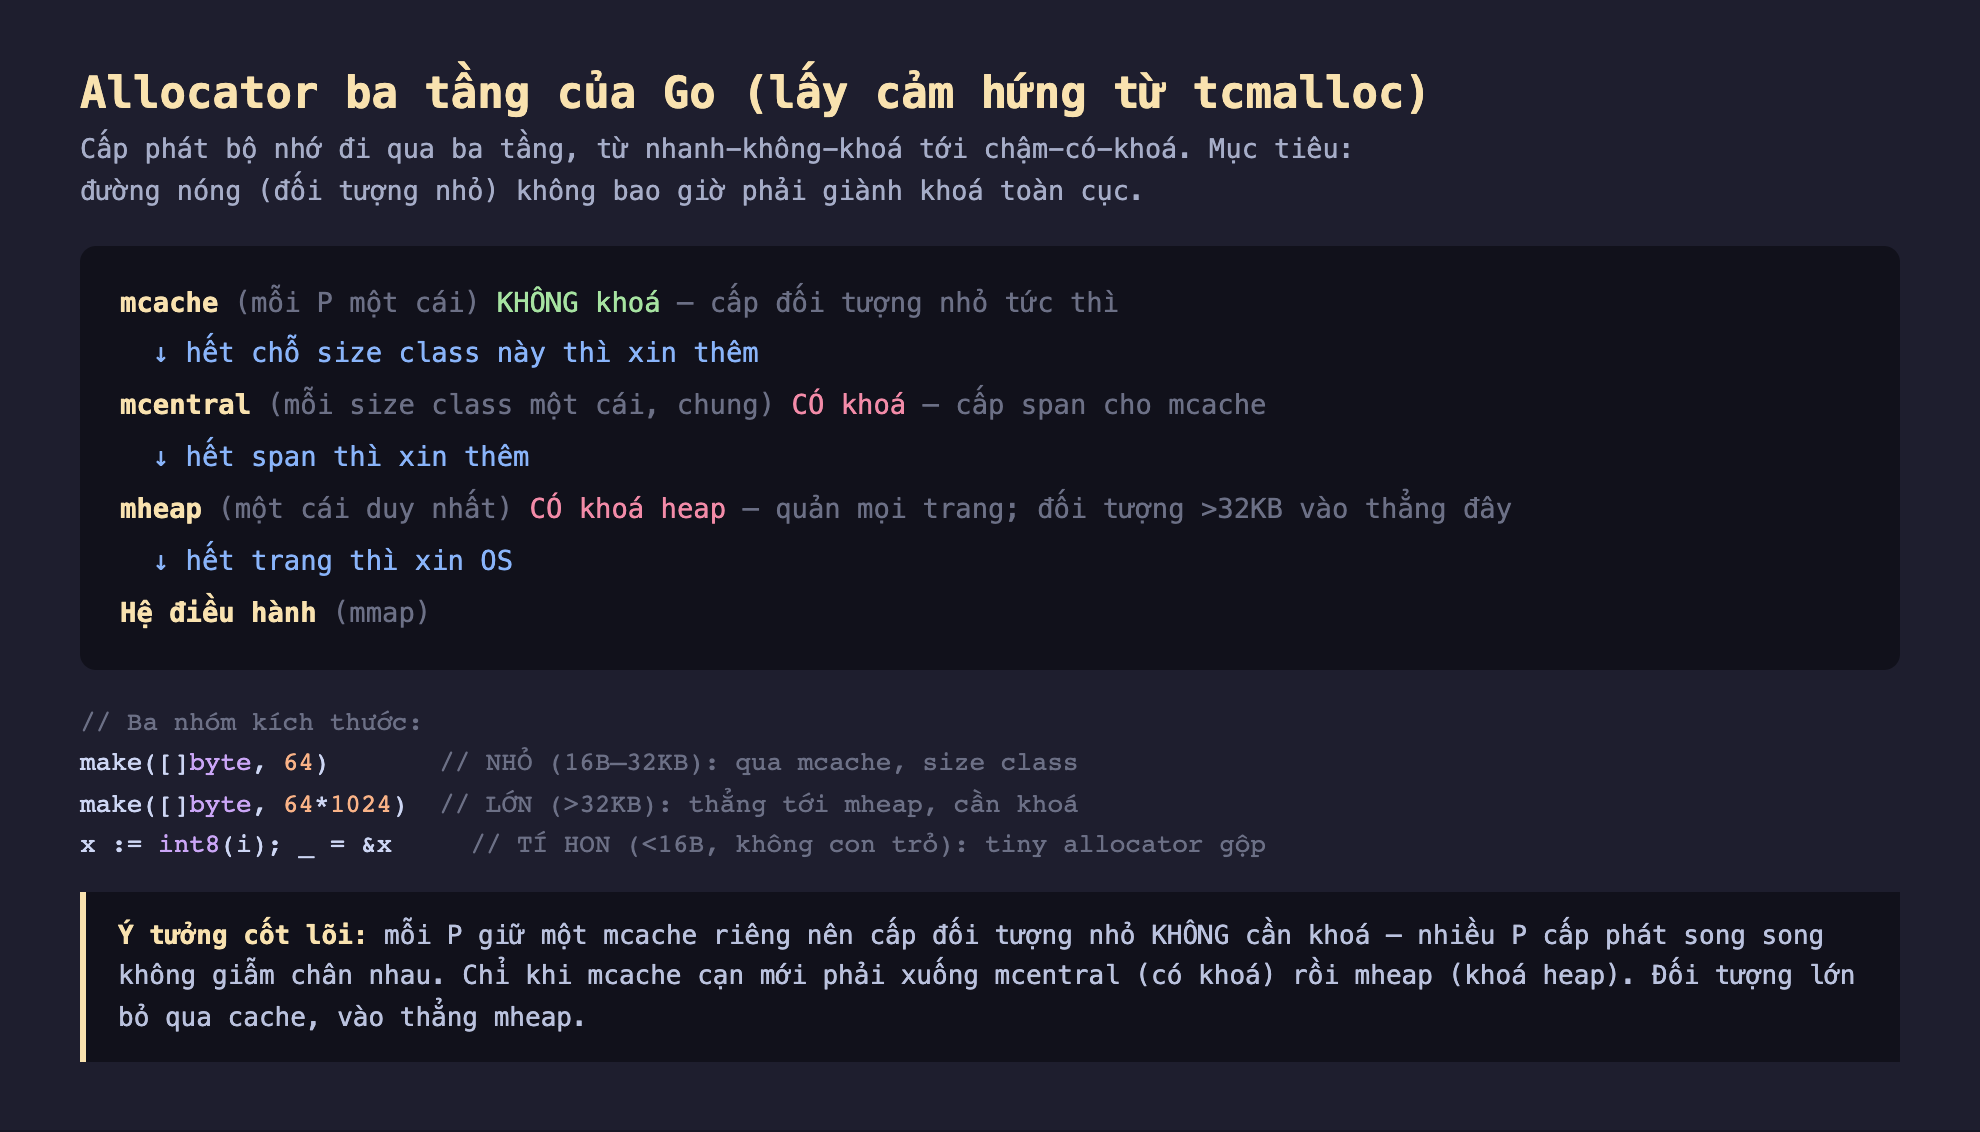
Hình 1: Ba tầng allocator. mcache (không khoá) → mcentral (có khoá) → mheap (khoá heap) → OS. Đối tượng lớn vào thẳng mheap; đối tượng tí hon được tiny allocator gộp.
Đo thật: nhỏ qua mcache, lớn qua mheap
Benchmark một cấp phát nhỏ (64 byte, thuộc size class → mcache) và một cấp phát lớn (64KB → thẳng mheap):
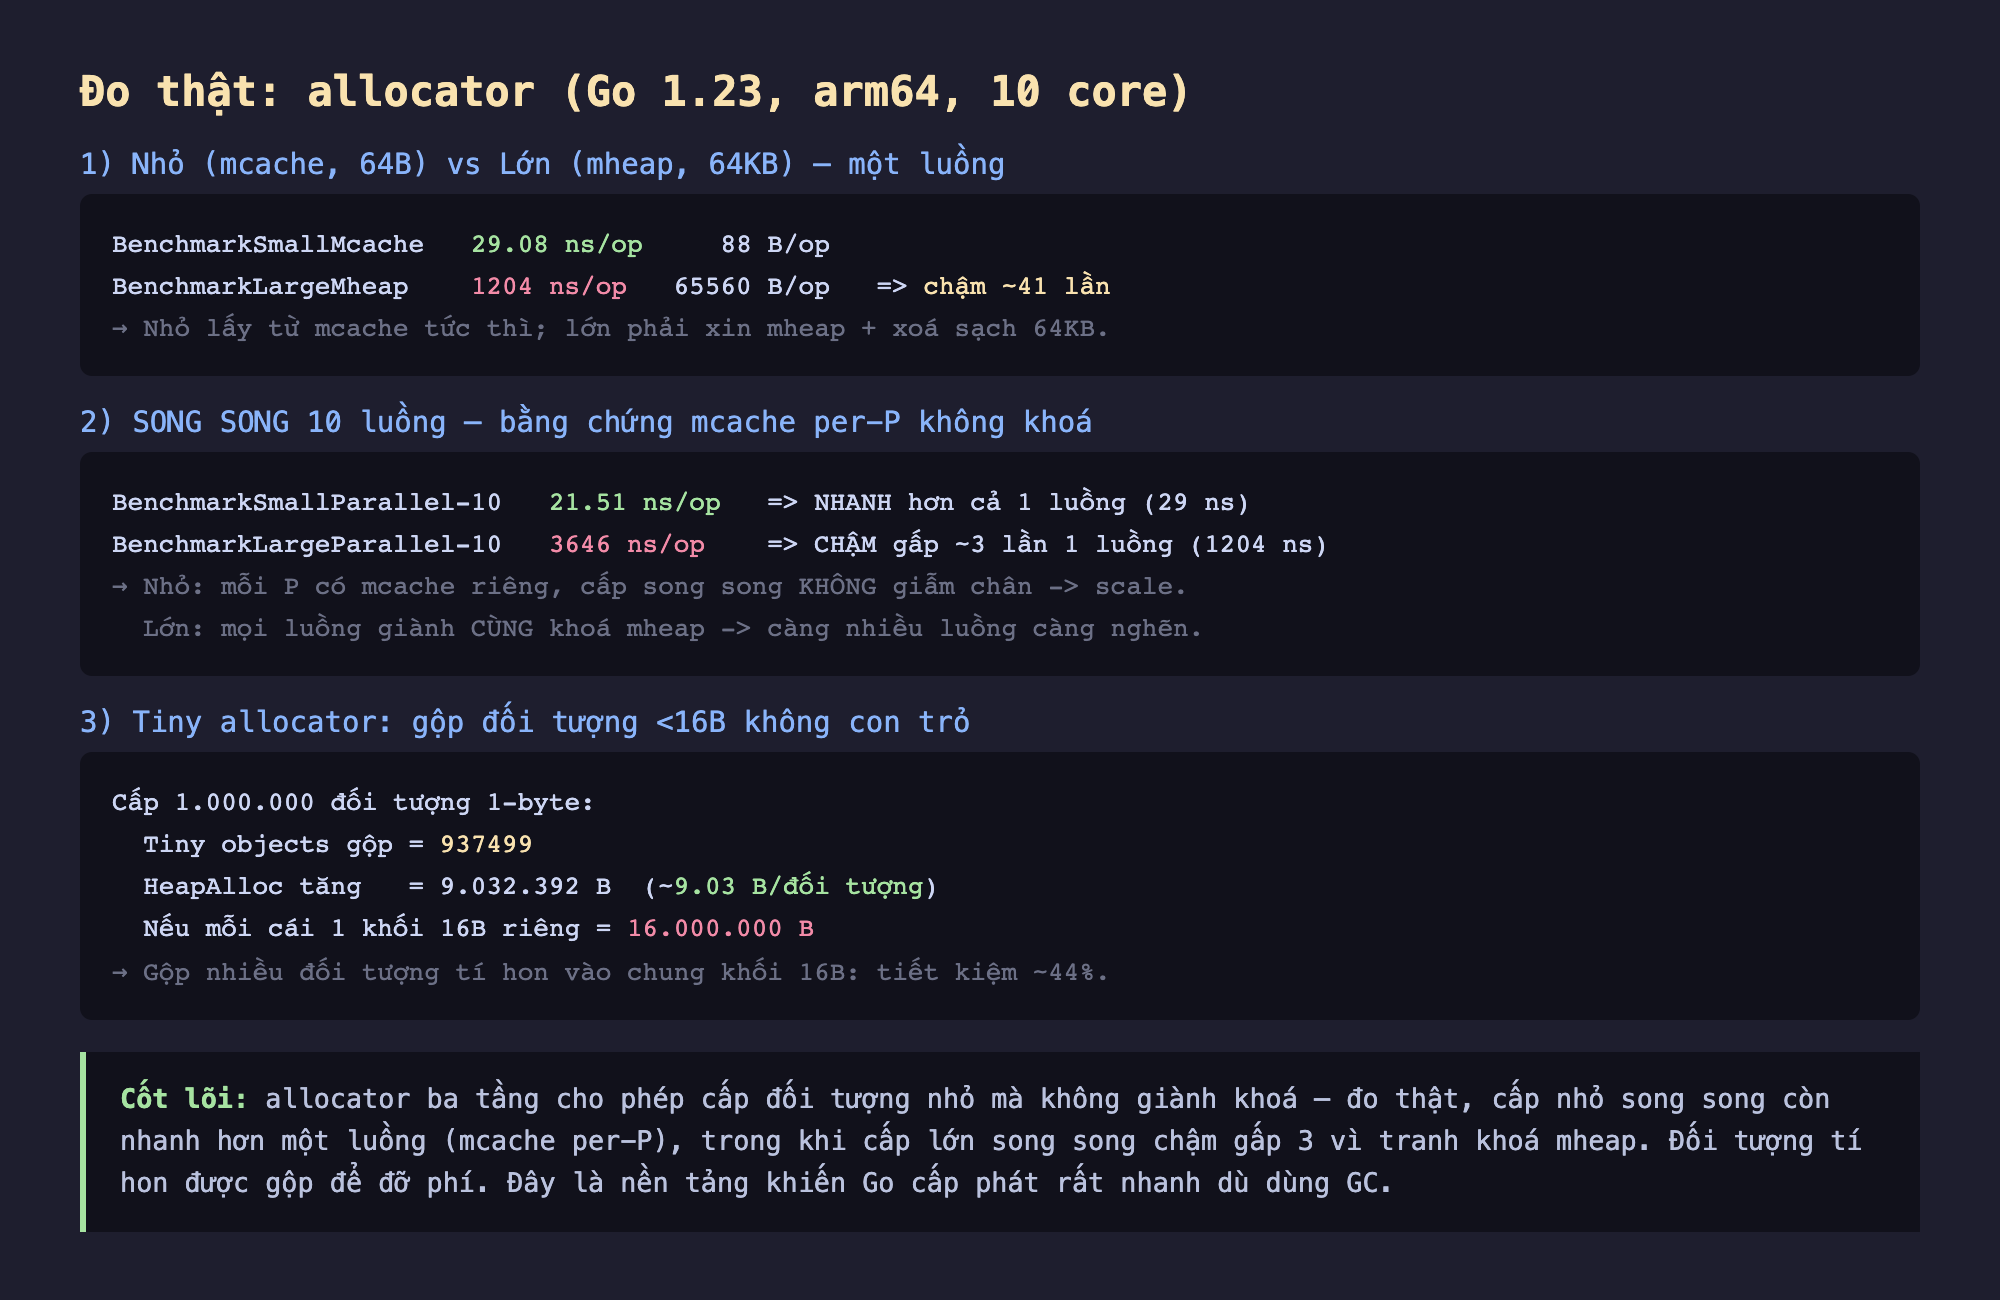
Hình 2: Nhỏ (mcache) 29 ns vs lớn (mheap) 1204 ns — chậm ~41 lần. Song song: nhỏ 21,5 ns (nhanh hơn cả 1 luồng, scale), lớn 3646 ns (chậm gấp 3, nghẽn khoá). Tiny allocator gộp 937K đối tượng.
Kết quả một luồng: cấp nhỏ 29 ns, cấp lớn 1204 ns — chậm ~41 lần. Đối tượng lớn vừa phải xin trực tiếp từ mheap (có khoá), vừa phải xoá sạch (zero) 64KB bộ nhớ trước khi trao.
Đo thật: bằng chứng mcache không khoá
Đây là phép đo hay nhất — nó chứng minh mcache là per-P và không khoá. Chạy cùng benchmark nhưng song song trên 10 luồng:
- Cấp nhỏ song song: 21,51 ns/op — nhanh hơn cả một luồng (29 ns). Vì mỗi P có mcache riêng, 10 luồng cấp phát cùng lúc không giẫm chân nhau; thông lượng scale theo số lõi.
- Cấp lớn song song: 3646 ns/op — chậm gấp ~3 lần một luồng (1204 ns). Vì mọi luồng đều phải giành cùng một khoá mheap; càng nhiều luồng càng nghẽn.
Sự tương phản này là bằng chứng trực tiếp cho kiến trúc: đường nóng (đối tượng nhỏ) đi qua mcache không khoá nên scale, còn đường phải chạm tài nguyên chung có khoá (mheap) thì degrade dưới song song. Đây chính là lý do allocator được thiết kế ba tầng — để giữ đường nóng không bao giờ phải giành khoá toàn cục.
Đo thật: tiny allocator gộp đối tượng nhỏ
Còn một tối ưu nữa cho đối tượng tí hon (<16 byte và không chứa con trỏ): tiny allocator gộp nhiều cái vào chung một khối 16 byte. Cấp 1 triệu đối tượng 1-byte và đọc runtime/metrics:
s := []metrics.Sample{{Name: "/gc/heap/tiny/allocs:objects"}}
metrics.Read(s)   // đếm số đối tượng đi qua tiny allocator
Kết quả: 937.499 đối tượng được gộp qua tiny allocator, và HeapAlloc chỉ tăng ~9,03 byte mỗi đối tượng — thay vì 16 byte nếu mỗi cái chiếm một khối riêng. Tiết kiệm khoảng 44%. Điều kiện để được gộp: đối tượng nhỏ hơn 16 byte và không chứa con trỏ (vì gộp các đối tượng có con trỏ sẽ làm phức tạp việc GC quét).
Ứng dụng thực tế
Cấp nhiều đối tượng nhỏ rẻ hơn nhiều so với vài đối tượng lớn. Nhờ mcache, một chương trình cấp hàng triệu struct nhỏ vẫn nhanh. Nhưng cấp phát lớn (buffer MB) tốn kém hơn nhiều mỗi lần — vừa vì khoá mheap, vừa vì phải zero cả khối. Nếu cần buffer lớn thường xuyên, tái dùng (như sync.Pool) thay vì cấp mới mỗi lần.
Đối tượng lớn không scale dưới song song. Nếu nhiều goroutine cùng cấp phát buffer >32KB, chúng sẽ nghẽn ở khoá mheap (đo thật chậm gấp 3). Với workload cấp phát lớn song song, cân nhắc gộp/tái dùng để giảm số lần chạm mheap.
Ngưỡng 32KB là ranh giới quan trọng. Đối tượng ≤32KB đi qua mcache (nhanh, scale); >32KB đi thẳng mheap (chậm, có khoá). Nếu một struct/buffer của bạn nằm ngay dưới ngưỡng này thì được lợi lớn về hiệu năng cấp phát so với ngay trên ngưỡng.
Đánh đổi cần cân nhắc
mcache tốn bộ nhớ cho mỗi P. Mỗi P giữ một bộ span cho mọi size class, nên tổng bộ nhớ "dự trữ" trong các mcache tỉ lệ với GOMAXPROCS. Đây là đánh đổi có chủ đích: đổi một chút bộ nhớ lấy tốc độ không-khoá. Với GOMAXPROCS rất cao, phần dự trữ này đáng kể.
Zero-ing đối tượng lớn là chi phí thật. Phần lớn 1204 ns của cấp phát 64KB là để xoá sạch bộ nhớ. Go luôn trả bộ nhớ đã zero (an toàn), nên đối tượng càng lớn, chi phí zero càng cao. Nếu bạn cấp buffer rồi ghi đè toàn bộ ngay, vẫn phải trả giá zero — không tránh được trong Go an toàn.
Kiến trúc này ẩn với lập trình viên — và nên thế. Bạn không điều khiển trực tiếp mcache/mcentral/mheap; runtime lo hết. Việc của kỹ sư là hiểu để giải thích các con số (vì sao cấp nhỏ scale còn lớn không) và ra quyết định thiết kế (tái dùng buffer lớn, tránh cấp phát lớn song song), chứ không phải chỉnh trực tiếp.
Ba ý mang về
- Allocator Go có ba tầng: mcache (mỗi P, không khoá) → mcentral (mỗi size class, có khoá) → mheap (một cái, khoá heap) → OS. Đối tượng nhỏ lấy từ mcache tức thì; lớn (>32KB) vào thẳng mheap.
- mcache không khoá là nguồn tốc độ: đo thật, cấp đối tượng nhỏ song song trên 10 luồng còn nhanh hơn một luồng (21,5 vs 29 ns) vì mỗi P có cache riêng — trong khi cấp lớn song song chậm gấp 3 (3646 vs 1204 ns) vì tranh khoá mheap.
- Tiny allocator gộp đối tượng <16B không con trỏ: đo thật 937K đối tượng gộp còn ~9 byte/cái thay vì 16 — và đối tượng lớn nên tái dùng (
sync.Pool) vì vừa tốn khoá mheap vừa tốn zero cả khối.
Phần sau ta đi sâu vào chính hệ thống phân loại kích thước mà allocator dùng: Phần sau mổ xẻ size classes và span — Go có bao nhiêu lớp kích thước, vì sao có phí phạm nội bộ (internal fragmentation), và cách chọn kích thước struct để khớp lớp.
