Hai phần đầu đo namespace, cơ chế cô lập cái mà một container thấy: tiến trình, mạng, hostname. Phần này chuyển sang cơ chế thứ hai của container, hoàn toàn độc lập với namespace: cgroups, thứ giới hạn cái mà container dùng. Và không có tài nguyên nào bị hiểu nhầm nhiều như CPU. Lập trình viên hay nghĩ --cpus=0.5 cho container "nửa cái lõi", như thể nó chạy trên một CPU chậm hơn; thực tế cơ chế khác hẳn, và sự khác biệt đó giải thích một trong những sự cố khó hiểu nhất của backend: một service chạy mượt trên máy dev nhưng chậm hoặc timeout trong container production, dù CPU của host còn rảnh rỗi. Bài này đo chính xác --cpus làm gì, vì sao nproc lừa dối, và vì sao siết CPU quá chặt làm độ trễ phình lên phi tuyến.
Hạn ngạch CPU, không phải ít lõi hơn
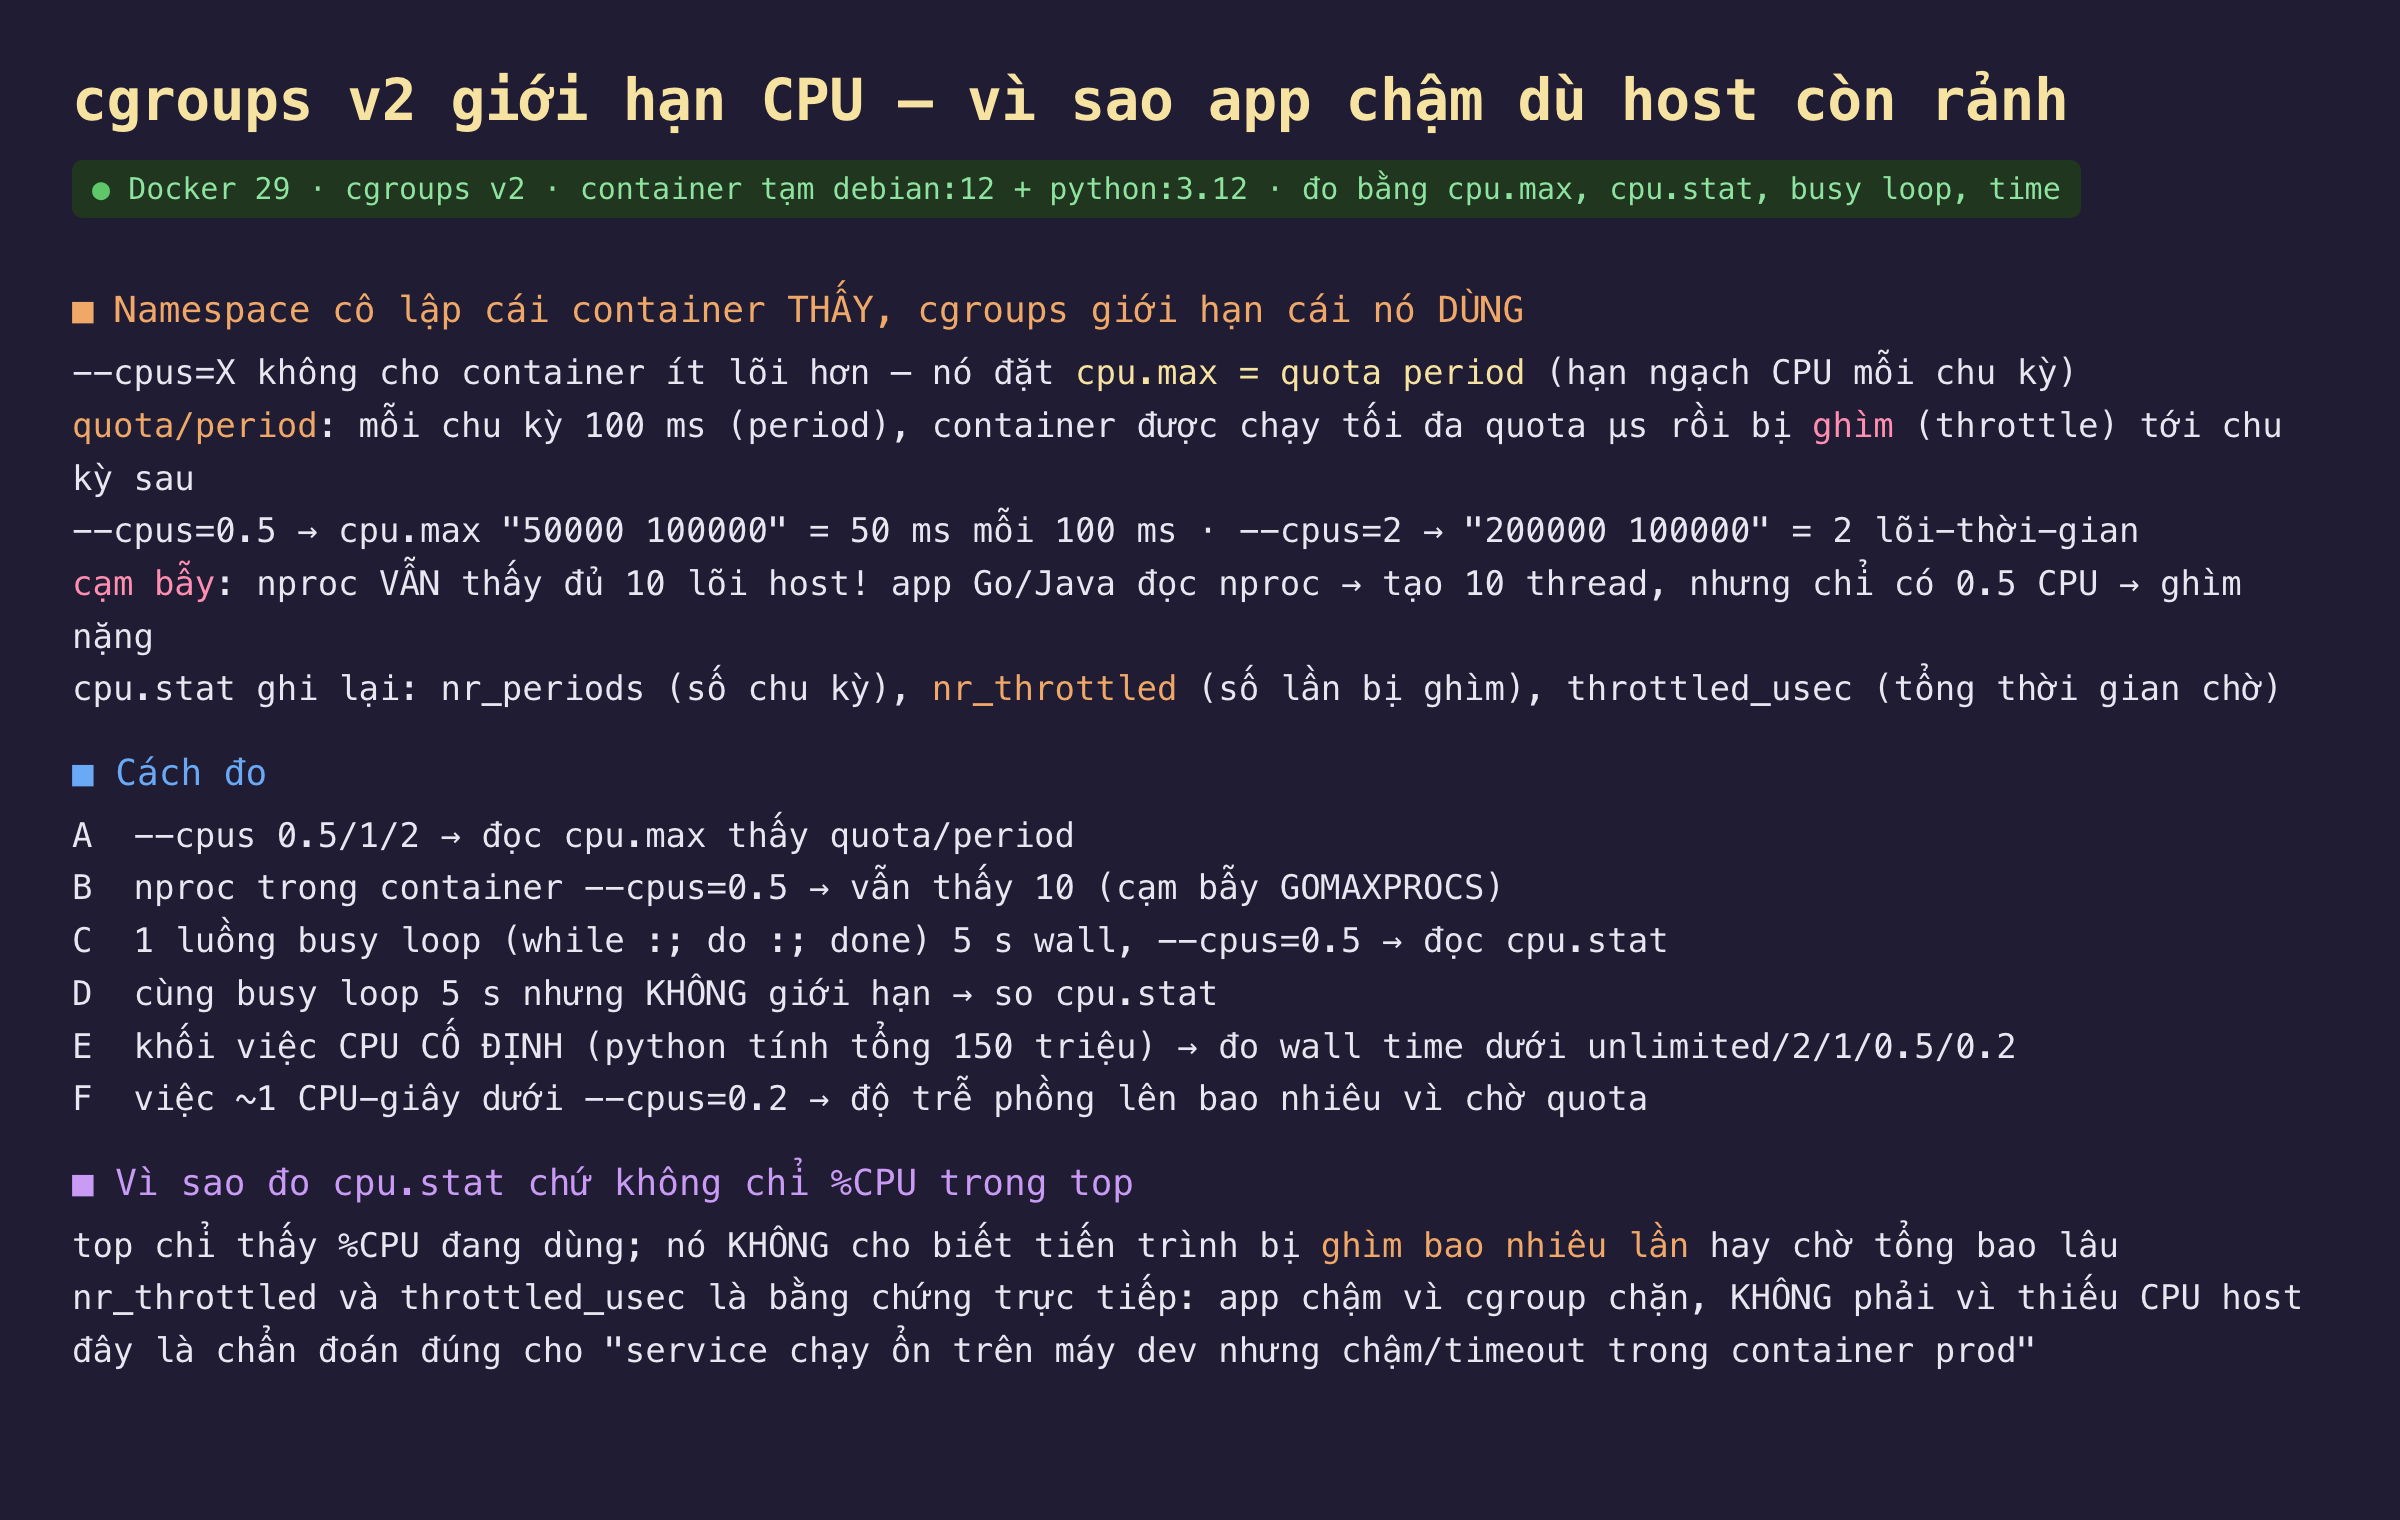
Hình 1: cgroups đặt cpu.max là hạn ngạch chứ không phải số lõi, cạm bẫy nproc, và cách cpu.stat ghi lại việc bị ghìm.
Điều quan trọng nhất cần hiểu: --cpus=X không làm container thấy ít lõi hơn hay chạy trên CPU chậm hơn. Nó đặt một tham số cgroups tên cpu.max dưới dạng quota period, một cơ chế hạn ngạch theo thời gian. Period mặc định là 100 mili giây; trong mỗi chu kỳ 100 ms đó, các tiến trình của container được phép dùng CPU tối đa quota micro giây, và khi đã dùng hết hạn ngạch, kernel ghìm chúng lại, bắt ngồi chờ tới đầu chu kỳ sau mới cho chạy tiếp. --cpus=0.5 đặt cpu.max thành 50000 100000, tức 50 ms chạy mỗi 100 ms; --cpus=2 thành 200000 100000, tức được dùng tổng 200 ms CPU mỗi 100 ms thực, nghĩa là hai lõi-thời-gian chạy song song. Đây là lý do một tiến trình đơn luồng dưới --cpus=2 không nhanh hơn dưới --cpus=1: nó chỉ dùng được một luồng, mà một luồng tối đa là 100 ms mỗi 100 ms.
Cạm bẫy lớn nhất của cơ chế này là nproc, và các hàm tương đương như runtime.NumCPU() của Go hay Runtime.availableProcessors() của Java, vẫn báo đủ số lõi của host, không phản ánh hạn ngạch cgroups. Một ứng dụng Go đọc nproc thấy 10 sẽ đặt GOMAXPROCS=10 và chạy 10 luồng hệ điều hành song song; một ứng dụng Java tính kích thước thread pool theo số lõi cũng tạo chừng ấy luồng. Nhưng nếu container chỉ có --cpus=0.5, cả 10 luồng đó tranh nhau một hạn ngạch 50 ms mỗi 100 ms, và kết quả là ghìm nặng với overhead chuyển ngữ cảnh lớn. Để đo cho đúng, không thể dựa vào top vì top chỉ cho biết phần trăm CPU đang dùng; cần đọc cpu.stat, nơi ghi nr_periods (số chu kỳ đã qua), nr_throttled (số chu kỳ mà container bị ghìm), và throttled_usec (tổng thời gian bị bắt chờ). Ba con số này là bằng chứng trực tiếp rằng app chậm vì cgroups chặn, không phải vì host thiếu CPU.
Đo thật: 6 giây thành 77 giây, bị ghìm 50 trên 51 chu kỳ
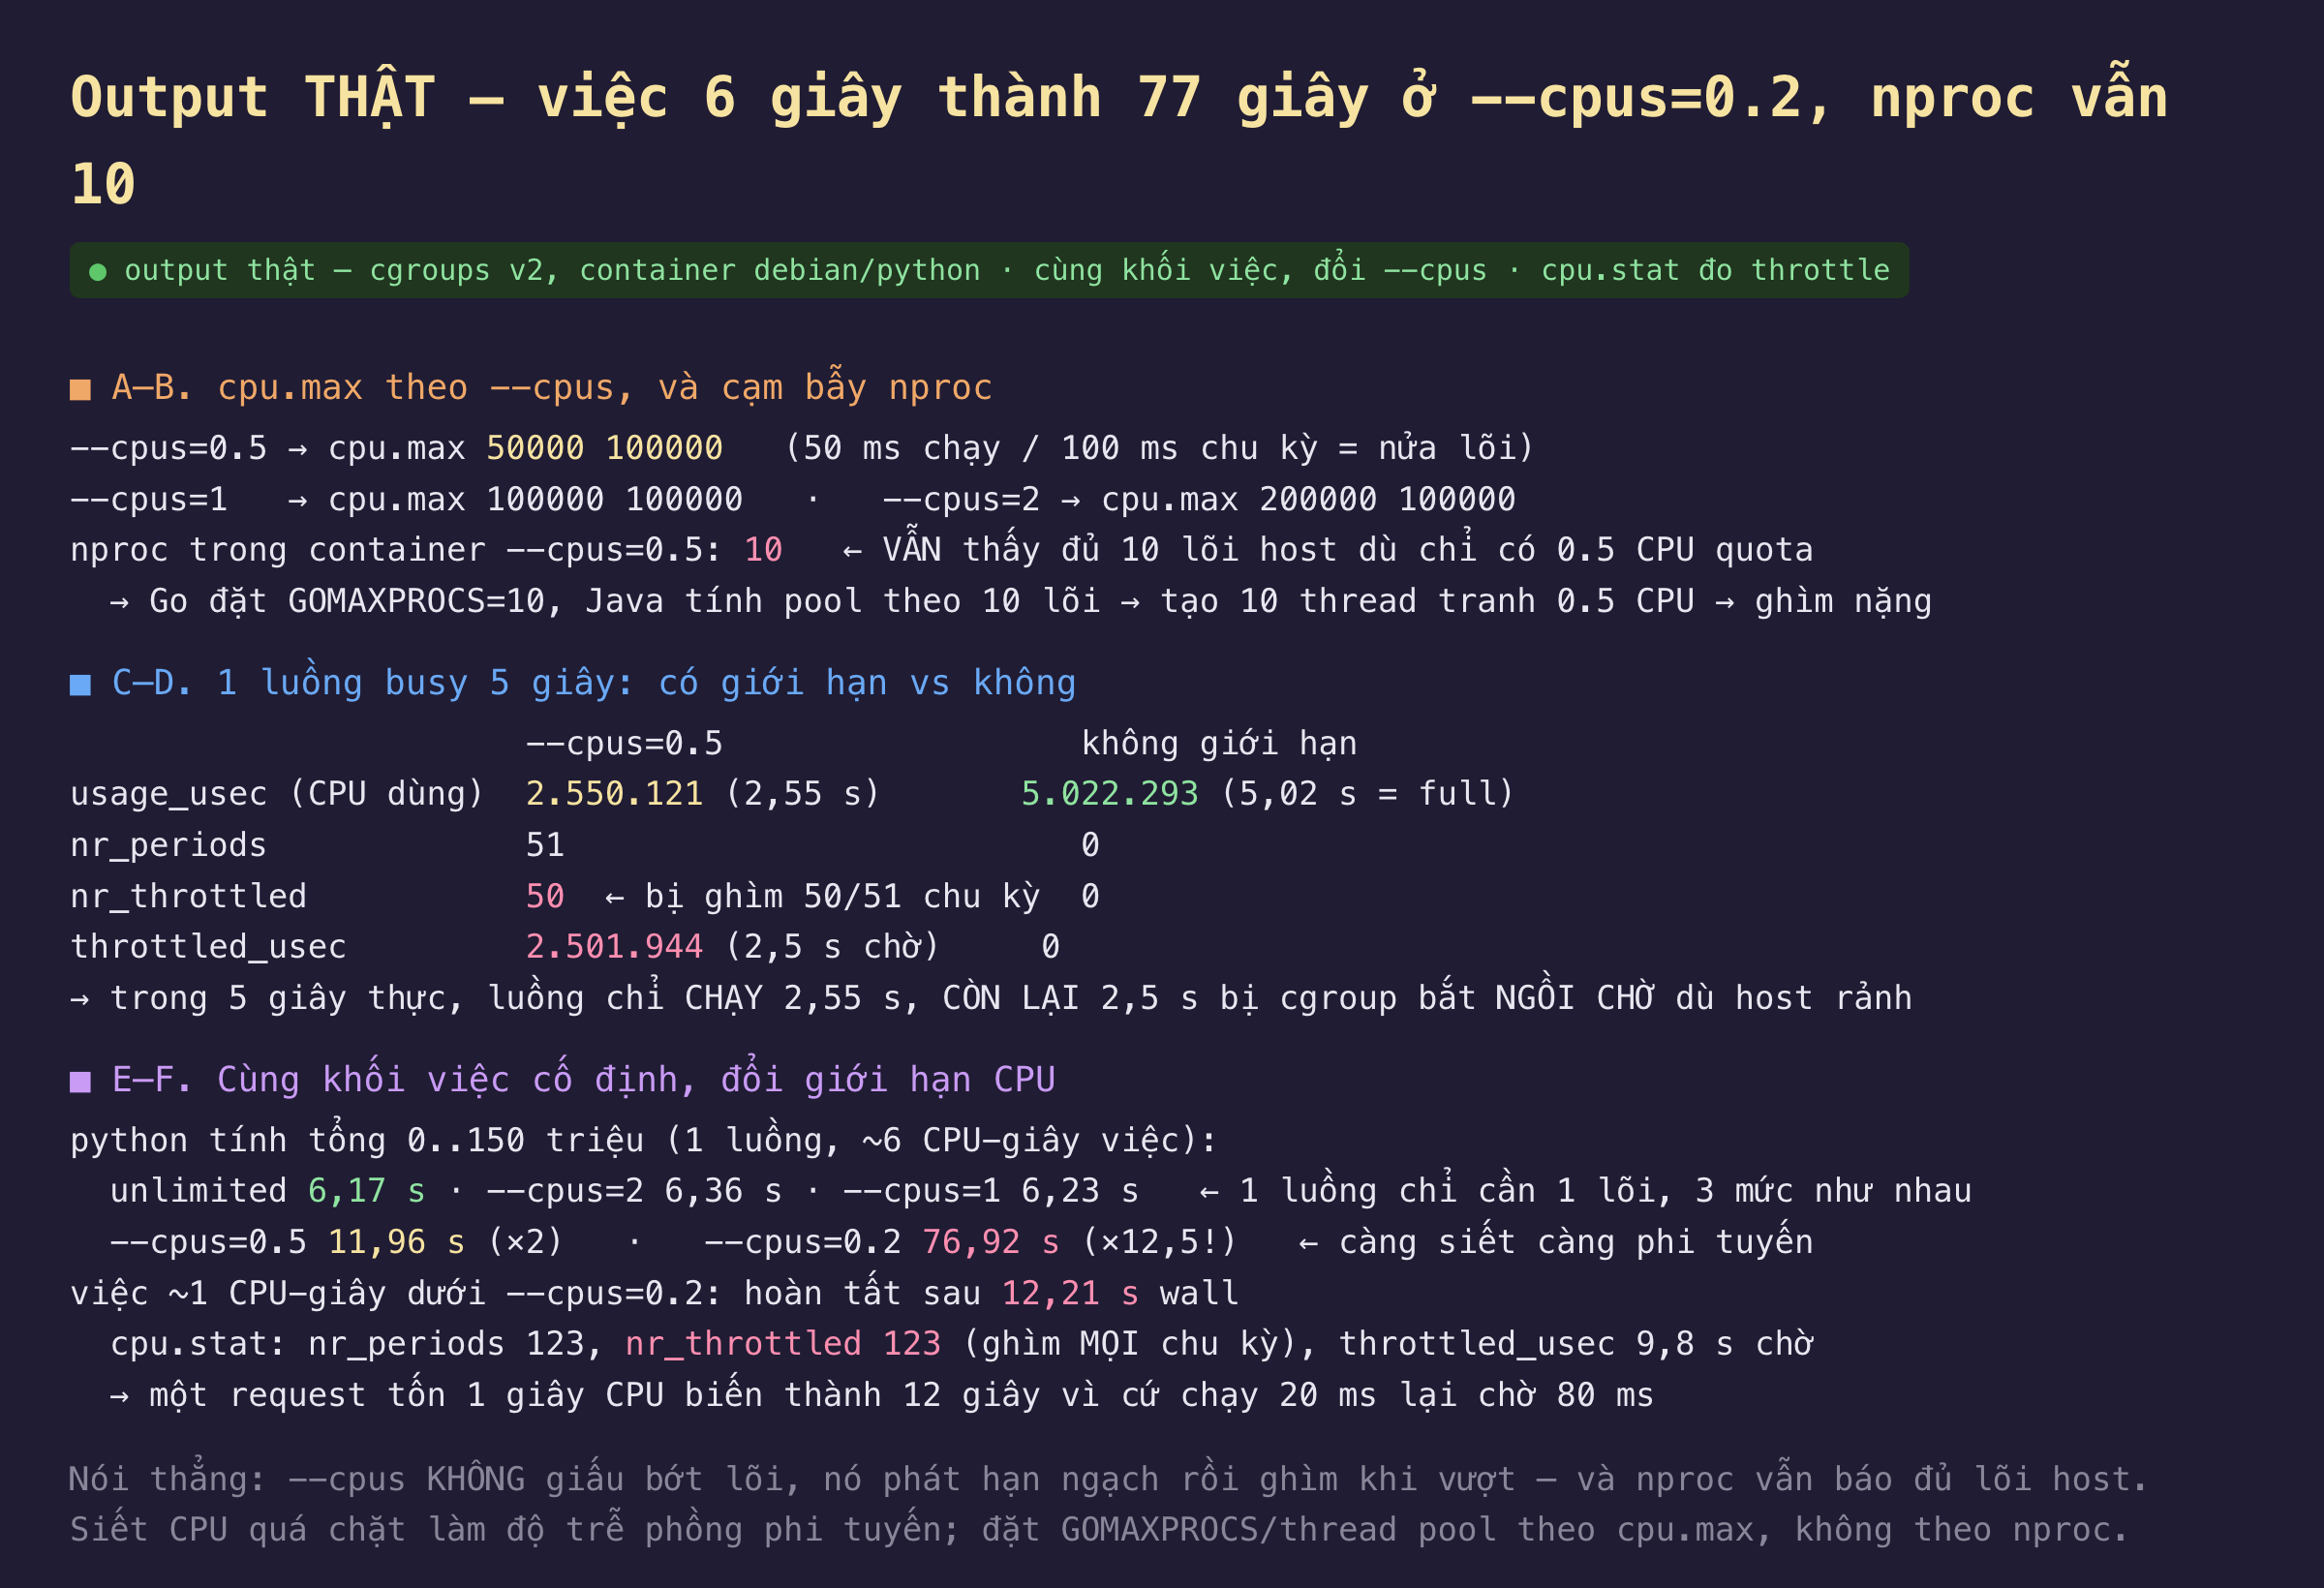
Hình 2: cpu.max theo --cpus, cạm bẫy nproc, việc bị ghìm qua cpu.stat, và cùng khối việc phình phi tuyến khi siết CPU.
| phép đo | kết quả |
|---|---|
--cpus=0.5 / 1 / 2 → cpu.max |
50000 100000 / 100000 100000 / 200000 100000 |
| nproc trong container --cpus=0.5 | 10 (đủ lõi host, không phản ánh hạn ngạch) |
| 1 luồng busy 5 s, --cpus=0.5: CPU dùng | 2,55 s (chỉ nửa), còn lại chờ |
| cùng busy 5 s, nr_throttled / throttled_usec | 50/51 chu kỳ / 2,5 s chờ |
| không giới hạn: CPU dùng / nr_throttled | 5,02 s (full) / 0 |
| khối việc ~6 s: unlimited / 1 / 2 CPU | 6,17 / 6,23 / 6,36 s (như nhau) |
| cùng khối việc: --cpus=0.5 / 0.2 | 11,96 s / 76,92 s |
--cpus đặt hạn ngạch, và các con số cpu.max chứng minh điều đó. --cpus=0.5 cho cpu.max là 50000 100000, --cpus=1 cho 100000 100000, --cpus=2 cho 200000 100000. Đọc theo nghĩa quota trên period: 50 ms, 100 ms, 200 ms CPU cho mỗi 100 ms thời gian thực. Không ở đâu có con số "số lõi"; container với --cpus=0.5 vẫn chạy trên đủ 10 lõi vật lý của host, chỉ là tổng thời gian nó được dùng bị giới hạn. Đây là khác biệt tinh tế nhưng quyết định: nửa CPU không phải một CPU chạy chậm một nửa, mà là một CPU chạy full tốc độ nhưng chỉ được bật một nửa thời gian, nửa còn lại bị tắt.
nproc báo 10 dù chỉ có 0,5 CPU, và đó là nguồn của vô số sự cố. Trong container --cpus=0.5, nproc vẫn trả về 10, số lõi của host. Hệ quả dây chuyền: một ứng dụng Go tự đặt GOMAXPROCS bằng runtime.NumCPU() là 10, nên nó chạy 10 goroutine trên 10 luồng OS song song; một ứng dụng Java tạo fork-join pool hay thread pool theo số lõi cũng vậy. Mười luồng này cùng tranh một hạn ngạch chỉ đủ cho nửa luồng, nên chúng liên tục bị ghìm, và tệ hơn, chi phí chuyển ngữ cảnh và tranh khoá giữa chúng tăng lên trong khi hạn ngạch không đổi. Đây là lý do nhiều hướng dẫn triển khai khuyên đặt GOMAXPROCS hoặc kích thước thread pool theo cpu.max chứ không theo nproc; thư viện như automaxprocs của Uber ra đời chính để đọc cgroups và đặt GOMAXPROCS đúng. Java 10 trở đi có nhận biết cgroups tốt hơn cho một số tính toán, nhưng vẫn cần kiểm.
Một luồng chạy 5 giây thực chỉ dùng được 2,55 giây CPU, bị ghìm 50 trên 51 chu kỳ. Chạy một busy loop đơn luồng trong 5 giây thực dưới --cpus=0.5: cpu.stat cho usage_usec là 2.550.121, tức 2,55 giây CPU, đúng một nửa thời gian thực; nr_periods 51, nr_throttled 50, nghĩa là trong 51 chu kỳ 100 ms, nó bị ghìm ở 50 chu kỳ; và throttled_usec 2.501.944, tức 2,5 giây bị bắt ngồi chờ. So với cùng busy loop không giới hạn: usage_usec 5.022.293, dùng trọn 5 giây, nr_throttled bằng 0. Bức tranh rõ ràng: cgroups không làm tiến trình chạy chậm hơn mỗi khi nó chạy, mà bắt nó dừng lại nửa thời gian, và host hoàn toàn rảnh trong lúc nó bị bắt chờ. Đây chính xác là thứ mà top không cho thấy: top sẽ hiển thị container dùng khoảng 50% một CPU, trông bình thường, trong khi sự thật là nó đang bị chặn liên tục.
Cùng một khối việc, siết CPU làm thời gian phình phi tuyến. Một tính toán đơn luồng cố định, cộng dãy số tới 150 triệu, cần khoảng 6 giây CPU. Chạy nó dưới các giới hạn khác nhau: không giới hạn 6,17 giây, --cpus=2 6,36 giây, --cpus=1 6,23 giây, ba mức gần như y hệt vì một luồng chỉ cần một lõi và cả ba đều cấp đủ một lõi. Nhưng --cpus=0.5 cho 11,96 giây, gấp đôi, đúng như kỳ vọng với nửa hạn ngạch; và --cpus=0.2 cho 76,92 giây, gấp 12,5 lần, nhiều hơn mức tuyến tính gấp 5 mà hạn ngạch 1/5 gợi ý. Phần dư là chi phí của chính việc bị ghìm: với hạn ngạch rất nhỏ, tiến trình chạy một đoạn ngắn rồi ngủ phần lớn chu kỳ, và tổng chi phí đánh thức, lập lịch lại, hâm nóng cache mỗi lần chạy tiếp cộng dồn thành một khoản không nhỏ. Siết CPU càng chặt, hiệu suất càng tệ hơn mức tỉ lệ.
Một request tốn 1 giây CPU có thể biến thành 12 giây độ trễ. Chạy một tác vụ cần khoảng 1 giây CPU dưới --cpus=0.2: nó hoàn tất sau 12,21 giây thực, và cpu.stat cho nr_periods 123, nr_throttled 123, bị ghìm ở mọi chu kỳ, với throttled_usec 9,8 giây. Nói cách khác, trong 12 giây đó, tác vụ thật sự chạy khoảng 2 giây và ngồi chờ gần 10 giây. Hình dung trong ngữ cảnh một API: một request xử lý cần một giây CPU, dưới một giới hạn CPU quá chặt, sẽ phản hồi sau mười hai giây, vượt mọi timeout hợp lý, dù CPU của cluster còn trống. Đây là cơ chế đằng sau các báo cáo "độ trễ đuôi p99 tăng vọt sau khi thêm CPU limit" mà nhiều đội gặp khi siết tài nguyên để tăng mật độ container. Giới hạn CPU không chỉ làm chậm trung bình, nó tạo ra các khoảng dừng rời rạc 80 ms mỗi chu kỳ, và những khoảng dừng đó rơi vào đúng đường đi của request.
Đánh đổi cần cân nhắc
Đặt limit đủ rộng, và căn theo hành vi thật của ứng dụng. Giới hạn CPU có ích để một container không chiếm hết host, nhưng đặt quá chặt là tự tạo throttling ngay cả khi host rảnh. Với workload có đợt tính toán ngắn như xử lý request, nên để limit rộng hơn mức trung bình nhiều, hoặc cân nhắc chỉ đặt cpu.shares (trọng số cạnh tranh) thay vì cpu.max (trần cứng), để container mượn được CPU rảnh của host khi cần. Kubernetes gọi hai thứ này là request và limit; nhiều hướng dẫn hiện khuyên đặt CPU request nhưng không đặt CPU limit cho workload nhạy độ trễ, chính vì cơ chế throttling bài này đo.
Đặt GOMAXPROCS và thread pool theo cgroups, không theo nproc. Vì nproc không phản ánh hạn ngạch, mọi quyết định về số luồng dựa trên nó đều sai trong container bị giới hạn. Đọc cpu.max và tính số luồng hợp lý, hoặc dùng thư viện làm việc đó tự động. Một container --cpus=2 nên chạy khoảng 2 luồng tính toán, không phải 10; chạy đúng số luồng giảm tranh chấp và chuyển ngữ cảnh, và thường nhanh hơn dù "ít song song hơn".
Phạm vi đo. Các số là của cgroups v2 với period mặc định 100 ms; period có thể chỉnh và ảnh hưởng độ mịn của throttling. Chưa đo cpu.weight, cơ chế chia CPU theo tỉ lệ khi tranh chấp, khác với cpu.max là trần cứng; chưa đo tương tác với bộ lập lịch khi nhiều container cùng chạy; và con số phình phi tuyến ở --cpus=0.2 phụ thuộc đặc tính workload, workload có nhiều I/O xen kẽ sẽ bị throttling CPU ít chạm hơn.
Ba ý mang về
--cpusđặt hạn ngạch thời gian, không giảm số lõi.--cpus=0.5là cpu.max50000 100000, 50 ms chạy mỗi 100 ms rồi bị ghìm; container vẫn chạy trên đủ lõi host nhưng chỉ được bật nửa thời gian.- nproc lừa dối, cpu.stat nói thật.
nprocbáo đủ lõi host nên app tạo quá nhiều luồng;nr_throttledvàthrottled_useclà bằng chứng trực tiếp app chậm do cgroup chặn chứ không do thiếu CPU. Đặt số luồng theo cpu.max. - Siết CPU quá chặt làm độ trễ phình phi tuyến. Khối việc 6 giây thành 12 giây ở 0.5 CPU và 77 giây ở 0.2; một request 1 giây CPU thành 12 giây độ trễ. Với workload nhạy độ trễ, cân nhắc không đặt CPU limit cứng.
Nguồn
- Linux kernel — Control Group v2, mục CPU controller (
cpu.max,cpu.stat): https://docs.kernel.org/admin-guide/cgroup-v2.html#cpu - Docker — Runtime options with Memory, CPUs, and GPUs (
--cpus): https://docs.docker.com/engine/containers/resource_constraints/#cpu - Uber — automaxprocs, đặt GOMAXPROCS theo cgroups: https://github.com/uber-go/automaxprocs
- Kubernetes — CPU limits and aggressive throttling (thảo luận throttling): https://kubernetes.io/docs/concepts/configuration/manage-resources-containers/#how-pods-with-resource-limits-are-run
- Dave Cheney / cộng đồng Go — nhận biết cgroups và GOMAXPROCS: https://go.dev/doc/godebug
- Linux
sched(7)— CFS bandwidth control, cơ chế quota/period: https://man7.org/linux/man-pages/man7/sched.7.html
Phần sau chuyển từ CPU sang bộ nhớ: --memory đặt memory.max, và khi container vượt trần, không có chuyện "chạy chậm lại" mà là OOM killer giết tiến trình. Đo memory.current tăng tới memory.max, xem ai bị chọn giết, vì sao app thấy exit code 137, và khác biệt giữa memory.max cứng và memory.high ghìm mềm.
