Phần 3 đo cgroups giới hạn CPU, nơi vượt trần chỉ làm tiến trình bị ghìm, chạy chậm lại. Bộ nhớ thì khác hẳn, và khác biệt đó là một trong những điều quan trọng nhất về container mà lập trình viên backend cần biết. Không có chuyện "dùng RAM chậm lại": khi một container chạm trần bộ nhớ và kernel không thu hồi được gì thêm, nó gọi OOM killer để giết một tiến trình. Hệ quả là exit code 137 bí ẩn mà gần như ai vận hành container cũng từng gặp, thường kèm một container tự nhiên biến mất giữa đêm. Bài này đo chính xác cơ chế đó: đặt trần bộ nhớ, cho app ngốn RAM, xem memory.current leo tới memory.max rồi OOM, ai bị giết, vì sao có khi cả container chết mà có khi không.
Trần cứng, OOM killer và exit code 137
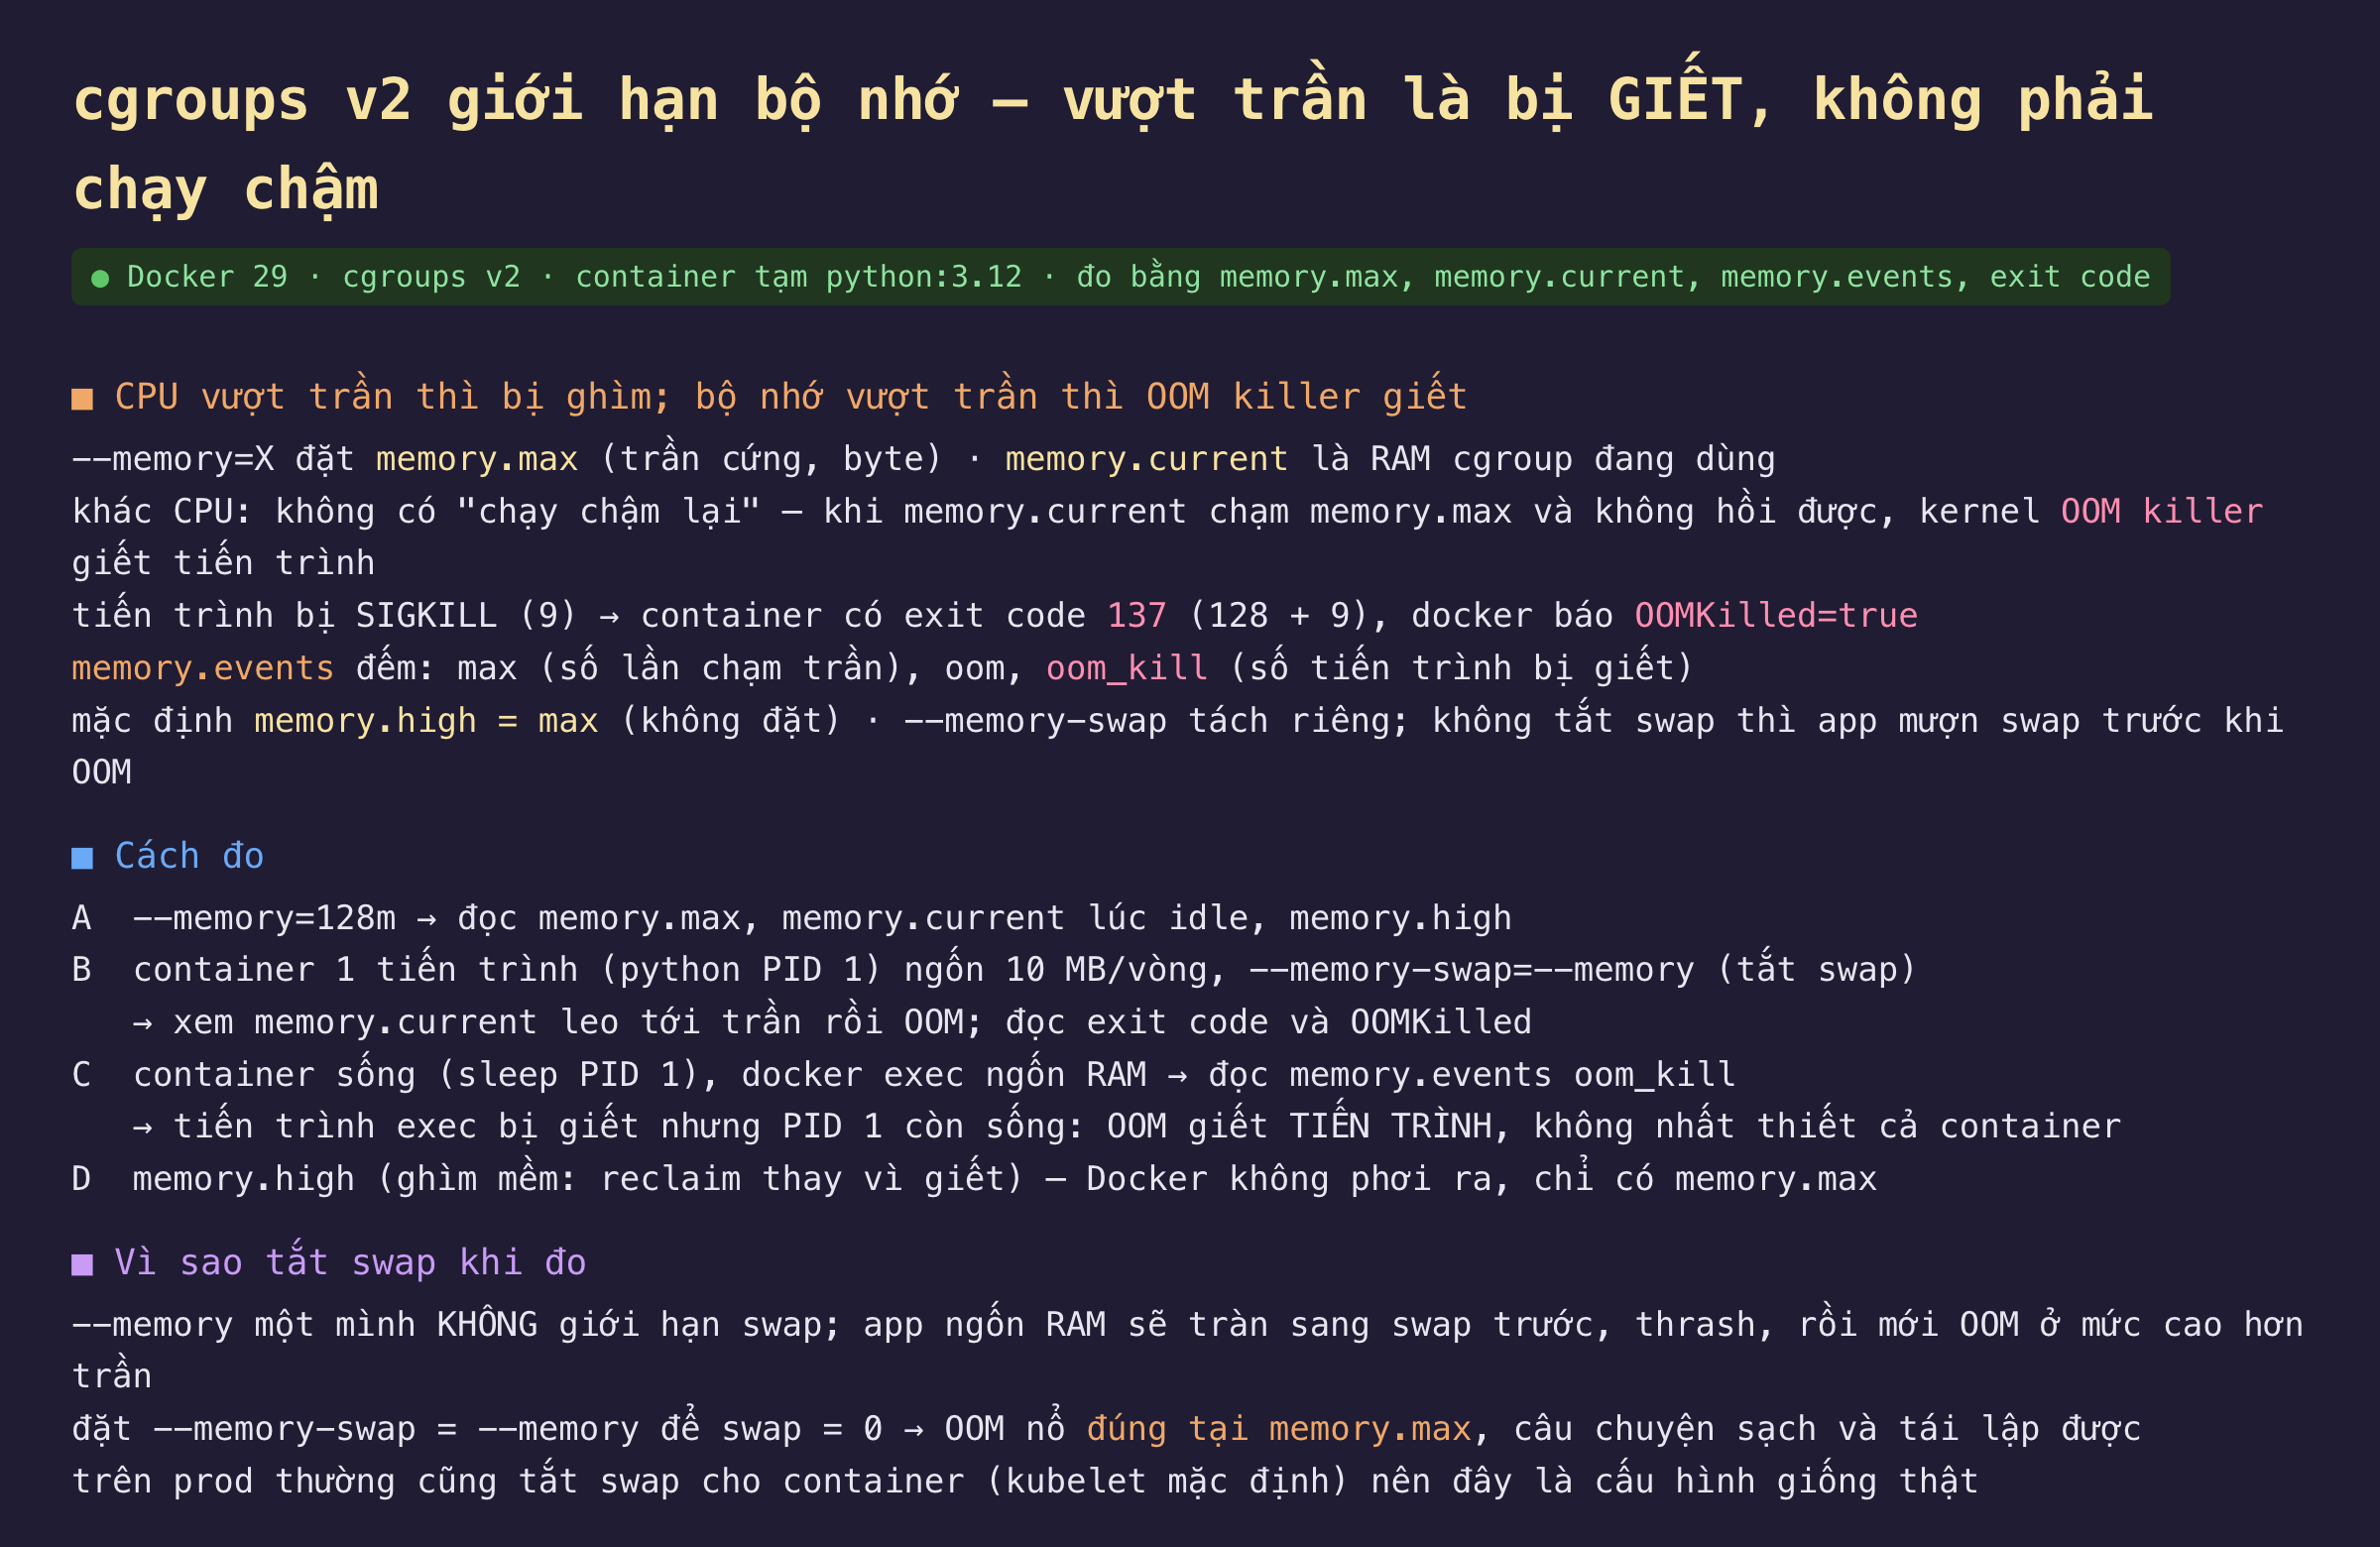
Hình 1: Bộ nhớ vượt trần thì OOM killer giết chứ không ghìm, exit code 137, và cách memory.events ghi lại.
--memory=X đặt một tham số cgroups tên memory.max, là trần cứng tính bằng byte cho tổng bộ nhớ của mọi tiến trình trong container; memory.current là lượng RAM cgroup đang thật sự dùng. Khác với CPU, không có cơ chế "chạy chậm lại khi vượt": khi memory.current chạm memory.max và kernel đã cố thu hồi cache, trang sạch, mọi thứ có thể thu hồi mà vẫn không đủ, nó kích hoạt OOM killer để giết một tiến trình trong cgroup. Tiến trình bị giết nhận tín hiệu SIGKILL, số 9, một tín hiệu không thể bắt hay bỏ qua; và theo quy ước Unix, một tiến trình chết vì tín hiệu N thì shell báo exit code 128 + N, nên container có main process bị OOM giết mang exit code 137. Docker ghi nhận riêng điều này: docker inspect cho OOMKilled=true. Bên cạnh đó, memory.events là một bộ đếm: max là số lần cgroup chạm trần (mỗi lần kernel phải thu hồi gấp), oom và oom_kill là số lần OOM killer được gọi và số tiến trình bị giết.
Có một chi tiết về swap quyết định phép đo có sạch không. --memory một mình không giới hạn swap; nếu host có swap và Docker cho phép, một container ngốn RAM sẽ tràn sang swap trước, thrash đĩa một hồi, rồi mới OOM ở một mức cao hơn trần, làm con số rối. Vì vậy bài này đặt --memory-swap bằng đúng --memory để tắt swap, cho OOM nổ đúng tại memory.max, câu chuyện sạch và tái lập được. Đây cũng gần với production: Kubernetes mặc định tắt swap cho container, nên cấu hình này giống thật hơn là để swap bật. Cách đo: đọc memory.max, memory.current, memory.high khi mới chạy; cho một container một tiến trình ngốn 10 MB mỗi vòng và xem memory.current leo tới trần rồi OOM; chạy một container sống với sleep làm PID 1 rồi docker exec một tiến trình ngốn RAM, để thấy OOM giết ai; và kiểm memory.high, cơ chế ghìm mềm mà Docker không phơi ra.
Đo thật: leo tới 128 MB rồi chết, exit 137
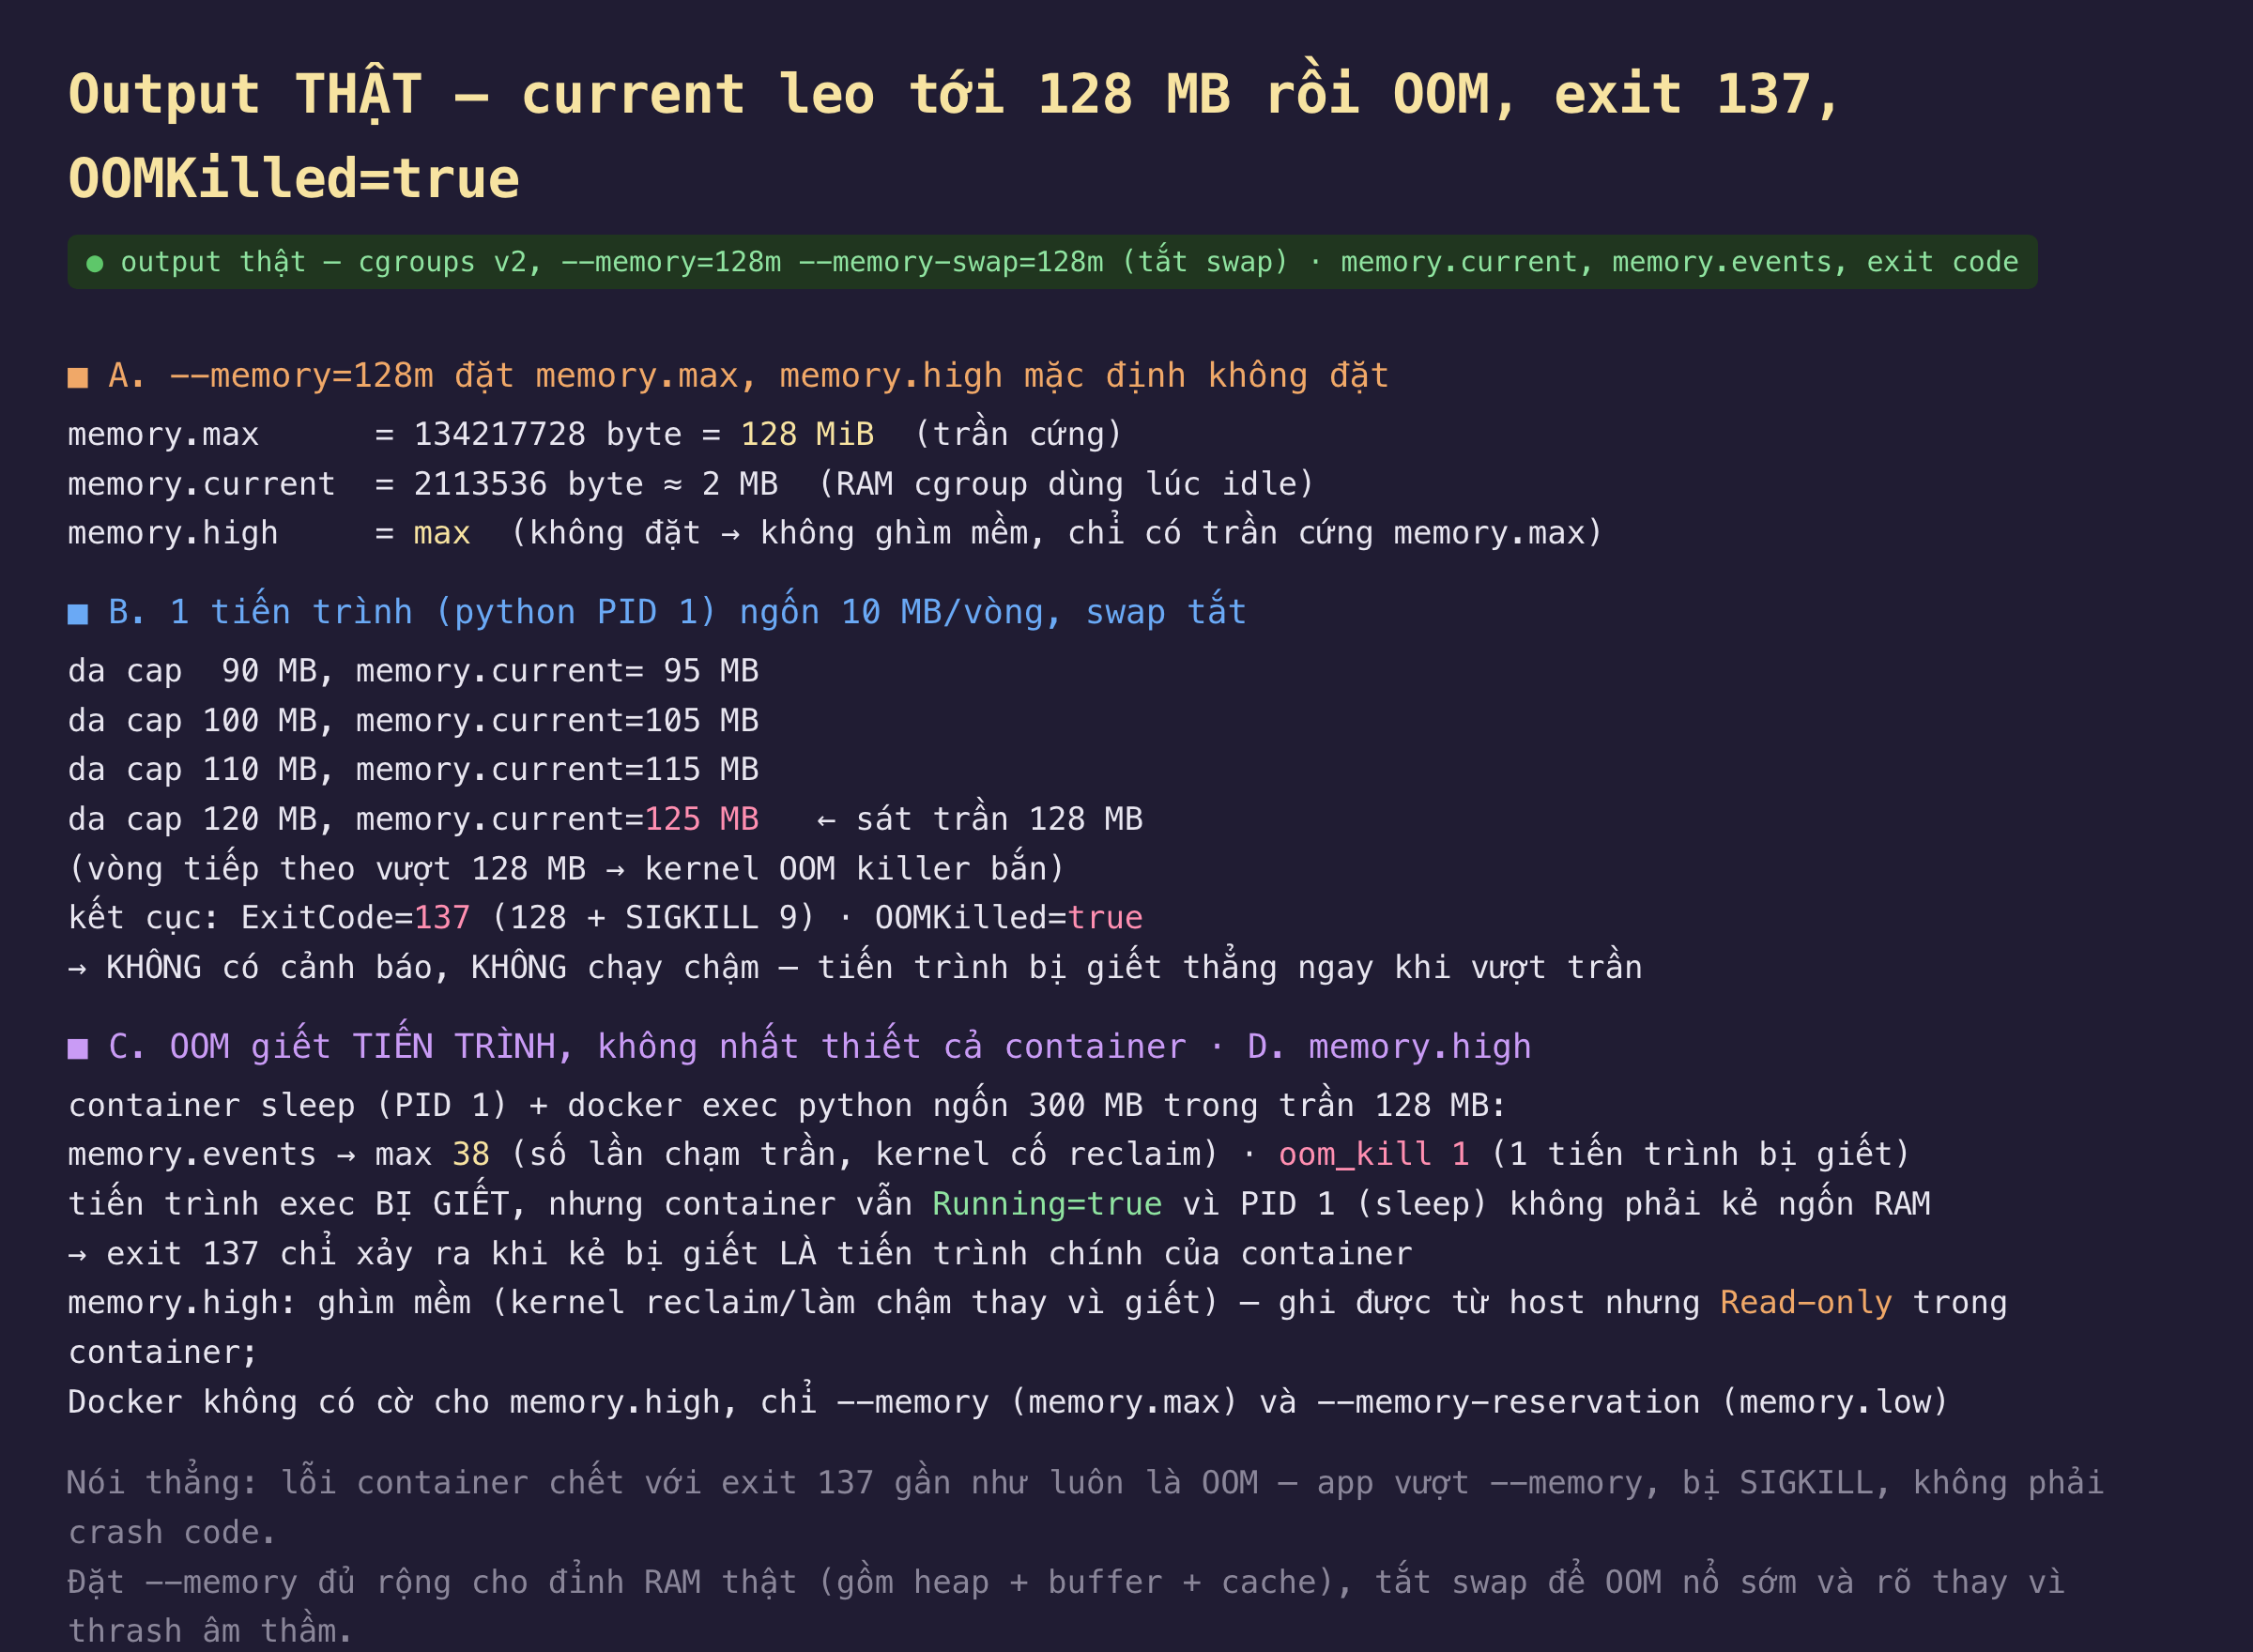
Hình 2: memory.current leo tới trần 128 MB rồi OOM với exit 137, và OOM giết tiến trình chứ không nhất thiết cả container.
| phép đo | kết quả |
|---|---|
| --memory=128m → memory.max | 134217728 byte = 128 MiB |
| memory.current lúc idle | ~2 MB |
| memory.high mặc định | max (không đặt) |
| 1 tiến trình ngốn RAM, memory.current trước OOM | leo 95 → 105 → 115 → 125 MB |
| kết cục khi vượt trần | exit 137, OOMKilled=true |
| exec ngốn RAM, memory.events | max 38, oom_kill 1 |
| container (sleep PID 1) sau OOM của exec | Running=true |
memory.current leo tới trần rồi tiến trình bị giết thẳng, không cảnh báo. Container một tiến trình với --memory=128m và swap tắt, chạy python cấp 10 MB mỗi vòng: memory.current tăng đều, 95, 105, 115, 125 MB. Ở mốc 125 MB, nó đã sát trần 128; vòng cấp phát tiếp theo vượt 128 MB, và ngay lập tức kernel OOM killer bắn, tiến trình nhận SIGKILL, container kết thúc với ExitCode=137 và OOMKilled=true. Không có một dòng cảnh báo nào từ ứng dụng, không có giai đoạn chạy chậm, không có cơ hội dọn dẹp: SIGKILL không thể bắt, nên chương trình không chạy được handler nào trước khi chết. Đây là khác biệt cốt lõi với CPU: giới hạn CPU làm app chậm nhưng vẫn sống và vẫn log; giới hạn bộ nhớ, khi bị vượt, làm app biến mất ngay lập tức. Một ứng dụng rò rỉ bộ nhớ chậm trong container sẽ chạy bình thường hàng giờ rồi đột ngột chết, lặp lại, mà trong log của chính nó không có dấu vết gì về nguyên nhân.
exit code 137 gần như luôn là OOM, và đó là nơi đầu tiên cần nhìn. Khi một container chết với exit 137 và không rõ lý do, giả thuyết đúng gần như mọi lần là OOM: 137 là 128 cộng 9, và 9 là SIGKILL mà OOM killer dùng. Xác nhận bằng docker inspect xem OOMKilled có true không, hoặc đọc memory.events xem oom_kill có tăng không. Điều quan trọng là đừng nhầm 137 với một crash của ứng dụng: ứng dụng tự crash thường có exit code riêng và một stack trace trong log, còn 137 nghĩa là một thế lực bên ngoài, kernel, đã giết nó, và trong log ứng dụng sẽ không có gì vì nó không kịp viết. Nhầm hai thứ này dẫn tới hàng giờ gỡ lỗi sai hướng, tìm bug trong code trong khi vấn đề là trần bộ nhớ đặt quá thấp.
OOM killer giết một tiến trình, không phải cả container, và điều đó tạo ra hai kịch bản khác nhau. Chạy một container với sleep làm PID 1, rồi docker exec một tiến trình python ngốn 300 MB trong trần 128 MB: memory.events cho max 38, nghĩa là cgroup chạm trần 38 lần và kernel cố thu hồi mỗi lần, và oom_kill 1, một tiến trình bị giết. Tiến trình docker exec đó chết, nhưng container vẫn Running=true, vì OOM killer chọn giết kẻ ngốn RAM, là tiến trình exec, chứ không phải sleep, là PID 1. Hệ quả: exit code 137 chỉ xảy ra khi tiến trình bị OOM giết là tiến trình chính của container; nếu kẻ ngốn RAM là một worker con, container có thể sống sót với PID 1 nguyên vẹn trong khi một phần công việc của nó biến mất âm thầm. Đây là lý do một số sự cố OOM khó phát hiện hơn: container không chết, chỉ có một tiến trình con bị giết, và dịch vụ hoạt động lúc được lúc không. Cách OOM killer chọn nạn nhân dựa trên một điểm số, oom_score, nghiêng về tiến trình dùng nhiều bộ nhớ nhất; có thể điều chỉnh qua oom_score_adj để bảo vệ tiến trình quan trọng.
memory.high là ghìm mềm, nhưng Docker không phơi nó ra. cgroups v2 có một tham số thứ hai, memory.high, hoạt động như một trần mềm: khi memory.current vượt memory.high, kernel không giết mà bắt đầu thu hồi quyết liệt và làm chậm tiến trình, một kiểu áp lực để nó tự giảm dùng bộ nhớ trước khi chạm trần cứng memory.max. Trong phép đo, memory.high mặc định là max, tức không đặt, và ghi vào nó từ bên trong container báo Read-only file system vì cgroup của container do daemon quản lý. Quan trọng hơn, Docker không có cờ cho memory.high; nó chỉ phơi ra --memory (ánh xạ memory.max) và --memory-reservation (ánh xạ memory.low, một cơ chế bảo vệ chứ không phải ghìm). Muốn dùng memory.high phải đi qua orchestrator hỗ trợ nó hoặc chỉnh cgroup trực tiếp. Hệ quả thực tế: với Docker thuần, container chỉ có trần cứng và OOM đột ngột, không có vùng đệm ghìm mềm để phản ứng sớm.
Đánh đổi cần cân nhắc
Đặt --memory theo đỉnh RAM thật, không theo trung bình. Vì vượt trần là chết ngay chứ không chậm dần, trần phải đủ rộng cho mức bộ nhớ cao nhất mà ứng dụng chạm tới, gồm heap, bộ đệm, và cả cache mà runtime hay thư viện giữ. Một ứng dụng JVM cần trần lớn hơn -Xmx vì còn metaspace, thread stack, bộ đệm trực tiếp; một ứng dụng Go cần tính cả phần GC chưa trả về hệ điều hành. Đặt sát quá là rước OOM khi có đợt tải cao hoặc một request lớn bất thường; đặt rộng quá là lãng phí và giảm mật độ. Đo đỉnh RAM thật dưới tải thật là cách duy nhất chọn đúng.
Tắt swap cho container, và cân nhắc giới hạn swap riêng. Để swap bật cho container làm OOM đến muộn và kèm thrashing đĩa làm chậm toàn hệ thống, một kiểu suy giảm âm thầm khó chẩn đoán hơn một OOM dứt khoát. Tắt swap, hoặc đặt --memory-swap sát --memory, cho hành vi rõ ràng: hoặc vừa trần hoặc chết, không có vùng xám thrashing. Đây là lý do Kubernetes mặc định không cho pod dùng swap.
Phạm vi đo. Các số là của cgroups v2 với swap tắt; với swap bật, thời điểm OOM và memory.current sẽ khác, và memory.swap.current thành một con số cần theo dõi thêm. Chưa đo oom_score_adj để bảo vệ tiến trình cụ thể; chưa đo tương tác với page cache dùng chung, chủ đề của phần 11 về RSS và cache; và chưa đo memory.low (reservation), cơ chế bảo vệ bộ nhớ tối thiểu khi host chịu áp lực.
Ba ý mang về
- Bộ nhớ vượt trần là bị giết, không phải chạy chậm.
memory.currentleo tớimemory.maxrồi OOM killer bắn SIGKILL ngay; container chết với exit 137 vàOOMKilled=true, không cảnh báo, không log của ứng dụng. - exit 137 là tín hiệu OOM, không phải crash của code. Nhìn
OOMKilledvàmemory.eventstrước khi tìm bug trong ứng dụng; nhầm hai thứ dẫn tới gỡ lỗi sai hướng hàng giờ. - OOM giết tiến trình, không nhất thiết cả container. Nếu PID 1 không phải kẻ ngốn RAM, container sống sót trong khi một tiến trình con biến mất; đặt
--memorytheo đỉnh RAM thật và tắt swap để hành vi dứt khoát.
Nguồn
- Linux kernel — Control Group v2, mục Memory controller (
memory.max,memory.high,memory.events): https://docs.kernel.org/admin-guide/cgroup-v2.html#memory - Docker — Runtime options with Memory, CPUs, and GPUs (
--memory,--memory-swap): https://docs.docker.com/engine/containers/resource_constraints/#memory - Linux kernel — OOM killer và
oom_score,oom_score_adj: https://docs.kernel.org/admin-guide/mm/concepts.html - Linux
proc(5)—/proc/PID/oom_score_adj: https://man7.org/linux/man-pages/man5/proc.5.html - Kubernetes — Node memory management và vì sao tắt swap: https://kubernetes.io/docs/concepts/architecture/nodes/#swap-memory
- Chris Down — cgroup v2 và memory.high (LWN / blog về quản lý bộ nhớ): https://chrisdown.name/2018/01/02/in-defence-of-swap.html
Phần sau đo hai giới hạn còn lại của cgroups: I/O và số tiến trình. Đặt io.max giới hạn băng thông đĩa rồi đo tốc độ ghi bị chặn, và đặt pids.max để chặn một fork bomb trong container, xem nó dừng ở đúng số tiến trình nào và vì sao giới hạn này là lưới an toàn quan trọng mà ít ai đặt.
