Ba lệnh nhỏ này — sort, uniq, cut — ghép lại thành công cụ phân tích log nhanh nhất mà mọi kỹ sư nên thuộc lòng: "IP nào gọi nhiều nhất?", "URL nào lỗi 500 thường xuyên?", "có bao nhiêu người dùng duy nhất?". Trả lời những câu đó không cần mở CSDL hay viết script — chỉ cần một dòng pipe. Nhưng có hai hiểu lầm khiến kết quả sai âm thầm: uniq không làm điều bạn tưởng, và sort mặc định không sắp số như bạn nghĩ. Bài này (phần 6 loạt Unix) chạy thật trên một file access log để làm rõ.
cut: trích cột
cut lấy ra các cột theo dấu phân cách hoặc vị trí ký tự:
cut -d" " -f1,3 access.log   # -d dấu phân cách (space), -f cột 1 và 3
cut -d"," -f2 data.csv       # CSV: lấy cột 2
cut -c1-8 file               # theo VỊ TRÍ ký tự 1..8
cut gọn và nhanh cho cắt cột đơn giản; khi cần logic phức tạp hơn (cột theo điều kiện, tính toán) thì dùng awk như bài trước.
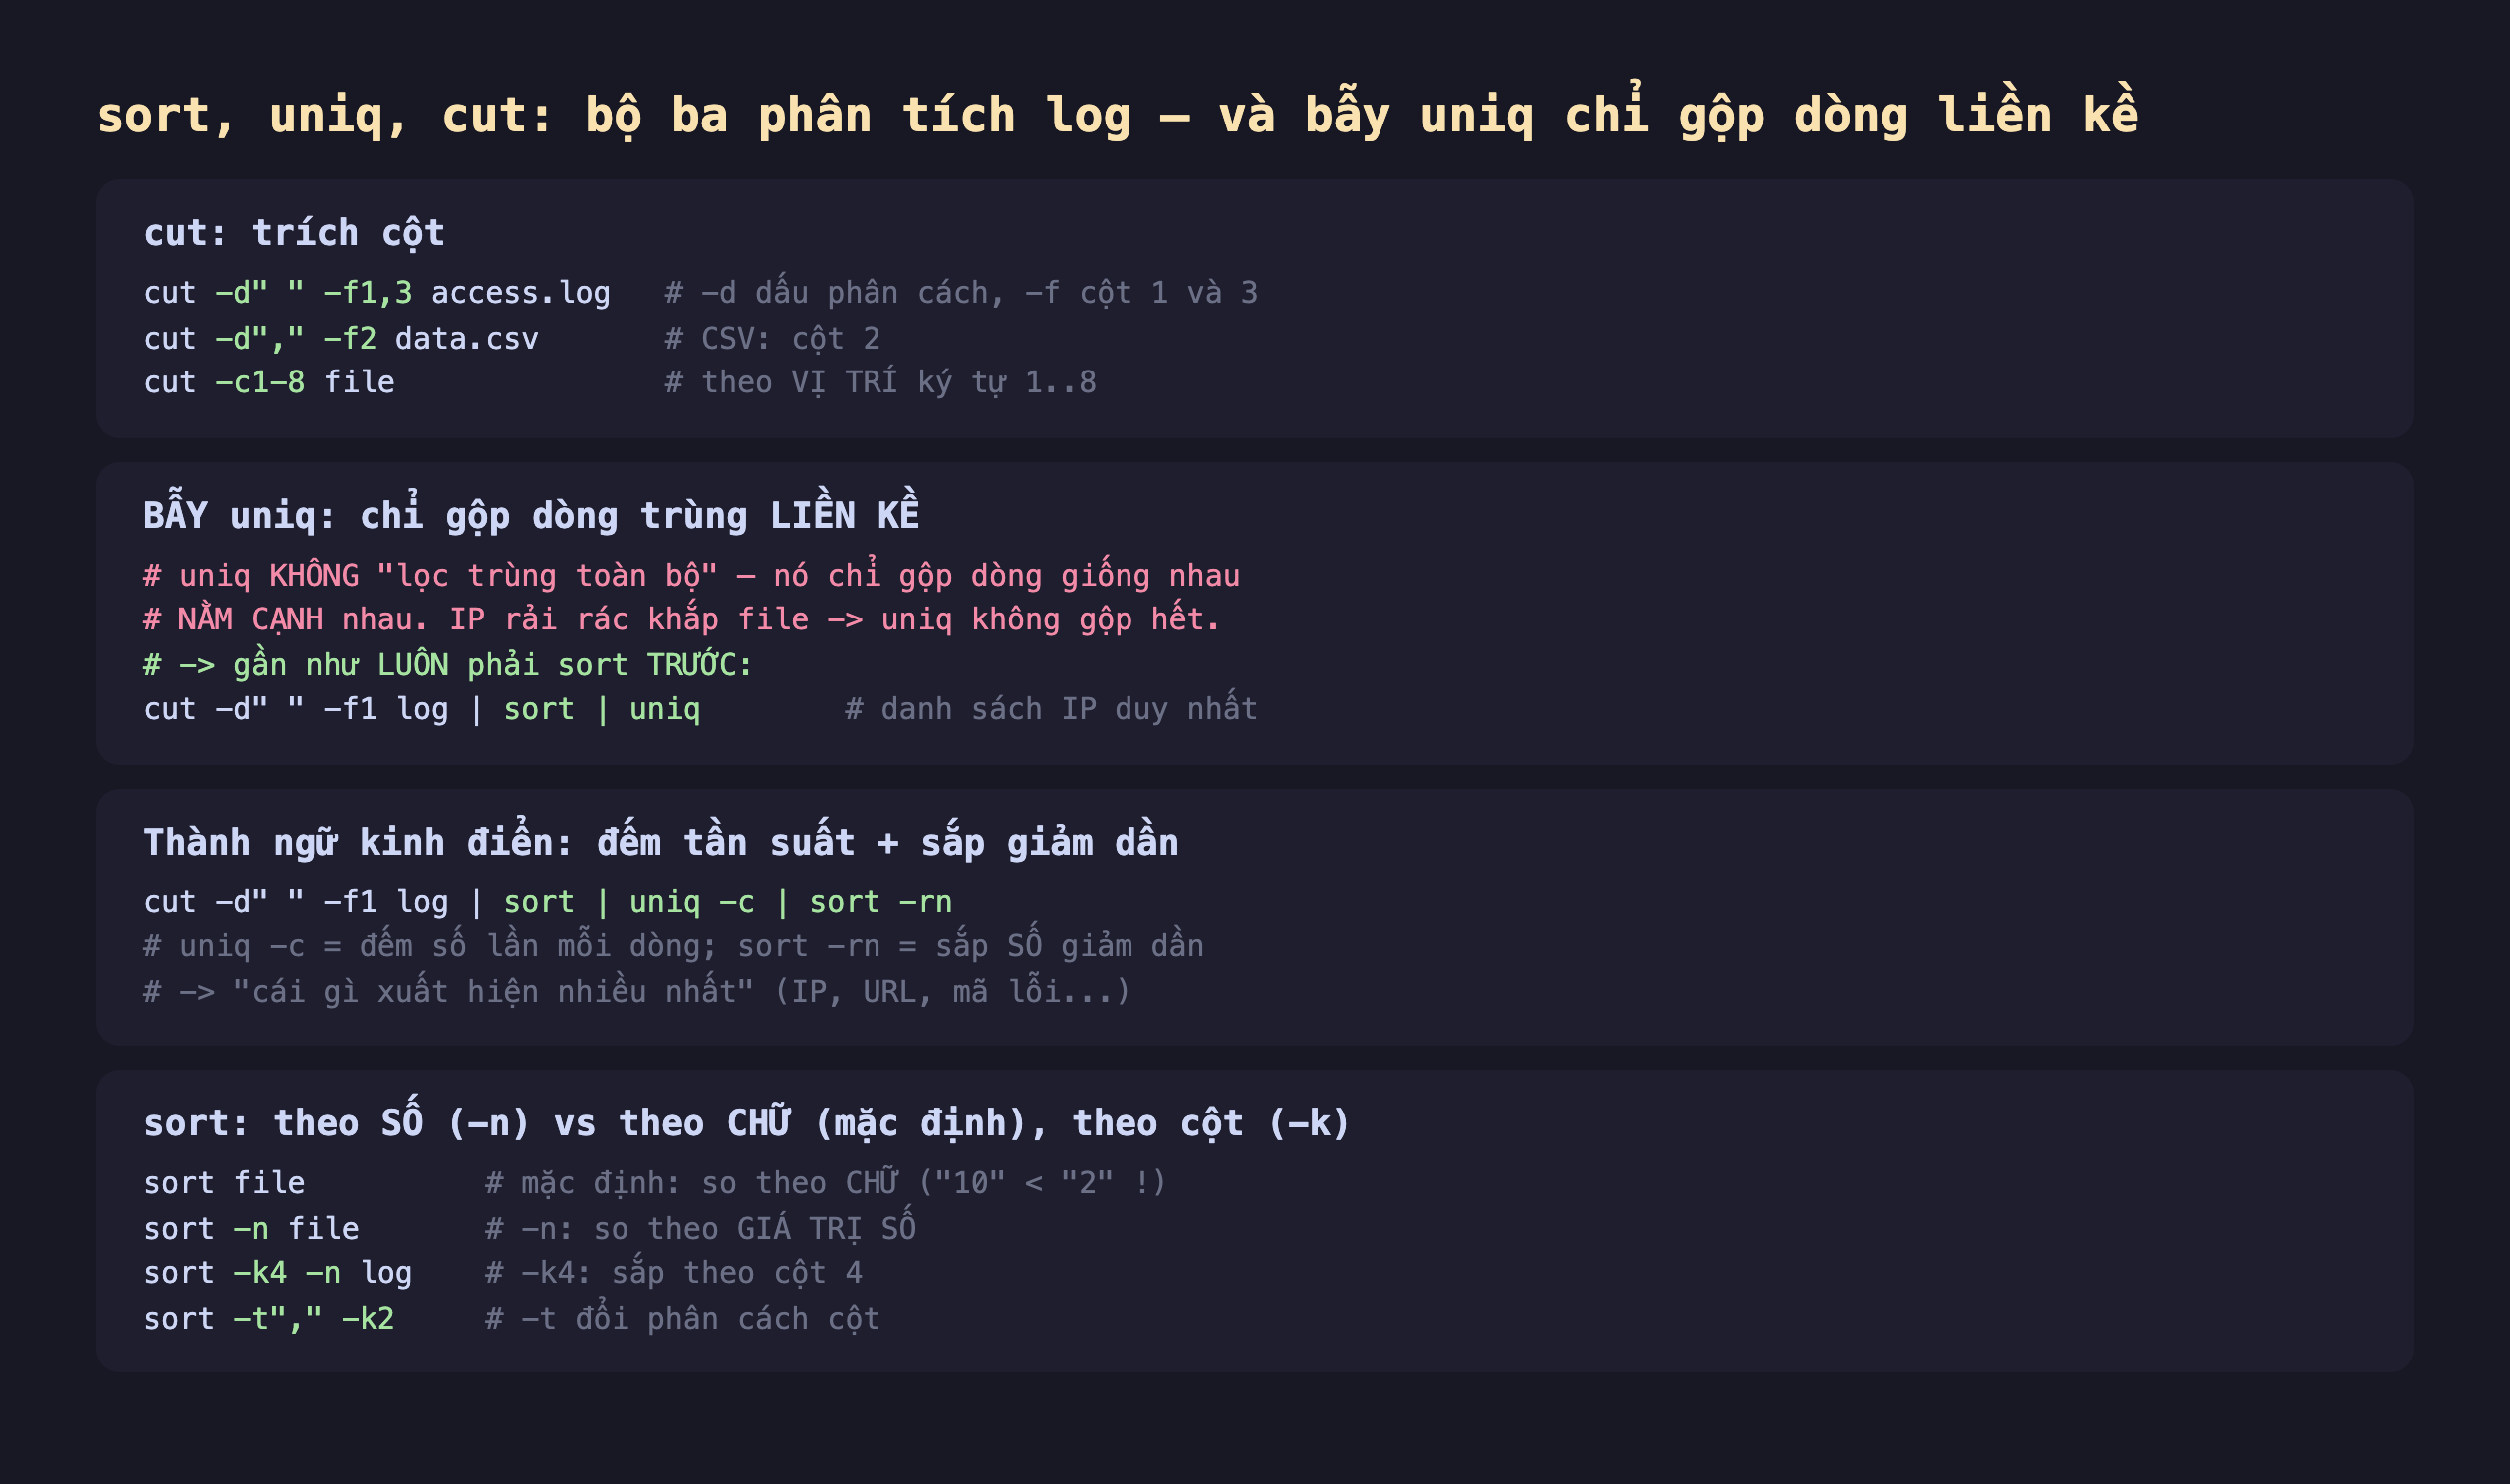
Hình 1: cut trích cột theo -d/-f hoặc vị trí; uniq chỉ gộp dòng trùng liền kề (nên cần sort trước); thành ngữ đếm tần suất sort | uniq -c | sort -rn; và sort -n vs sort theo chữ, -k theo cột.
Bẫy lớn nhất: uniq chỉ gộp dòng LIỀN KỀ
Đây là hiểu lầm khiến nhiều người đếm sai. uniq không loại bỏ mọi dòng trùng trong file — nó chỉ gộp các dòng giống nhau nằm cạnh nhau. Nếu cùng một giá trị xuất hiện rải rác khắp file (như IP trong log), uniq không gộp chúng. Đo thật:
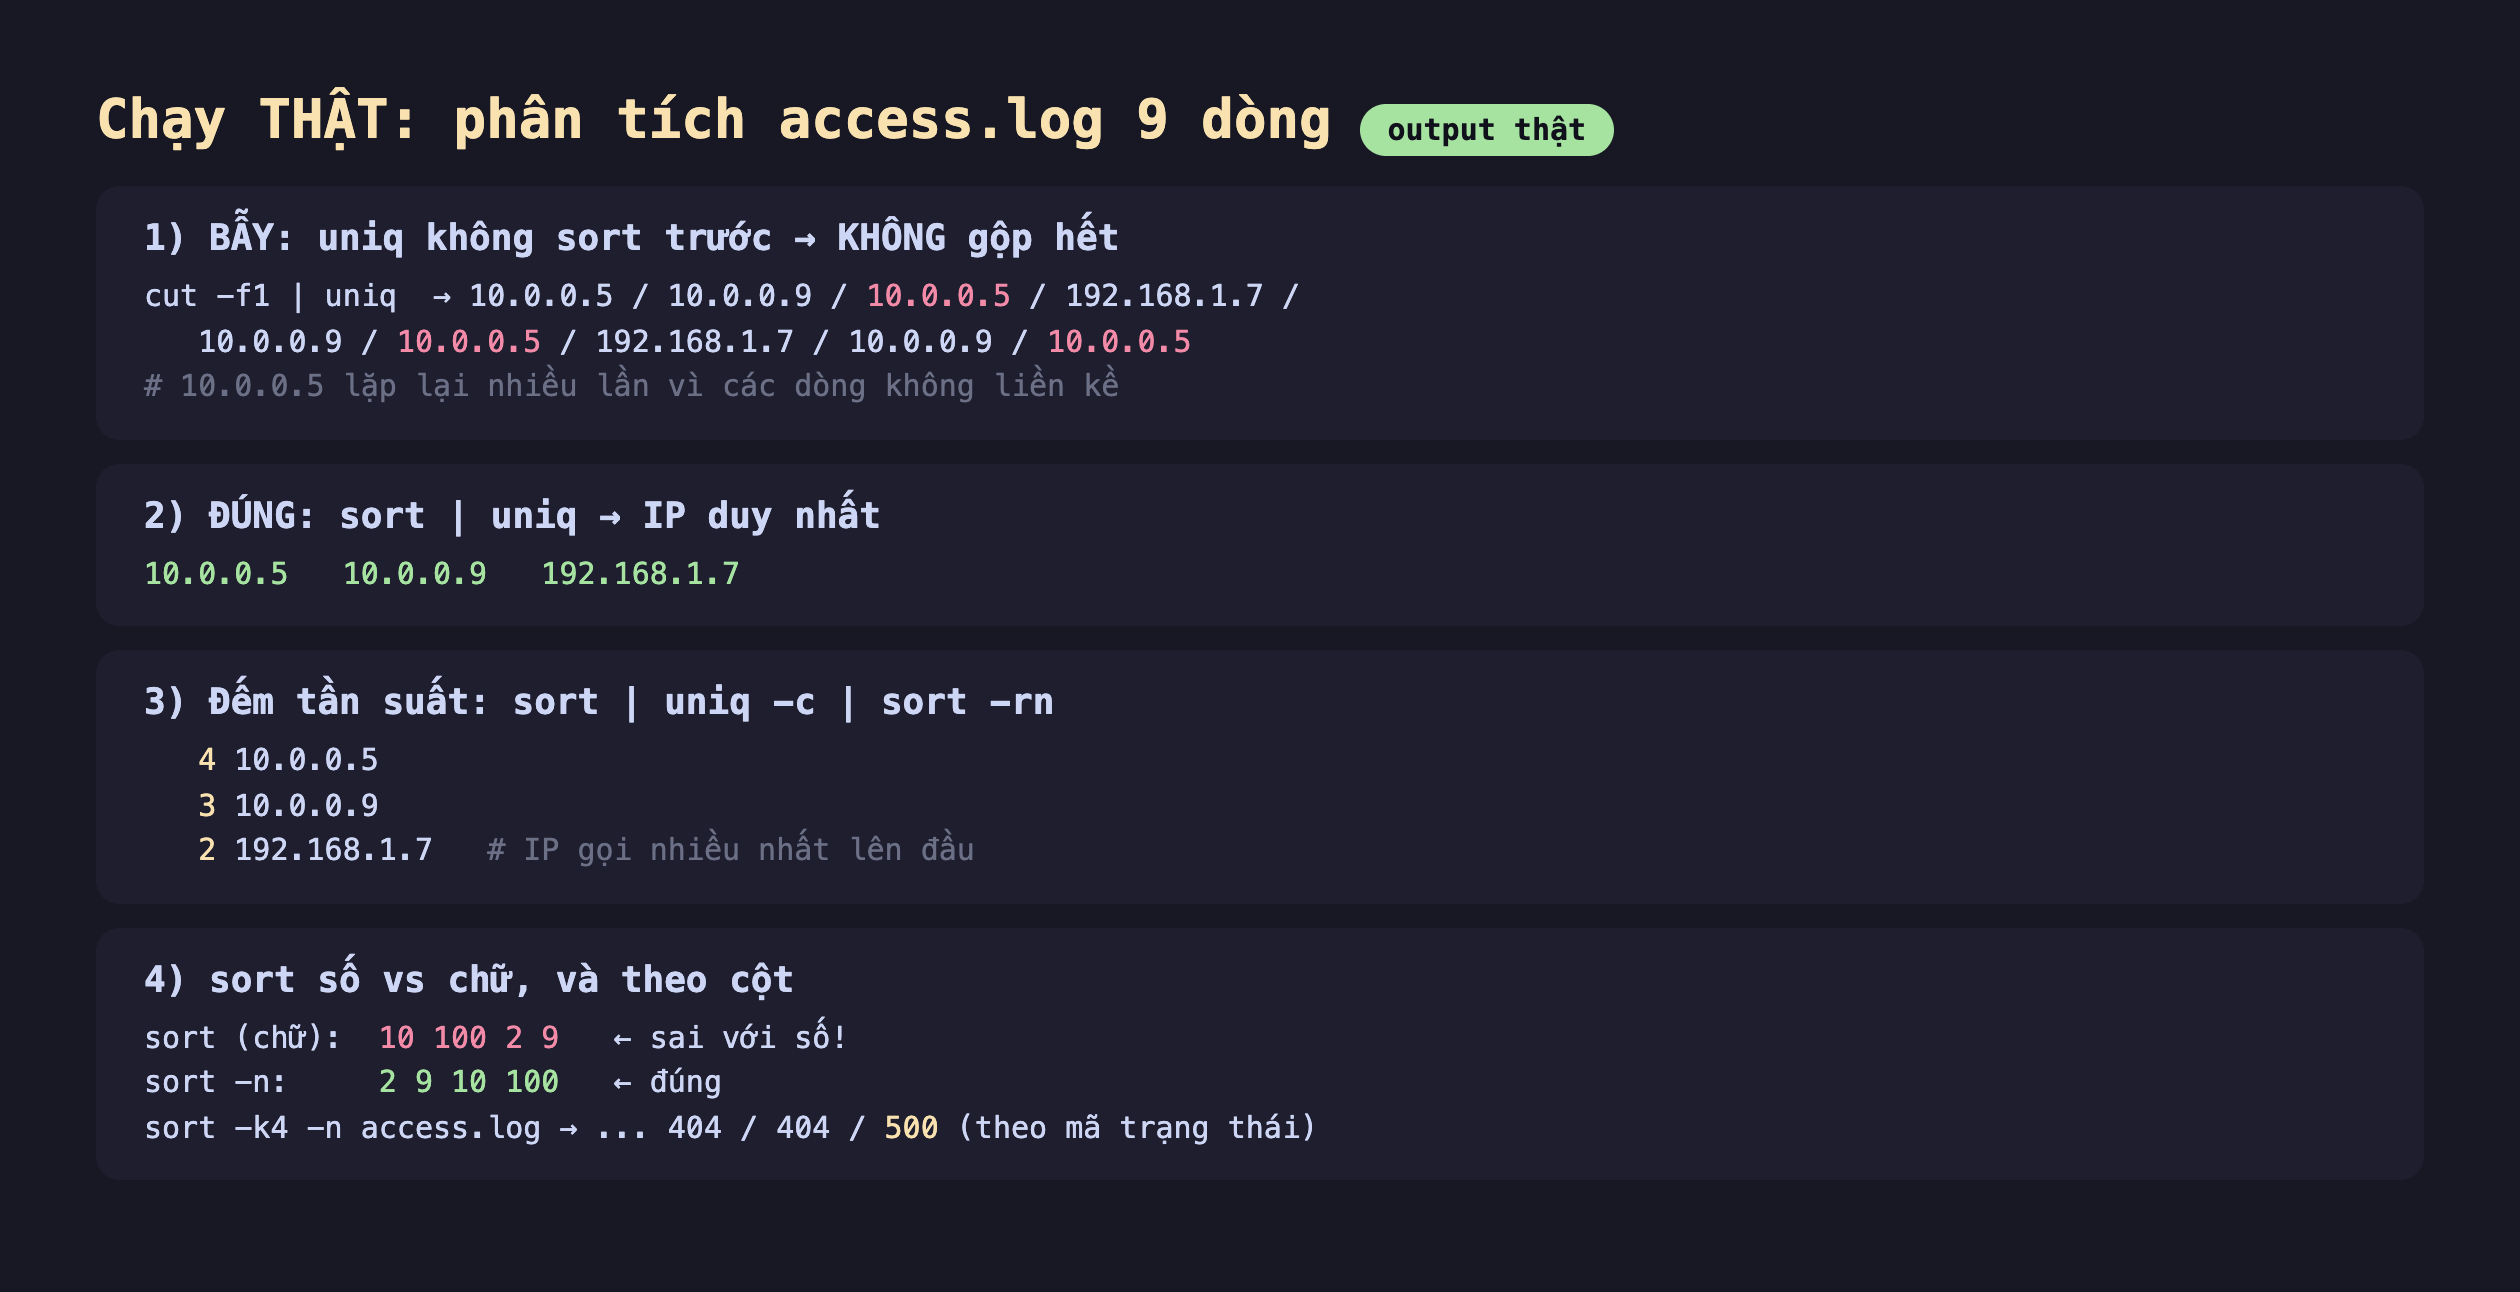
Hình 2: Chạy thật — cut -f1 | uniq để lại 10.0.0.5 lặp nhiều lần (dòng không liền kề); sort | uniq cho IP duy nhất; sort | uniq -c | sort -rn đếm 4/3/2; sort theo chữ cho 10 100 2 9 (sai), sort -n cho 2 9 10 100.
- Không sort trước:
cut -f1 | uniqđể lại10.0.0.5xuất hiện ba lần rời rạc — vì các dòng chứa nó không nằm cạnh nhau. Kết quả "danh sách IP" này sai. - Sort trước:
sort | uniqgom mọi10.0.0.5về cạnh nhau rồiuniqmới gộp được → đúng ba IP duy nhất. Quy tắc: gần như luônsort | uniq, hiếm khi dùnguniqmột mình. (Ngoại lệ: khi bạn chỉ muốn gộp dòng lặp liên tiếp, ví dụ log spam cùng một dòng.)
Thành ngữ kinh điển: đếm tần suất
Đây là một dòng lệnh mọi kỹ sư nên thuộc: sort | uniq -c | sort -rn. uniq -c thêm số đếm trước mỗi dòng, sort -rn sắp giảm dần theo số. Đo thật "IP nào gọi nhiều nhất":
cut -d" " -f1 access.log | sort | uniq -c | sort -rn
#    4 10.0.0.5
#    3 10.0.0.9
#    2 192.168.1.7
Đổi -f1 thành cột URL, mã trạng thái, hay user-agent, bạn có ngay bảng xếp hạng cho bất cứ trường nào — công cụ điều tra sự cố nhanh nhất khi chưa có dashboard.
sort: số khác chữ, và sắp theo cột
sort mặc định so theo chữ (từ điển), nên "10" đứng trước "2" vì ký tự 1 < 2. Đo thật: sort cho 10 100 2 9 (sai với số), còn sort -n (numeric) cho 2 9 10 100 (đúng). Đây là bẫy hay gặp khi sắp kích thước file, số lượng, cổng...
sort -k sắp theo cột cụ thể: sort -k4 -n access.log sắp theo cột 4 (mã trạng thái) — đo thật cho ra các dòng 404 rồi 500 ở cuối. Dùng -t để đổi dấu phân cách cột (mặc định là khoảng trắng): sort -t"," -k2 cho CSV.
Đánh đổi cần cân nhắc
sort -u gộp cả sort lẫn uniq — nhưng khác uniq -c. sort -u = sort | uniq (loại trùng), gọn hơn. Nhưng nó không đếm được — muốn đếm tần suất vẫn phải sort | uniq -c. Chọn sort -u khi chỉ cần danh sách duy nhất, uniq -c khi cần số lượng.
sort tốn bộ nhớ/đĩa với dữ liệu khổng lồ. sort phải nạp (hoặc tràn ra đĩa) để sắp toàn bộ; với file rất lớn nó dùng -T cho thư mục tạm và có thể chậm. Nếu chỉ cần "top N" mà không cần sắp toàn bộ, cân nhắc công cụ khác; nhưng với log cỡ vừa, pipe này vẫn nhanh và đủ dùng.
Locale ảnh hưởng thứ tự sort. Sắp xếp phụ thuộc biến LC_COLLATE — cùng lệnh có thể cho thứ tự khác nhau giữa các máy/locale (đặc biệt với ký tự có dấu, hoa/thường). Để kết quả nhất quán trong script, đặt LC_ALL=C sort (sắp theo byte, ổn định và nhanh nhất).
Ba ý mang về
- uniq chỉ gộp dòng trùng LIỀN KỀ: đo thật,
cut | uniqkhông sort để lại IP lặp rải rác; gần như luôn phảisort | uniq. Đây là hiểu lầm khiến kết quả đếm sai âm thầm. - Thành ngữ
sort | uniq -c | sort -rnđếm tần suất: đo thật ra bảng xếp hạng IP (4/3/2) — đổi cột là có ngay top URL/mã lỗi/user-agent, công cụ điều tra sự cố nhanh nhất. - sort mặc định theo chữ, cần
-ncho số: đo thậtsortcho10 100 2 9(sai),sort -ncho2 9 10 100;-ksắp theo cột, và đặtLC_ALL=Cđể thứ tự nhất quán giữa các máy.
Nguồn
- man7.org — sort(1): https://man7.org/linux/man-pages/man1/sort.1.html
- man7.org — uniq(1): https://man7.org/linux/man-pages/man1/uniq.1.html
- GNU coreutils manual — cut / sort / uniq: https://www.gnu.org/software/coreutils/manual/coreutils.html
Phần sau ta đi vào một nguồn bug shell kinh điển: quoting và word splitting — vì sao quên dấu ngoặc kép quanh biến ($x thay vì "$x") làm hỏng script khi giá trị có dấu cách, và cách quote đúng.
