Nếu grep lọc dòng và sed biến đổi văn bản, thì awk là công cụ để hiểu dữ liệu theo cột. Rất nhiều lập trình viên chỉ biết awk '{print $2}' để lấy một cột rồi dừng lại — bỏ lỡ sự thật rằng awk là một ngôn ngữ lập trình hoàn chỉnh, có biến, điều kiện, vòng lặp và mảng, được thiết kế riêng cho dữ liệu bảng. Với nó, bạn lọc theo giá trị số của cột, tính toán trên các cột, và thậm chí group-by tính tổng — những việc mà nhiều người vội mở Python hay import vào CSDL để làm. Bài này (phần 4 loạt Unix) chạy awk thật trên một bảng bán hàng để cho thấy điều đó.
Mô hình: mỗi dòng thành các trường $1 $2 ...
Với mỗi dòng đầu vào, awk tự tách thành các trường theo dấu phân cách và gán vào $1, $2, ...; $0 là cả dòng. Kèm theo là các biến dựng sẵn: NF (số trường/cột trên dòng), NR (số thứ tự dòng đang xử lý).
awk -F"\t" "NR>1 {print \$2}" # -F đặt phân cách (tab); NR>1 bỏ dòng tiêu đề
Cấu trúc chương trình awk là các cặp mẫu { hành động } — với mỗi dòng, nếu mẫu đúng thì chạy hành động. Bỏ mẫu = chạy mọi dòng; bỏ hành động = in dòng khớp.
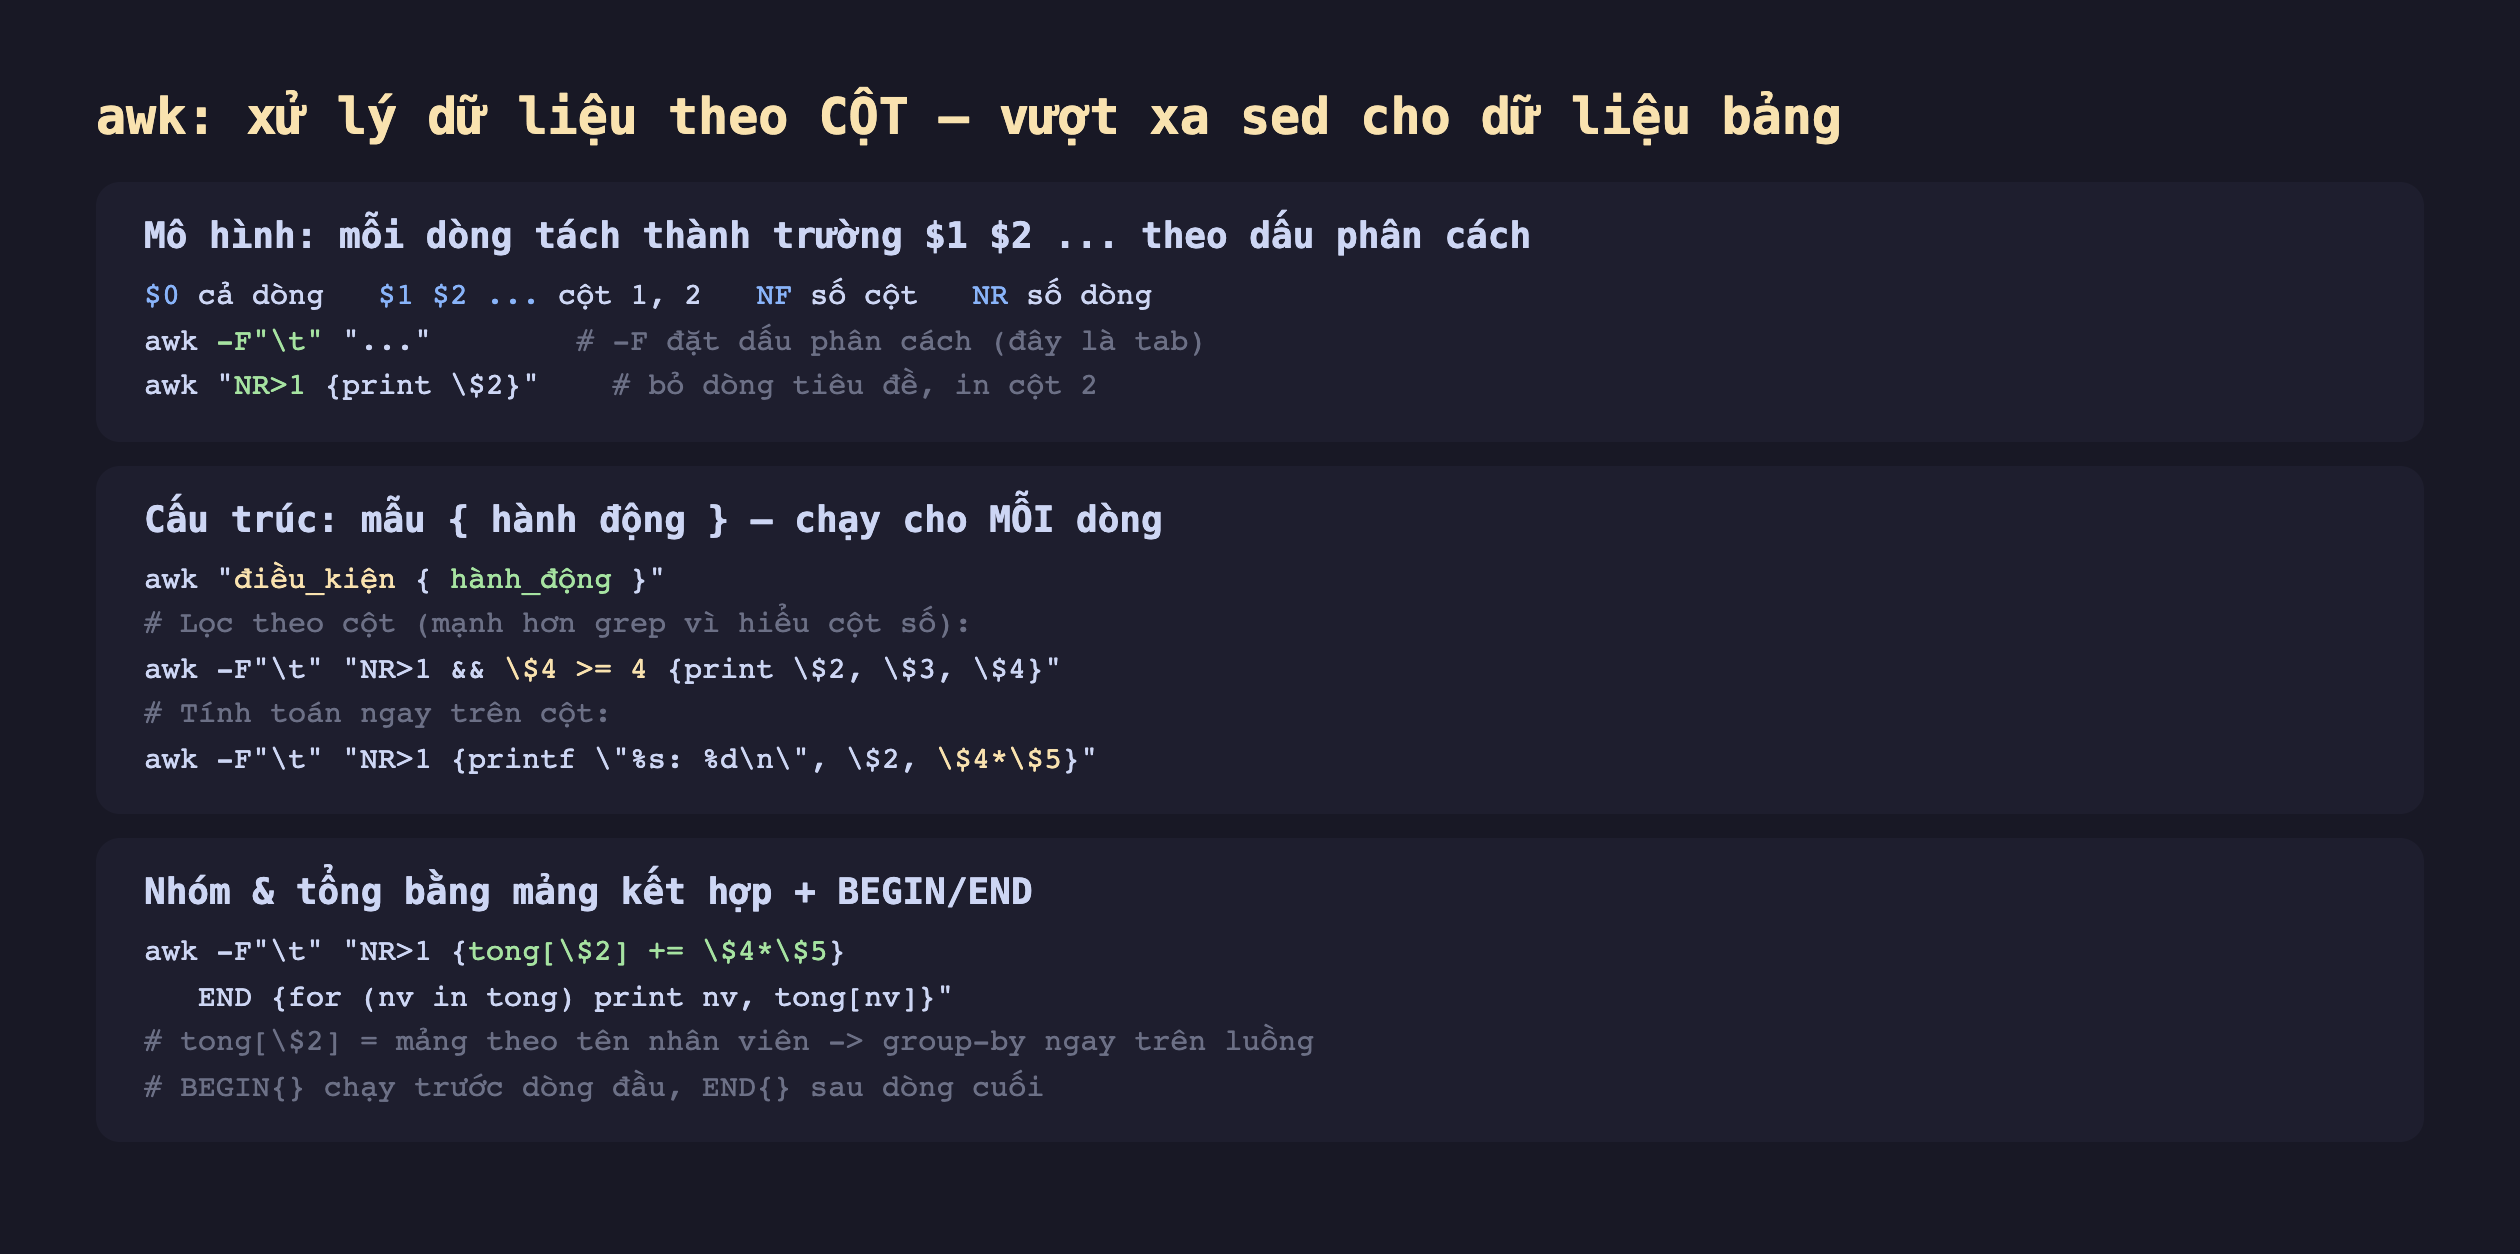
Hình 1: awk tách mỗi dòng thành trường $1 $2... (biến NF/NR); cấu trúc mẫu { hành động }; lọc theo giá trị số của cột, tính toán trên cột, và group-by bằng mảng kết hợp với BEGIN/END.
Đo thật: từ lọc tới group-by trên bảng bán hàng
Mình chạy trên một bảng TSV 6 dòng (ngày, nhân viên, sản phẩm, số lượng, đơn giá). Kết quả thật:
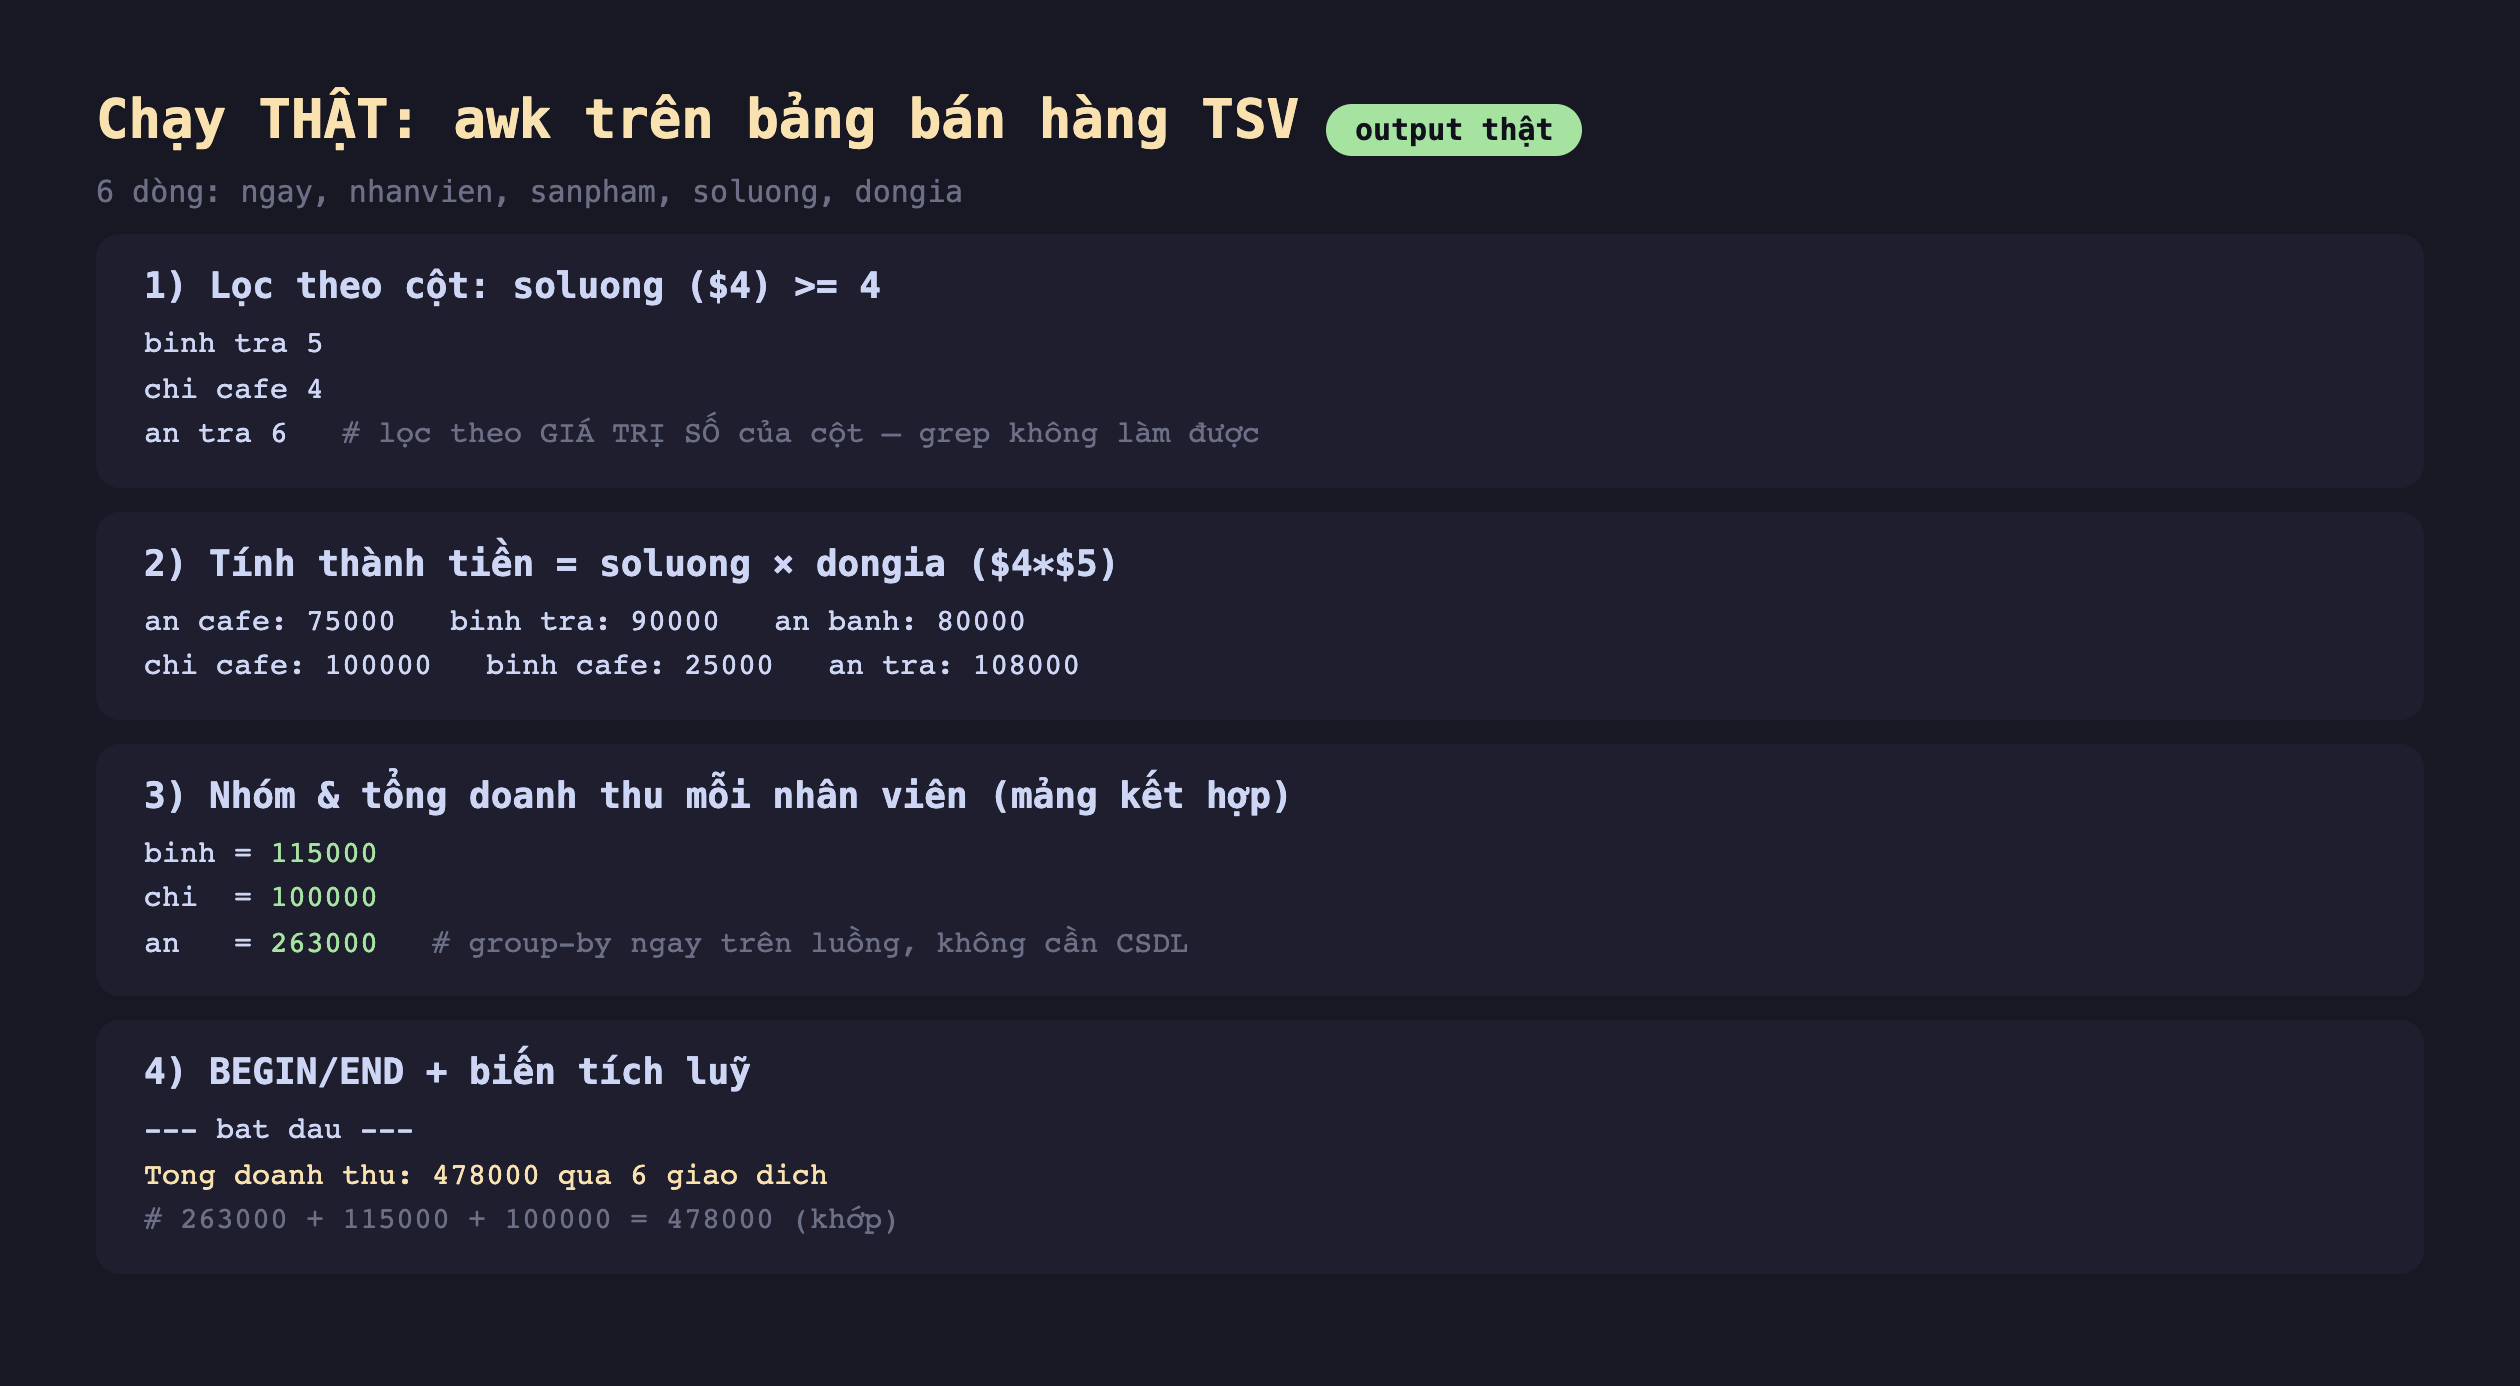
Hình 2: Chạy thật — lọc $4 >= 4 (theo giá trị số của cột); tính thành tiền $4*$5; group-by tổng doanh thu mỗi nhân viên bằng mảng kết hợp (an=263000, binh=115000, chi=100000); BEGIN/END cho tổng toàn bộ 478000 qua 6 giao dịch.
- Lọc theo cột (
$4 >= 4):awkso giá trị số của cột 4 — điềugrepkhông làm được, vì grep chỉ khớp văn bản chứ không hiểu "cột thứ 4 lớn hơn 4". Đây là khác biệt cốt lõi giữa awk và grep. - Tính toán (
$4*$5):awkcoi trường số là số và tính ngay — thành tiền = số lượng × đơn giá, in ra bằngprintfcó định dạng. - Group-by bằng mảng kết hợp:
tong[$2] += $4*$5—tonglà mảng kết hợp (dictionary) khoá theo tên nhân viên. Sau khi duyệt hết,END { for (nv in tong) ... }in tổng mỗi người. Đây làGROUP BY ... SUM()của SQL, chạy ngay trên luồng văn bản, không cần nạp vào CSDL. BEGIN/END+ biến tích luỹ:BEGIN{}chạy trước dòng đầu (in tiêu đề, đặt giá trị ban đầu),END{}chạy sau dòng cuối (in tổng kết). Tổng toàn bộ 478.000 qua 6 giao dịch — khớp với tổng ba nhân viên.
Vì sao awk hơn hẳn cho dữ liệu bảng
grep không hiểu khái niệm cột; sed biến đổi văn bản theo dòng nhưng không tính toán được. awk lấp đúng khoảng đó: nó hiểu cấu trúc cột và có đủ công cụ lập trình (số học, điều kiện, mảng) để phân tích. Với log, CSV/TSV, output của các lệnh khác (ps, df, ls -l), awk cho phép lọc–tính–tổng hợp trong một dòng, thay vì viết cả một script. Đó là lý do nó vẫn không thể thay thế sau gần 50 năm.
Đánh đổi cần cân nhắc
awk mặc định tách theo khoảng trắng — cẩn thận với dữ liệu có dấu phân cách trong trường. Không có -F, awk tách theo chuỗi khoảng trắng (gộp nhiều space/tab). Với CSV thật (trường có dấu phẩy trong ngoặc kép, như "Hà Nội, VN"), awk cơ bản không phân tích đúng — nó không hiểu quy tắc trích dẫn CSV. Dùng TSV, hoặc công cụ CSV chuyên dụng (csvkit, hoặc awk có thư viện CSV) cho dữ liệu phức tạp.
Khi logic vượt vài dòng, cân nhắc script thật. awk tuyệt cho biến đổi một dòng, nhưng chương trình awk dài (nhiều hàm, cấu trúc phức tạp) khó đọc và khó debug hơn Python. Ranh giới thực dụng: nếu cần vài phép lọc/tính/tổng thì awk gọn nhất; nếu cần cấu trúc dữ liệu phức tạp, thư viện, hay test, chuyển sang Python.
Chú ý biến thể awk. Có awk gốc, nawk, mawk (nhanh), và gawk (GNU, nhiều mở rộng). Phần lớn cú pháp POSIX chạy ở mọi bản, nhưng các mở rộng của gawk (như hàm gensub, mảng nhiều chiều thật) không chạy trên mawk. Giữ script trong phạm vi POSIX nếu cần chạy nhiều nơi.
Ba ý mang về
- awk hiểu dữ liệu theo cột: mỗi dòng tách thành
$1 $2..., cóNF/NR, cấu trúcmẫu { hành động }. Đo thật lọc$4 >= 4theo giá trị số của cột — điều grep không làm được vì grep chỉ khớp văn bản. - Tính toán và group-by ngay trên luồng: đo thật tính thành tiền
$4*$5, và mảng kết hợptong[$2] += $4*$5cho tổng doanh thu mỗi nhân viên (an=263000...) — chính làGROUP BY SUMcủa SQL mà không cần CSDL. - BEGIN/END cho khởi tạo và tổng kết: đo thật tổng toàn bộ 478000 qua 6 giao dịch; awk lấp khoảng giữa grep (lọc) và sed (biến đổi) — nhưng dùng TSV thay CSV có trích dẫn, và chuyển sang script thật khi logic phức tạp.
Nguồn
- GNU awk (gawk) manual: https://www.gnu.org/software/gawk/manual/gawk.html
- man7.org — awk(1p) (POSIX): https://man7.org/linux/man-pages/man1/awk.1p.html
- Brian Kernighan — The AWK Programming Language (tác giả gốc): https://awk.dev/
Phần sau ta xem cách biến output của lệnh này thành đối số cho lệnh kia: xargs — vì sao ls | rm không chạy, cách xử lý tên file có khoảng trắng an toàn, và chạy song song với -P.
