Bài trước thấy index biến SCAN thành SEARCH và nhanh gấp nghìn lần. Nhưng khi một bảng có nhiều index và một truy vấn có thể dùng vài cái trong số đó, SQLite phải chọn một. Chọn dựa trên gì? Và chuyện gì xảy ra khi nó chọn nhầm? Bài này đo đúng tình huống đó, và cho thấy một câu lệnh — ANALYZE — biến một truy vấn 53 mili-giây thành 0,010 mili-giây mà không đổi một chữ SQL nào. Tất cả trong container sqlite 3.45.3.
Cùng một truy vấn, hai index để chọn
Dựng bảng đơn hàng hai triệu dòng với hai cột có độ chọn lọc rất khác nhau, và index cho cả hai:
-- tp: chỉ 5 thành phố  → mỗi giá trị khớp 400.000 dòng  (ít chọn lọc)
-- khach: 50.000 khách  → mỗi giá trị khớp 40 dòng       (rất chọn lọc)
CREATE INDEX idx_khach ON don(khach);
CREATE INDEX idx_tp    ON don(tp);
SELECT COUNT(*) FROM don WHERE tp='Da Nang'      → 400 000 dòng khớp
SELECT COUNT(*) FROM don WHERE khach='KH012345'  →      40 dòng khớp
Giờ một truy vấn ràng buộc cả hai cột:
SELECT * FROM don WHERE tp='Da Nang' AND khach='KH012345';
Có hai con đường. Dùng idx_tp: nhảy tới 400.000 dòng "Da Nang" rồi lọc tay lấy 40 dòng đúng khách — chậm. Dùng idx_khach: nhảy thẳng tới 40 dòng đúng khách rồi lọc lấy thành phố — nhanh. Chênh lệch là mười nghìn lần số dòng phải xử lý. Câu hỏi: SQLite có biết chọn idx_khach không?
Thiếu thống kê, SQLite đoán — và đoán sai
Chạy EXPLAIN QUERY PLAN khi chưa có thống kê:
EXPLAIN QUERY PLAN SELECT * FROM don WHERE tp='Da Nang' AND khach='KH012345';
-- `--SEARCH don USING INDEX idx_tp (khach=?)   ← chọn NHẦM idx_tp
SQLite chọn idx_tp — con đường chậm. Không có thống kê, nó không biết tp chỉ có 5 giá trị còn khach có 50.000; với nó hai index trông như nhau, và nó rơi vào một heuristic mặc định (ở đây là index áp dụng được tạo gần nhất). Đo thời gian thật:
chưa ANALYZE → idx_tp: 53 ms / truy vấn
53 mili-giây, gần bằng quét cả bảng — vì nó thực sự phải lọc qua 400.000 dòng "Da Nang". Index có đó, đúng cái tốt (idx_khach) cũng có đó, nhưng SQLite không có cơ sở nào để biết cái nào tốt hơn.
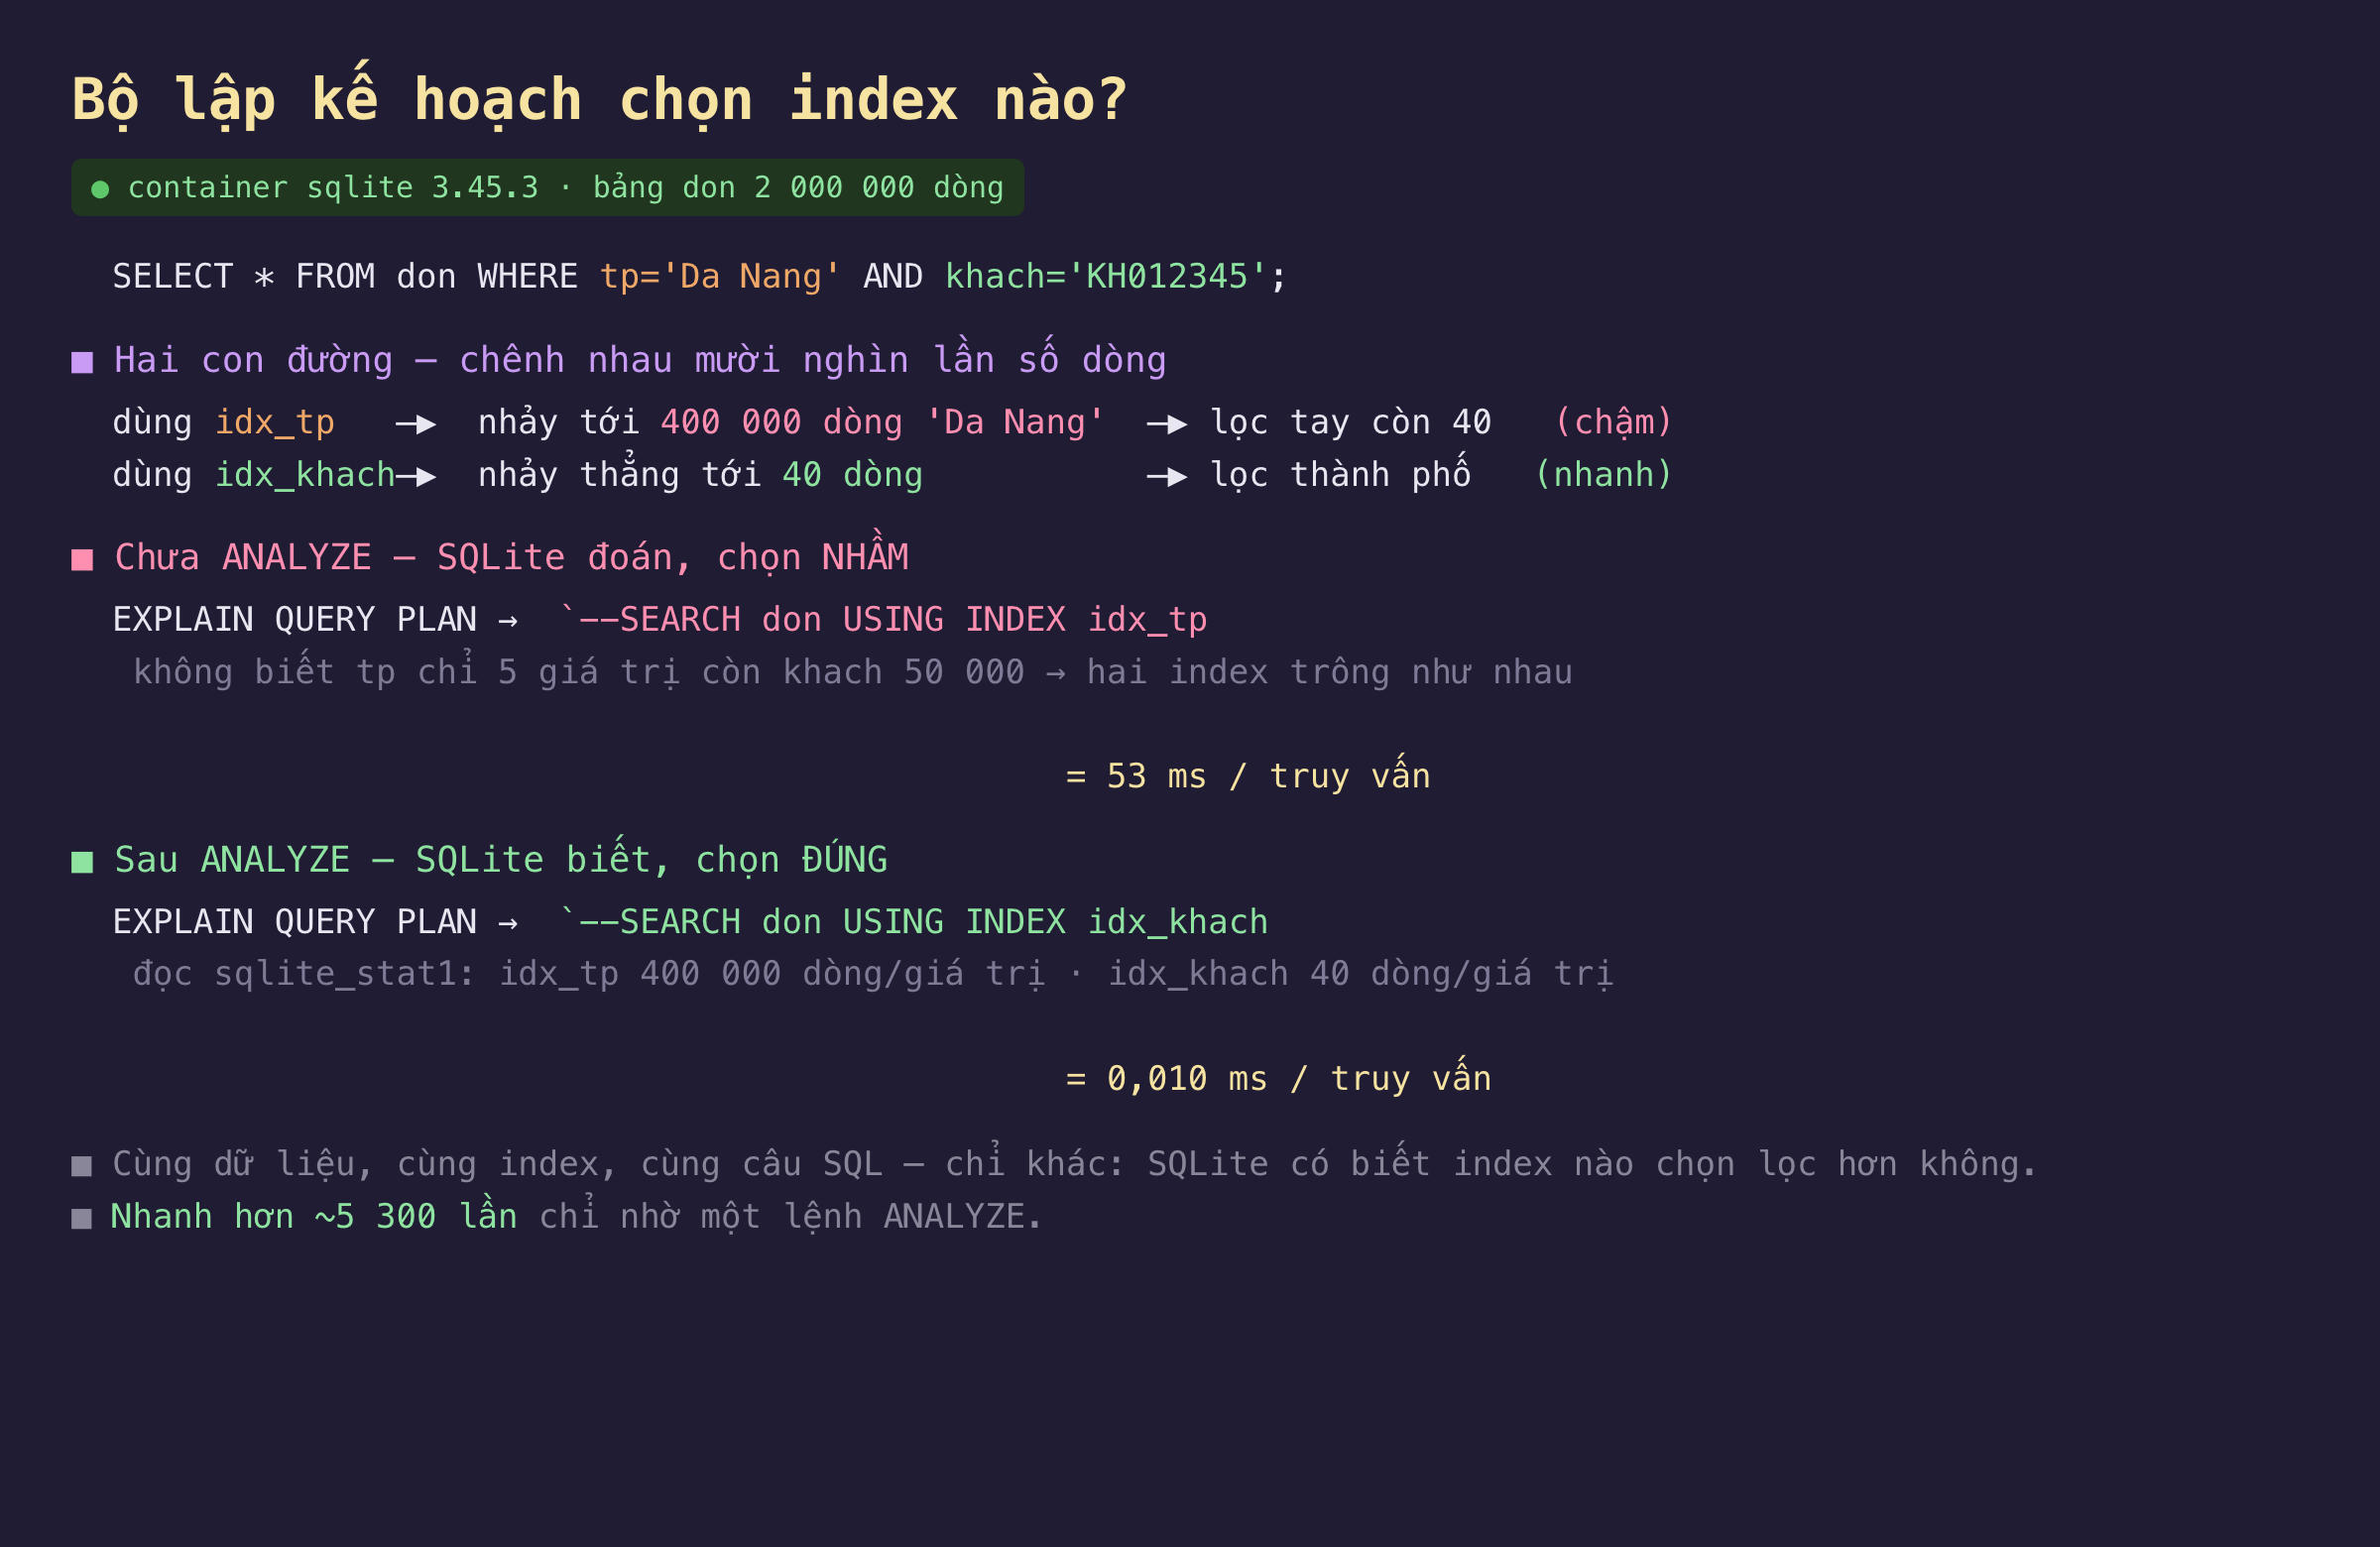
Hình 1: Hai con đường cho cùng một truy vấn. Thiếu thống kê, SQLite chọn nhầm con đường ít chọn lọc (idx_tp, 53 ms); có thống kê, nó chọn đúng con đường chọn lọc cao (idx_khach, 0,010 ms).
ANALYZE: đo độ chọn lọc và ghi vào sqlite_stat1
ANALYZE quét các index, đo xem trung bình mỗi giá trị khóa khớp bao nhiêu dòng, và lưu kết quả vào một bảng hệ thống tên sqlite_stat1:
ANALYZE;
SELECT tbl, idx, stat FROM sqlite_stat1;
-- don | idx_tp     | 2000000 400000    ← 2 triệu dòng, ~400.000 dòng / giá trị tp
-- don | idx_khach  | 2000000 40        ← 2 triệu dòng, ~40 dòng / giá trị khach
Cột stat nói đúng điều bộ lập kế hoạch cần: index idx_tp cho trung bình 400.000 dòng mỗi giá trị, còn idx_khach chỉ 40 dòng. Giờ SQLite có số để so sánh: idx_khach thu hẹp mạnh hơn mười nghìn lần, nên là lựa chọn rẻ hơn hẳn.
Cùng truy vấn, sau ANALYZE: nhanh hơn năm nghìn lần
Không đổi một chữ nào trong câu SELECT, chỉ chạy lại EXPLAIN QUERY PLAN:
EXPLAIN QUERY PLAN SELECT * FROM don WHERE tp='Da Nang' AND khach='KH012345';
-- `--SEARCH don USING INDEX idx_khach (khach=?)   ← giờ chọn ĐÚNG idx_khach
chưa ANALYZE → idx_tp:      53 ms / truy vấn
sau  ANALYZE → idx_khach:  0,010 ms / truy vấn       (~5.300 lần nhanh hơn)
Cùng dữ liệu, cùng index, cùng câu lệnh — khác biệt duy nhất là SQLite giờ biết index nào chọn lọc hơn. Đây là lý do ANALYZE đáng chạy trên mọi CSDL có bảng lớn với nhiều index: nó không thay đổi dữ liệu, chỉ cho bộ lập kế hoạch đôi mắt để chọn đúng.
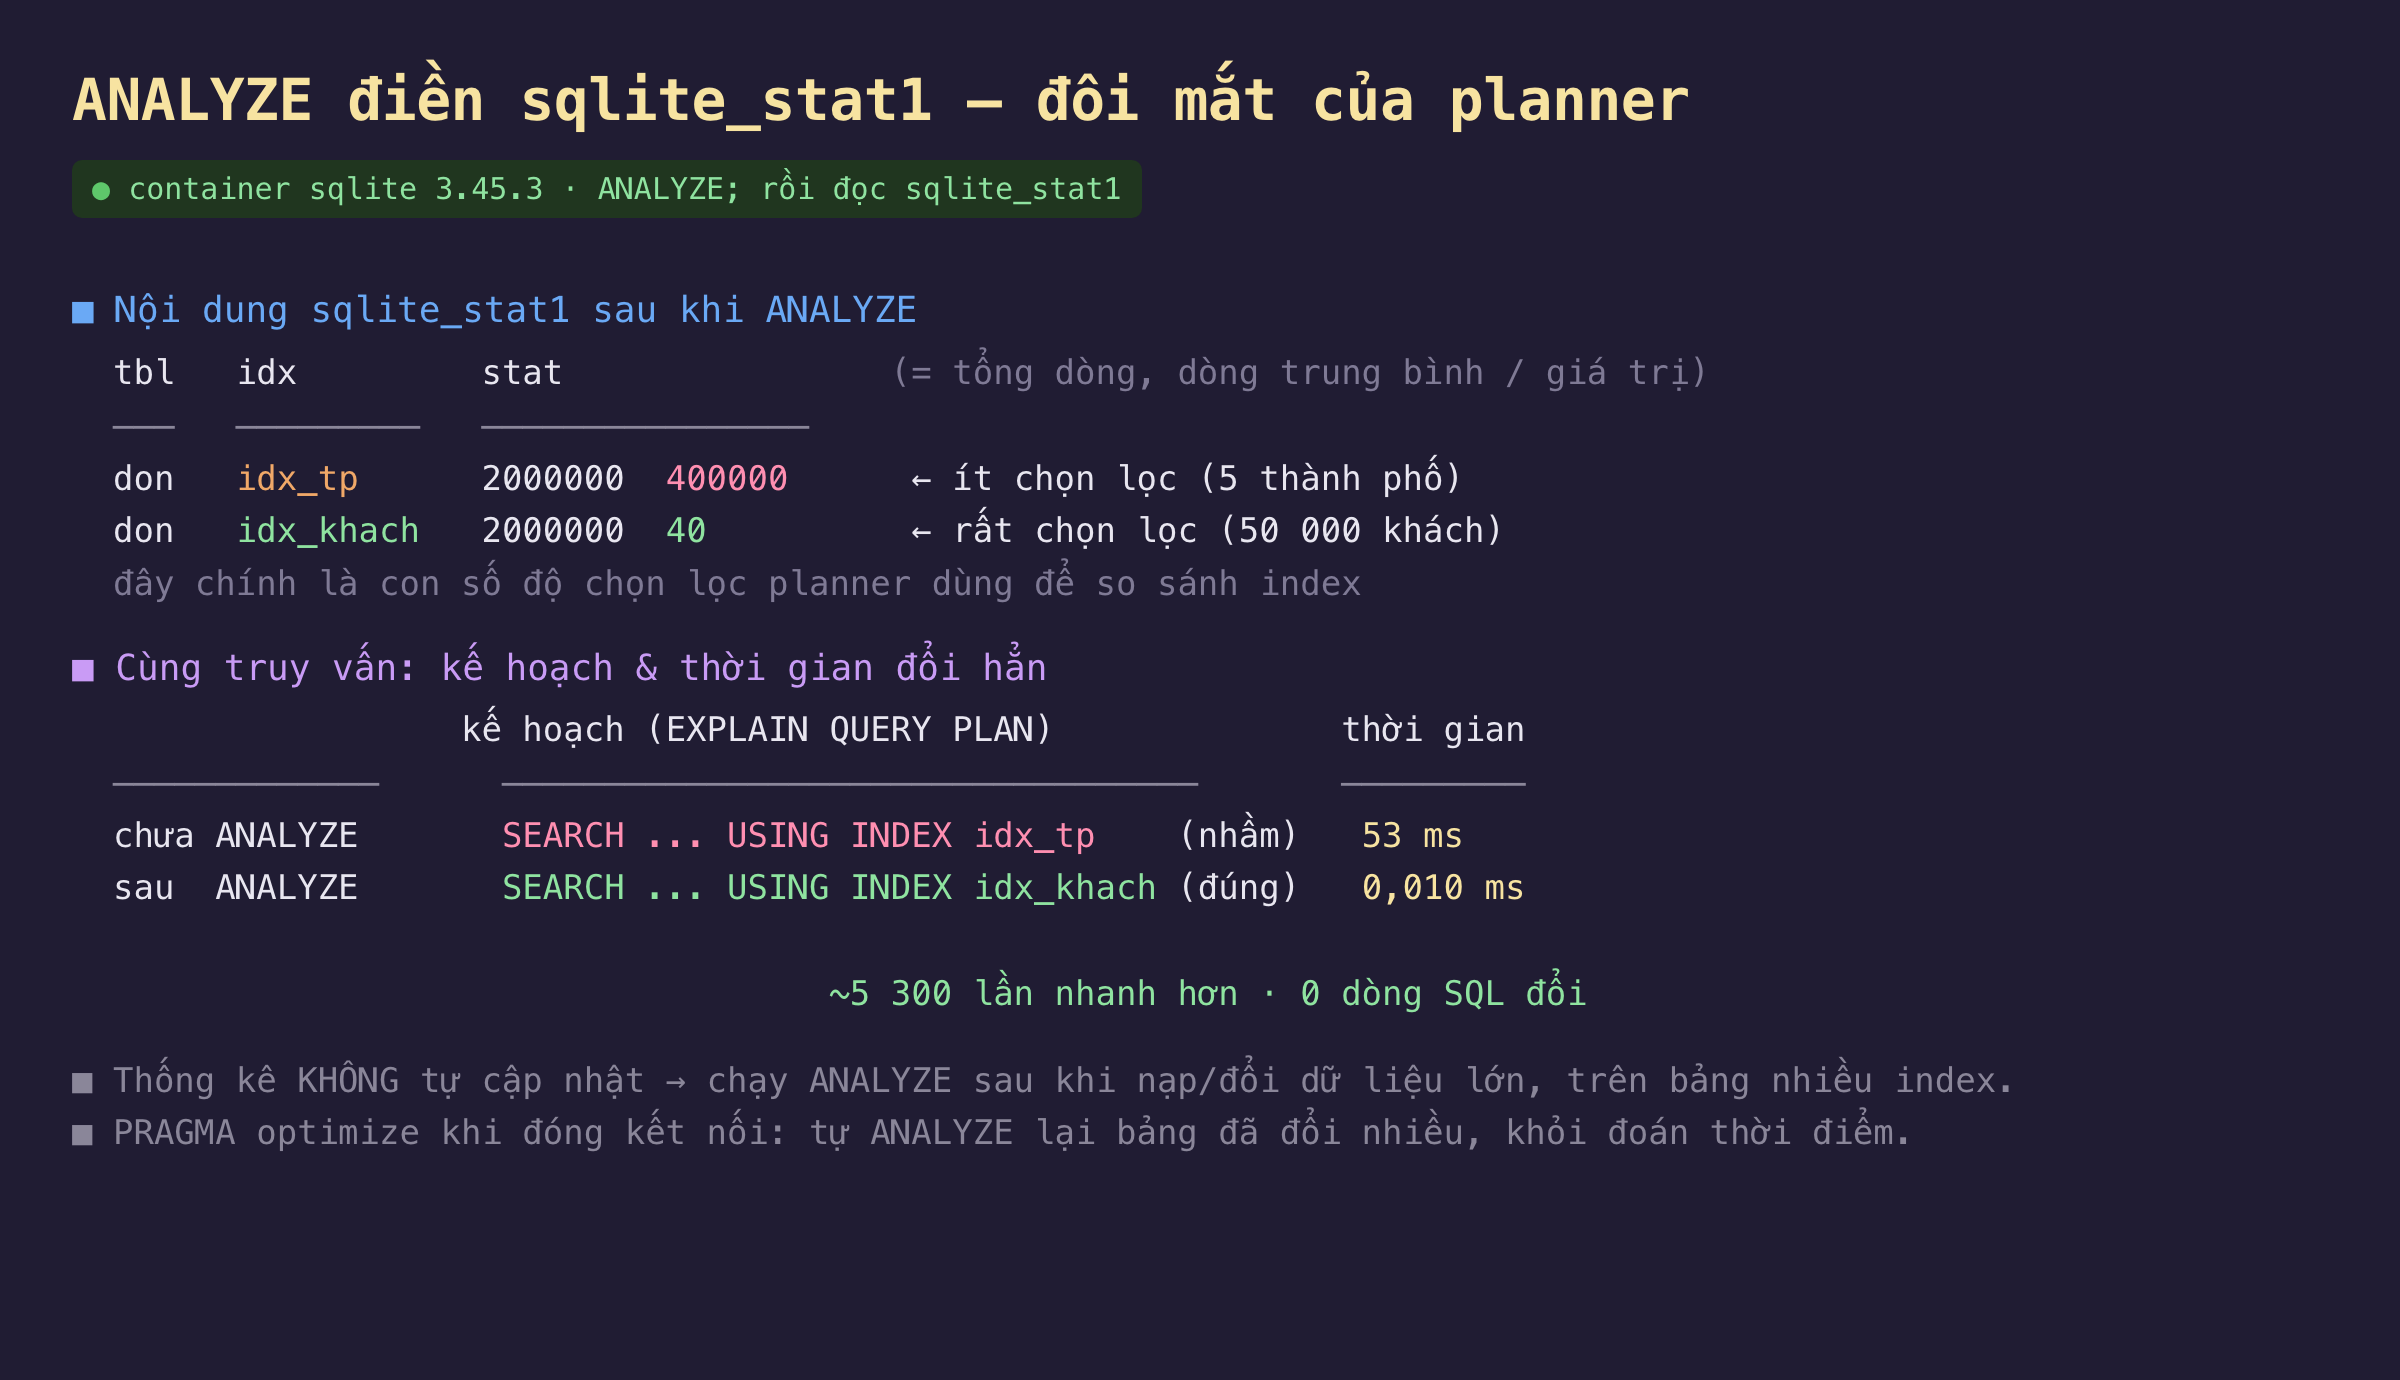
Hình 2: sqlite_stat1 lưu độ chọn lọc mỗi index (trên); nhờ nó, cùng truy vấn chuyển từ chọn nhầm idx_tp (53 ms) sang chọn đúng idx_khach (0,010 ms) — đo bằng container sqlite 3.45.3.
Khi nào chạy ANALYZE
Thống kê không tự cập nhật — sqlite_stat1 chỉ phản ánh dữ liệu tại thời điểm ANALYZE chạy. Nguyên tắc thực dụng: chạy ANALYZE sau khi nạp một lượng lớn dữ liệu hoặc sau khi dữ liệu đổi nhiều về phân bố, và trên các bảng có nhiều index khả dĩ cho cùng truy vấn. SQLite còn có PRAGMA optimize — chạy nó khi đóng kết nối sẽ tự ANALYZE lại những bảng đã thay đổi đáng kể, một cách gọn để giữ thống kê tươi mà không phải đoán thời điểm. Với bảng chỉ một index hoặc truy vấn chỉ theo khóa chính, ANALYZE ít quan trọng hơn vì không có lựa chọn nào để cân.
Vì sao điều này quan trọng
Bộ lập kế hoạch là bộ não của SQLite, nhưng nó chỉ thông minh bằng dữ liệu nó có. Ta vừa đo một trường hợp nó chọn nhầm index chậm năm nghìn lần đơn giản vì thiếu thống kê — và sửa bằng đúng một lệnh ANALYZE. Bài học: khi một truy vấn chậm bất ngờ dù có index phù hợp, nghi ngờ đầu tiên là bộ lập kế hoạch đang chọn sai đường, và EXPLAIN QUERY PLAN cộng ANALYZE là cặp công cụ để chẩn đoán và chữa. Tới đây ta đã đi hết phía đọc — bảng, cây, index, kế hoạch. Phần sau quay sang phía ghi: khi bạn thay đổi dữ liệu, SQLite đảm bảo an toàn trước sự cố bằng cách nào? Bắt đầu từ cơ chế mặc định — nhật ký hoàn tác (rollback journal) — đo bằng chính các tệp phụ nó tạo ra trên đĩa.
