Khi nói "cơ sở dữ liệu" phần lớn chúng ta nghĩ tới một tiến trình máy chủ chạy nền: PostgreSQL, MySQL, một cổng mạng, một tài khoản, một kết nối. SQLite phá vỡ hình dung đó. Nó không có tiến trình máy chủ nào cả — chỉ là một thư viện C liên kết thẳng vào chương trình của bạn, và toàn bộ cơ sở dữ liệu là một file duy nhất trên đĩa. Không cổng mạng, không daemon, không cấu hình khởi động. Đó cũng là lý do SQLite là engine CSDL được triển khai nhiều nhất hành tinh: nó nằm trong mọi điện thoại Android và iOS, mọi trình duyệt, vô số ứng dụng desktop.
Sê-ri này mổ xẻ SQLite bằng cách đo thật từng cơ chế trong container sqlite 3.45.3: định dạng file, cây B-tree, index, bộ lập kế hoạch truy vấn, nhật ký hoàn tác, WAL, giao dịch, kiểu động, VACUUM và cache. Không trích dẫn tài liệu suông — mỗi khẳng định đều kèm con số hoặc byte thật đọc ra từ file. Bài mở đầu đặt nền ở chỗ căn bản nhất: một file đó trông như thế nào.
Cả cơ sở dữ liệu là một file — và nó rỗng cho tới lần ghi đầu
Hãy bắt đầu bằng điều đơn giản nhất đo được: mở một CSDL mà không ghi gì, rồi tạo một bảng.
sqlite3 e1.db ""            -- chỉ mở, không ghi gì
-- file: 0 byte

sqlite3 e1.db "CREATE TABLE a(x);"
-- file: 8192 byte
Mở một file CSDL mà không chạy câu lệnh nào thì nó vẫn là 0 byte — SQLite không ghi gì cho tới khi thực sự có dữ liệu cần lưu. Ngay khi CREATE TABLE đầu tiên chạy, file nhảy lên 8192 byte. Con số này không ngẫu nhiên: nó là 2 trang, mỗi trang 4096 byte. SQLite tổ chức file thành các trang (page) cố định kích thước, đánh số từ 1. Trang 1 luôn đặc biệt (chứa header và lược đồ), và bảng mới cần thêm một trang gốc cho cây B-tree của nó — nên tối thiểu là 2 trang.
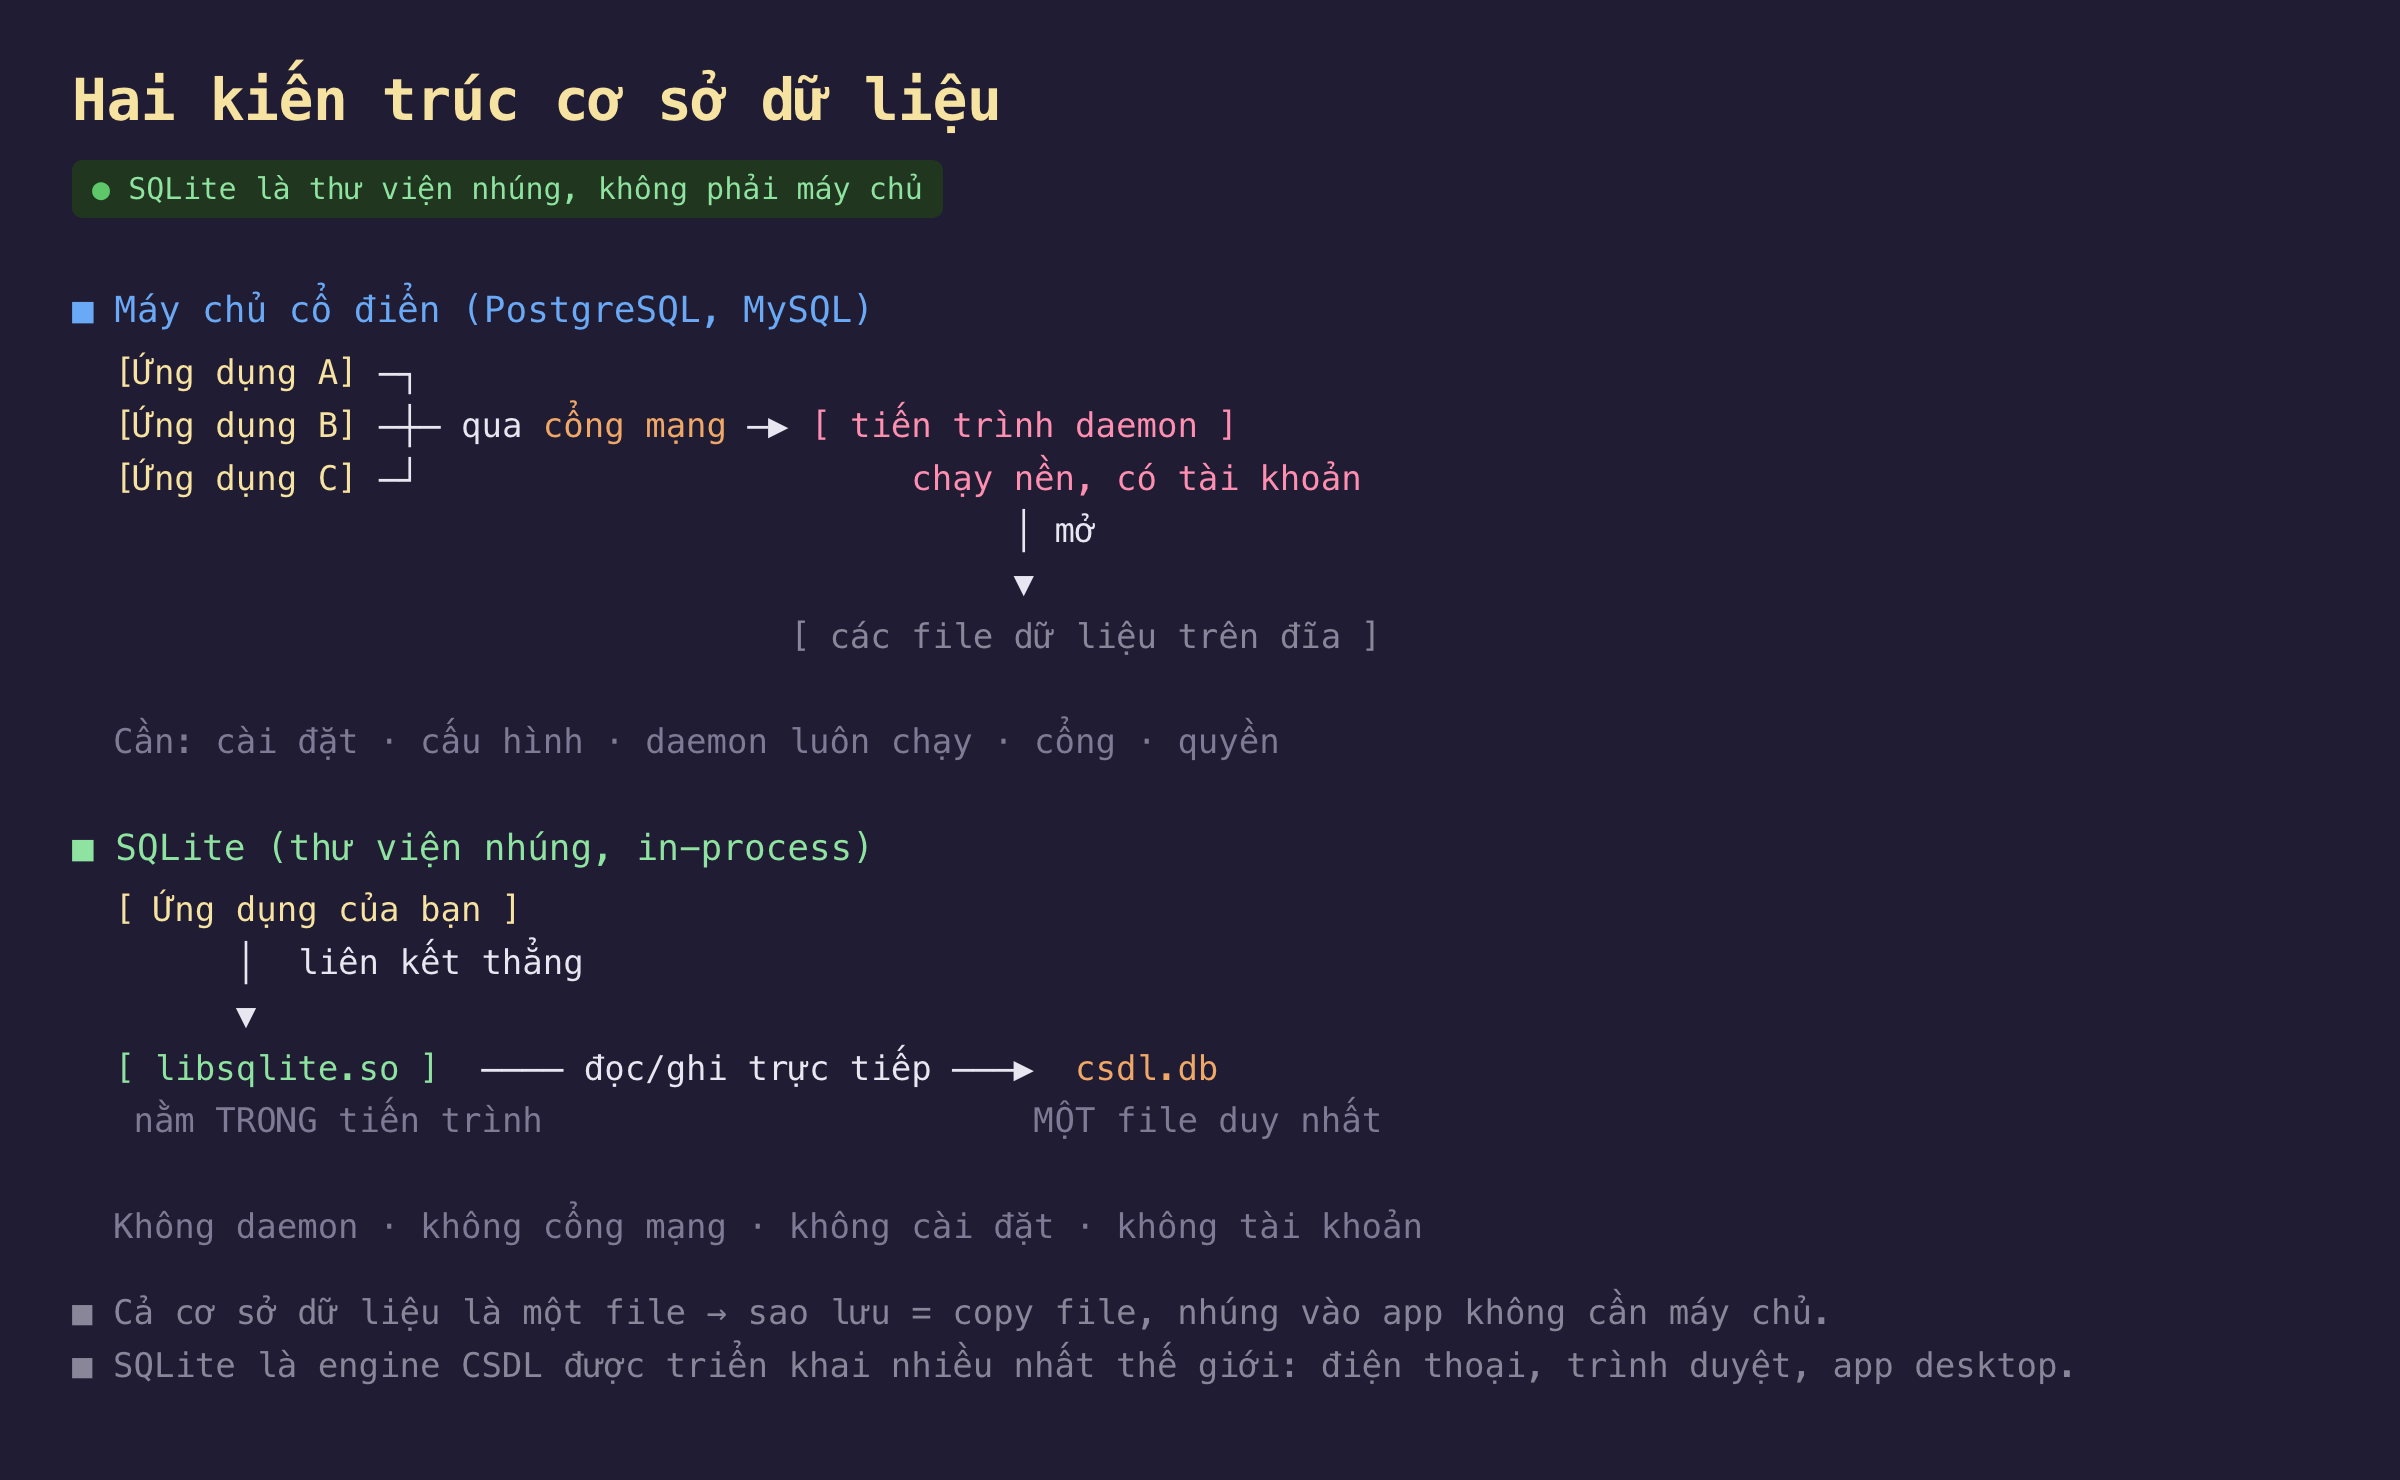
Hình 1: SQLite là thư viện nhúng chạy trong tiến trình ứng dụng, đọc ghi thẳng một file — khác hẳn mô hình client gọi tới một máy chủ CSDL chạy nền.
16 byte đầu tiên: chuỗi ma thuật
Mọi file SQLite hợp lệ đều mở đầu bằng cùng một chuỗi. Đọc 16 byte đầu bằng xxd:
00000000: 5351 4c69 7465 2066 6f72 6d61 7420 3300 SQLite format 3.
Đúng 16 byte: "SQLite format 3\0" (15 ký tự cộng một byte NUL kết thúc). Đây là magic string — thứ đầu tiên thư viện kiểm tra khi mở file. Nếu 16 byte này sai, SQLite từ chối file ngay, không thử đoán. Lệnh file của Unix cũng nhận ra CSDL SQLite nhờ đúng chuỗi này.
Header 100 byte: bản đồ của cả file
100 byte đầu của trang 1 là header cơ sở dữ liệu, một cấu trúc cố định mô tả toàn bộ phần còn lại. Đọc nguyên 100 byte:
00000000: 5351 4c69 7465 2066 6f72 6d61 7420 3300  SQLite format 3.
00000010: 1000 0101 0040 2020 0000 0002 0000 0002  .....@  ........
00000020: 0000 0000 0000 0000 0000 0001 0000 0004  ................
00000030: 0000 0000 0000 0000 0000 0001 0000 0000  ................
...
00000038: 0000 0001                                (offset 56: encoding)
Vài trường quan trọng, đọc trực tiếp ra byte:
| Offset | Dài | Giá trị đo được | Ý nghĩa |
|---|---|---|---|
| 0 | 16 | SQLite format 3\0 |
Chuỗi ma thuật |
| 16 | 2 | 0x1000 = 4096 |
page_size — kích thước mỗi trang |
| 18 | 1 | 0x01 |
Phiên bản định dạng khi ghi |
| 19 | 1 | 0x01 |
Phiên bản định dạng khi đọc |
| 28 | 4 | 0x00000002 = 2 |
page_count — số trang trong file |
| 56 | 4 | 0x00000001 = 1 |
Mã hóa văn bản: 1 = UTF-8 |
Trường ở offset 16 nói page_size = 4096, và trường ở offset 28 nói page_count = 2. Nhân lại: 4096 × 2 = 8192 — đúng bằng kích thước file. Đây không phải trùng hợp mà là bất biến của định dạng: kích thước một file SQLite khỏe mạnh luôn đúng bằng page_size × page_count.
SELECT (SELECT page_size  FROM pragma_page_size)
     * (SELECT page_count FROM pragma_page_count);
-- 8192  (= đúng kích thước file trên đĩa)
page_size đổi được, và file co giãn theo
page_size mặc định là 4096, nhưng đặt được trước khi bảng đầu tiên ra đời. Đo ba lựa chọn:
PRAGMA page_size = 512;   CREATE TABLE a(x);   -- file: 1024 byte  (2 × 512)
PRAGMA page_size = 4096;  CREATE TABLE a(x);   -- file: 8192 byte  (2 × 4096)
PRAGMA page_size = 8192;  CREATE TABLE a(x);   -- file: 16384 byte (2 × 8192)
Cả ba đều là 2 trang sau đúng một bảng rỗng — chỉ khác kích thước mỗi trang. page_size quyết định rất nhiều về sau: trang lớn chứa được nhiều dòng hơn mỗi lần đọc đĩa (tốt cho quét tuần tự) nhưng lãng phí hơn với CSDL nhỏ và ghi lẻ. Các bài sau sẽ đo đúng sự đánh đổi này.
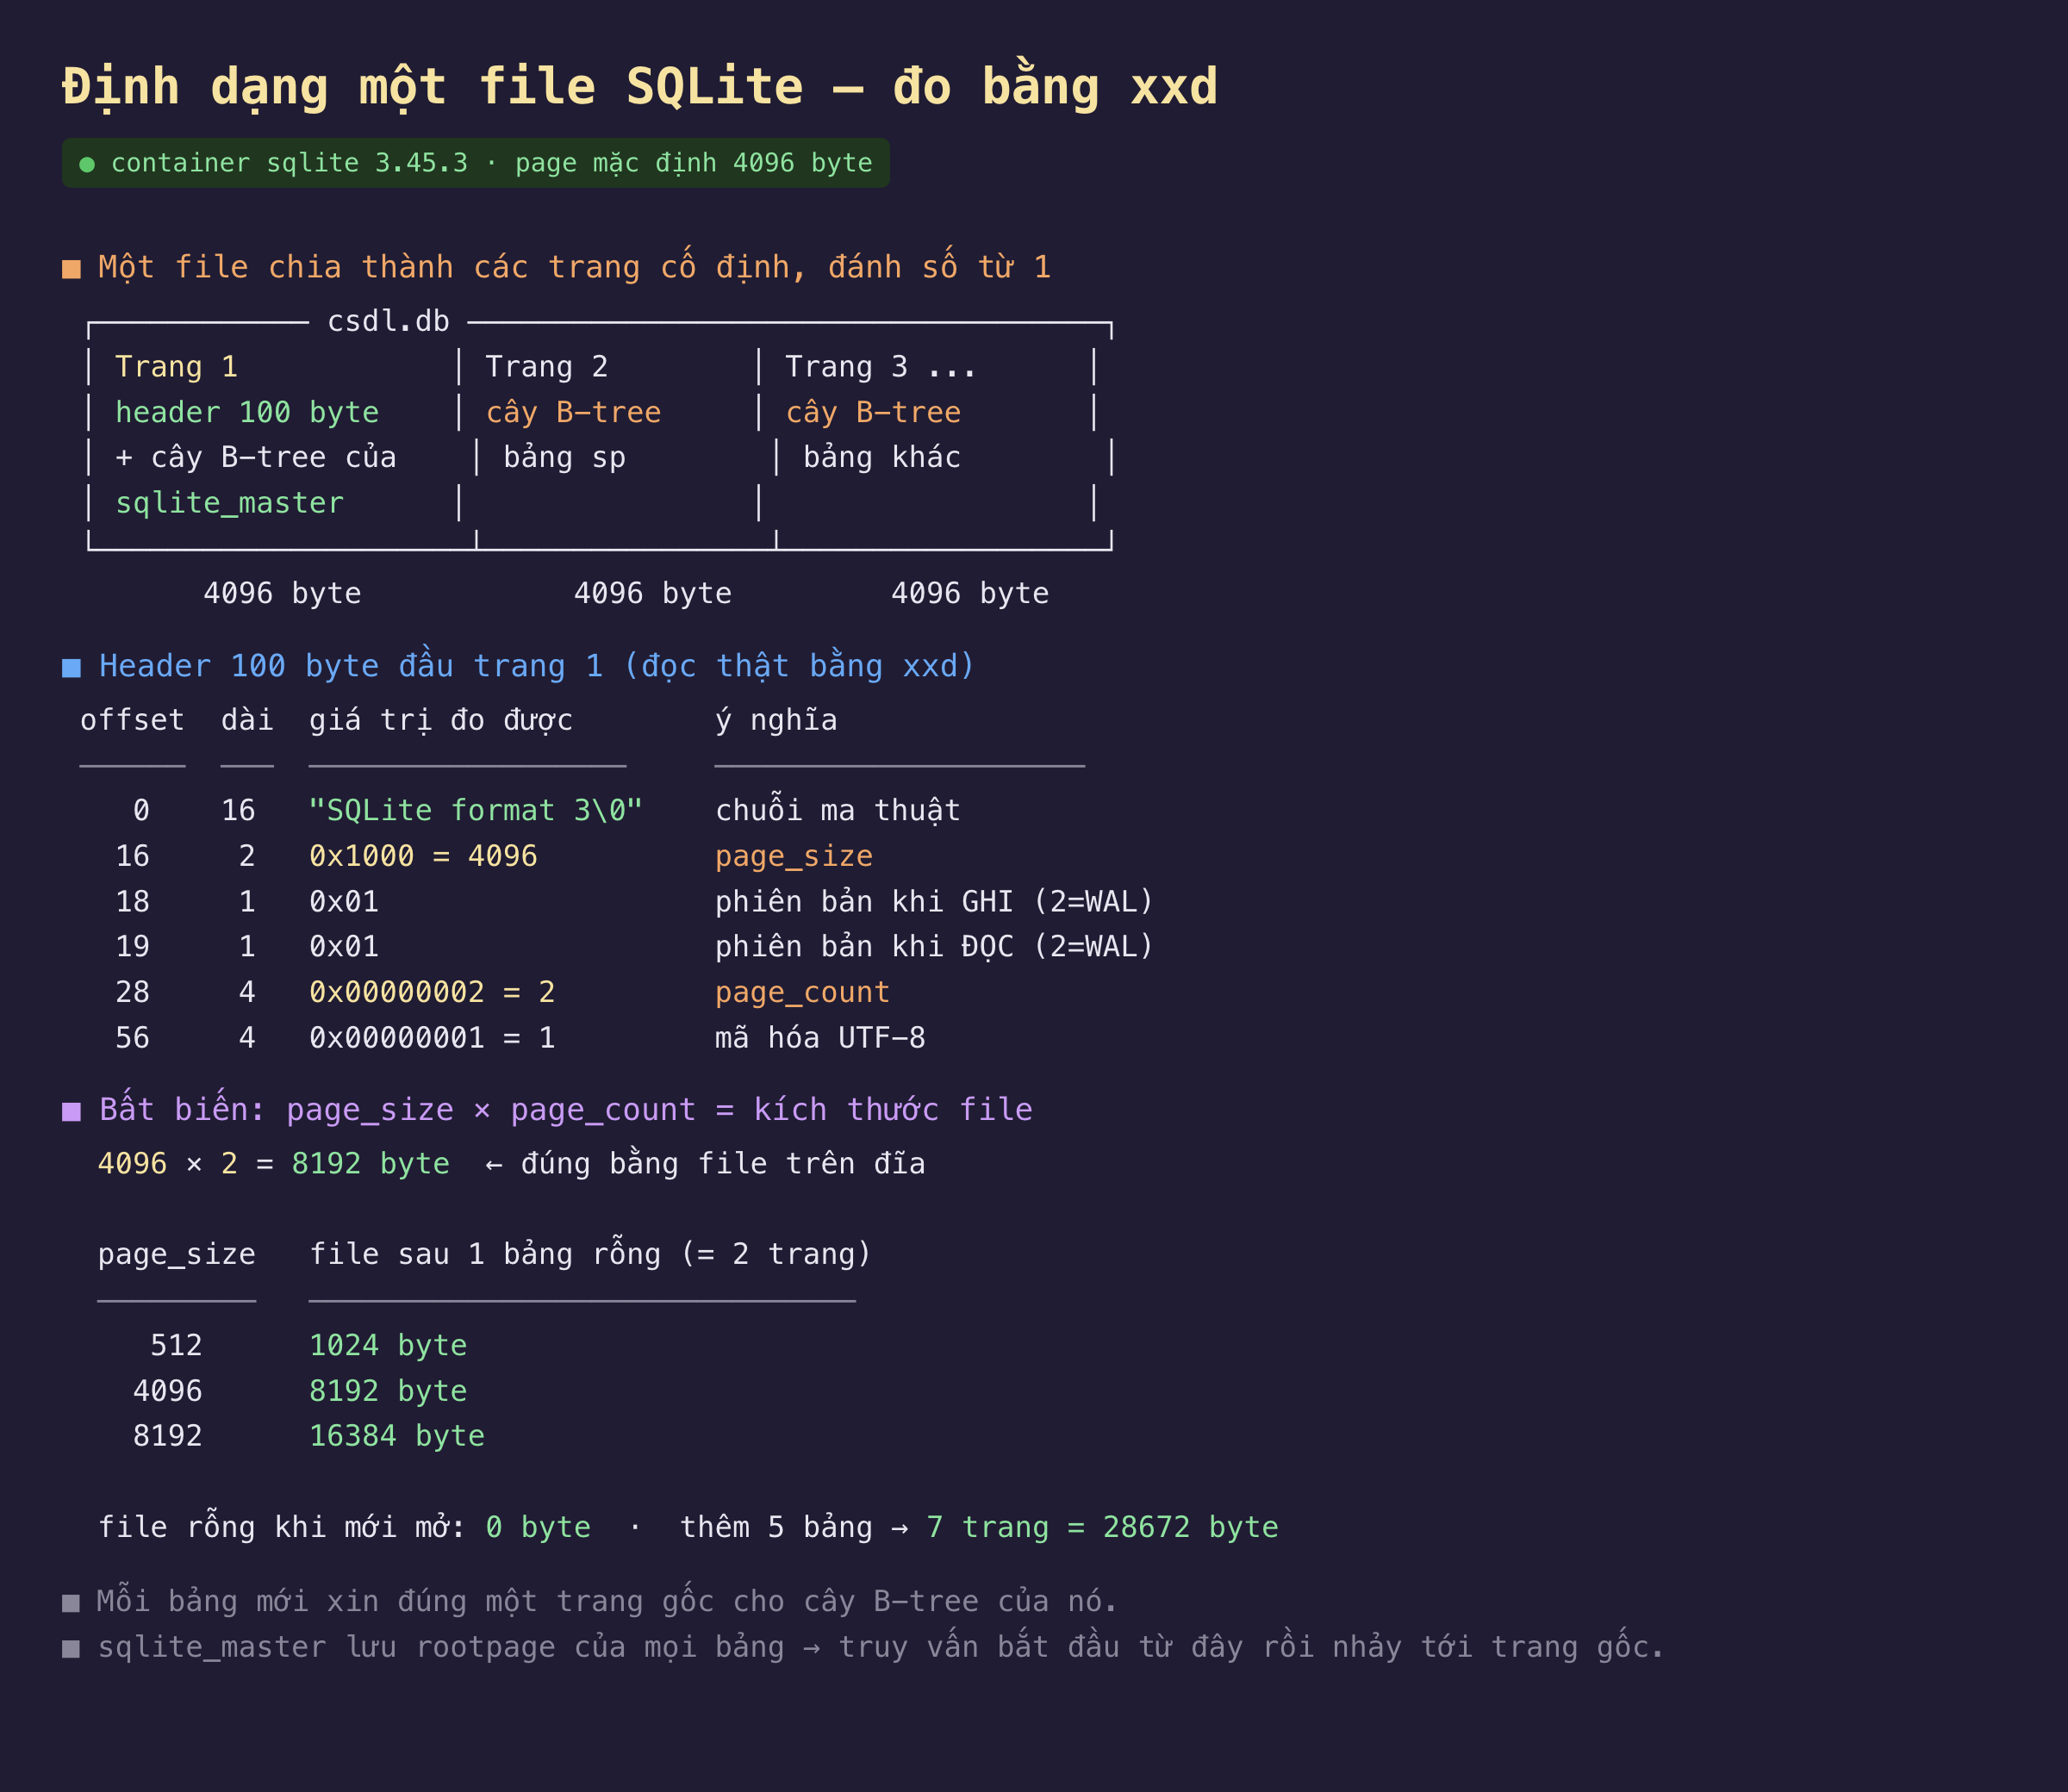
Hình 2: Cấu trúc một file SQLite — các trang cố định kích thước, header 100 byte ở đầu trang 1, và quan hệ page_size × page_count = kích thước file, đọc thật bằng xxd trong container sqlite 3.45.3.
sqlite_master: lược đồ cũng là một cây B-tree
SQLite lưu lược đồ của chính nó ở đâu? Trong một bảng tên sqlite_master, và bảng đó là một cây B-tree nằm ngay trên trang 1, sau 100 byte header. Mỗi lần tạo bảng, index hay view, một dòng được thêm vào đây:
SELECT type, name, rootpage, substr(sql,1,40) FROM sqlite_master;
-- table | sp | 2 | CREATE TABLE sp(id INTEGER PRIMARY KEY,
Dòng này nói: có một table tên sp, cây B-tree của nó bắt đầu ở trang 2 (rootpage), và câu lệnh đã tạo ra nó là gì. Khi bạn truy vấn SELECT ... FROM sp, SQLite trước tiên đọc sqlite_master để tìm rootpage của sp, rồi nhảy tới trang đó để duyệt cây. Không có gì "bên ngoài" file — ngay cả định nghĩa bảng cũng chỉ là dữ liệu trong một cây B-tree khác.
Thêm nhiều bảng thì file lớn thêm từng trang gốc một. Tạo thêm 5 bảng rỗng:
CREATE TABLE t1(x); ... CREATE TABLE t5(x);
PRAGMA page_count;   -- 7
-- file: 28672 byte  (= 7 × 4096)
Từ 2 lên 7 trang: mỗi bảng mới xin đúng một trang gốc cho cây B-tree của nó, và file nở ra theo bội số của page_size. Không có khoảng trống bí ẩn, không có vùng metadata ẩn ngoài trang 1 — mọi byte đều thuộc về một trang có số.
Hai byte phiên bản: dấu vết của chế độ nhật ký
Nhớ lại offset 18 và 19 lúc nãy đều là 0x01. Hai byte đó không cố định — chúng cho biết file đang dùng chế độ nhật ký nào. Bật WAL rồi đọc lại:
PRAGMA journal_mode = WAL; CREATE TABLE a(x);
00000012: 0202 (offset 18-19: trước là 01 01, giờ là 02 02)
Hai byte nhảy từ 01 01 sang 02 02. Giá trị 1 nghĩa là chế độ nhật ký hoàn tác cổ điển (rollback journal), giá trị 2 nghĩa là WAL (Write-Ahead Log). Chỉ hai byte này quyết định một CSDL cũ có mở nổi file hay không: một thư viện SQLite quá cũ không biết WAL sẽ thấy 0x02 ở byte "phiên bản đọc" và từ chối mở — đó chính là mục đích của trường này. Sự khác biệt giữa hai chế độ, cùng những con số hiệu năng và đồng thời rất khác nhau của chúng, là nội dung của phần 6 và phần 7.
Vì sao điều này quan trọng
"Cả CSDL là một file" không phải khẩu hiệu tiếp thị mà là một tính chất đo được đến từng byte: một header 100 byte tự mô tả, các trang cố định kích thước, và bất biến page_size × page_count = kích thước file. Chính kiến trúc này cho SQLite những điểm mạnh riêng — sao lưu bằng cách copy một file, nhúng vào ứng dụng không cần cài đặt, chạy không cần quyền quản trị — và cả những giới hạn mà phần 12 sẽ cân nhắc. Nhưng trái tim của tốc độ truy vấn không nằm ở header, mà ở thứ các trang kia tổ chức nên: cây B-tree. Bài sau mở một file thật ra, đếm số trang và đo độ sâu của cây lớn dần theo dữ liệu — để thấy vì sao tìm một dòng trong hàng triệu dòng chỉ tốn vài lần đọc trang.
