Phần trước thấy một file SQLite là tập hợp các trang cố định kích thước, và sqlite_master trỏ tới rootpage của mỗi bảng. Bài này đi vào chính cấu trúc mà các trang đó tạo nên — thứ quyết định vì sao SQLite tìm một dòng trong hàng triệu dòng gần như tức thì: cây B-tree. Và điểm bất ngờ đáng đo nhất là cây này phẳng đến mức nào. Mọi phép đo dưới đây đọc thẳng từ bảng ảo dbstat trong container sqlite 3.45.3 — một bảng hệ thống liệt kê từng trang của file kèm loại và vị trí trong cây.
Mọi thứ đều là B-tree
Trong SQLite, bảng không phải một mảng dòng, index không phải một cấu trúc tách biệt — cả hai đều là cây B-tree, chỉ khác nội dung trang lá. Tạo một bảng, một triệu dòng, rồi một index, và hỏi dbstat xem file gồm những gì:
name            pagetype   số_trang
─────────────   ────────   ────────
sp              internal   19          ← cây B-tree của BẢNG
sp              leaf       7105
idx_gia         internal   15          ← cây B-tree của INDEX
idx_gia         leaf       3165
sqlite_schema   leaf       1           ← chính lược đồ cũng là b-tree
Ba cây B-tree riêng biệt trong cùng một file: cây của bảng sp, cây của index idx_gia, và cây một trang của lược đồ. Không có cấu trúc dữ liệu nào khác — hiểu B-tree là hiểu cách SQLite lưu mọi thứ.
Trang trong điều hướng, trang lá chứa dữ liệu
Một cây B-tree của bảng có hai loại trang. Trang lá (leaf) nằm ở đáy và chứa trọn vẹn các dòng dữ liệu, sắp theo rowid. Trang trong (internal) nằm phía trên và không chứa dữ liệu dòng — chỉ chứa các khóa phân chia và con trỏ xuống trang con. Khi tìm một dòng, SQLite bắt đầu từ trang gốc, so khóa để chọn đúng nhánh, đi xuống, lặp lại cho tới khi chạm trang lá chứa dòng cần tìm.
Số dòng mỗi trang lá chứa được là hữu hạn — đo thật trên bảng sp (mỗi dòng có id, tên, giá):
leaf ncell:     min=137  max=181  avg=140   (dòng dữ liệu / trang lá)
internal ncell: min=17   max=409  avg=373   (con trỏ / trang trong)
Mỗi trang lá 4096 byte chứa trung bình 140 dòng. Còn mỗi trang trong chứa trung bình 373 con trỏ tới trang con — vì nó chỉ cần lưu một khóa rowid (một số nguyên nén varint) cộng một con trỏ trang cho mỗi nhánh, nên nhồi được rất nhiều. Con số 373 này — hệ số phân nhánh (fanout) — là lý do cả bài.
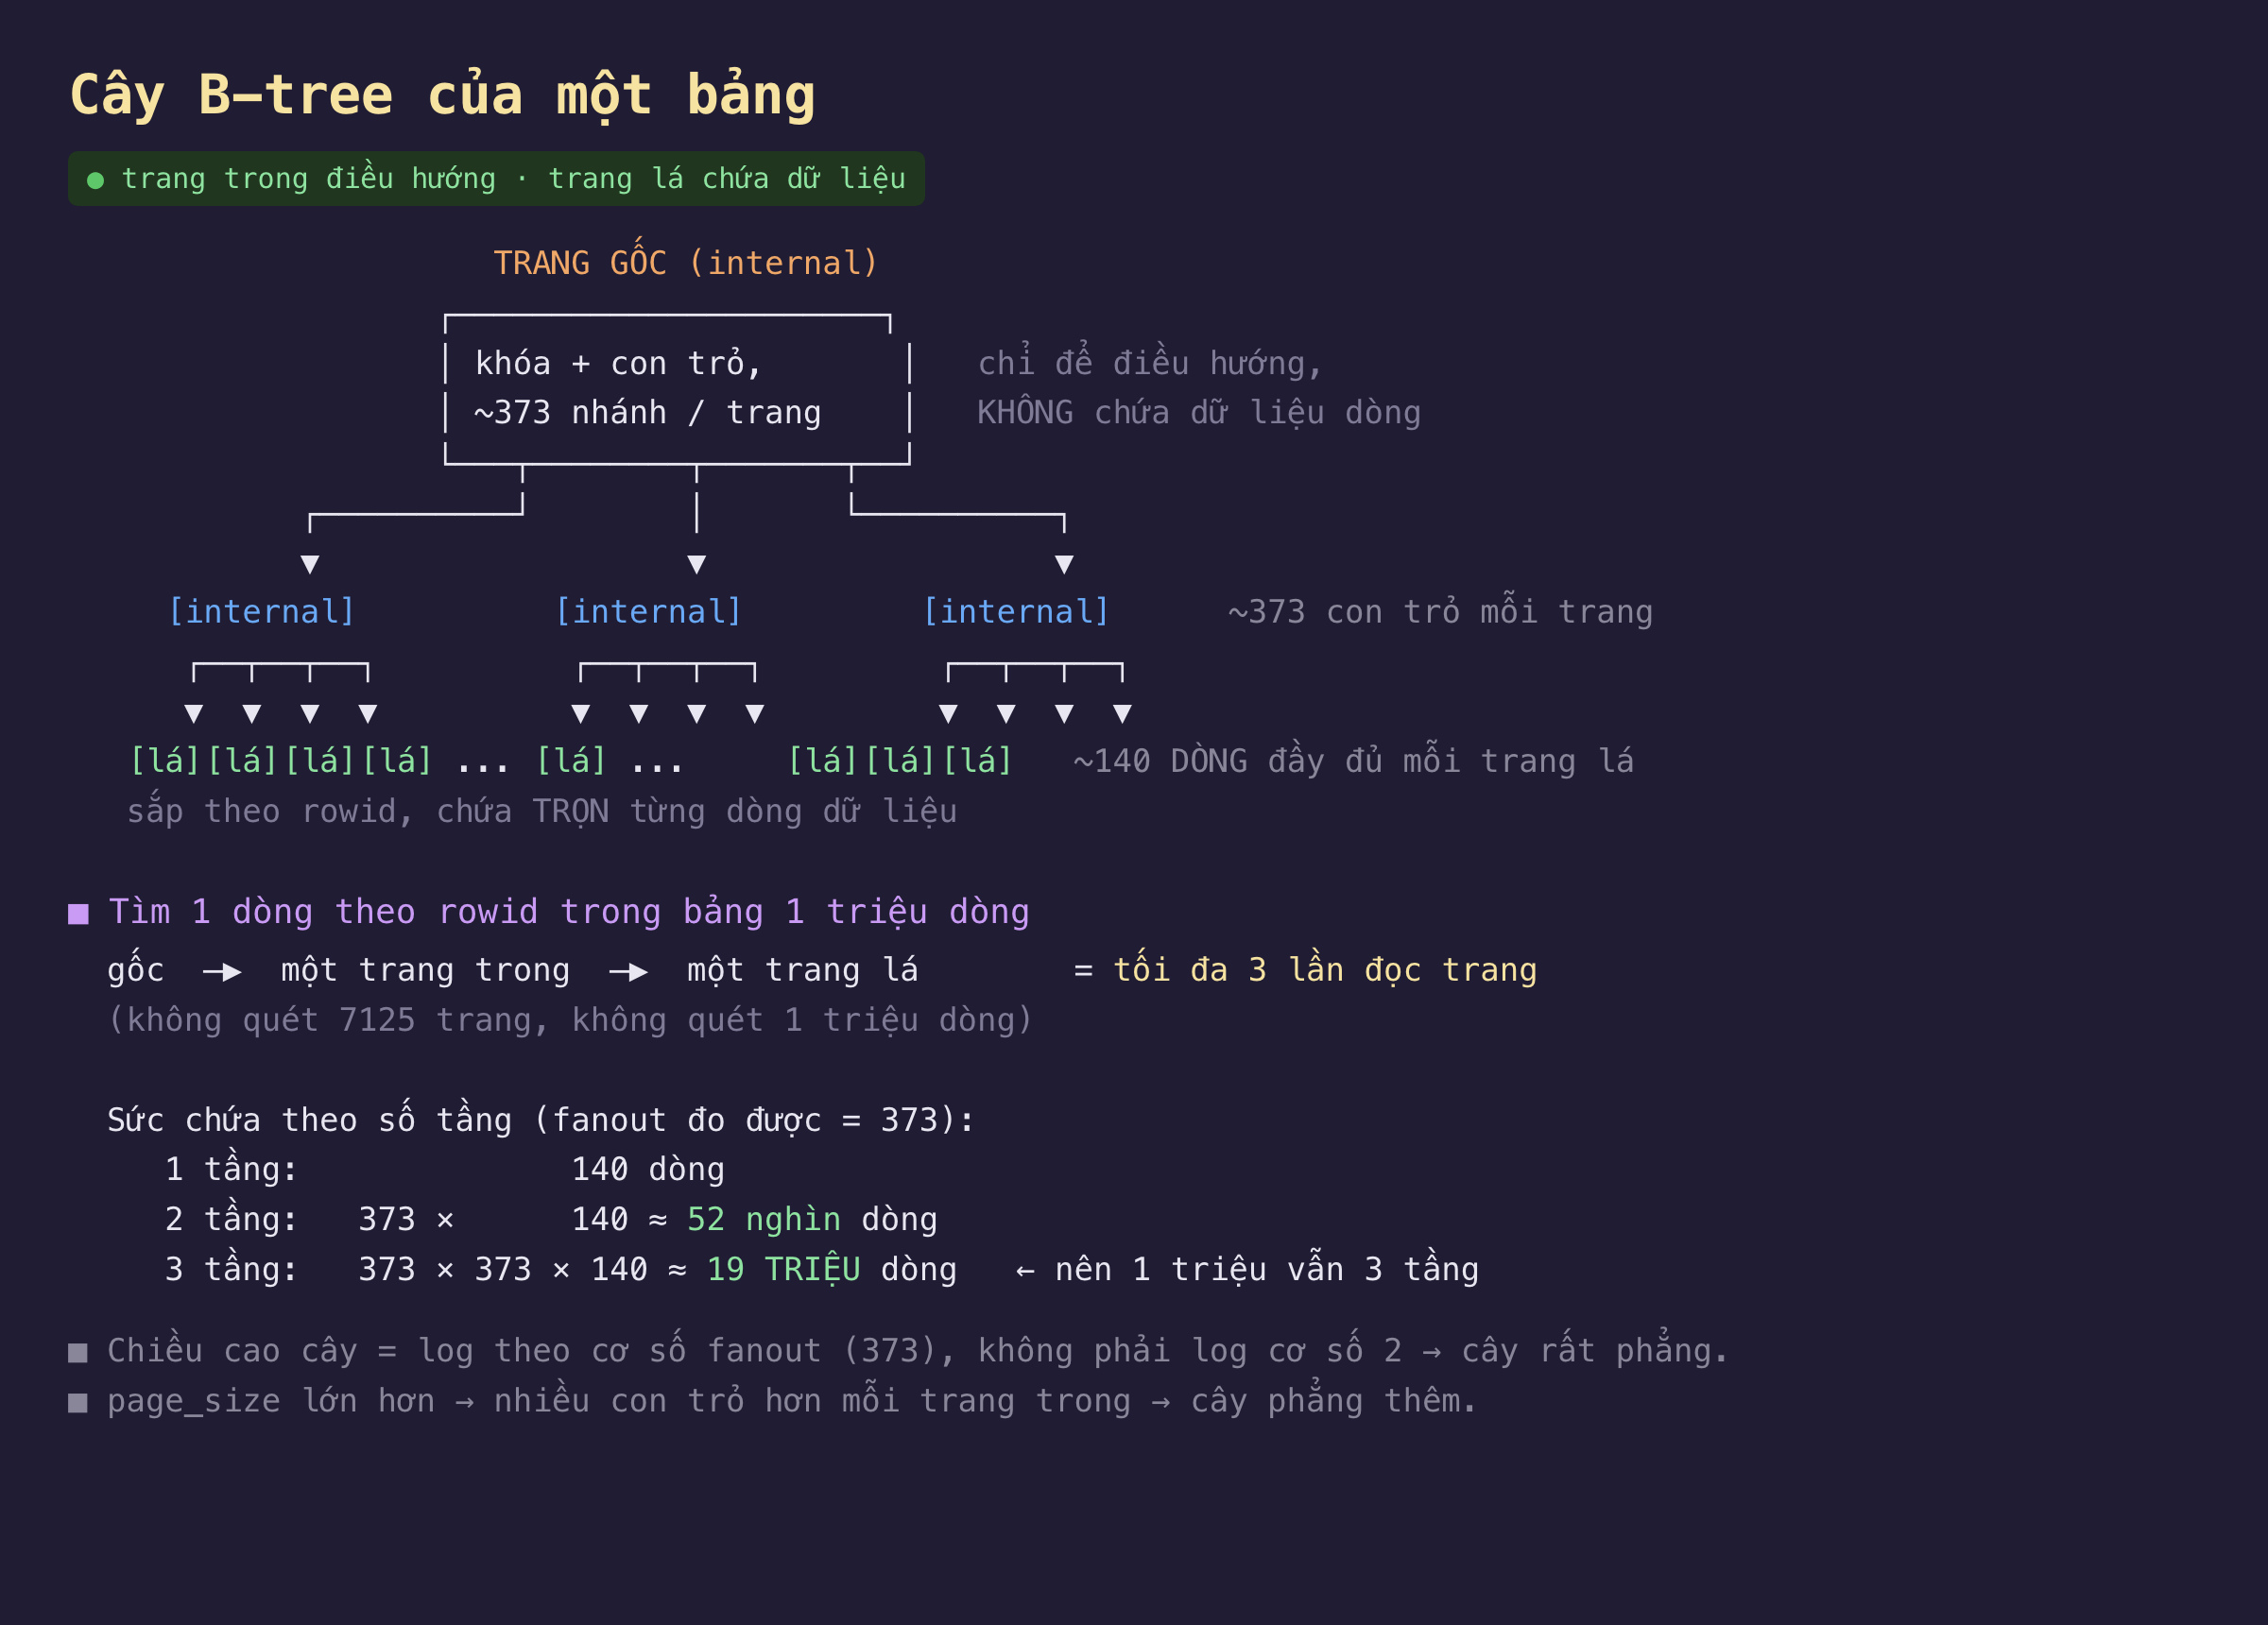
Hình 1: Cây B-tree của bảng — trang trong chỉ chứa khóa và con trỏ để điều hướng, trang lá chứa trọn dòng dữ liệu. Hệ số phân nhánh lớn giữ cây rất phẳng.
Đo chiều cao cây lớn dần theo dữ liệu
Đây là phép đo cốt lõi. Nạp bảng sp với số dòng tăng dần, và mỗi lần đo số trang, kích thước file, và chiều cao cây (số tầng, đọc từ độ sâu đường dẫn trong dbstat):
| Số dòng | Số trang | Kích thước file | Trang trong | Trang lá | Số tầng cây |
|---|---|---|---|---|---|
| 10 | 2 | 8 KB | 0 | 1 | 1 |
| 100 | 2 | 8 KB | 0 | 1 | 1 |
| 1.000 | 8 | 32 KB | 1 | 6 | 2 |
| 10.000 | 64 | 256 KB | 1 | 62 | 2 |
| 100.000 | 681 | 2,7 MB | 3 | 677 | 3 |
| 1.000.000 | 7.125 | 29 MB | 19 | 7.105 | 3 |
Đọc cột cuối cho kỹ. Với 10–100 dòng, cả bảng là một trang lá duy nhất cũng là gốc — cây cao đúng 1 tầng. Lên 1.000 dòng, một trang không đủ chứa, SQLite thêm một tầng gốc trỏ xuống 6 trang lá: 2 tầng. Và rồi từ 100.000 tới 1.000.000 dòng — gấp mười lần — cây vẫn chỉ sâu 3 tầng. Số trang nhảy từ 681 lên 7.125, nhưng chiều cao đứng yên.
Đó chính là sức mạnh của B-tree. Tìm một dòng theo rowid trong bảng một triệu dòng chỉ cần đọc tối đa 3 trang: gốc → một trang trong → một trang lá. Không phải quét 7.125 trang, không phải quét một triệu dòng — ba lần đọc trang, xong.
Vì sao cây phẳng đến thế: hệ số phân nhánh
Chiều cao cây tăng theo logarithm của số dòng, nhưng cơ số của log đó không phải 2 mà là hệ số phân nhánh — số con mỗi trang trong trỏ tới. Ta đo được avg 373. Nhẩm nhanh sức chứa theo số tầng:
1 tầng:              140 dòng          (1 trang lá)
2 tầng:   373 ×      140 ≈ 52 nghìn dòng
3 tầng:   373 × 373 × 140 ≈ 19 TRIỆU dòng
Ba tầng đã địa chỉ hóa được gần 19 triệu dòng — nên không ngạc nhiên khi một triệu dòng vẫn gọn trong 3 tầng. Vì mỗi lần thêm một tầng, sức chứa nhân với 373, chiều cao cây tăng cực kỳ chậm: một bảng tỷ dòng cũng chỉ sâu khoảng 4 tầng. Đây là lý do một CSDL dựa trên B-tree cho thời gian tra cứu gần như không đổi bất kể dữ liệu lớn cỡ nào — và vì sao page_size lớn hơn (nhồi nhiều con trỏ hơn mỗi trang trong) có thể làm cây phẳng thêm.
Index là một cây B-tree thứ hai
Khi tạo CREATE INDEX idx_gia ON sp(gia), SQLite dựng một cây B-tree hoàn toàn riêng. File đo được trước và sau:
trước index:  7.125 trang   = 29,18 MB
sau  index:  10.305 trang   = 42,21 MB   (+3.180 trang cho idx_gia)
Index idx_gia chiếm 15 trang trong + 3.165 trang lá = 3.180 trang, cũng cao 3 tầng. Nó nhỏ hơn cây của bảng (3.180 so với 7.124 trang) vì trang lá của index không chứa trọn dòng — chỉ chứa giá trị cột gia cộng rowid trỏ ngược về dòng thật trong cây của bảng. Tìm theo gia vì thế là: đi xuống cây index (3 lần đọc trang) để lấy rowid, rồi đi xuống cây bảng (3 lần đọc trang nữa) để lấy trọn dòng. Index đổi dung lượng đĩa lấy tốc độ tra cứu trên cột không phải khóa chính — và bài sau sẽ đo đúng sự đánh đổi đó qua EXPLAIN QUERY PLAN.
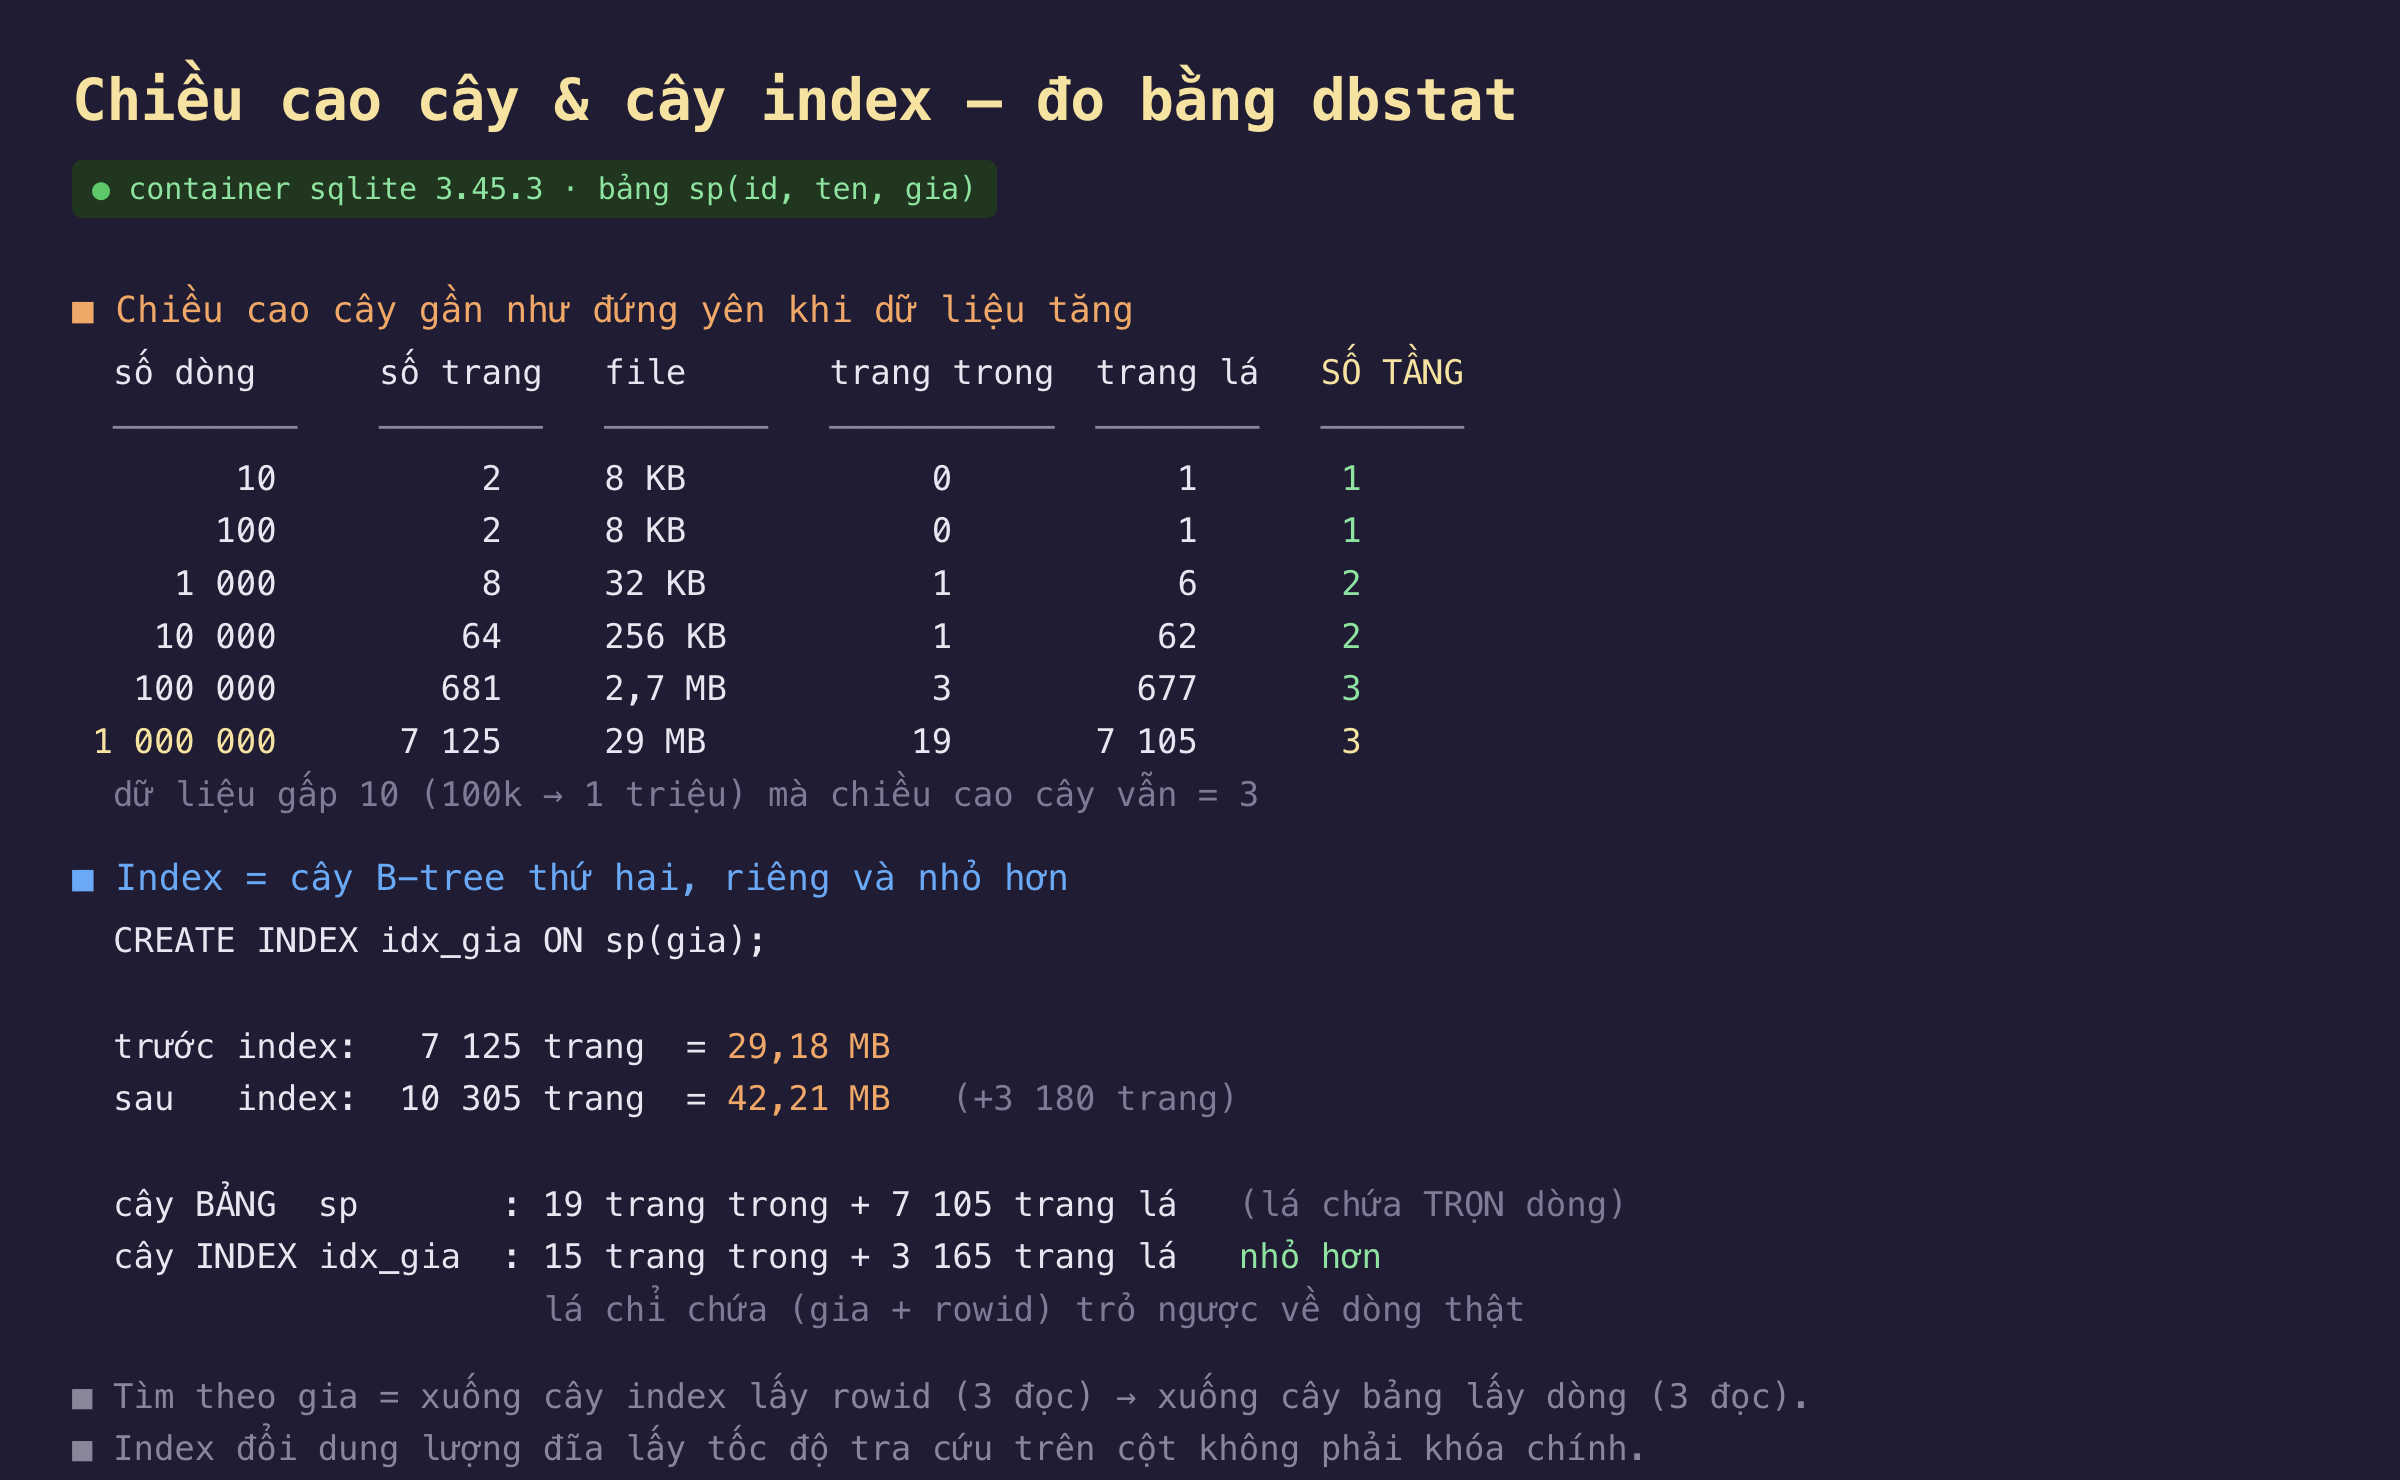
Hình 2: Chiều cao cây gần như đứng yên khi dữ liệu tăng mười lần (trên), và index là một cây B-tree riêng nhỏ hơn cây của bảng (dưới) — đo bằng dbstat trong container sqlite 3.45.3.
Vì sao điều này quan trọng
Cây B-tree là nền của mọi lời hứa hiệu năng của SQLite. Vì hệ số phân nhánh lớn giữ cây phẳng, tra cứu theo khóa gần như không đổi theo quy mô — ba lần đọc trang cho một triệu dòng, bốn cho một tỷ. Nhưng cũng chính cấu trúc này đặt ra câu hỏi tiếp theo: điều gì xảy ra khi bạn tìm theo một cột không phải khóa chính và không có index? SQLite buộc phải quét từng trang lá một — và đó là khác biệt giữa tra cứu tức thì và quét toàn bảng. Bài sau mở EXPLAIN QUERY PLAN ra để thấy SQLite chọn đường nào, và đo chênh lệch thời gian thật giữa có index và không.
