Ở phần 1, benchmark cho thấy encoding/json tốn kha khá cấp phát bộ nhớ — nhất là khi giải mã (27 allocs cho một struct). Trong một service tải cao, mỗi lần cấp phát là một chút áp lực lên bộ thu gom rác (GC), và cộng dồn theo lưu lượng thì thành đáng kể. Tin tốt: ta không cần đổi định dạng hay bỏ encoding/json để cải thiện — chỉ cần dùng nó khéo hơn. Bài này (phần 2 loạt Serialization) áp ba kỹ thuật giữ nguyên JSON và đo thật xem tiết kiệm được bao nhiêu.
Ba kỹ thuật, cùng một tư tưởng: tránh việc thừa
Cả ba đều xoay quanh một ý: đừng tạo ra thứ bạn không cần.
// 1. Encoder streaming — ghi thẳng vào buffer, không []byte trung gian
enc := json.NewEncoder(&buf)
for j := range orders {
    _ = enc.Encode(&orders[j])   // tái dùng bộ đệm nội bộ, không cấp []byte mỗi vòng
}

// 2. json.RawMessage — hoãn giải mã phần chưa cần
type Envelope struct {
    Loai string          `json:"loai"`
    Data json.RawMessage `json:"data"`  // giữ nguyên byte, CHƯA parse
}

// 3. Decoder streaming — đọc từng bản ghi từ luồng, RAM không phình
dec := json.NewDecoder(reader)
for dec.More() {
    var o Order
    dec.Decode(&o)   // xử lý từng cái, không nạp cả file vào bộ nhớ
}
json.Marshal trả về một []byte mới mỗi lần gọi — tiện khi cần một mẩu JSON, nhưng lãng phí khi ghi nhiều object liên tiếp. json.Encoder ghi thẳng vào một io.Writer và tái dùng bộ đệm bên trong. json.RawMessage là một kiểu đặc biệt bảo json: "để nguyên phần này dạng byte, đừng giải mã" — hữu ích khi bạn chỉ cần đọc vài field ngoài (định tuyến theo loai, chẳng hạn) mà chưa cần phần bên trong. json.Decoder đọc lần lượt từng giá trị từ một io.Reader, cho phép xử lý luồng lớn hay vô hạn mà không nạp hết vào RAM.
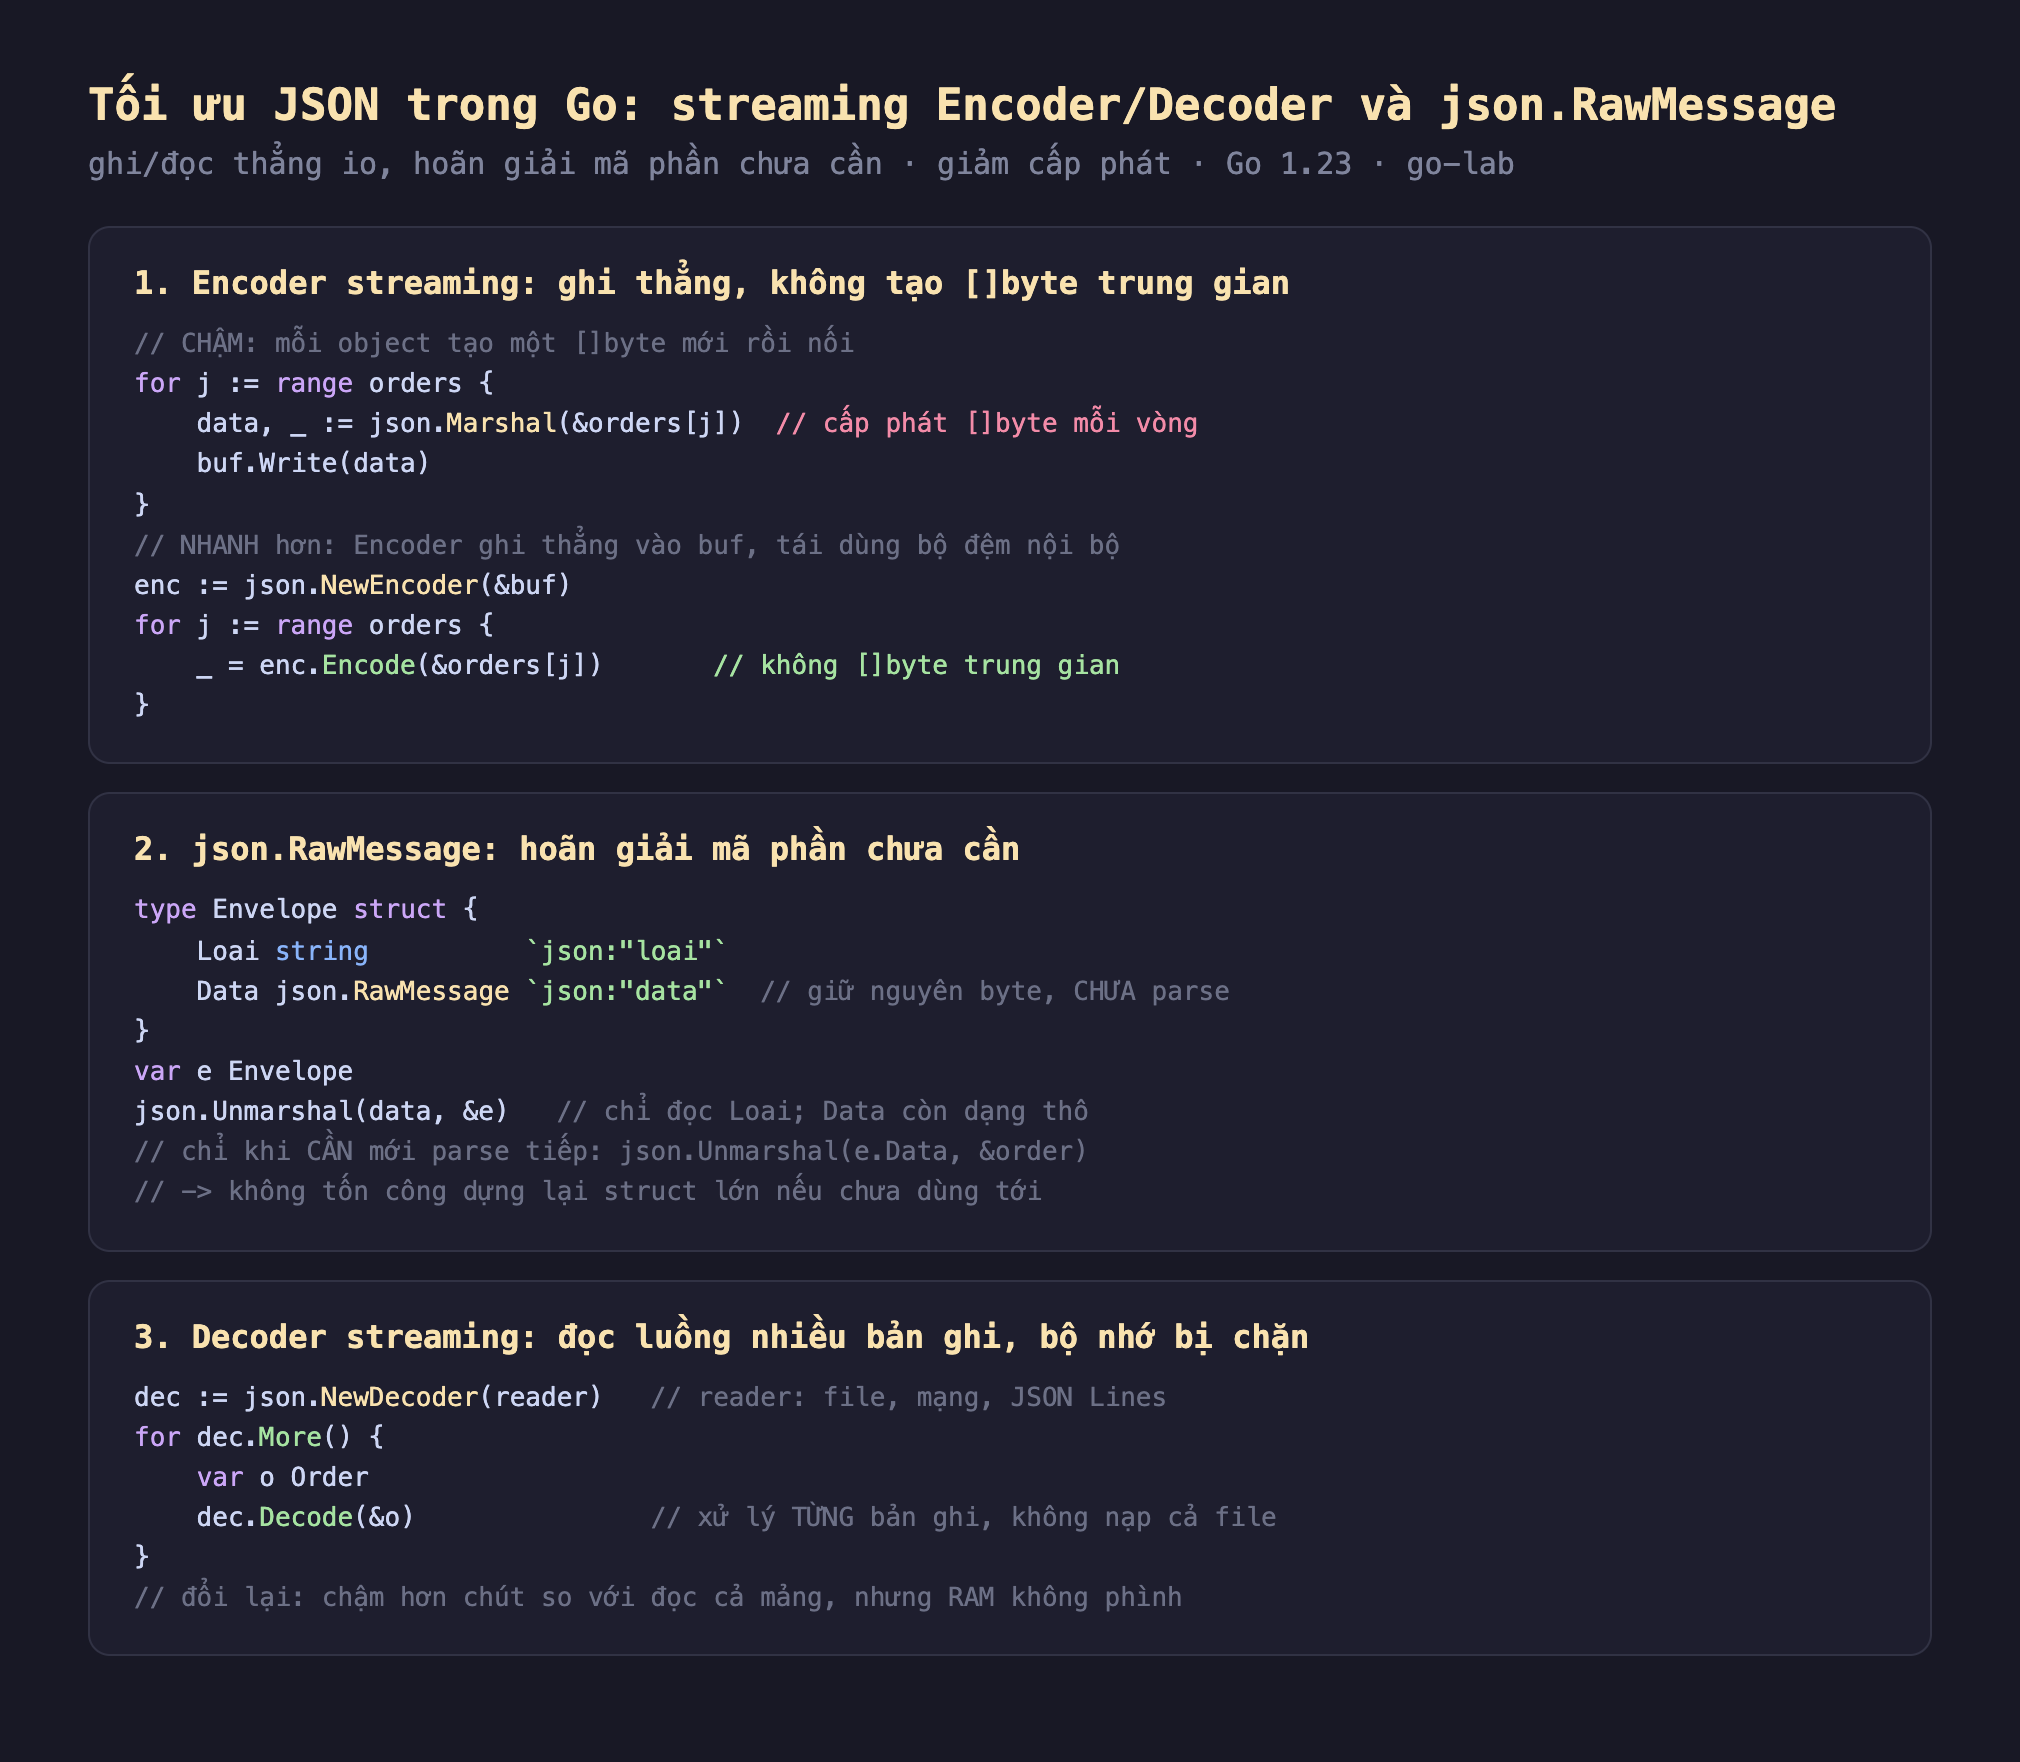
Hình 1: Ba kỹ thuật — json.Encoder ghi thẳng io tránh []byte trung gian; json.RawMessage giữ phần chưa cần dạng byte thô; json.Decoder đọc từng bản ghi từ luồng để bộ nhớ không phình.
Đo thật: benchmark trước và sau
Mình benchmark cả ba trong go-lab bằng go test -bench -benchmem:
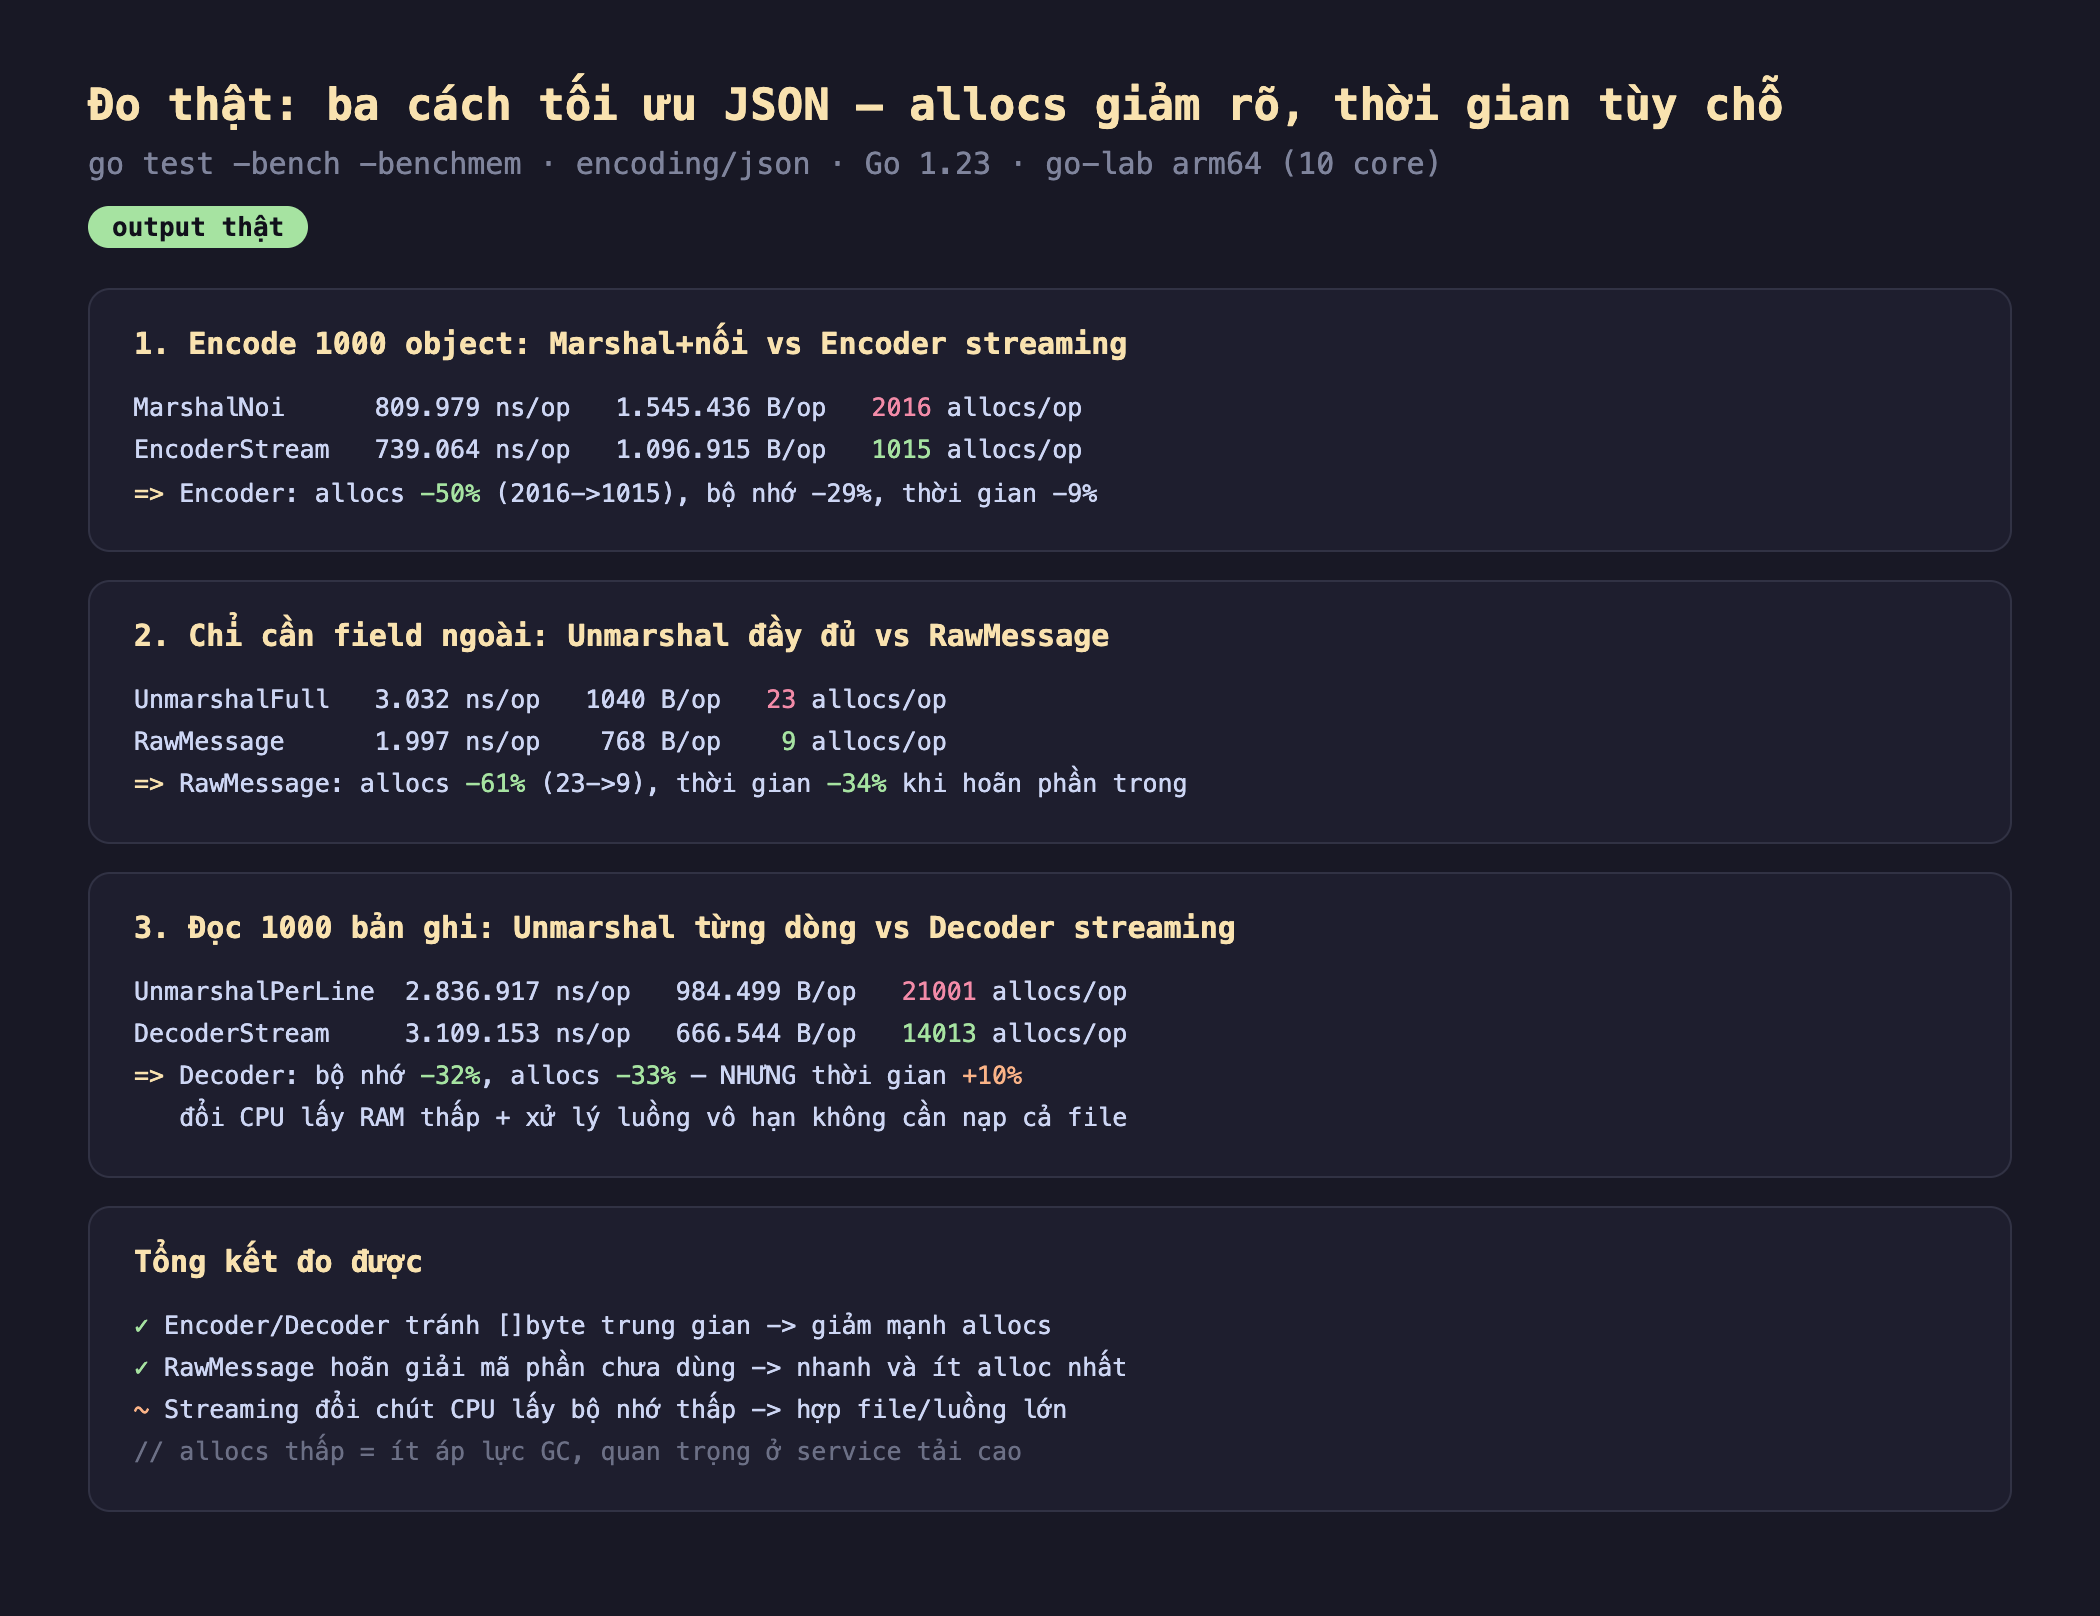
Hình 2: Chạy thật — Encoder streaming cắt allocs 50% (2016→1015) và bộ nhớ 29% khi ghi 1000 object; RawMessage giảm allocs 61% (23→9) và thời gian 34% khi chỉ cần field ngoài; Decoder streaming giảm bộ nhớ 32% và allocs 33% nhưng tốn thêm ~10% thời gian.
Đọc kết quả đo được:
- Encoder streaming cắt một nửa số lần cấp phát: ghi 1000 object,
Marshal+nối tốn 2016 allocs và 1,55 MB;Encoder.Encodechỉ 1015 allocs và 1,10 MB — giảm 50% allocs, 29% bộ nhớ, và còn nhanh hơn 9%. Lý do: mỗiMarshaltạo một[]bytemới; Encoder ghi thẳng và tái dùng bộ đệm. Đây là cải thiện "được cả đôi đường" — vừa ít cấp phát vừa nhanh hơn. - RawMessage thắng lớn nhất khi bạn không cần phần trong: đọc một envelope mà chỉ cần field
loai,Unmarshalđầy đủ tốn 23 allocs / 3.032 ns, còn dùngRawMessagegiữ phầndatathô chỉ tốn 9 allocs / 1.997 ns — giảm 61% allocs và 34% thời gian. Rất hợp cho router/dispatcher: đọc loại thông điệp rồi mới quyết định parse tiếp phần nào. - Decoder streaming là đánh đổi CPU lấy bộ nhớ: đọc 1000 bản ghi,
Unmarshaltừng dòng nhanh hơn về thời gian (2,84 ms vs 3,11 ms) nhưng tốn 21001 allocs / 984 KB;Decoderstreaming tốn 14013 allocs / 666 KB — ít hơn 33% allocs và 32% bộ nhớ, đổi lại chậm hơn ~10%. Đây là báo cáo trung thực: streaming không luôn nhanh hơn; giá trị của nó là bộ nhớ bị chặn và khả năng xử lý luồng lớn/vô hạn (đọc từ mạng, file GB) mà không nạp hết.
Đánh đổi cần cân nhắc
Ít cấp phát quan trọng vì GC, không chỉ vì tốc độ thô. Con số allocs/op không chỉ là chuyện nhanh chậm một lần gọi. Mỗi object cấp phát là thứ GC phải theo dõi và dọn; ở service xử lý hàng chục nghìn request/giây, giảm một nửa allocs nghĩa là giảm đáng kể tần suất và thời gian GC pause — điều mà một benchmark đơn lẻ không phản ánh hết. Đây là lý do allocs/op thường đáng quan tâm hơn ns/op trong code đường nóng.
RawMessage chỉ hoãn, không loại bỏ công việc. Nếu cuối cùng bạn vẫn phải parse phần data, tổng chi phí không giảm — RawMessage chỉ giúp khi có nhánh mà bạn không cần phần trong (định tuyến, lọc, chuyển tiếp nguyên trạng). Dùng nó cho mọi field một cách máy móc chỉ làm code rối mà không lợi.
Streaming đổi lấy sự phức tạp và mất khả năng xử lý ngẫu nhiên. Decoder xử lý tuần tự; bạn không thể nhảy tới bản ghi thứ 500 mà không đọc qua 499 cái trước. Với dữ liệu nhỏ vừa RAM và cần truy cập ngẫu nhiên, Unmarshal cả mảng đơn giản và nhanh hơn. Chỉ chuyển sang streaming khi dữ liệu lớn tới mức bộ nhớ thành vấn đề, hoặc khi nguồn vốn là luồng (mạng, đường ống).
Ba ý mang về
- Encoder/Decoder tránh
[]bytetrung gian, cắt mạnh cấp phát: đo thật ghi 1000 object bằngEncodergiảm 50% allocs (2016→1015) và 29% bộ nhớ so vớiMarshal+nối — mà còn nhanh hơn 9%; dùng khi ghi/đọc nhiều giá trị liên tiếp. - RawMessage hoãn giải mã phần chưa cần: đo thật khi chỉ cần field ngoài,
RawMessagegiảm 61% allocs (23→9) và 34% thời gian so vớiUnmarshalđầy đủ — lý tưởng cho router/dispatcher đọc loại thông điệp rồi mới parse tiếp. - Streaming đổi CPU lấy bộ nhớ, không phải luôn nhanh hơn: đo thật
Decodergiảm 33% allocs và 32% bộ nhớ nhưng tốn thêm ~10% thời gian so vớiUnmarshaltừng dòng — chọn nó cho luồng lớn/vô hạn cần bộ nhớ bị chặn, không phải để tăng tốc thô.
Nguồn
- Go docs — json.Encoder / json.Decoder: https://pkg.go.dev/encoding/json#Encoder
- Go docs — json.RawMessage: https://pkg.go.dev/encoding/json#RawMessage
- Go docs — testing: Benchmarks và ReportAllocs: https://pkg.go.dev/testing#B.ReportAllocs
Phần sau ta rời JSON để mổ xẻ Protobuf wire format: cách nó mã hóa một số nguyên thành varint, field number và wire type ghép vào một byte tag ra sao — xem từng byte thật bằng gói protowire, không cần protoc.
