Bạn tối ưu một truy vấn dashboard, test thấy 25 mili giây, hài lòng đẩy lên production. Rồi giờ cao điểm tới, người dùng than dashboard "quay mãi không xong". Bạn chạy lại đúng truy vấn đó — vẫn 25 mili giây. Vấn đề không nằm ở truy vấn khi chạy một mình, mà ở chuyện gì xảy ra khi hàng chục người cùng chạy nó. Đây là một loại nút thắt chỉ xuất hiện dưới tải đồng thời, và cần cách đo khác. Bài này đo thật sự suy giảm, chẩn đoán, và tìm ra một cách sửa khá bất ngờ.
Đo triệu chứng: cùng query, nhiều mức đồng thời
Chìa khoá là đo dưới tải, không phải đo một lần. Tôi lấy đúng truy vấn dashboard (tổng hợp trên 200 nghìn dòng) và chạy nó bằng pgbench ở số client tăng dần:
pgbench -n -f dashboard.sql -c 1  -T 8   # giờ vắng
pgbench -n -f dashboard.sql -c 8  -T 8
pgbench -n -f dashboard.sql -c 32 -T 8   # giờ cao điểm
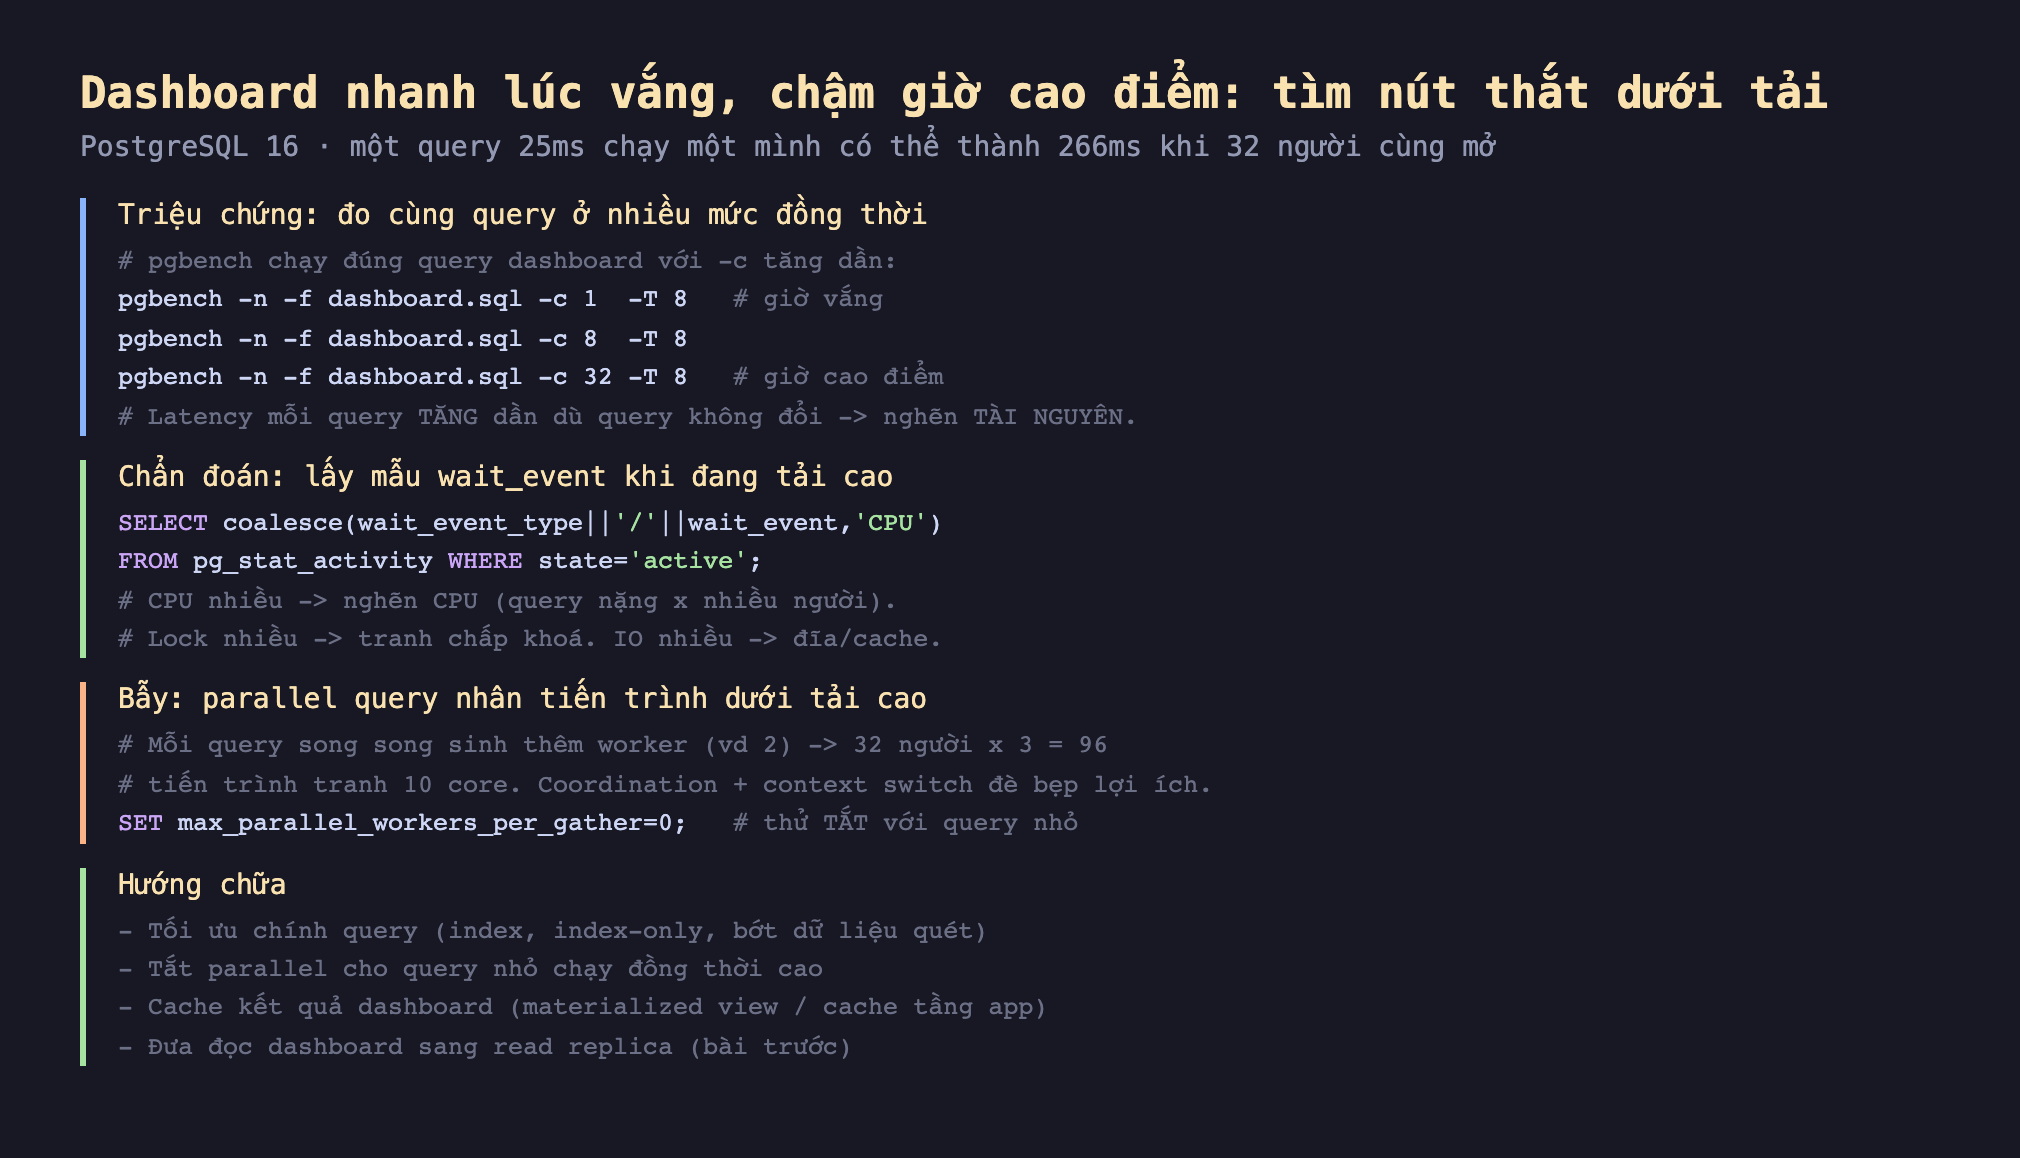
Hình 1: Đo cùng query ở nhiều mức đồng thời để thấy latency tăng dần; chẩn đoán bằng lấy mẫu wait_event; cái bẫy parallel query nhân tiến trình dưới tải cao; và các hướng chữa.
Đo thật: chậm 10 lần ở giờ cao điểm
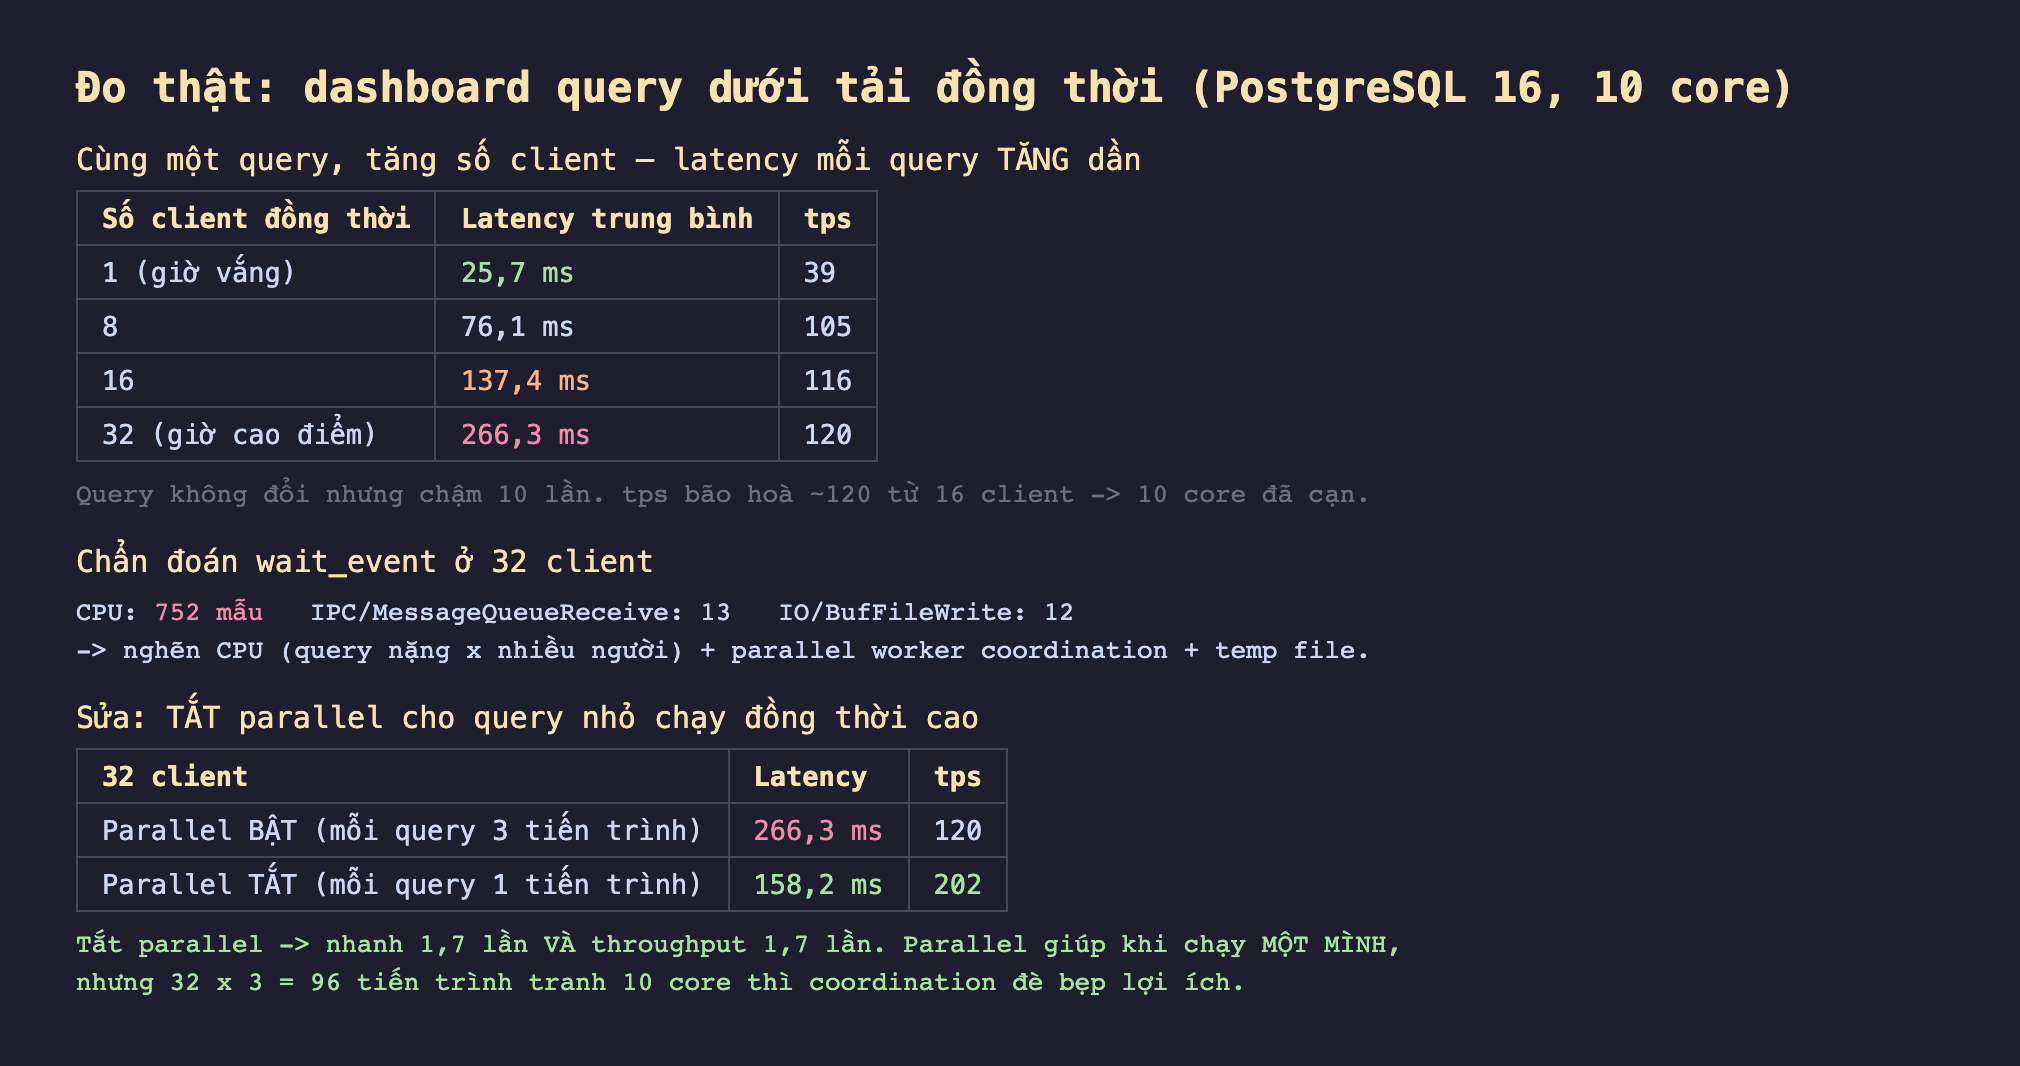
Hình 2: Cùng query — 1 client 25,7 ms, 8 client 76 ms, 16 client 137 ms, 32 client 266,3 ms (chậm 10 lần). tps bão hoà ~120 từ 16 client (10 core cạn). wait_event: CPU-bound. Tắt parallel ở 32 client: 266→158 ms, tps 120→202.
Con số thật (máy 10 core):
- 1 client: 25,7 ms/query.
- 8 client: 76,1 ms.
- 16 client: 137,4 ms.
- 32 client: 266,3 ms — chậm hơn 10 lần so với khi chạy một mình!
Đáng chú ý: throughput (tps) bão hoà quanh 120 từ 16 client trở đi — nghĩa là 10 core đã cạn, thêm client chỉ làm mỗi query xếp hàng lâu hơn chứ tổng công việc không tăng. Đây chính là "nhanh lúc vắng, chậm giờ cao điểm": query không hề đổi, chỉ là tài nguyên bị chia cho nhiều người.
Chẩn đoán: hệ thống đang chờ gì
Lấy mẫu wait_event khi 32 client đang chạy (kỹ thuật ở bài wait events): áp đảo là CPU (752 mẫu) — hệ thống nghẽn CPU, đúng như dự đoán cho một query tính toán nặng nhân với nhiều người. Kèm theo là IPC/MessageQueueReceive (điều phối parallel worker) và IO/BufFileWrite (temp file từ tổng hợp).
Chi tiết IPC/MessageQueueReceive là manh mối cho cách sửa bất ngờ tiếp theo.
Cách sửa bất ngờ: tắt parallel query
max_parallel_workers_per_gather = 2, nghĩa là mỗi query dashboard sinh thêm 2 worker — thành 3 tiến trình mỗi query. Ở 32 client, đó là 32 × 3 = 96 tiến trình tranh nhau 10 core. Chi phí điều phối worker và context switch giữa 96 tiến trình lớn hơn lợi ích của song song hoá. Tôi thử tắt parallel cho query này:
SET max_parallel_workers_per_gather = 0; -- mỗi query chỉ 1 tiến trình
Đo lại ở 32 client: latency 266,3 ms → 158,2 ms (nhanh 1,7 lần), throughput 120 → 202 tps (cũng 1,7 lần). Bất ngờ nhưng hợp lý: parallel query giúp khi chạy một mình (chia việc cho nhiều core rảnh), nhưng dưới tải đồng thời cao khi mọi core đã bận, nó chỉ nhân số tiến trình lên và thêm chi phí điều phối. Với query nhỏ chạy đồng thời cao, một tiến trình mỗi query là tối ưu hơn.
Đánh đổi và các hướng chữa khác
Tắt parallel không phải luôn đúng — chỉ cho query nhỏ dưới tải cao. Một query phân tích lớn chạy đơn lẻ (báo cáo ban đêm) vẫn hưởng lợi từ parallel. Đây là lý do PostgreSQL cho SET ở mức phiên/truy vấn — bạn tắt cho dashboard OLTP đồng thời cao, giữ bật cho báo cáo nặng đơn lẻ. Đừng tắt parallel toàn hệ thống theo phản xạ.
Tối ưu chính query vẫn là gốc. Query dashboard này tính lại tổng hợp trên 200 nghìn dòng mỗi lần load. Cách bền hơn: cache kết quả — MATERIALIZED VIEW làm mới định kỳ, hoặc cache ở tầng ứng dụng. Dashboard thường chấp nhận dữ liệu trễ vài phút, nên tính một lần rồi phục vụ nhiều người rẻ hơn nhiều so với tính lại cho từng người.
Phân tải sang read replica. Như bài read replica đã đo, đưa các truy vấn dashboard (chỉ đọc, chấp nhận trễ) sang replica giải phóng primary và cộng thêm năng lực. Đây là cách xử lý "giờ cao điểm" ở tầng kiến trúc, bổ sung cho việc tối ưu từng query.
Ba ý mang về
- Nút thắt "chậm giờ cao điểm" chỉ lộ ra dưới tải đồng thời — phải đo bằng nhiều client (pgbench -c tăng dần), không phải đo một lần: đo thật một query 25,7 ms (1 client) thành 266,3 ms (32 client), throughput bão hoà ~120 tps khi 10 core cạn.
- Chẩn đoán bằng lấy mẫu wait_event dưới tải: ở đây CPU áp đảo (nghẽn CPU do query nặng × nhiều người) cùng chi phí điều phối parallel worker — chỉ ra cả nút thắt lẫn hướng sửa.
- Cách sửa bất ngờ: tắt parallel query cho query nhỏ chạy đồng thời cao (32×3=96 tiến trình tranh 10 core) cho nhanh 1,7 lần và throughput 1,7 lần — parallel giúp khi chạy một mình nhưng hại dưới tải; kèm các hướng bền hơn là cache kết quả (materialized view) và phân tải sang read replica.
Phần sau ta xử một tình huống vận hành khó nhất: Phần sau thực hiện một migration lớn trên bảng đang chạy mà không gây downtime — thêm cột, thêm index, đổi kiểu dữ liệu một cách an toàn trên hệ thống production đang phục vụ.
