Suốt mười một phần, ta đã đi từ entropy — bức tường lý thuyết — qua từng thuật toán (RLE, Huffman, LZ77, DEFLATE), các công cụ (gzip, bzip2, xz, zstd), và cách dùng (mức nén, từ điển, HTTP, Go). Bài cuối này (phần 12 loạt Nén) gom tất cả thành thứ bạn thực sự cần khi ngồi trước một quyết định: chọn cái gì? Câu trả lời ngắn gọn là điều đã lặp đi lặp lại cả loạt — không có "cái tốt nhất", chỉ có "tốt nhất cho ràng buộc của bạn". Nhưng để câu đó có ích, ta cần một khung rõ ràng: bốn tiêu chí để cân, và một cây quyết định để chọn nhanh. Và mình chốt lại bằng một bảng đo thật cuối cùng cho thấy vì sao mỗi công cụ tồn tại.
Bốn tiêu chí, không tối đa cùng lúc
Mọi quyết định nén xoay quanh bốn tiêu chí, và chúng đánh đổi lẫn nhau — không thể tối đa cả bốn:
- Tỉ lệ nén — nhỏ hơn bao nhiêu lần. Quan trọng khi tiết kiệm đĩa/băng thông là ưu tiên.
- Tốc độ nén — nén nhanh không. Quan trọng khi bạn nén nhiều hoặc realtime.
- Tốc độ giải nén — giải nhanh không. Quan trọng khi dữ liệu được đọc nhiều lần.
- Bộ nhớ và tính tương thích — RAM cần bao nhiêu, ai đọc được. Quan trọng khi tài nguyên hạn chế hoặc cần phổ biến.
Quy luật chung xuyên suốt loạt: nén chặt hơn thường chậm hơn (phần 6, 7). Nên chọn nghĩa là quyết định tiêu chí nào quan trọng nhất với bạn, rồi chấp nhận đánh đổi các tiêu chí kia.
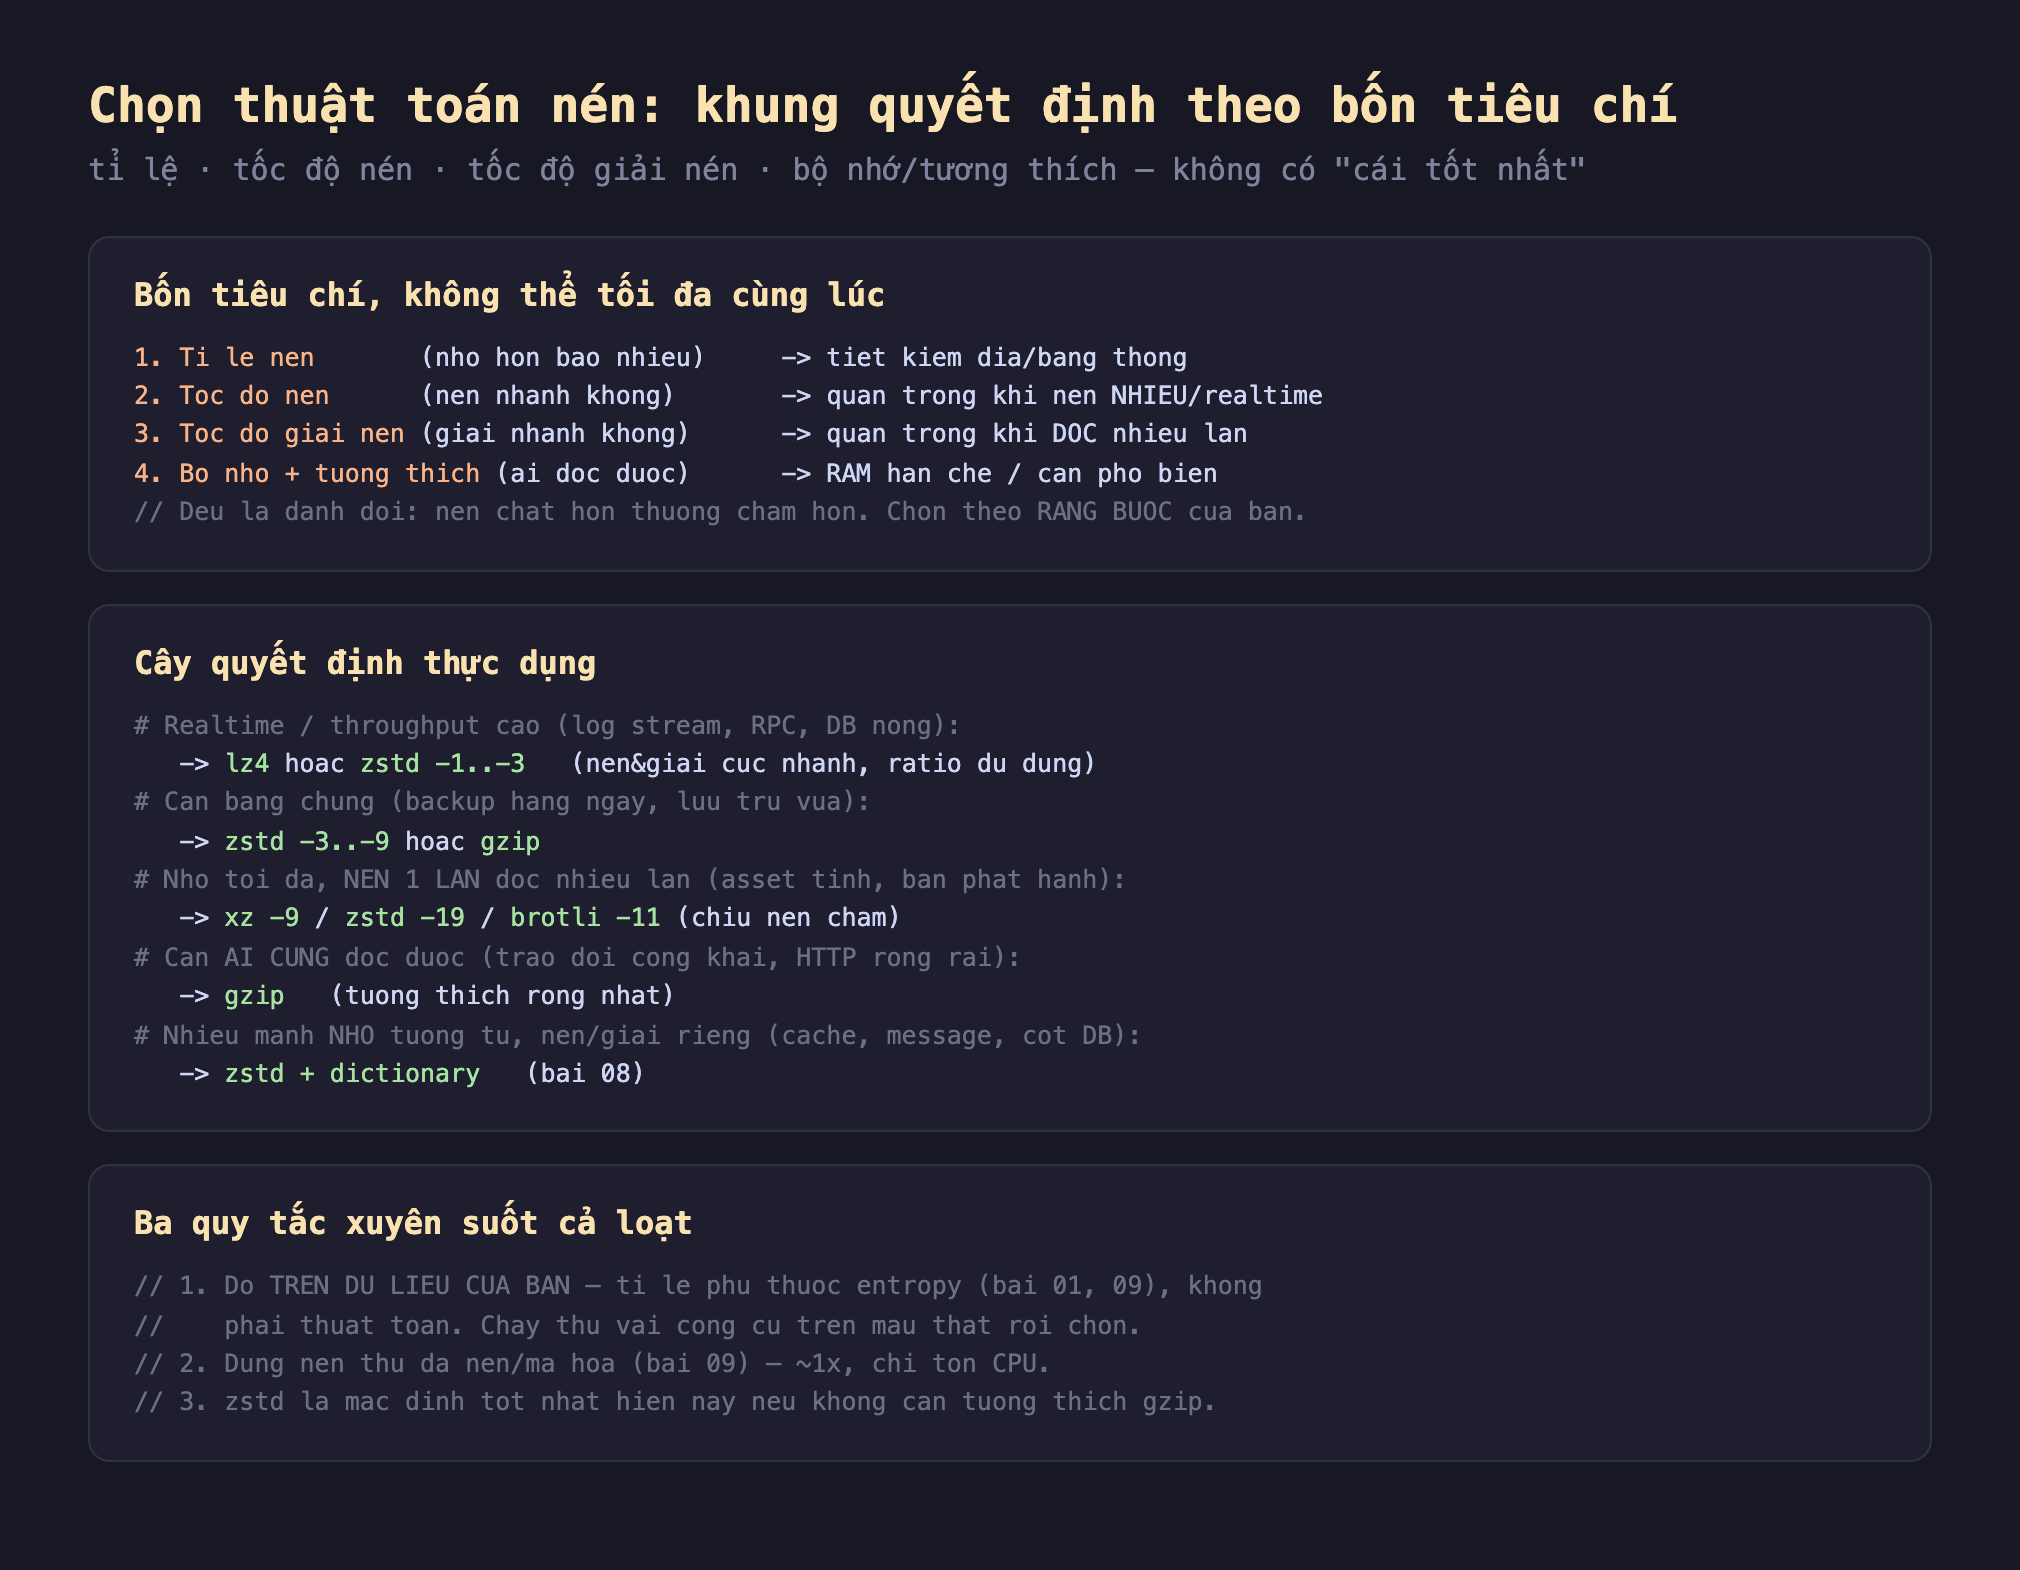
Hình 1: Bốn tiêu chí (tỉ lệ, tốc độ nén, tốc độ giải nén, bộ nhớ/tương thích) đánh đổi lẫn nhau; cây quyết định thực dụng chọn công cụ theo ràng buộc; và ba quy tắc xuyên suốt: đo trên dữ liệu của bạn, đừng nén thứ đã nén, zstd là mặc định tốt nhất hiện nay.
Cây quyết định thực dụng
Từ những gì đã đo cả loạt, đây là cách chọn nhanh theo ràng buộc chính:
- Realtime / throughput cao (log stream, RPC, database nóng) → lz4 hoặc zstd -1..-3: nén và giải cực nhanh, tỉ lệ đủ dùng.
- Cân bằng chung (backup hằng ngày, lưu trữ vừa) → zstd -3..-9 hoặc gzip.
- Nhỏ tối đa, nén một lần đọc nhiều lần (asset tĩnh, bản phát hành) → xz -9 / zstd -19 / brotli -11: chịu nén chậm để đổi kích thước nhỏ nhất.
- Cần ai cũng đọc được (trao đổi công khai, HTTP rộng rãi) → gzip: tương thích rộng nhất.
- Nhiều mảnh nhỏ tương tự, nén/giải riêng (cache, message queue, cột DB) → zstd + dictionary (phần 8).
Đo thật chốt loạt: mỗi công cụ vô địch một cột
Để thấy vì sao cả năm công cụ đều tồn tại, mình nén cùng một file 22MB bằng lz4, zstd (hai mức), gzip, xz — đo đủ tỉ lệ, tốc độ nén và tốc độ giải nén:
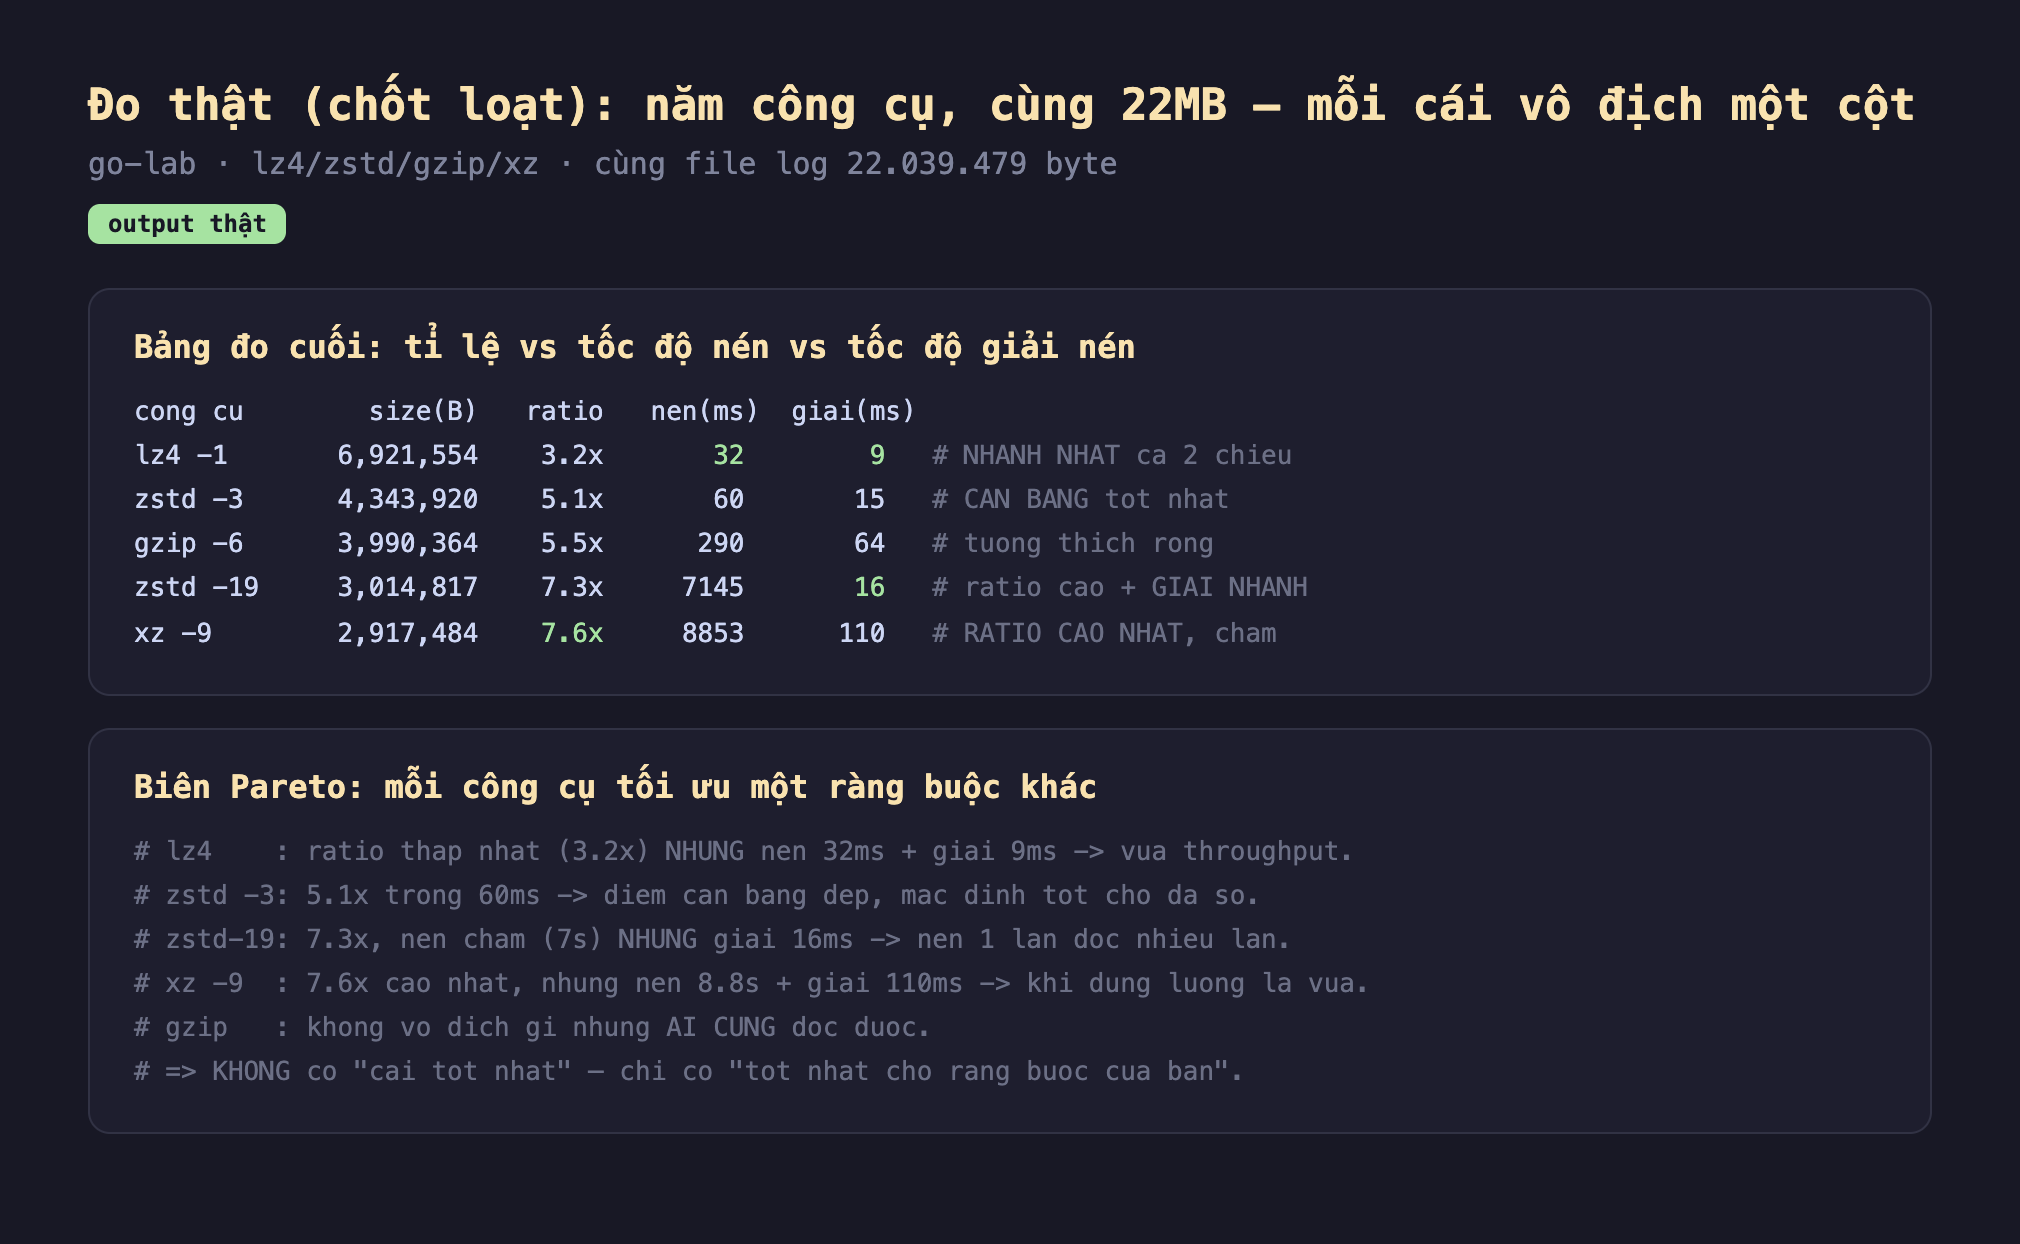
Hình 2: Chạy thật trên 22.039.479 byte — lz4 -1 3.2x nhưng nén 32ms/giải 9ms (nhanh nhất); zstd -3 5.1x/60ms (cân bằng); gzip -6 5.5x/290ms (tương thích); zstd -19 7.3x nén chậm 7s nhưng giải 16ms; xz -9 7.6x (chặt nhất) nhưng nén 8.8s/giải 110ms.
- lz4 — vua tốc độ, đáy tỉ lệ: nén cả 22MB trong 32ms, giải trong 9ms — nhanh nhất cả hai chiều, nhưng tỉ lệ chỉ 3.2x (thấp nhất). Đây là công cụ khi bạn cần nén "gần như miễn phí" trên đường nóng (database WAL, log stream) và tỉ lệ vừa đủ là được.
- zstd -3 — điểm cân bằng đẹp: 5.1x trong 60ms. Nhanh gần lz4 nhưng nén tốt hơn hẳn. Đây là lý do zstd là mặc định tốt nhất hiện nay cho đa số nhu cầu.
- gzip -6 — tương thích là giá trị: 5.5x nhưng nén chậm hơn zstd (290ms) và giải chậm hơn (64ms). Nó không thắng tiêu chí hiệu năng nào, nhưng ai cũng đọc được — giá trị của gzip nằm ở tính phổ biến.
- zstd -19 — nhỏ mà vẫn giải nhanh: 7.3x, nén chậm (7.1 giây) nhưng giải chỉ 16ms — nhanh ngang zstd -3. Tính chất vàng cho "nén một lần đọc nhiều lần" (phần 6): trả chi phí nén một lần, mọi lượt đọc sau siêu nhanh.
- xz -9 — chặt nhất, chậm nhất: 7.6x (nhỏ nhất) nhưng nén 8.8 giây và giải 110ms. Chỉ đáng khi từng byte dung lượng quan trọng hơn thời gian (gói phát hành, lưu trữ dài hạn).
Năm công cụ, năm điểm khác nhau trên biên Pareto — không cái nào "tốt nhất", mỗi cái tối ưu một ràng buộc. Đúng là bức tranh cả loạt bài đã vẽ.
Tổng kết loạt "Nén dữ liệu: đo thật" (12 phần)
Loạt bài đã đi trọn từ lý thuyết tới thực chiến:
- Phần 1-4 — nền tảng: entropy (bức tường lý thuyết); RLE (thắng run dài, thua text); Huffman (mã tần suất, tiến sát entropy); LZ77 (loại lặp bằng tham chiếu ngược).
- Phần 5 — ghép lại: DEFLATE = LZ77 + Huffman, mổ header gzip/zlib.
- Phần 6-9 — thực tế và đánh đổi: mức nén (lợi ích giảm dần); so gzip/bzip2/xz/zstd; từ điển zstd cho mẩu nhỏ; nén phụ thuộc dữ liệu (entropy quyết định).
- Phần 10-12 — ứng dụng: nén trong HTTP (Content-Encoding); nén trong Go (streaming); và chọn thuật toán.
Sợi chỉ xuyên suốt, gói trong ba câu: (1) Tỉ lệ nén là thuộc tính của dữ liệu (entropy), không phải thuật toán — đo trên dữ liệu của bạn. (2) Đừng nén thứ đã nén hoặc mã hóa. (3) zstd là mặc định tốt nhất năm nay nếu không cần tương thích gzip. Nén không phải phép thuật — nó là loại bỏ dư thừa trong giới hạn entropy, và biết chọn đúng công cụ cho đúng ràng buộc là kỹ năng phân biệt hệ thống tiết kiệm với hệ thống lãng phí. Cảm ơn bạn đã theo trọn loạt bài, và chúc bạn luôn nén đúng chỗ, đúng cách.
Ba ý mang về
- Không có thuật toán nén tốt nhất — chỉ tốt nhất cho ràng buộc: đo thật trên 22MB, lz4 nhanh nhất (32ms/9ms) nhưng 3.2x, xz chặt nhất (7.6x) nhưng chậm nhất, zstd -19 vừa nhỏ (7.3x) vừa giải nhanh (16ms) — mỗi cái vô địch một tiêu chí trên biên Pareto.
- Chọn theo cây quyết định bốn tiêu chí: realtime → lz4/zstd thấp; cân bằng → zstd/gzip; nhỏ tối đa (nén 1 lần đọc nhiều) → xz/zstd-19/brotli; tương thích rộng → gzip; nhiều mẩu nhỏ → zstd+dictionary.
- Ba quy tắc xuyên suốt loạt: tỉ lệ nén do entropy của dữ liệu quyết định (đo trên dữ liệu của bạn, không chép con số người khác); đừng nén thứ đã nén/mã hóa (~1x, tốn CPU); zstd là mặc định tốt nhất hiện nay khi không cần tương thích gzip.
Nguồn
- Facebook — zstd benchmarks (Pareto frontier): https://github.com/facebook/zstd#benchmarks
- lz4 — Extremely Fast Compression: https://github.com/lz4/lz4
- Squash Compression Benchmark — so sánh nhiều codec: https://quixdb.github.io/squash-benchmark/
