Mười một phần qua, ta đã đi từ "vì sao cần hàng đợi" tới schema evolution — mỗi bài một demo chạy thật trên Kafka, PostgreSQL hoặc Redis, mỗi kết luận một con số đo được. Nhưng message queue không phải mười một kỹ thuật rời rạc; chúng là các mảnh của một bức tranh, và sức mạnh thật đến khi chúng làm việc cùng nhau. Bài cuối này (phần 12, khép lại loạt Message Queue & Event-Driven) làm đúng điều đó: chạy một pipeline hoàn chỉnh ghép nhiều pattern, rồi đúc kết toàn bộ bài học thành một bảng số liệu thật và một khung quyết định thực chiến.
Các pattern không đứng riêng — chúng ghép lại
Nhớ lại mạch của loạt bài: nó không ngẫu nhiên mà là một chuỗi hệ quả. Queue cho ta tách rời (bài 1), nhưng tách rời sinh ra vấn đề ngữ nghĩa giao nhận (bài 2); at-least-once là mặc định, nhưng nó đảm bảo có message trùng → cần idempotency (bài 4); scale bằng consumer group (bài 3) kéo theo mất thứ tự → cần key (bài 8); ghi DB rồi publish không nguyên tử → outbox (bài 5); message độc chặn hàng đợi → DLQ (bài 6); và để biết hệ có khoẻ, theo dõi lag (bài 7). Event sourcing (bài 9), saga (bài 10), schema evolution (bài 11) là các kiến trúc nâng cao xây trên nền đó.
Để thấy chúng ghép lại, mình chạy một pipeline nhỏ kết hợp bốn pattern cùng lúc:
Producer ──► [Kafka topic 3 partition, key=user] ──► Consumer idempotent
  (bài 1)      (bài 8: key giữ thứ tự mỗi user)     (bài 2 at-least-once
                                                      + bài 4 dedup Redis)
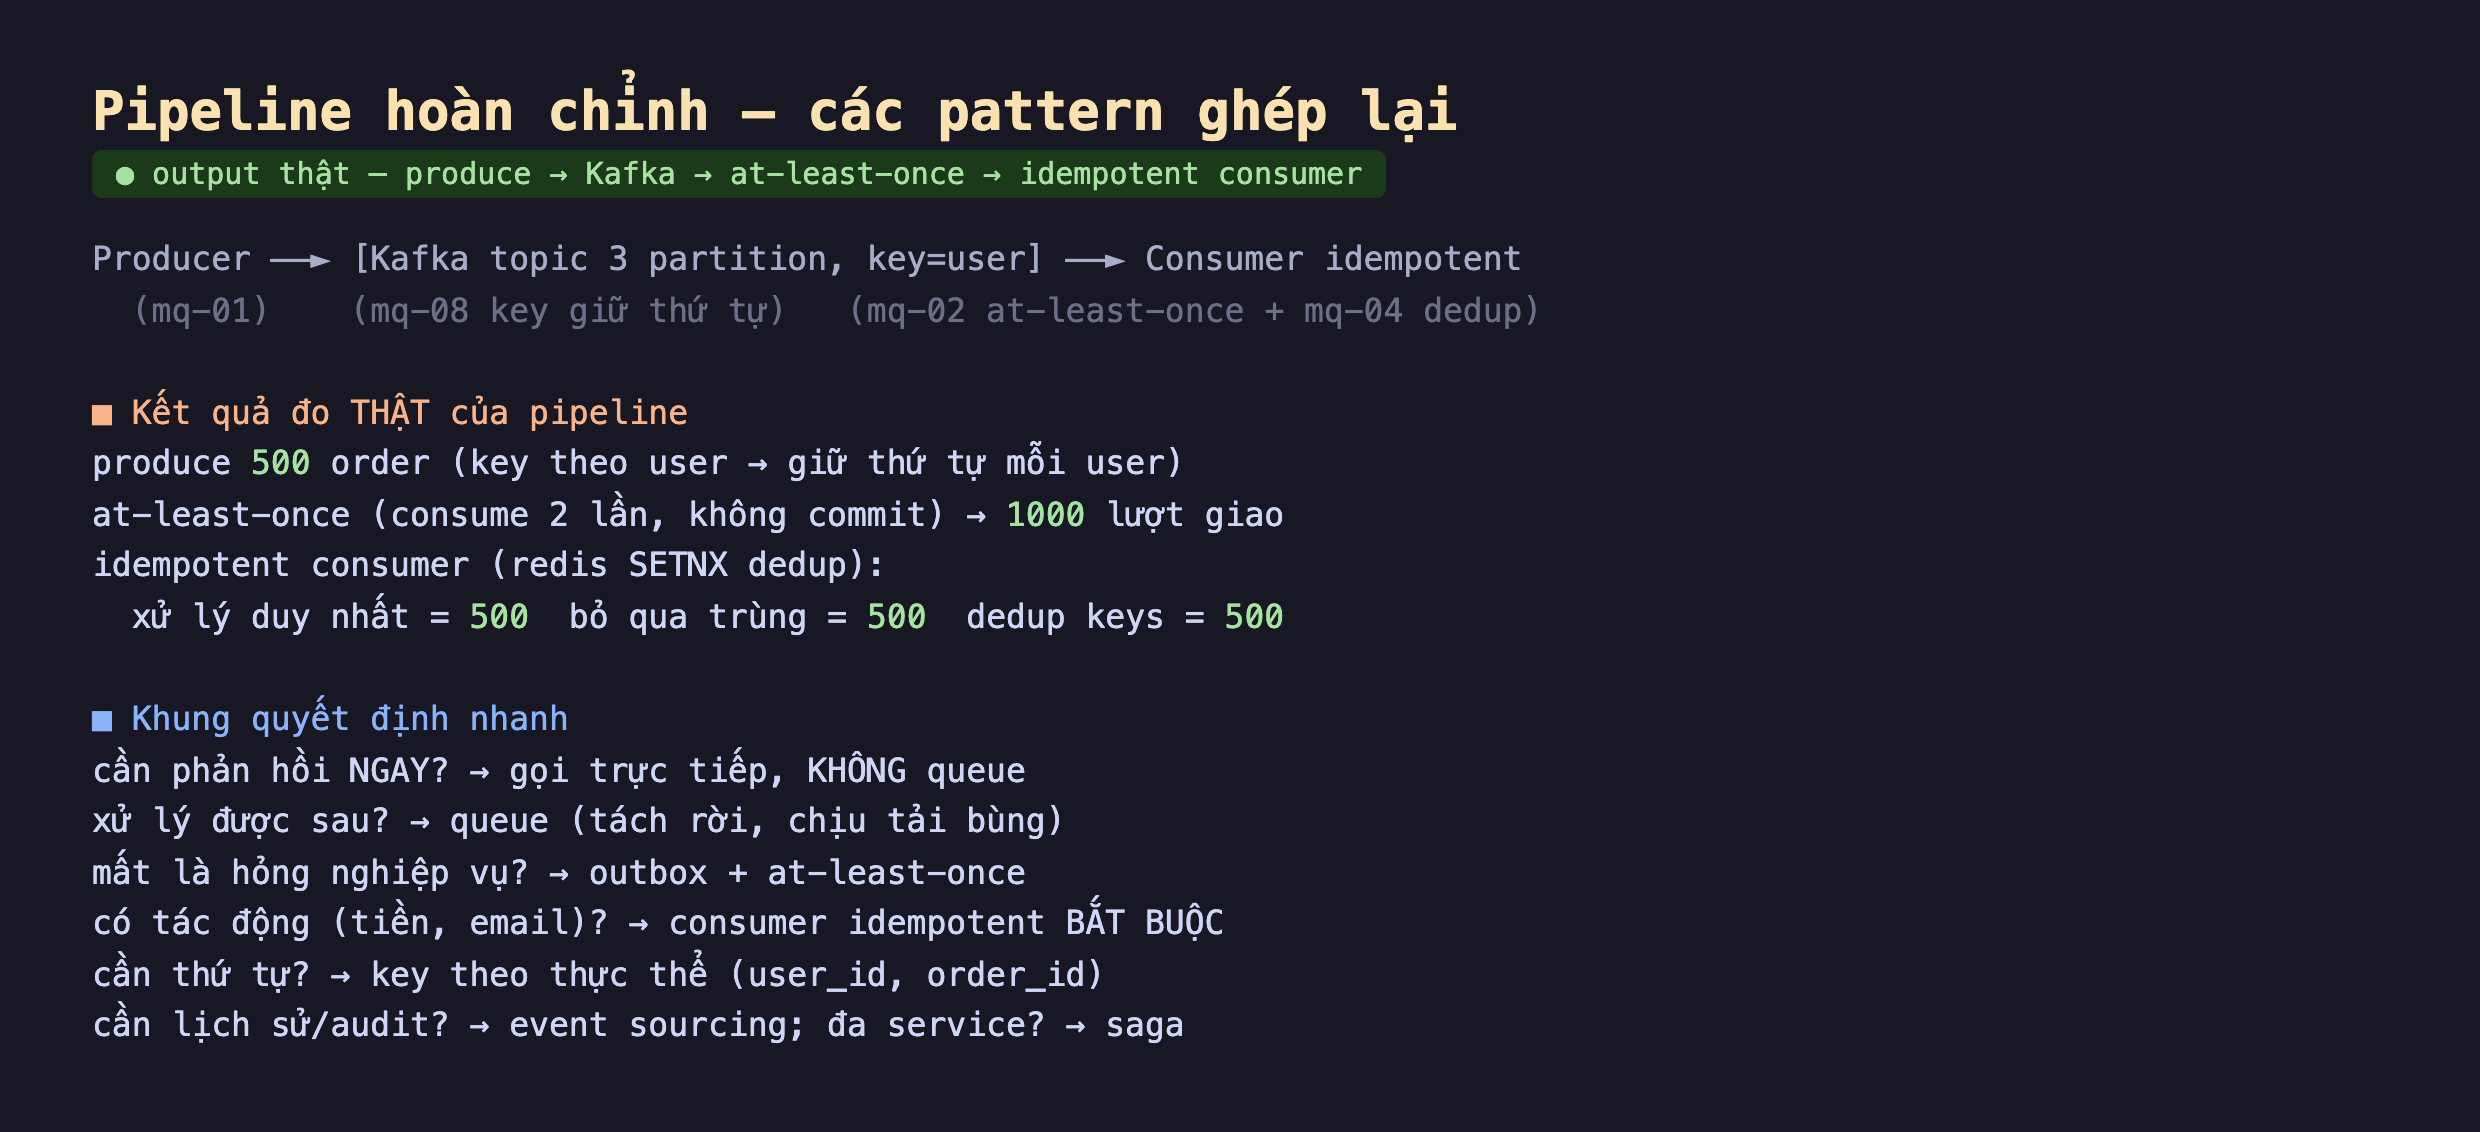
Hình 1: Pipeline hoàn chỉnh ghép bốn pattern. Kết quả đo thật: produce 500 order (key theo user để giữ thứ tự mỗi user), at-least-once giao 1000 lượt (consume 2 lần không commit), consumer idempotent dùng Redis SETNX xử lý đúng 500 order duy nhất và bỏ qua 500 lượt trùng. Bên dưới là khung quyết định nhanh.
Kết quả pipeline nói lên tất cả: 500 order vào, 1000 lượt giao ra (vì at-least-once), nhưng đúng 500 được xử lý nhờ idempotency — trong khi key đảm bảo thứ tự event của mỗi user được giữ. Bốn pattern phối hợp cho một hệ vừa scale được, vừa không mất, vừa không trùng, vừa đúng thứ tự. Không pattern nào một mình làm được điều đó.
Toàn bộ loạt bài: những con số đo thật
Điều mình tự hào nhất ở loạt này là không con số nào bịa — mỗi kết luận đến từ một lần chạy thật trong container:
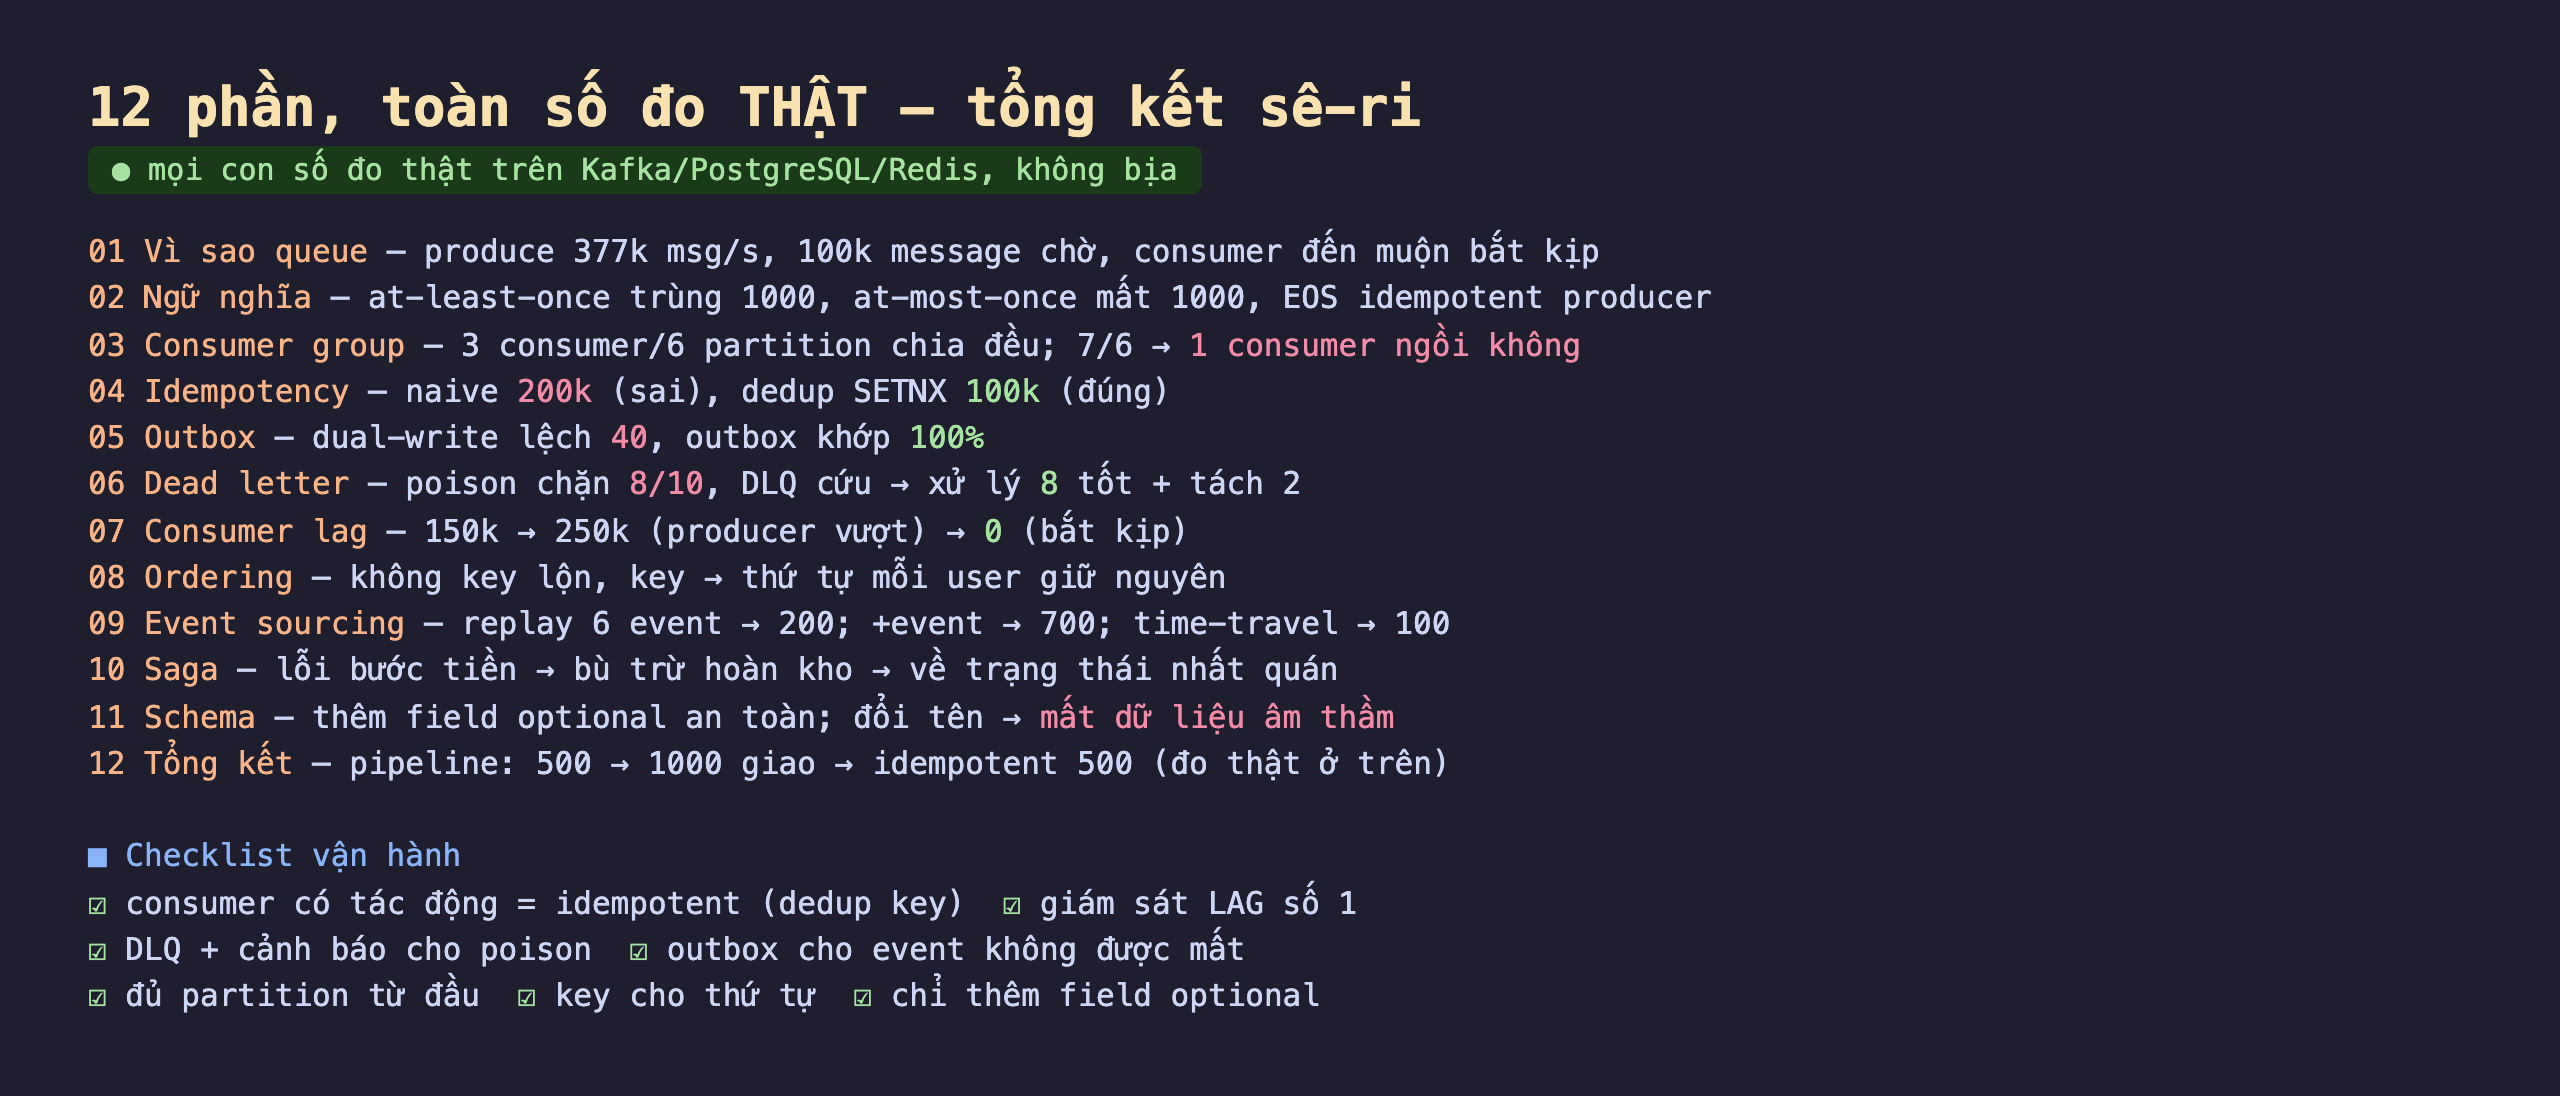
Hình 2: Tổng kết 12 phần — mọi con số đo thật trên Kafka/PostgreSQL/Redis. Từ throughput produce (377k msg/s), mất/trùng theo ngữ nghĩa (1000), trần partition (7→1 ngồi không), idempotency (200k→100k), outbox (lệch 40→khớp), DLQ (chặn 8→cứu), lag (150k→250k→0), tới event sourcing/saga/schema. Bên dưới là checklist vận hành.
Khung quyết định: dùng pattern nào khi nào
Gộp mọi bài học thành một cây quyết định thực dụng:
- Cần phản hồi ngay không? Nếu nghiệp vụ cần kết quả tức thì (kiểm tra số dư trước khi rút) → gọi trực tiếp đồng bộ, đừng dùng queue (bài 1). Queue chỉ cho việc xử lý được sau.
- Message mất có hỏng nghiệp vụ không? Nếu có (đơn hàng, thanh toán) → at-least-once + outbox để không mất (bài 2, 5). Nếu không (log, metric) → có thể chấp nhận at-most-once đơn giản hơn.
- Consumer có tác động thật không? Nếu xử lý message gây hiệu ứng (trừ tiền, gửi email, ghi DB) → idempotency là bắt buộc, không phải tuỳ chọn (bài 4) — vì at-least-once chắc chắn giao trùng.
- Có cần thứ tự không? Nếu có → key theo thực thể (user_id, order_id) để giữ thứ tự mỗi thực thể mà vẫn scale (bài 8). Chọn đủ partition từ đầu (bài 3).
- Cần lịch sử/audit không? Nếu có → cân nhắc event sourcing (bài 9). Giao dịch trải nhiều service? → saga với bù trừ (bài 10).
- Luôn luôn: theo dõi lag làm tín hiệu sức khoẻ số một (bài 7), có DLQ + cảnh báo cho message độc (bài 6), và chỉ thêm field optional khi tiến hoá schema (bài 11).
Đánh đổi cần cân nhắc
Message queue không miễn phí — nó dời phức tạp, không xoá. Queue giải quyết tách rời và chịu tải, nhưng đổi lại bạn nhận một loạt vấn đề mới mà loạt bài này dành 11 phần để xử lý: trùng, mất, thứ tự, lag, poison, dual-write. Một lời gọi hàm đồng bộ không có những vấn đề đó. Đừng thêm queue vì "nghe hiện đại" — thêm khi lợi ích (tách rời, chịu bùng tải, nhiều consumer độc lập) vượt chi phí phức tạp này. Với hệ nhỏ, gọi trực tiếp thường đúng hơn.
Hầu hết hệ chỉ cần at-least-once + idempotency, không cần phần còn lại. Trong 11 pattern, hai cái nền tảng — at-least-once và consumer idempotent — đã đủ cho phần lớn hệ thống. Event sourcing, saga, CQRS là công cụ mạnh nhưng đắt về phức tạp; nhiều team dùng chúng quá sớm cho bài toán chưa cần, rồi trả giá. Bắt đầu đơn giản (queue + idempotency + DLQ + giám sát lag), chỉ thêm pattern nâng cao khi bài toán thật đòi hỏi.
Demo lab không phải production — nhưng cơ chế thì thật. Mọi số liệu trong loạt này đo trên container đơn, quy mô nhỏ (nghìn message, không phải tỉ). Throughput 377k msg/s là trên một broker local không replication; production với replication, nhiều broker, mạng thật sẽ khác. Giá trị của các demo không nằm ở con số tuyệt đối mà ở cơ chế chúng phơi bày: at-least-once có giao trùng, cardinality có nổ, outbox có ngăn lệch. Mang cơ chế vào production, đo lại ở quy mô thật của bạn.
Ba ý mang về
- Các pattern ghép thành một hệ, không đứng riêng: đo thật một pipeline produce 500 order → at-least-once giao 1000 lượt → idempotent consumer xử lý đúng 500, với key giữ thứ tự — bốn pattern (queue, ngữ nghĩa, idempotency, ordering) phối hợp cho hệ vừa scale vừa đúng.
- Khung quyết định bắt đầu từ bản chất nghiệp vụ: cần phản hồi ngay thì đừng queue; mất là hỏng thì outbox + at-least-once; có tác động thì idempotency bắt buộc; cần thứ tự thì key; cần lịch sử thì event sourcing; đa service thì saga — chọn theo yêu cầu, không theo độ hot của pattern.
- Queue dời phức tạp chứ không xoá — dùng đúng liều: hầu hết hệ chỉ cần at-least-once + idempotency + DLQ + giám sát lag; event sourcing/saga/CQRS mạnh nhưng đắt, chỉ thêm khi bài toán thật đòi hỏi; và mang cơ chế đã đo thật vào production rồi đo lại ở quy mô của bạn.
Nguồn
- Martin Kleppmann — Designing Data-Intensive Applications, ch.11 (Stream Processing)
- Chris Richardson — Microservices Patterns (microservices.io): https://microservices.io/patterns/
- Confluent — Kafka design & event-driven architecture: https://www.confluent.io/learn/event-driven-architecture/
- Gregor Hohpe — Enterprise Integration Patterns: https://www.enterpriseintegrationpatterns.com/
