Khi hai service cần nói chuyện, phản xạ đầu tiên là gọi trực tiếp: service A gọi HTTP/gRPC tới service B, chờ kết quả, rồi đi tiếp. Đơn giản, dễ hiểu — và ghép hai service chặt với nhau theo cách gây đau về sau. A bị chặn suốt thời gian B xử lý; nếu B chậm, A chậm theo; nếu B sập, A lỗi theo. Khi hệ lớn lên, kiểu ghép chặt này lan ra thành chuỗi domino: một service chậm kéo sập cả hệ. Hàng đợi tin nhắn (message queue) là lời giải kinh điển — nó tách rời producer khỏi consumer. Bài này (phần 1 loạt Message Queue & Event-Driven) đo thật trên Kafka để thấy chính xác "tách rời" nghĩa là gì bằng con số.
Đồng bộ vs bất đồng bộ: khác biệt ở ai chờ ai
Cốt lõi nằm ở câu hỏi: ai chờ ai, và chờ bao lâu?
- Đồng bộ (gọi trực tiếp): caller gửi request và bị chặn tới khi downstream xử lý xong. Độ trễ của caller = độ trễ xử lý của downstream. Hai service ghép chặt theo thời gian: phải cùng sống, cùng tốc độ. Downstream sập → caller nhận lỗi.
- Bất đồng bộ (qua queue): producer chỉ ghi message vào hàng đợi rồi trả về ngay — nó chỉ chờ broker xác nhận đã nhận (ack), không chờ ai xử lý. Consumer đọc và xử lý độc lập, theo nhịp riêng, thậm chí muộn hơn nhiều. Hai bên tách rời: producer nhanh không bị consumer chậm kéo lại; consumer offline thì message chờ trong hàng đợi, không mất.
# tạo topic 3 partition
kafka-topics.sh --create --topic mq01-demo --partitions 3
# ĐO throughput + độ trễ produce (bất đồng bộ) — không cần consumer nào
kafka-producer-perf-test.sh --num-records 100000 --record-size 200 --throughput -1
# chứng minh message chờ trong topic (0 consumer):
kafka-get-offsets.sh --topic mq01-demo
# consumer đến muộn đọc hết + xem lag:
kafka-consumer-groups.sh --describe --group late2
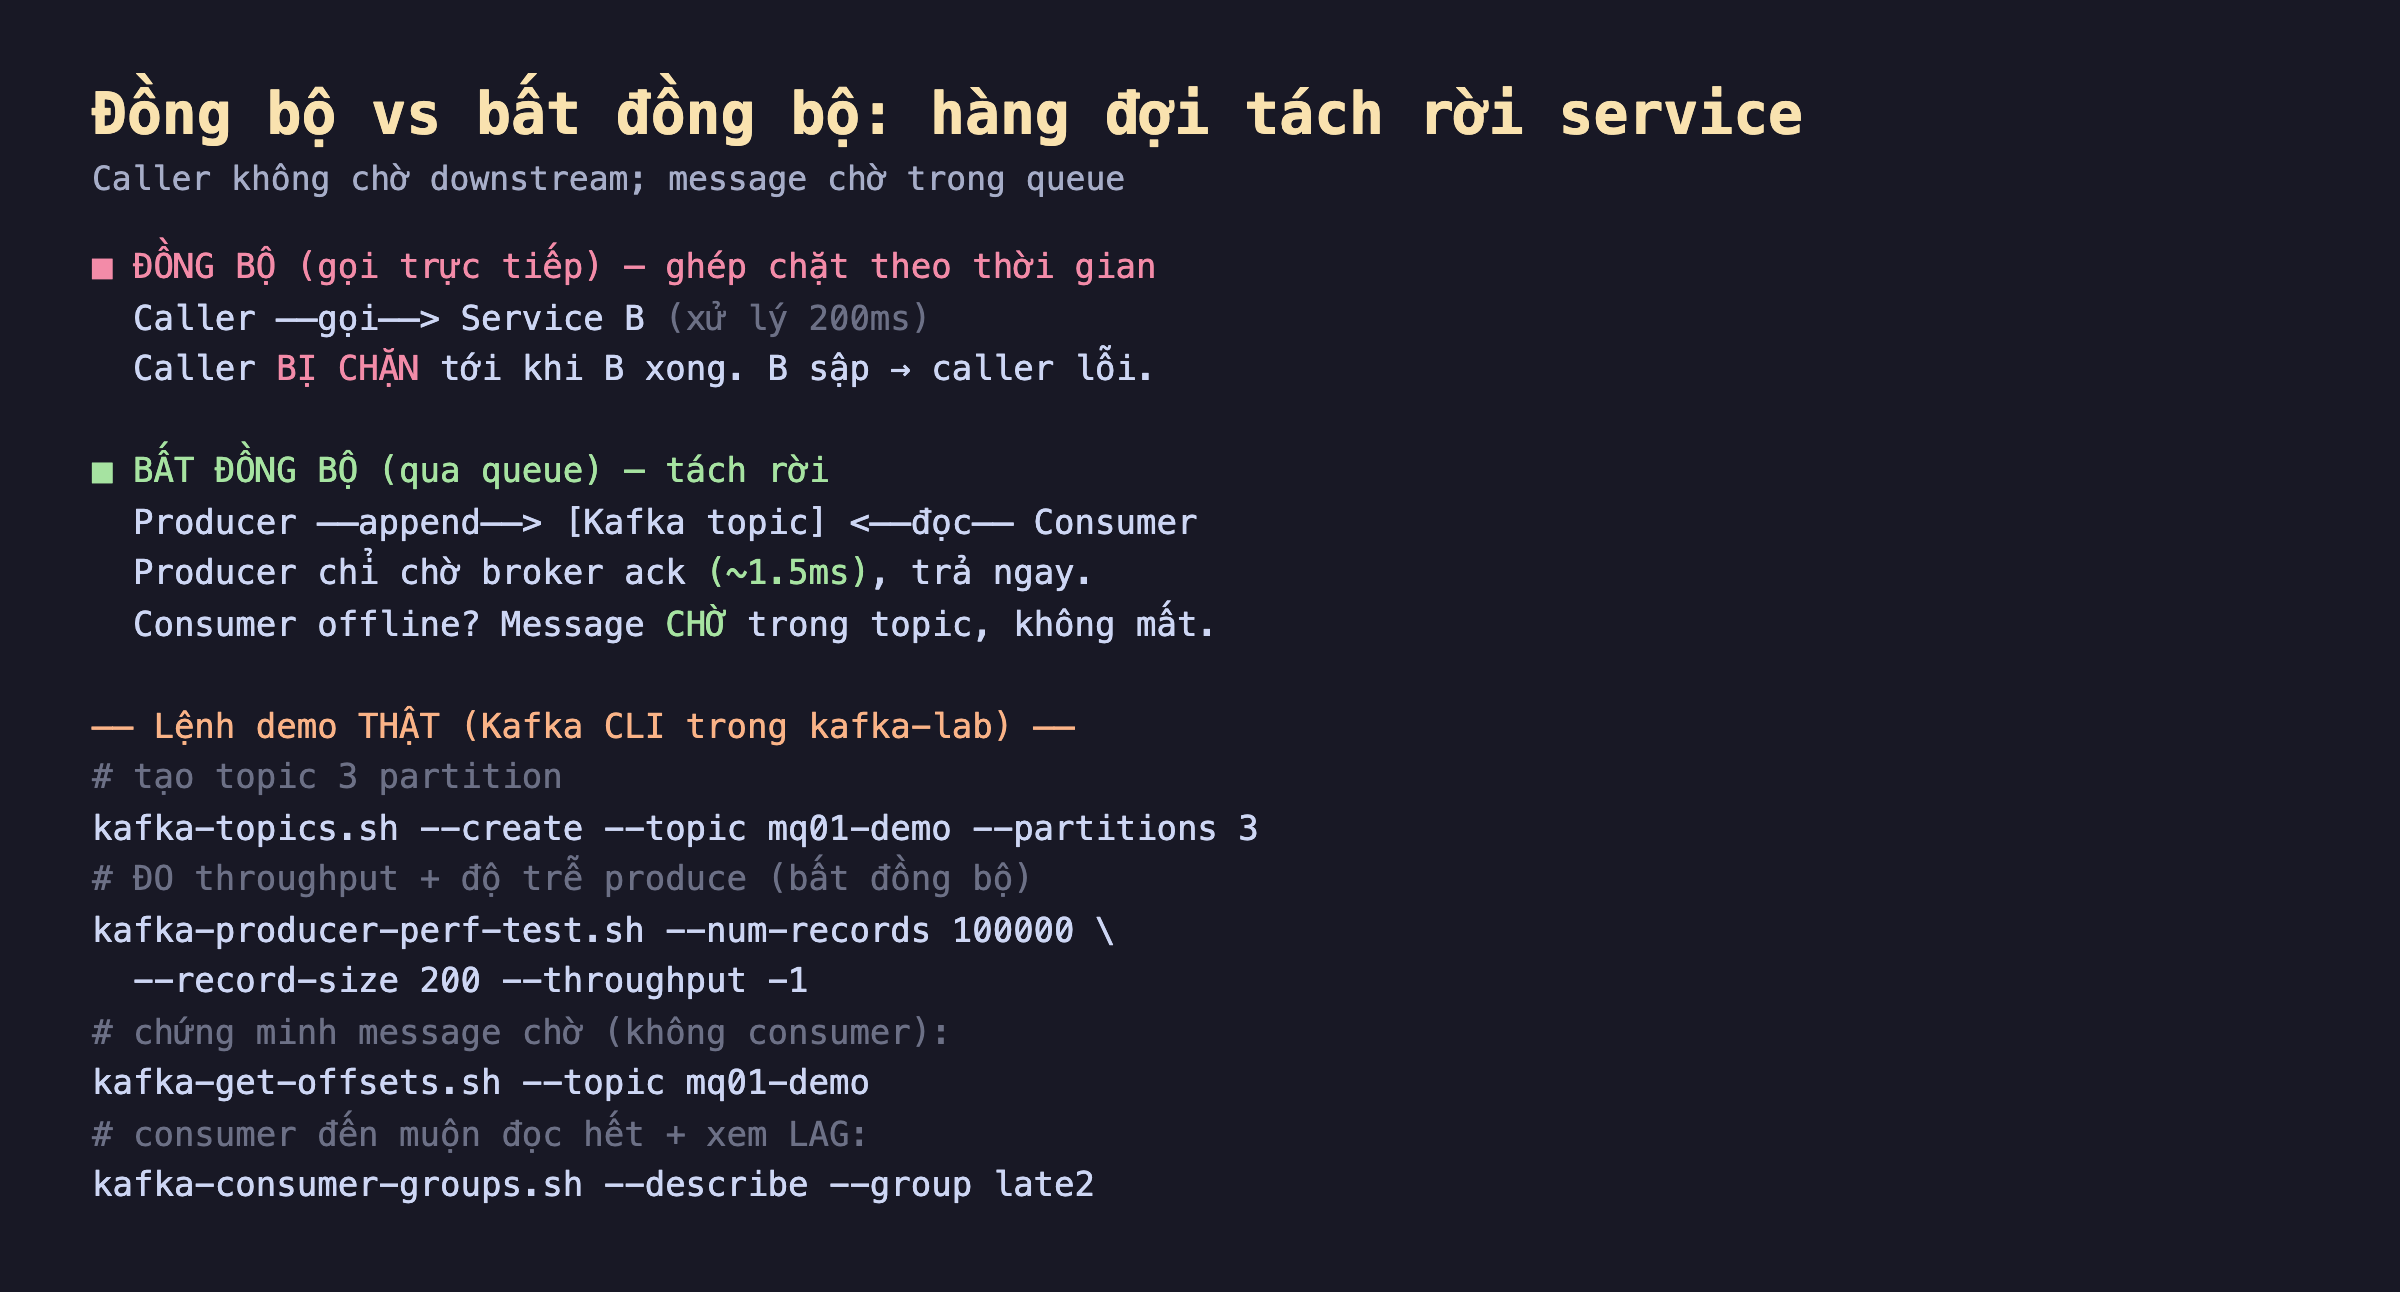
Hình 1: Đồng bộ ghép chặt caller với downstream theo thời gian (bị chặn, sập theo); bất đồng bộ qua queue thì producer chỉ chờ broker ack rồi trả ngay, consumer xử lý độc lập và message chờ an toàn nếu consumer offline. Bên dưới là các lệnh Kafka CLI dùng để đo thật.
Đo thật: producer không chờ ai, message vẫn chờ
Mình chạy trên kafka-lab (Kafka 3.7 KRaft). Dùng chính công cụ perf-test của Kafka để lấy số thật, theo ba bước minh hoạ tách rời:
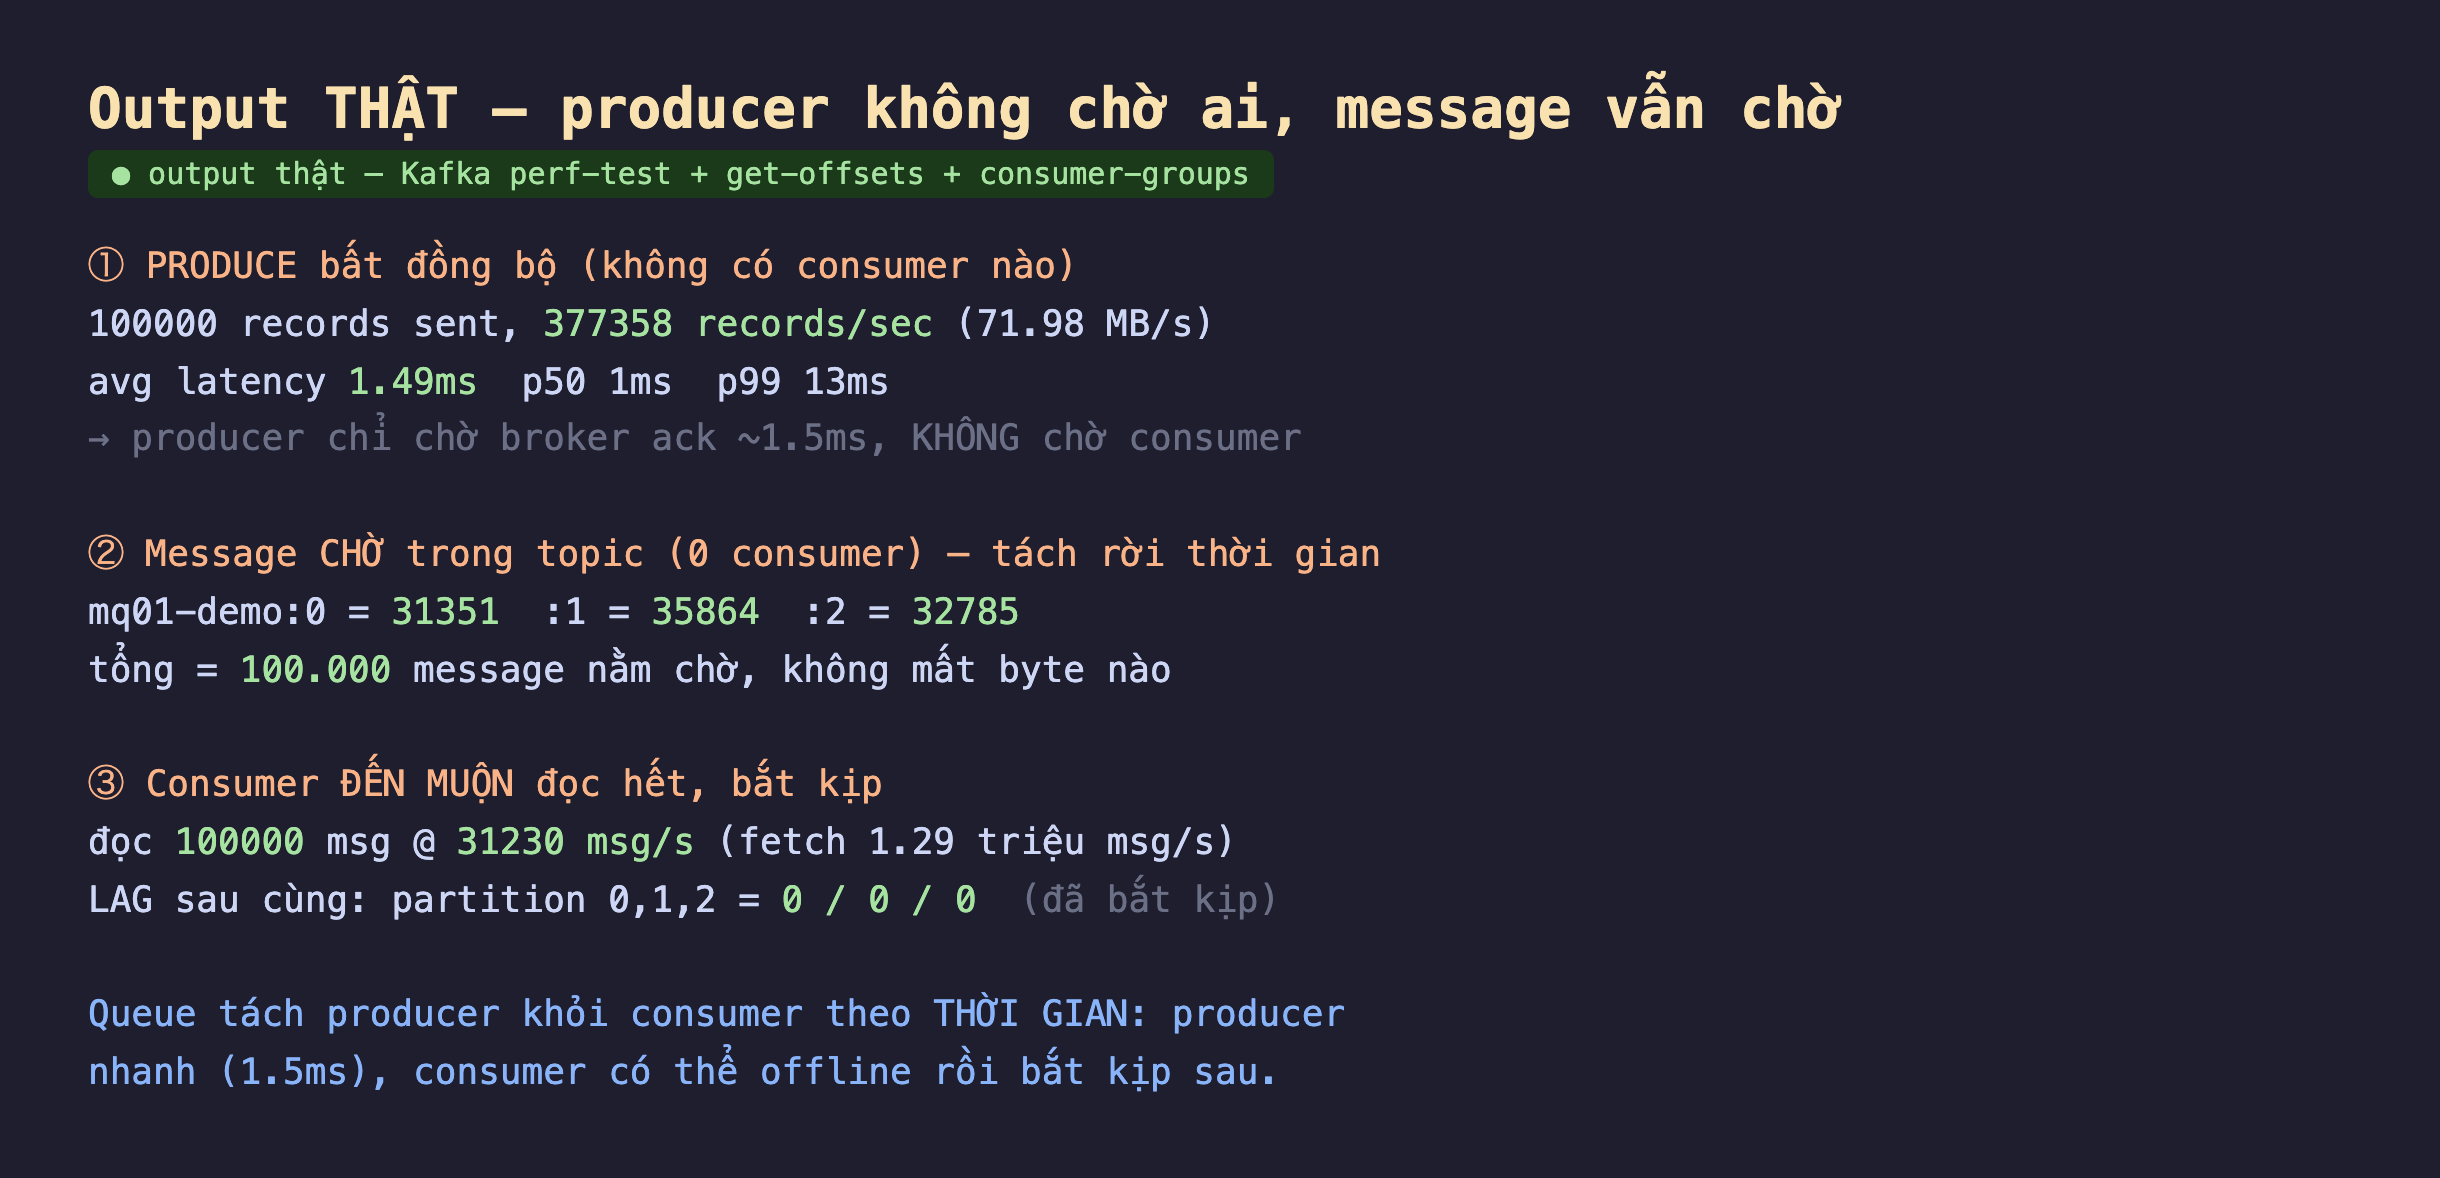
Hình 2: Output thật. ① Producer đẩy 100.000 message ở 377.358 msg/s, độ trễ trung bình chỉ 1.49ms (p99 13ms) — không hề có consumer nào. ② Ba partition giữ 31351+35864+32785 = 100.000 message nằm chờ. ③ Consumer đến muộn đọc hết ở 31.230 msg/s và kết thúc với LAG 0 trên cả ba partition.
Đọc kết quả:
- Producer nhanh và độc lập: 100.000 message được ghi ở 377.358 msg/s, độ trễ trung bình 1.49ms mỗi message. Quan trọng nhất: lúc này không có consumer nào. Producer chỉ chờ broker xác nhận (~1.5ms) rồi đi tiếp — nó không bao giờ chờ việc xử lý. So với gọi đồng bộ (caller chờ cả thời gian xử lý downstream), đây là khác biệt bản chất.
- Message chờ an toàn:
kafka-get-offsetscho thấy ba partition giữ đúng 100.000 message (31351 + 35864 + 32785), dù chưa consumer nào chạm vào. Đây là tách rời theo thời gian: dữ liệu được lưu bền trong hàng đợi, producer đã xong việc từ lâu, message kiên nhẫn đợi người đọc. - Consumer đến muộn bắt kịp: một consumer khởi động sau khi producer đã xong đọc hết 100.000 message ở 31.230 msg/s (tốc độ fetch thuần tới 1,29 triệu msg/s), và
consumer-groups --describecho thấy LAG về 0 trên cả ba partition — nó đã bắt kịp hoàn toàn. Consumer từng "offline" vẫn không bỏ lỡ gì.
Ba bước này là toàn bộ ý nghĩa của hàng đợi: producer và consumer không cần cùng sống, cùng tốc độ. Producer bùng tải lúc 9h sáng, consumer xử lý rải rác cả ngày — queue hấp thụ chênh lệch.
Tách rời không chỉ là tốc độ — mà là khả năng chịu lỗi
Điều demo gợi ra nhưng đáng nói rõ: tách rời theo thời gian đồng nghĩa với chịu lỗi tốt hơn. Trong mô hình đồng bộ, downstream sập là caller sập (hoặc phải tự xử lý retry/timeout phức tạp). Trong mô hình queue, consumer sập thì message cứ chất trong hàng đợi; khi consumer hồi phục, nó đọc tiếp từ offset đang dang dở — như demo cho thấy consumer đến muộn vẫn đọc từ đầu và bắt kịp. Producer hoàn toàn không biết và không quan tâm consumer có sống hay không. Đây là lý do queue là xương sống của kiến trúc chịu lỗi: nó biến một phụ thuộc cứng (phải gọi được ngay) thành một phụ thuộc mềm (sẽ được xử lý, sớm hay muộn).
Đánh đổi cần cân nhắc
Bất đồng bộ đổi tính tức thời lấy throughput và độ bền. Queue không miễn phí: bạn mất phản hồi ngay. Với gọi đồng bộ, caller biết kết quả tức thì (thành công/thất bại, dữ liệu trả về). Với queue, producer chỉ biết "đã gửi" — kết quả xử lý đến sau, qua một kênh khác (callback, một topic kết quả, hay polling). Nếu nghiệp vụ cần câu trả lời ngay (ví dụ kiểm tra số dư trước khi cho rút tiền), đồng bộ mới đúng. Queue hợp cho việc có thể xử lý sau: gửi email, cập nhật thống kê, xử lý đơn hàng nền.
Thêm queue là thêm một thành phần phải vận hành. Kafka/RabbitMQ là hệ phân tán cần cấu hình, giám sát, backup — thêm chi phí vận hành và một điểm có thể hỏng. Với hệ nhỏ, gọi trực tiếp có thể đủ và đơn giản hơn. Chỉ đưa queue vào khi lợi ích tách rời (chịu tải bùng, chịu lỗi, nhiều consumer) vượt chi phí vận hành — đừng thêm chỉ vì "nghe hiện đại".
"Đã gửi" không phải "đã xử lý" — và đó là nguồn của nhiều lỗi tinh vi. Producer thấy ack nghĩa là broker nhận được, không phải consumer đã làm xong. Giữa hai mốc đó có đủ thứ có thể sai: consumer xử lý lỗi, message bị xử lý trùng, hay xử lý sai thứ tự. Toàn bộ các bài sau của loạt này — ngữ nghĩa giao nhận, idempotency, ordering, dead letter — chính là để xử lý khoảng cách giữa "đã gửi" và "đã xử lý đúng".
Ba ý mang về
- Queue tách rời producer khỏi consumer theo thời gian: đo thật producer đẩy 100.000 message ở 377.358 msg/s với độ trễ 1.49ms mà không cần consumer nào — nó chỉ chờ broker ack, khác hẳn gọi đồng bộ (caller chờ cả thời gian xử lý downstream).
- Message chờ bền trong hàng đợi, consumer bắt kịp sau: đo thật 100.000 message nằm trong 3 partition khi 0 consumer, rồi một consumer đến muộn đọc hết và về LAG 0 — producer và consumer không cần cùng sống hay cùng tốc độ.
- Tách rời là chịu lỗi, nhưng đổi lấy tính tức thời: consumer sập thì message chờ chứ không kéo sập producer; bù lại bạn mất phản hồi ngay và thêm một hệ phải vận hành — dùng queue cho việc xử-lý-được-sau, và nhớ "đã gửi" chưa phải "đã xử lý đúng".
Nguồn
- Kafka docs — Design & durability: https://kafka.apache.org/documentation/#design
- Martin Kleppmann — Designing Data-Intensive Applications, ch.11 (Stream Processing)
- Confluent — Benefits of event-driven architecture: https://www.confluent.io/learn/event-driven-architecture/
Phần sau ta mổ xẻ ba ngữ nghĩa giao nhận — at-most-once, at-least-once, exactly-once — và chạy thật để thấy message bị mất và bị trùng trong từng chế độ, cùng cái giá của việc đảm bảo không mất không trùng.
