Bài trước ta thấy khóa Redis phân tán đủ tốt khi việc "thỉnh thoảng hai người cùng vào" gây khó chịu nhưng không thảm họa — và nó có thể sai khi Redis failover. Khi tính đúng đắn là tuyệt đối bắt buộc — một hệ cấu hình mà mọi node phải thấy cùng một giá trị, một cụm database mà không bao giờ được có hai primary — bạn cần thứ mạnh hơn: một thuật toán đồng thuận (consensus).
Raft là thuật toán đồng thuận được thiết kế để dễ hiểu (khác Paxos nổi tiếng khó). Nó là nền tảng của etcd (bộ não của Kubernetes), Consul, TiKV, và vô số hệ phân tán. Ý tưởng cốt lõi: nhiều node cùng thống nhất về một chuỗi lệnh có thứ tự (log), và mỗi node chạy log đó qua cùng một máy trạng thái để tới cùng kết quả — dù một số node chết, miễn đa số (quá bán) còn sống. Bài này dựng một cụm Raft 3 node thật trong Go bằng hashicorp/raft, và đo ba tính chất then chốt: bầu leader, nhân bản log đồng nhất, và failover.
FSM: máy trạng thái được nhân bản
Raft không tự biết "trạng thái" của bạn là gì — nó chỉ nhân bản một log các lệnh. Việc biến log thành trạng thái là của bạn, qua một FSM (finite state machine). Mỗi node chạy cùng một log qua cùng một FSM, nên tất cả tới cùng trạng thái. Ở đây FSM là một bộ đếm cộng dồn:
type demFSM struct { mu sync.Mutex; tong int64 }

func (f *demFSM) Apply(l *raft.Log) interface{} {
	f.mu.Lock(); defer f.mu.Unlock()
	f.tong += int64(l.Data[0]) // áp lệnh đã committed
	return f.tong
}
Apply được Raft gọi cho mỗi lệnh đã committed — và điểm mấu chốt là nó chỉ được gọi cho lệnh mà đa số node đã đồng ý. Bạn không bao giờ tự gọi Apply; Raft gọi nó, trên mọi node, theo đúng thứ tự.
Ba vai trò và cơ chế bầu leader
Mỗi node ở một trong ba vai trò:
- Follower: mặc định, thụ động nghe heartbeat từ leader.
- Candidate: nếu một follower hết thời gian chờ mà không nghe heartbeat (leader có thể đã chết), nó tăng term (số kỳ bầu cử) và tự ứng cử, xin phiếu từ các node khác.
- Leader: candidate nào được đa số phiếu trong một term thì thành leader. Chỉ leader nhận lệnh ghi, rồi nhân bản xuống follower.
term là một số nguyên tăng dần, đóng vai đồng hồ logic: nó đảm bảo mỗi term có tối đa một leader, và giúp node phát hiện thông tin cũ. Khi bạn thấy term nhảy từ 2 lên 3, đó là dấu một cuộc bầu cử mới đã xảy ra.
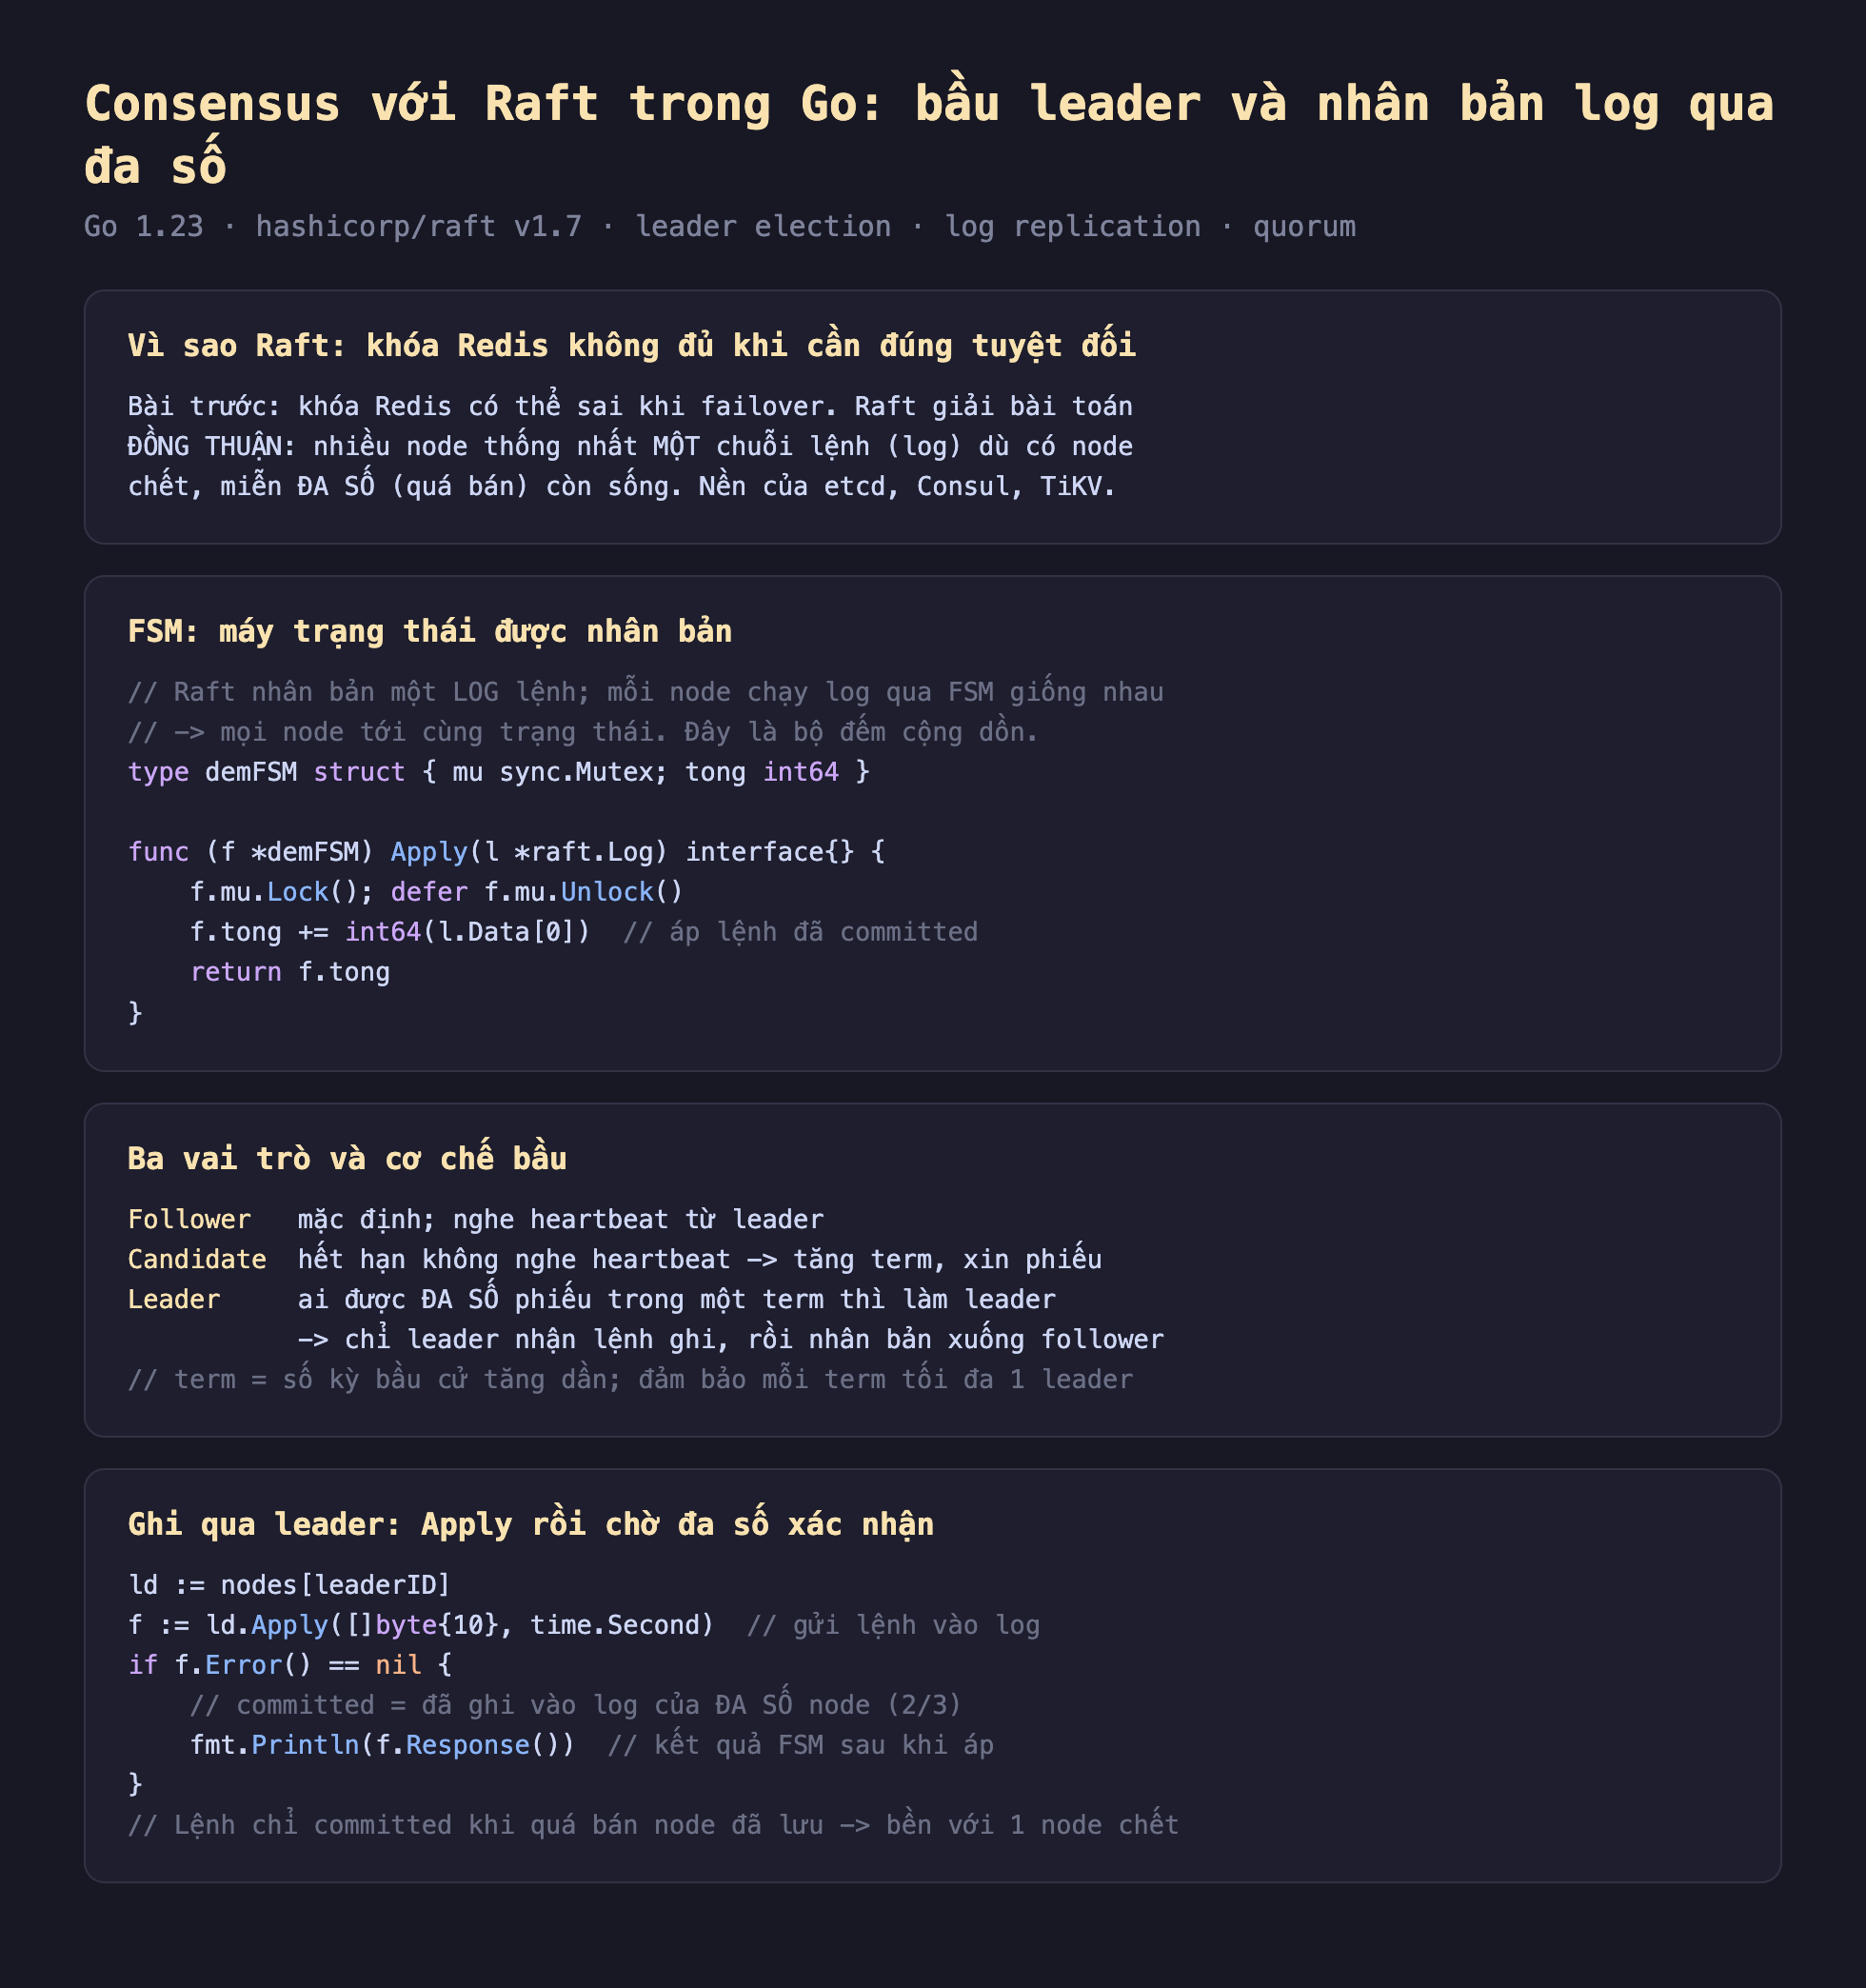
Hình 1: Raft trong Go — FSM nhận các lệnh đã committed để dựng trạng thái nhân bản; ba vai trò Follower/Candidate/Leader và cơ chế bầu qua đa số phiếu trong mỗi term; ghi chỉ qua leader và chỉ committed khi quá bán node đã lưu.
Ghi qua leader: Apply rồi chờ đa số
Client chỉ ghi qua leader. Apply gửi một lệnh vào log và chờ nó committed — nghĩa là đã được ghi vào log của đa số node:
ld := nodes[leaderID]
f := ld.Apply([]byte{10}, time.Second) // gửi lệnh vào log
if f.Error() == nil {
	// committed = đã ghi vào log của ĐA SỐ node (2/3)
	fmt.Println(f.Response()) // kết quả FSM sau khi áp
}
Chữ "committed" ở đây là cốt lõi của độ bền: một lệnh chỉ được coi là thành công khi quá bán node đã lưu nó vào log của chúng. Nghĩa là ngay cả khi leader chết ngay sau đó, lệnh vẫn sống — vì nó đã nằm trên đa số, và leader mới (được bầu từ đa số đó) chắc chắn có nó.
Đo thật: bầu leader và nhân bản log đồng nhất
Chạy cụm 3 node (n1, n2, n3) với transport trong bộ nhớ. Sau khi bootstrap, cụm bầu leader:
n1: Leader    term=2
n2: Follower  term=2
n3: Follower  term=2
Leader được bầu: n1
Đúng một leader (n1) trong term 2, hai node còn lại là follower — tất cả cùng term. Giờ áp 5 lệnh (mỗi lệnh cộng 10) qua leader:
lệnh 1 committed -> tổng trên FSM leader = 10
lệnh 2 committed -> tổng trên FSM leader = 20
...
lệnh 5 committed -> tổng trên FSM leader = 50
Mỗi lệnh committed và FSM leader cộng dồn tới 50. Điều quan trọng nhất — kiểm tra FSM trên tất cả node:
n1: tổng = 50    n2: tổng = 50    n3: tổng = 50
LastIndex trên leader = 7 (log đã nhân bản)
Cả ba node tới cùng một trạng thái (tổng = 50). Đây chính là đồng thuận: không phải chỉ leader biết kết quả, mà mọi node trong cụm đều đồng ý về cùng một chuỗi lệnh và cùng một trạng thái cuối. LastIndex = 7 (gồm mục bootstrap cấu hình, một mục noop khi leader nhậm chức, và 5 lệnh) cho thấy log đã nhân bản đầy đủ.
Đo thật: failover khi leader chết
Đây là lý do người ta dùng Raft. Tắt leader n1 và xem điều gì xảy ra:
== tắt leader n1 - cụm tự bầu leader mới ==
Leader mới: n2  |  term mới: 3
Leader mới áp thêm lệnh (+7) -> tổng = 57 (cụm vẫn hoạt động)
Khi n1 biến mất, n2 và n3 không còn nghe heartbeat, hết thời gian chờ, và tổ chức bầu cử mới ở term 3 (tăng từ 2). n2 được n3 bầu (hai node là đa số của cụm 3), thành leader mới. Và cụm vẫn ghi được — leader mới áp thêm lệnh (+7) đưa tổng lên 57. Cụm chịu được mất một node và tiếp tục hoạt động — đây là tính sẵn sàng cao mà một khóa Redis đơn lẻ không có.
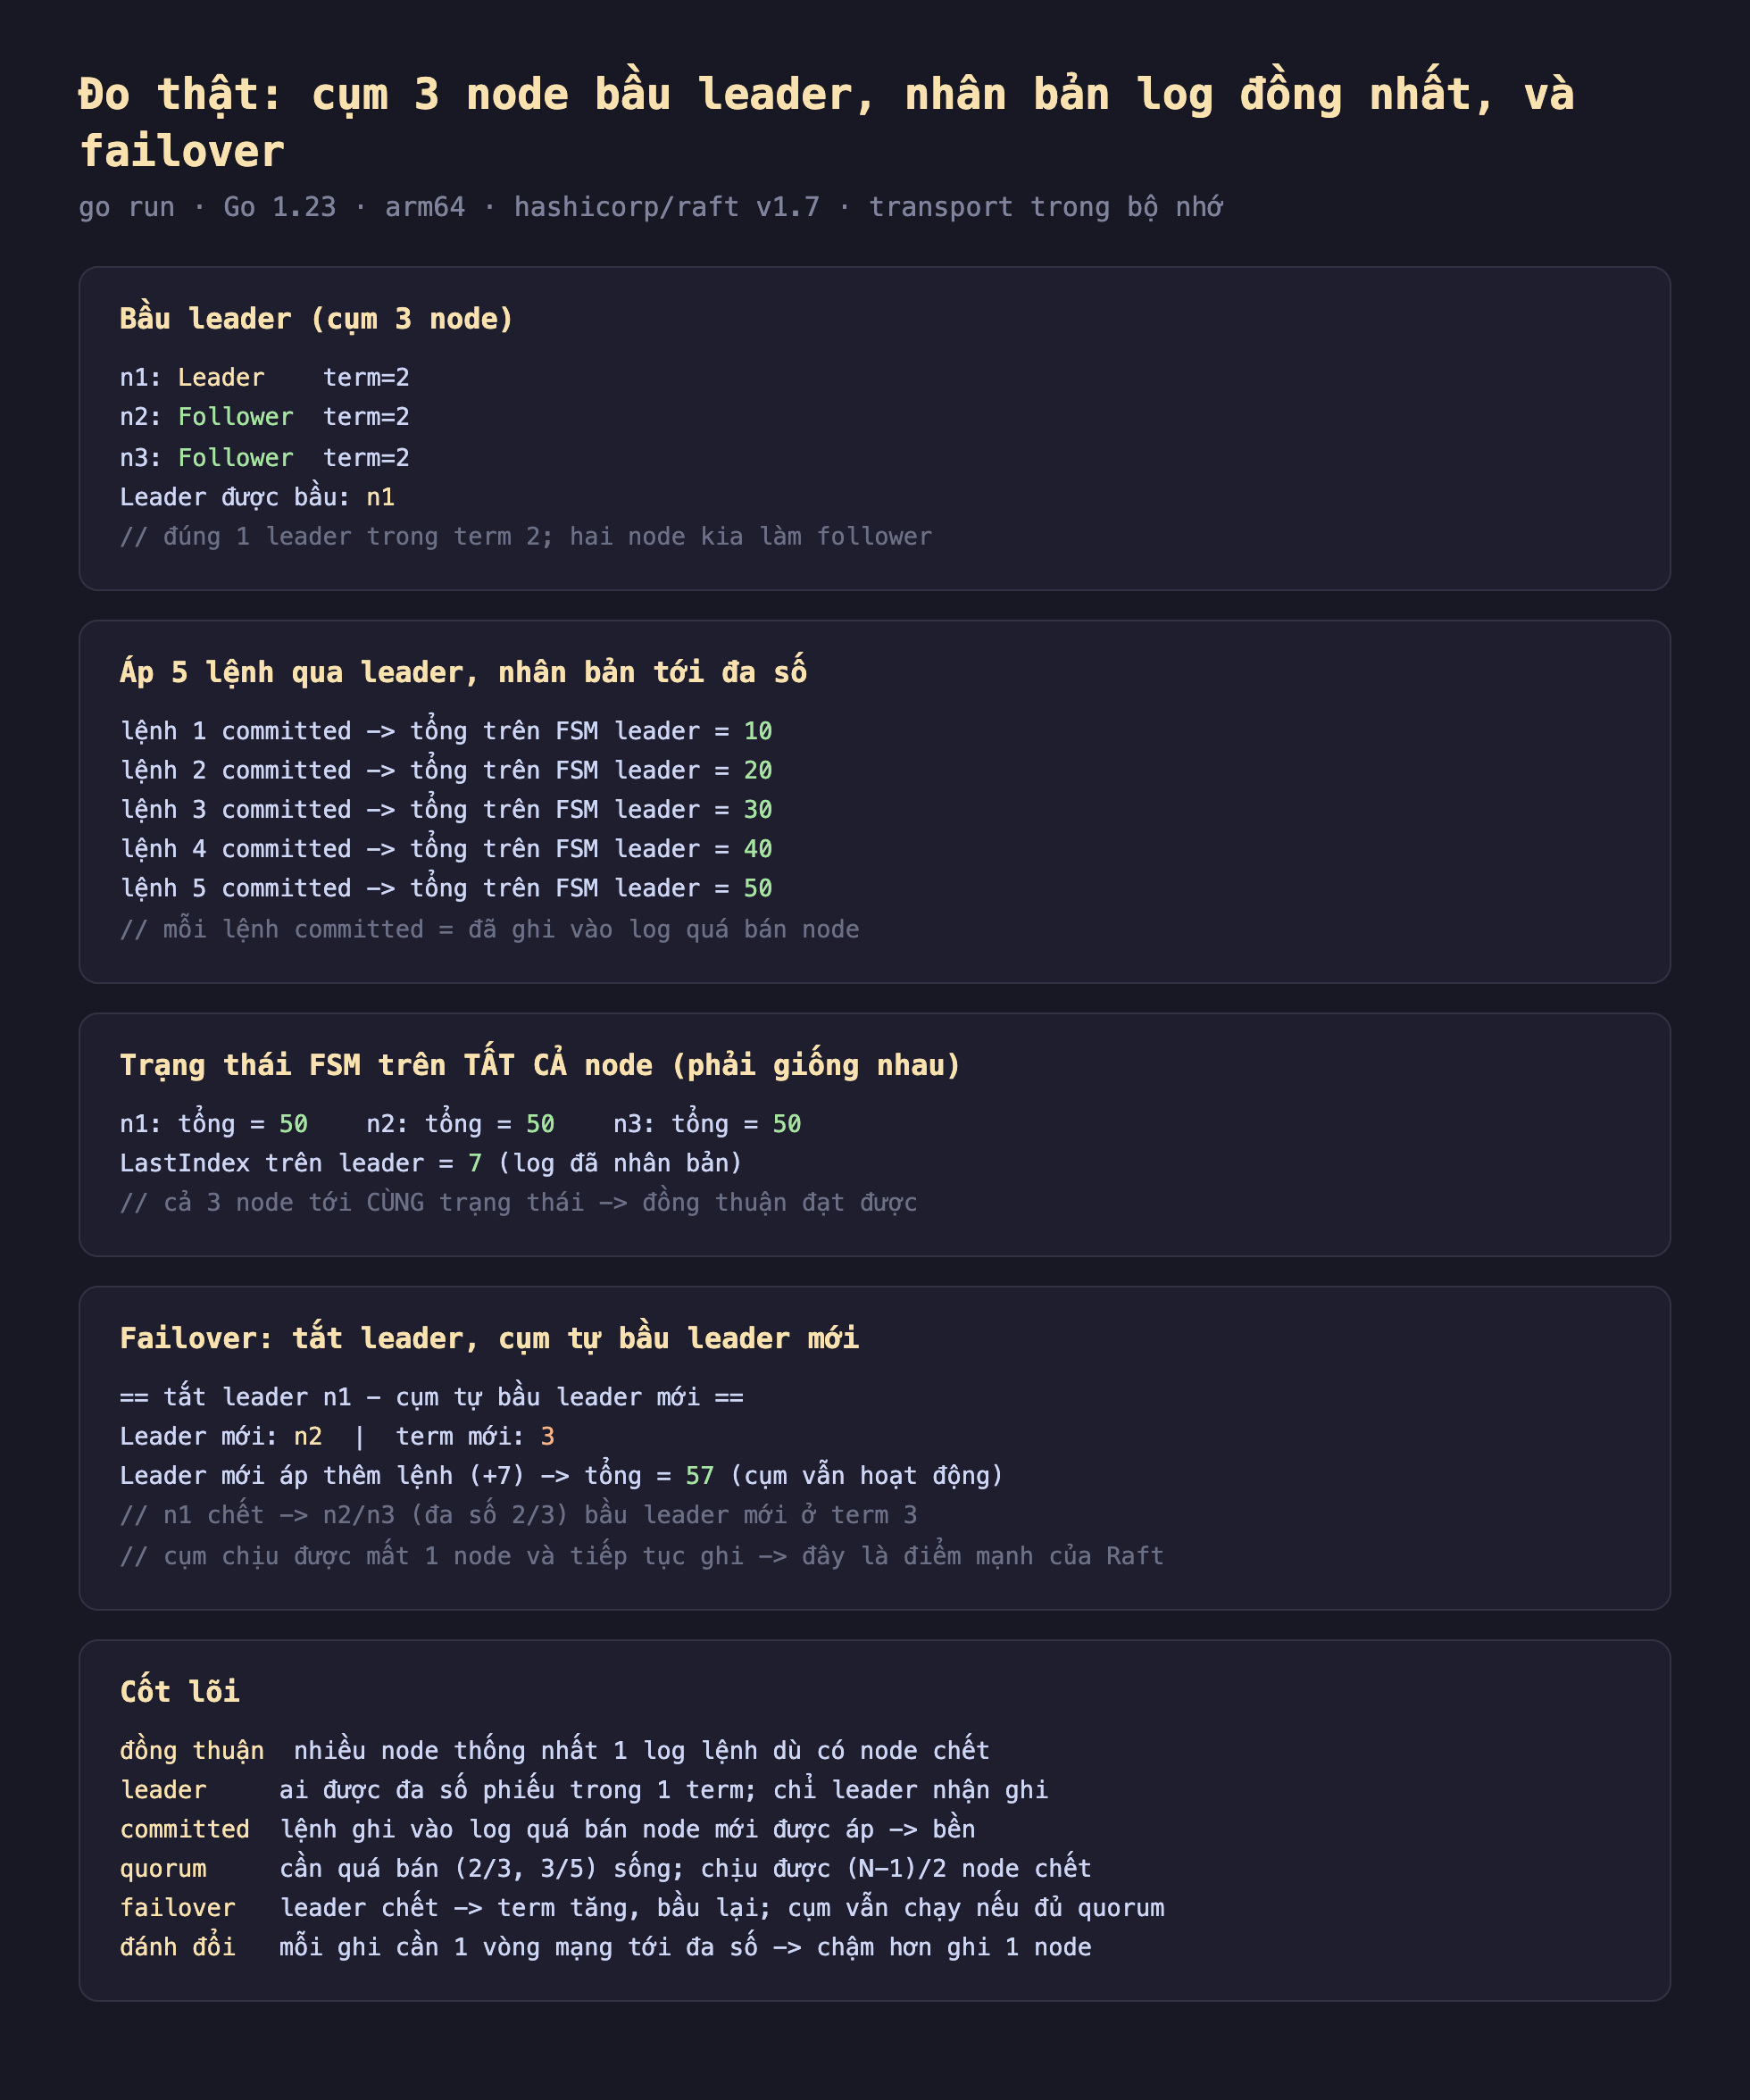
Hình 2: Đo thật cụm Raft 3 node — bầu đúng một leader n1 ở term 2, nhân bản 5 lệnh khiến FSM cả ba node đều bằng 50, và failover khi tắt n1 thì n2 được bầu ở term 3 và cụm vẫn ghi được (tổng lên 57).
Đánh đổi cần cân nhắc
Mỗi lần ghi tốn một vòng mạng tới đa số. Đây là cái giá của đồng thuận: leader không thể xác nhận ghi cho tới khi quá bán node đã lưu. Với cụm cùng data center, đó là dưới mili-giây; với cụm liên vùng địa lý, độ trễ ghi tăng đáng kể. Raft (và mọi consensus) chậm hơn ghi vào một node — bạn trả tốc độ để lấy tính đúng đắn và bền vững. Đừng dùng Raft cho dữ liệu lưu lượng cực cao không cần đảm bảo mạnh.
Quorum quyết định khả năng chịu lỗi. Cụm N node chịu được (N-1)/2 node chết: 3 node chịu 1, 5 node chịu 2. Số chẵn không có lợi — cụm 4 node vẫn chỉ chịu được 1 (cần 3 để quá bán), nên người ta luôn chọn số lẻ. Và nếu mất quá bán (2/3 node chết), cụm ngừng nhận ghi để bảo toàn tính nhất quán — nó ưu tiên "đúng" hơn "sẵn sàng" khi buộc phải chọn.
Dùng thư viện, đừng tự viết Raft. Demo này dùng hashicorp/raft — một implement đã được kiểm nghiệm sản xuất nhiều năm. Raft "dễ hiểu" hơn Paxos về mặt khái niệm, nhưng implement đúng mọi ca biên (snapshot, thay đổi thành viên cụm, khôi phục sau lỗi mạng chia cắt) cực kỳ khó. Với hầu hết nhu cầu, dùng thẳng etcd/Consul hoặc nhúng một thư viện Raft đã kiểm nghiệm là lựa chọn đúng.
Ba ý mang về
- Raft giải bài toán đồng thuận mà khóa Redis không giải nổi: nhiều node thống nhất một log lệnh và cùng tới một trạng thái — đo thật cụm 3 node bầu đúng một leader (term 2) và nhân bản 5 lệnh sao cho FSM cả ba node đều bằng 50.
- "Committed" nghĩa là đa số đã lưu: một lệnh chỉ thành công khi quá bán node ghi nó vào log, nên nó sống sót qua cái chết của leader — đo thật failover, tắt leader n1 thì n2 được bầu ở term 3 và cụm vẫn ghi được (tổng lên 57).
- Đánh đổi rõ ràng: mỗi ghi cần một vòng mạng tới đa số (chậm hơn ghi một node), quorum cần số lẻ và chịu được (N-1)/2 node chết, mất quá bán thì cụm ngừng ghi để giữ nhất quán — và luôn dùng thư viện Raft đã kiểm nghiệm thay vì tự viết.
Phần sau ta xét cách các dịch vụ trong hệ phân tán tìm thấy nhau: service discovery pattern trong Go — đăng ký, phát hiện, health check, và vì sao địa chỉ cứng không co giãn được.
