Đôi khi bạn phải gọi mã C từ Go: một thư viện mã hóa đã kiểm định, một driver phần cứng, SQLite, libjpeg. Go cho phép điều này qua cgo — cầu nối gọi hàm C ngay trong mã Go. Nghe tiện, và đúng là tiện. Nhưng cgo mang một cái giá mà nhiều người đánh giá thấp: mỗi lần vượt biên giới Go↔C tốn một khoản phí cố định, không phụ thuộc hàm C làm gì. Bài này đo thật khoản phí đó, giải thích vì sao nó tồn tại, và chỉ ra cách duy nhất để nó không giết hiệu năng.
Gọi C từ Go trông thế nào
cgo dùng một quy ước đặc biệt: viết mã C trong một khối comment ngay trên dòng import "C". Mọi hàm, kiểu, biến C khai trong đó truy cập được qua namespace giả C:
/*
#include <stdint.h>
static int64_t cong_c(int64_t a, int64_t b) { return a + b; }
*/
import "C"

r := C.cong_c(C.int64_t(20), C.int64_t(22)) // = 42
import "C" phải đứng ngay dưới khối comment, không có dòng trống xen giữa. C.cong_c gọi hàm C; C.int64_t(...) chuyển giá trị Go sang kiểu C tương ứng. Đo thật trong go-lab (Go 1.23, gcc 12.2): C.cong_c(20,22) trả về 42 đúng như mong đợi. Nhưng có một tác dụng phụ quan trọng: bật cgo khiến binary link động tới libc — không còn là binary tĩnh thuần túy nữa (ta sẽ nói ở phần đánh đổi).
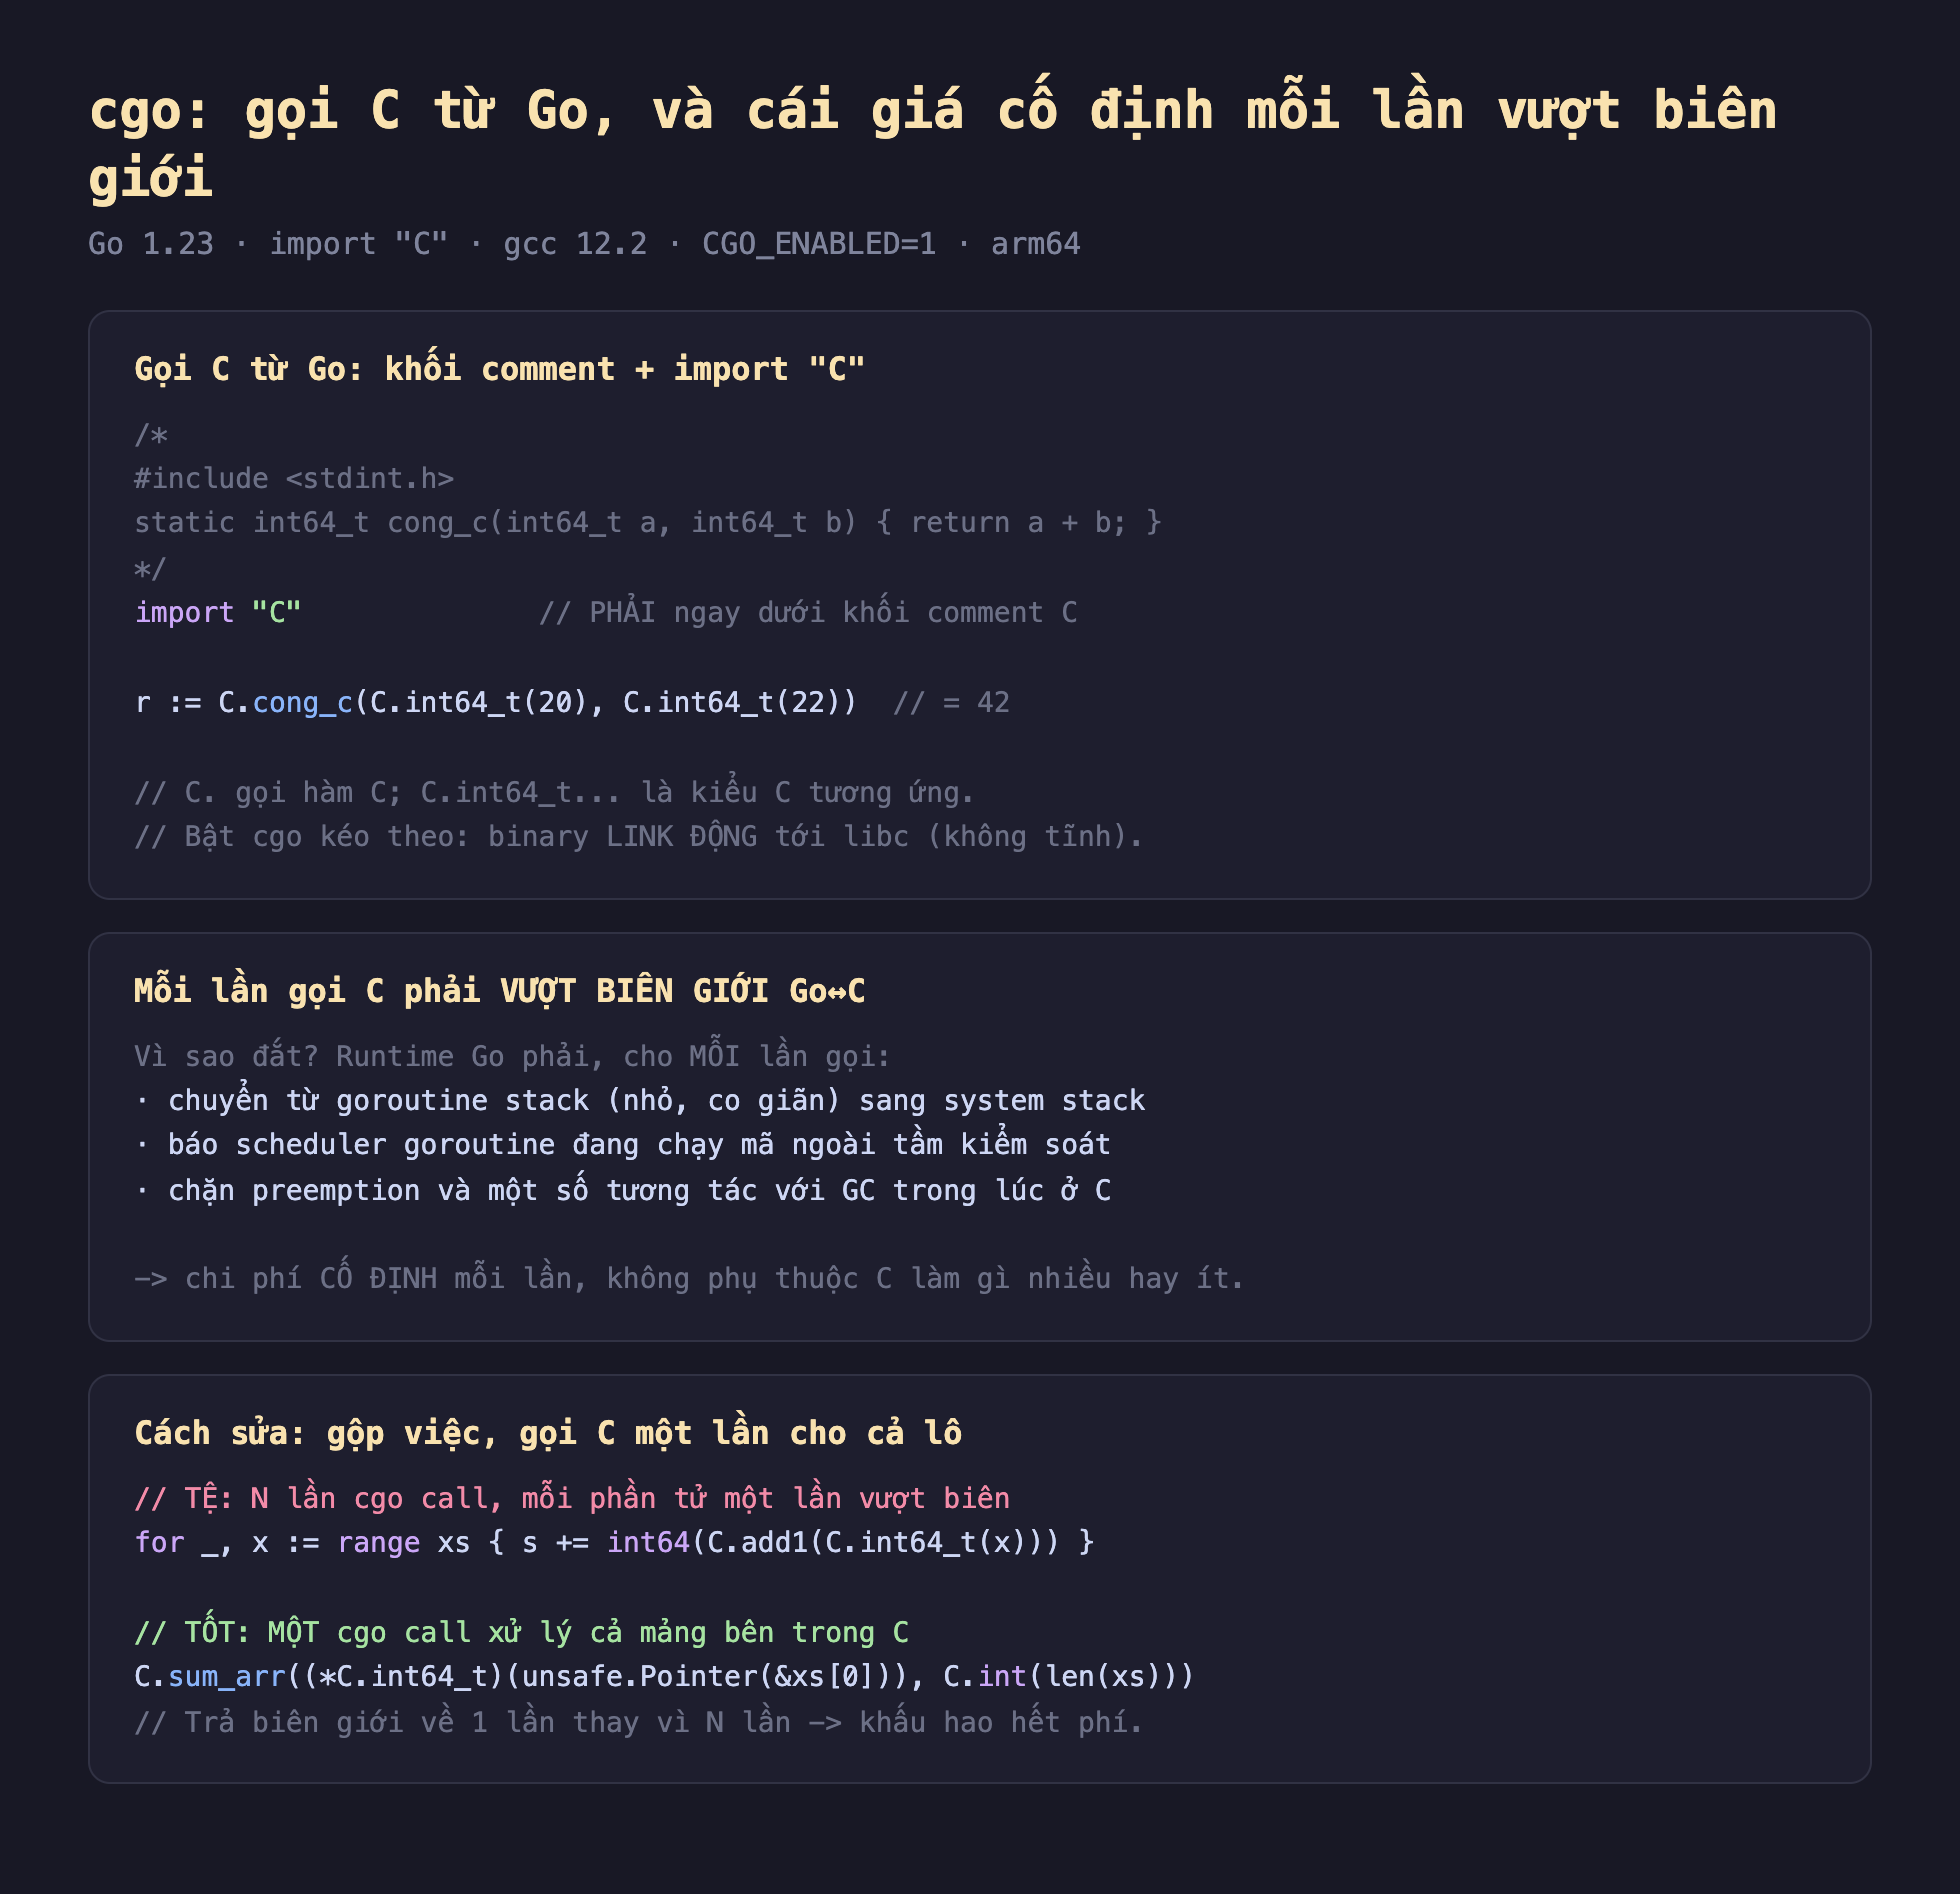
Hình 1: cgo dùng khối comment C ngay trên import "C". C.cong_c(...) gọi hàm C. Mỗi lần gọi phải vượt biên giới Go↔C — chi phí cố định. Cách sửa: gộp việc, gọi C một lần cho cả lô thay vì mỗi phần tử một lần.
Vì sao mỗi lần gọi lại đắt
Một lời gọi hàm Go thường gần như miễn phí — compiler thường inline nó. Nhưng gọi qua cgo, runtime Go phải làm một loạt việc cho mỗi lần gọi:
- Chuyển từ goroutine stack (nhỏ, co giãn được) sang system stack (cố định, kiểu C) — vì mã C không hiểu stack co giãn của Go.
- Báo cho scheduler biết goroutine này đang chạy mã ngoài tầm kiểm soát của runtime, để nó không bị preempt hay dời sang thread khác giữa chừng.
- Xử lý tương tác với GC: trong lúc ở C, con trỏ Go truyền vào phải được pin để GC không dời chúng.
Tất cả những việc này là chi phí cố định mỗi lần gọi, không phụ thuộc hàm C bên trong làm nhiều hay ít. Đo thật để thấy điều đó:
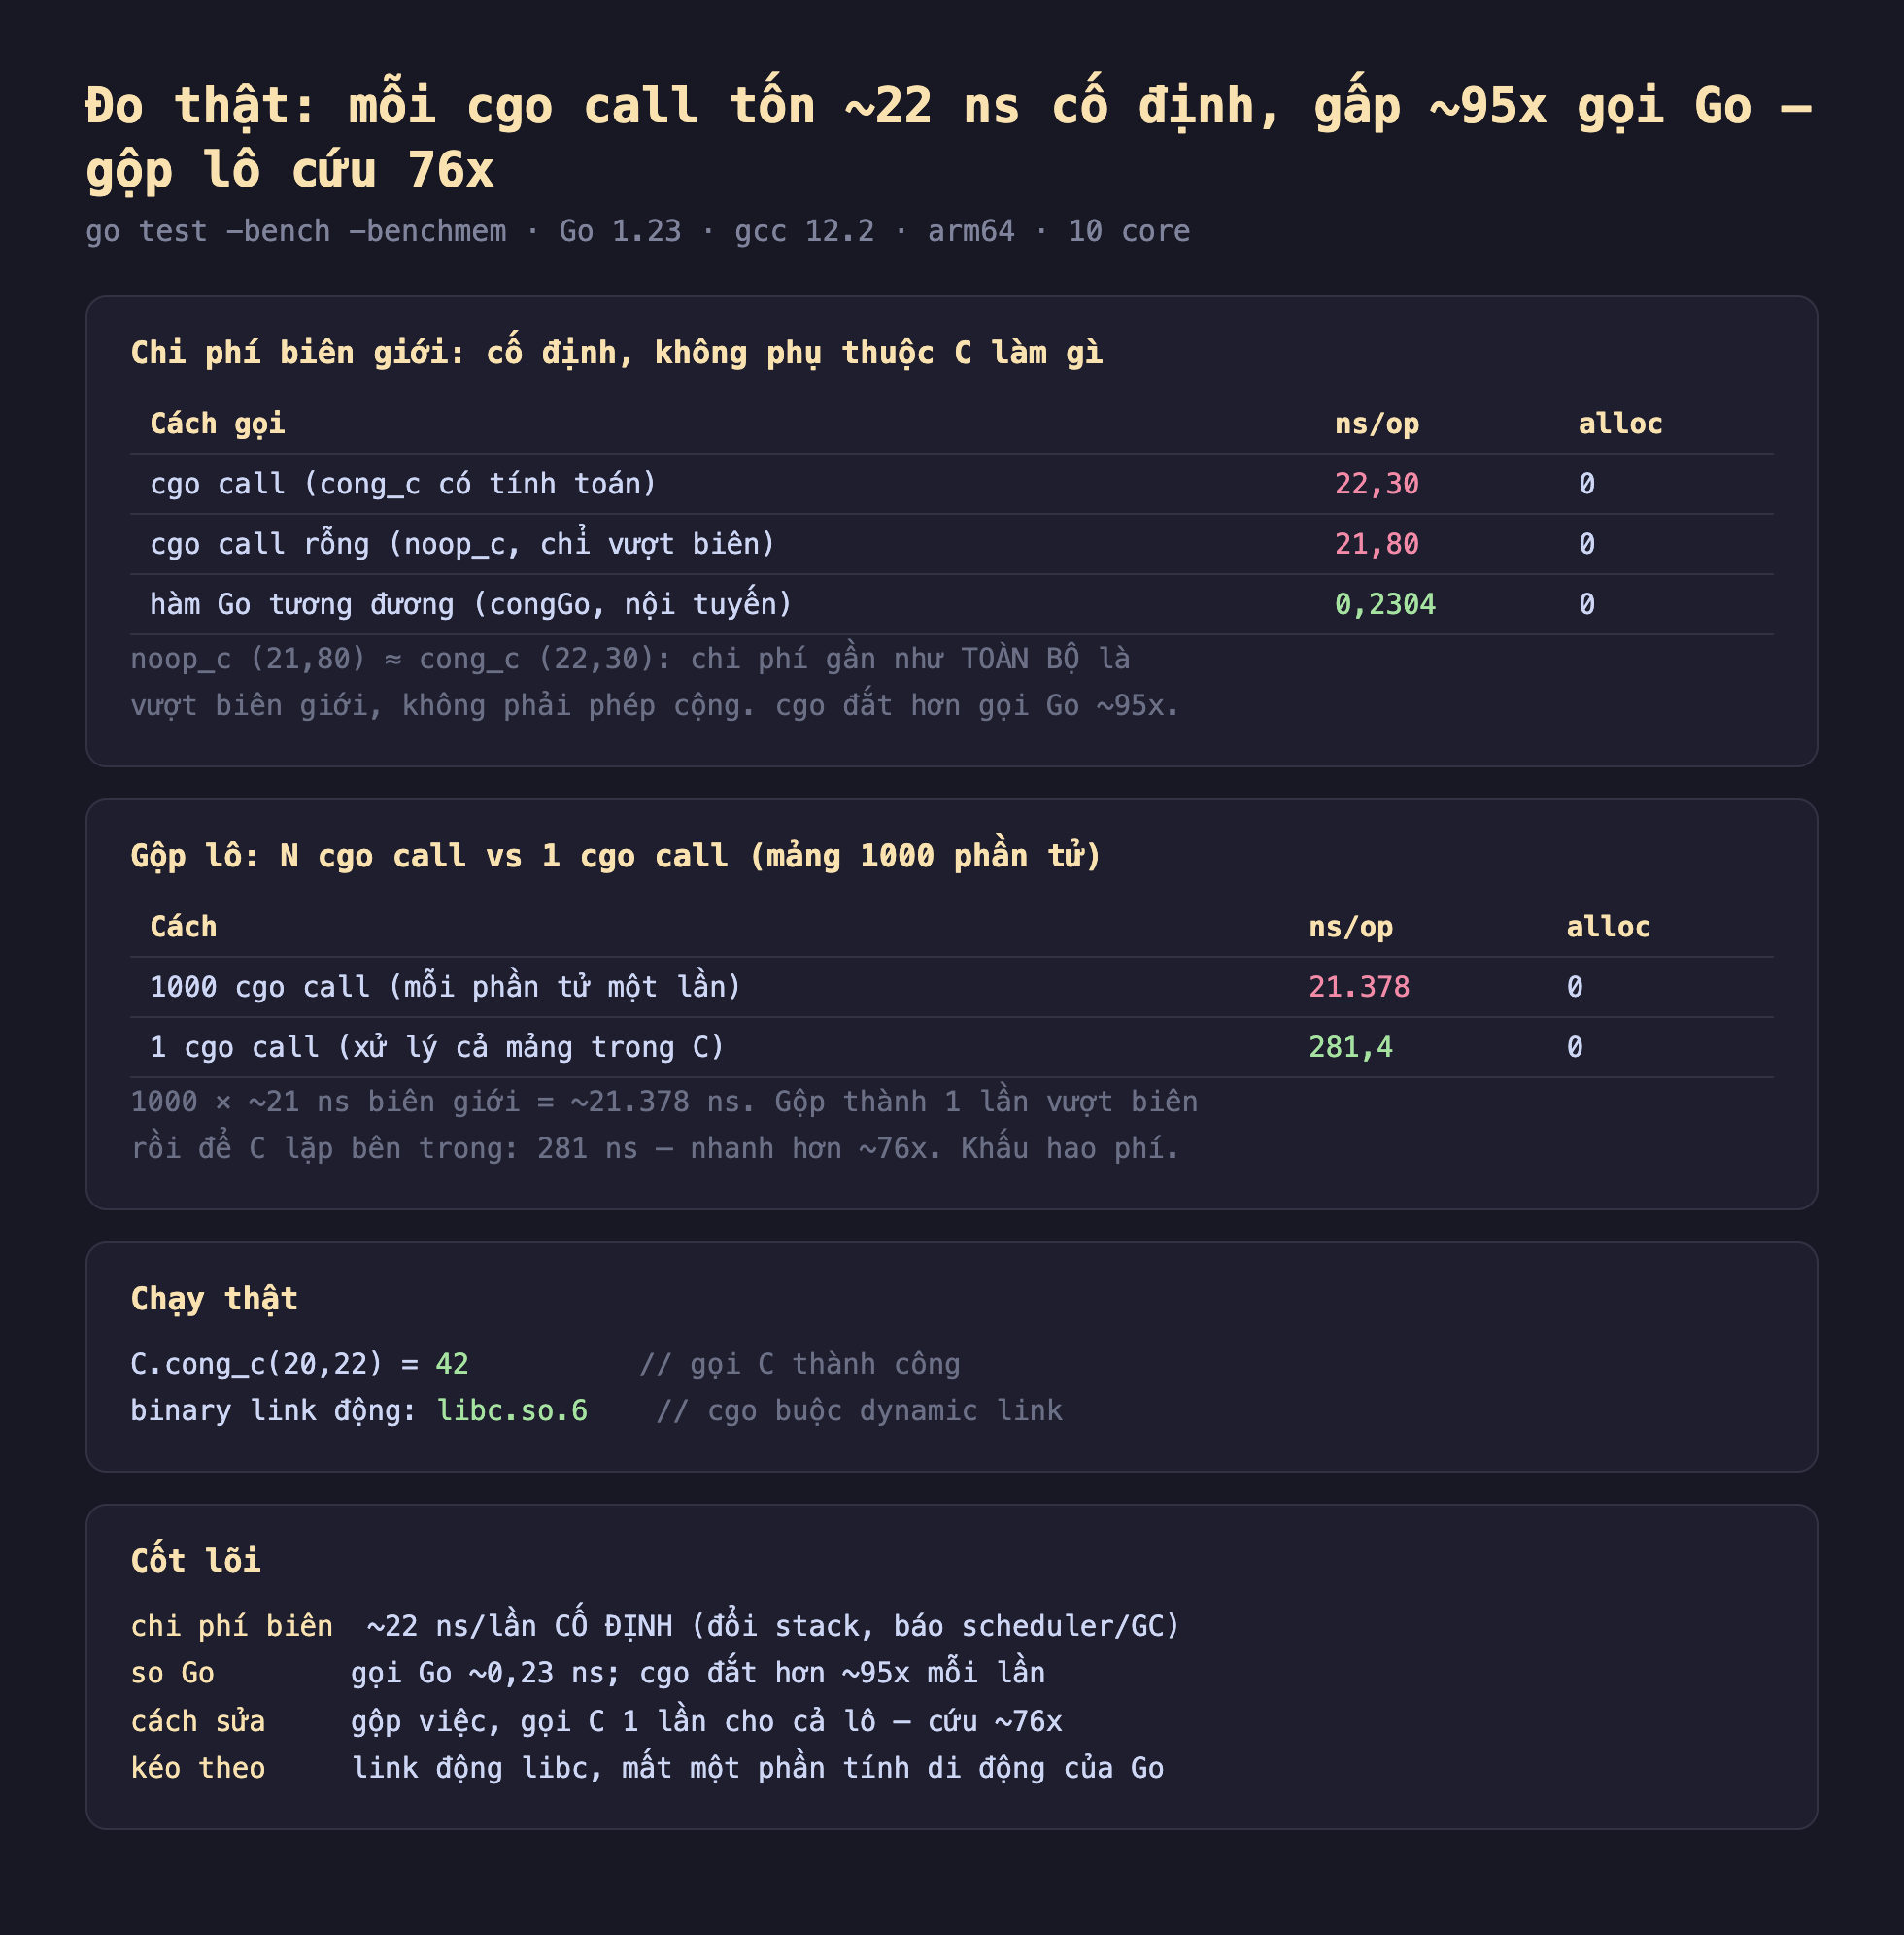
Hình 2: cgo call có tính toán (22,30 ns) và cgo call rỗng (21,80 ns) gần bằng nhau — chi phí gần như toàn bộ là vượt biên giới, không phải phép cộng. Hàm Go tương đương chỉ 0,2304 ns. Gộp lô: 1000 cgo call riêng lẻ (21.378 ns) so với 1 cgo call cho cả mảng (281,4 ns) — nhanh hơn ~76x.
Bằng chứng nằm ở hai dòng đầu: noop_c (hàm C rỗng, chỉ return 0) mất 21,80 ns, còn cong_c (có phép cộng) mất 22,30 ns — gần như bằng nhau. Nghĩa là ~22 ns đó không phải chi phí tính toán mà gần như toàn bộ là chi phí vượt biên giới. So với hàm Go tương đương chạy 0,2304 ns, một cgo call đắt hơn khoảng 95 lần. Con số này nhất quán với những gì cộng đồng Go đo được qua nhiều năm: cgo call cỡ vài chục nano giây, gấp cả trăm lần gọi Go thường.
Cách sửa duy nhất: gộp lô
Vì phí là mỗi lần vượt biên, cách duy nhất để nó không giết hiệu năng là vượt biên ít lần hơn — gộp nhiều việc vào một cgo call. So sánh hai cách xử lý mảng 1.000 phần tử:
// TỆ: 1000 cgo call, mỗi phần tử một lần vượt biên
for _, x := range xs { s += int64(C.add1(C.int64_t(x))) }

// TỐT: MỘT cgo call, C tự lặp bên trong
C.sum_arr((*C.int64_t)(unsafe.Pointer(&xs[0])), C.int(len(xs)))
Đo thật: cách per-element mất 21.378 ns (1000 × ~21 ns biên giới), còn cách gộp lô chỉ 281,4 ns — nhanh hơn ~76 lần. Toàn bộ chênh lệch là chi phí biên giới bị nhân lên 1000 lần ở cách đầu. Nguyên tắc rút ra: nếu phải dùng cgo, hãy thiết kế API C thô (coarse-grained) — mỗi cgo call làm thật nhiều việc — thay vì API mịn (fine-grained) gọi qua lại liên tục. Truyền cả mảng, cả buffer, cả struct sang một lần, để C xử lý trong vòng lặp của nó.
Đánh đổi cần cân nhắc
cgo phá vỡ binary tĩnh và một phần tính di động. Binary có cgo link động tới libc (đo thật: ldd cho thấy libc.so.6), nên không còn "copy một file là chạy mọi nơi" — máy đích phải có libc tương thích. Cross-compile cũng phức tạp hơn nhiều vì cần toolchain C cho nền tảng đích. Nếu ưu thế lớn nhất của dự án là triển khai một-binary, cân nhắc kỹ trước khi thêm cgo.
Chỉ dùng cgo khi thật sự cần thư viện C. Với thư viện lớn đã kiểm định (OpenSSL, SQLite, ffmpeg) mà viết lại bằng Go là phi thực tế, cgo là lựa chọn đúng. Nhưng nếu chỉ cần một thuật toán nhỏ, viết thẳng bằng Go thường thắng — vừa tránh phí biên giới, vừa giữ binary tĩnh, vừa dễ debug (stack trace xuyên biên giới C rất khó đọc).
Đừng gọi cgo trong vòng lặp nóng. Đây là hệ quả trực tiếp của phép đo. Một cgo call trong vòng lặp chạy hàng triệu lần biến ~22 ns thành hàng chục mili giây phí thuần. Nếu buộc phải xử lý nhiều phần tử qua C, gộp chúng thành một call. Và luôn benchmark — đôi khi phiên bản Go thuần hóa ra nhanh hơn cgo dù C nhanh hơn, đơn giản vì phí biên giới lớn hơn phần C tiết kiệm được.
Ba ý mang về
- Mỗi cgo call tốn một khoản phí cố định ~22 ns để vượt biên giới Go↔C (đổi stack, báo scheduler, pin con trỏ cho GC) — đo thật, hàm C rỗng (21,80 ns) gần bằng hàm C có tính toán (22,30 ns), chứng tỏ phí nằm ở biên giới chứ không ở phần C; đắt hơn một lời gọi Go (~0,23 ns) khoảng 95 lần.
- Cách sửa là gộp lô — vượt biên ít lần hơn: đo thật, 1000 cgo call riêng lẻ (21.378 ns) so với một cgo call xử lý cả mảng trong C (281,4 ns) nhanh hơn ~76 lần; thiết kế API C thô, truyền cả buffer/mảng một lần thay vì gọi qua lại.
- cgo đánh đổi tính di động: binary link động tới libc (mất binary tĩnh), cross-compile phức tạp, stack trace khó đọc — chỉ dùng khi thật sự cần thư viện C đã kiểm định, và đừng bao giờ gọi cgo trong vòng lặp nóng.
Bài tập làm thử
Bài 1 (đọc hiểu). Bài đo được: gọi hàm C rỗng noop_c (chỉ return 0) mất 21,80 ns, còn gọi hàm C có phép cộng cong_c mất 22,30 ns — gần như bằng nhau. Giải thích ý nghĩa của việc hai con số này gần bằng nhau, và tại sao đây là bằng chứng quan trọng về bản chất chi phí của cgo.
Đáp án
Vì noop_c không làm gì (chỉ trả về ngay) mà vẫn mất gần bằng thời gian với cong_c (có thực hiện phép cộng), điều đó chứng tỏ khoảng ~22 ns đo được hầu như hoàn toàn là chi phí vượt biên giới Go↔C (đổi stack, báo scheduler, xử lý tương tác GC) chứ không phải chi phí của phép tính bên trong hàm C. Đây là bằng chứng cốt lõi cho luận điểm của bài: cgo có một khoản phí cố định mỗi lần gọi, không phụ thuộc hàm C làm việc nhiều hay ít.
Bài 2 (sửa lỗi/tối ưu). Đoạn mã sau xử lý một mảng 1.000 phần tử bằng cách gọi cgo cho từng phần tử, rất chậm theo bài đo (~21.378 ns). Viết lại theo nguyên tắc "gộp lô" để đạt hiệu năng tốt hơn nhiều (như trong bài, ~281,4 ns).
var s int64
for _, x := range xs {
	s += int64(C.add1(C.int64_t(x)))
}
Đáp án
s := int64(C.sum_arr((*C.int64_t)(unsafe.Pointer(&xs[0])), C.int(len(xs))))
Thay vì vượt biên giới Go↔C 1.000 lần (mỗi phần tử một lần gọi C.add1), ta gộp toàn bộ công việc vào một lời gọi cgo duy nhất (C.sum_arr), truyền cả con trỏ mảng và độ dài sang, để vòng lặp cộng dồn chạy hoàn toàn bên trong C. Điều này giảm số lần vượt biên từ 1.000 xuống còn 1, khấu hao hết chi phí cố định của cgo và đạt tốc độ nhanh hơn khoảng 76 lần theo đo thật trong bài.
Bài 3 (vận dụng thực tế). Đội của bạn cân nhắc dùng cgo để gọi một thư viện C tính toán ảnh, xử lý mỗi pixel một lần qua một hàm C nhỏ, chạy trong vòng lặp cho ảnh độ phân giải cao (hàng triệu pixel). Dựa vào số liệu đo trong bài, đây có phải thiết kế tốt không? Đề xuất cách tiếp cận thay thế.
Đáp án
Đây là thiết kế tệ. Với hàng triệu pixel, gọi cgo cho mỗi pixel sẽ nhân chi phí cố định ~22 ns lên hàng triệu lần, biến ra hàng chục hoặc hàng trăm mili giây phí thuần chỉ để vượt biên giới, đúng như cảnh báo trong bài: "một cgo call trong vòng lặp chạy hàng triệu lần biến ~22 ns thành hàng chục mili giây phí thuần." Cách tiếp cận đúng: thiết kế API C "thô" (coarse-grained) — truyền toàn bộ buffer ảnh (con trỏ + kích thước) sang C trong một lời gọi duy nhất, để vòng lặp xử lý từng pixel chạy hoàn toàn bên trong mã C, chỉ vượt biên giới Go↔C đúng một lần cho cả bức ảnh.
Bài 4 (đọc hiểu / đánh đổi). Sau khi đo, một kỹ sư phát hiện phiên bản viết thuần bằng Go (không dùng cgo) cho một thuật toán nhỏ lại nhanh hơn phiên bản gọi qua cgo, dù bản thân thuật toán C được biết là nhanh hơn thuật toán Go tương đương. Giải thích hiện tượng này bằng kiến thức trong bài.
Đáp án
Hiện tượng này hoàn toàn hợp lý và được bài học cảnh báo trực tiếp: "đôi khi phiên bản Go thuần hóa ra nhanh hơn cgo dù C nhanh hơn, đơn giản vì phí biên giới lớn hơn phần C tiết kiệm được." Nếu thuật toán được gọi nhiều lần (đặc biệt trong vòng lặp), chi phí cố định ~22 ns mỗi lần vượt biên giới Go↔C có thể lớn hơn nhiều so với phần thời gian C tiết kiệm được so với Go cho mỗi lần tính toán nhỏ — tổng thể khiến bản cgo chậm hơn. Bài học rút ra: luôn benchmark thực tế thay vì giả định "C nhanh hơn nên cgo luôn thắng".
Bài 5 (bẫy/đánh đổi). Một dự án Go tự hào về khả năng "copy một binary tĩnh là chạy được mọi nơi" (triển khai một-binary). Nhóm định thêm cgo để dùng một thư viện nén dữ liệu viết bằng C. Nêu hệ quả cụ thể của quyết định này đối với tính di động, theo bài học.
Đáp án
Thêm cgo sẽ phá vỡ tính "binary tĩnh thuần túy": binary sẽ link động tới libc (kiểm chứng được bằng lệnh ldd cho thấy phụ thuộc libc.so.6), nghĩa là máy đích phải có phiên bản libc tương thích thì binary mới chạy được — không còn đúng nghĩa "copy một file là chạy mọi nơi" nữa. Ngoài ra, cross-compile sẽ phức tạp hơn nhiều vì cần có toolchain C cho từng nền tảng đích (không chỉ đổi biến GOOS/GOARCH như Go thuần). Theo bài, nếu ưu thế triển khai một-binary là giá trị cốt lõi của dự án, cần cân nhắc kỹ trước khi thêm cgo — chỉ nên chấp nhận đánh đổi này khi thật sự không có lựa chọn viết lại thư viện đó bằng Go thuần.
Phần sau ta đi tới một đích biên dịch hiện đại mở ra thế giới trình duyệt cho Go: Phần sau mổ xẻ WebAssembly — biên dịch Go với GOOS=js GOARCH=wasm, cách gọi qua lại JavaScript, và kích thước binary wasm.
