Bài trước ta xây stack lock-free và thấy nó chậm hơn mutex. Bài này ta thử một cấu trúc khó hơn nhiều: hàng đợi lock-free. Stack chỉ có một điểm truy cập (đỉnh); hàng đợi có hai — lấy ở đầu (head), thêm ở cuối (tail) — nên phải phối hợp hai con trỏ nhất quán. Thuật toán chuẩn là Michael-Scott queue, một trong những cấu trúc lock-free nổi tiếng nhất. Ta sẽ xây nó, kiểm đúng, và đo — rồi thấy vì sao channel của Go vẫn là câu trả lời cho gần như mọi trường hợp.
Vì sao hàng đợi khó hơn stack
Stack lock-free chỉ cần CAS một con trỏ head. Hàng đợi phức tạp hơn hẳn:
- Hai điểm truy cập:
Enqueueđụngtail,Dequeueđụnghead— phải giữ hai con trỏ nhất quán với nhau. - Node giả (dummy): queue bắt đầu với một node rỗng để
headvàtailluôn trỏ tới một node hợp lệ, tránh trường hợp đặc biệt khi rỗng. - Cập nhật hai bước: thêm một phần tử cần hai thao tác (gắn node vào cuối, rồi đẩy
tail) — mà giữa hai bước có thể bị goroutine khác chen vào.
type MSQueue struct {
	head atomic.Pointer[node]   // lấy ở đây
	tail atomic.Pointer[node]   // thêm ở đây
}
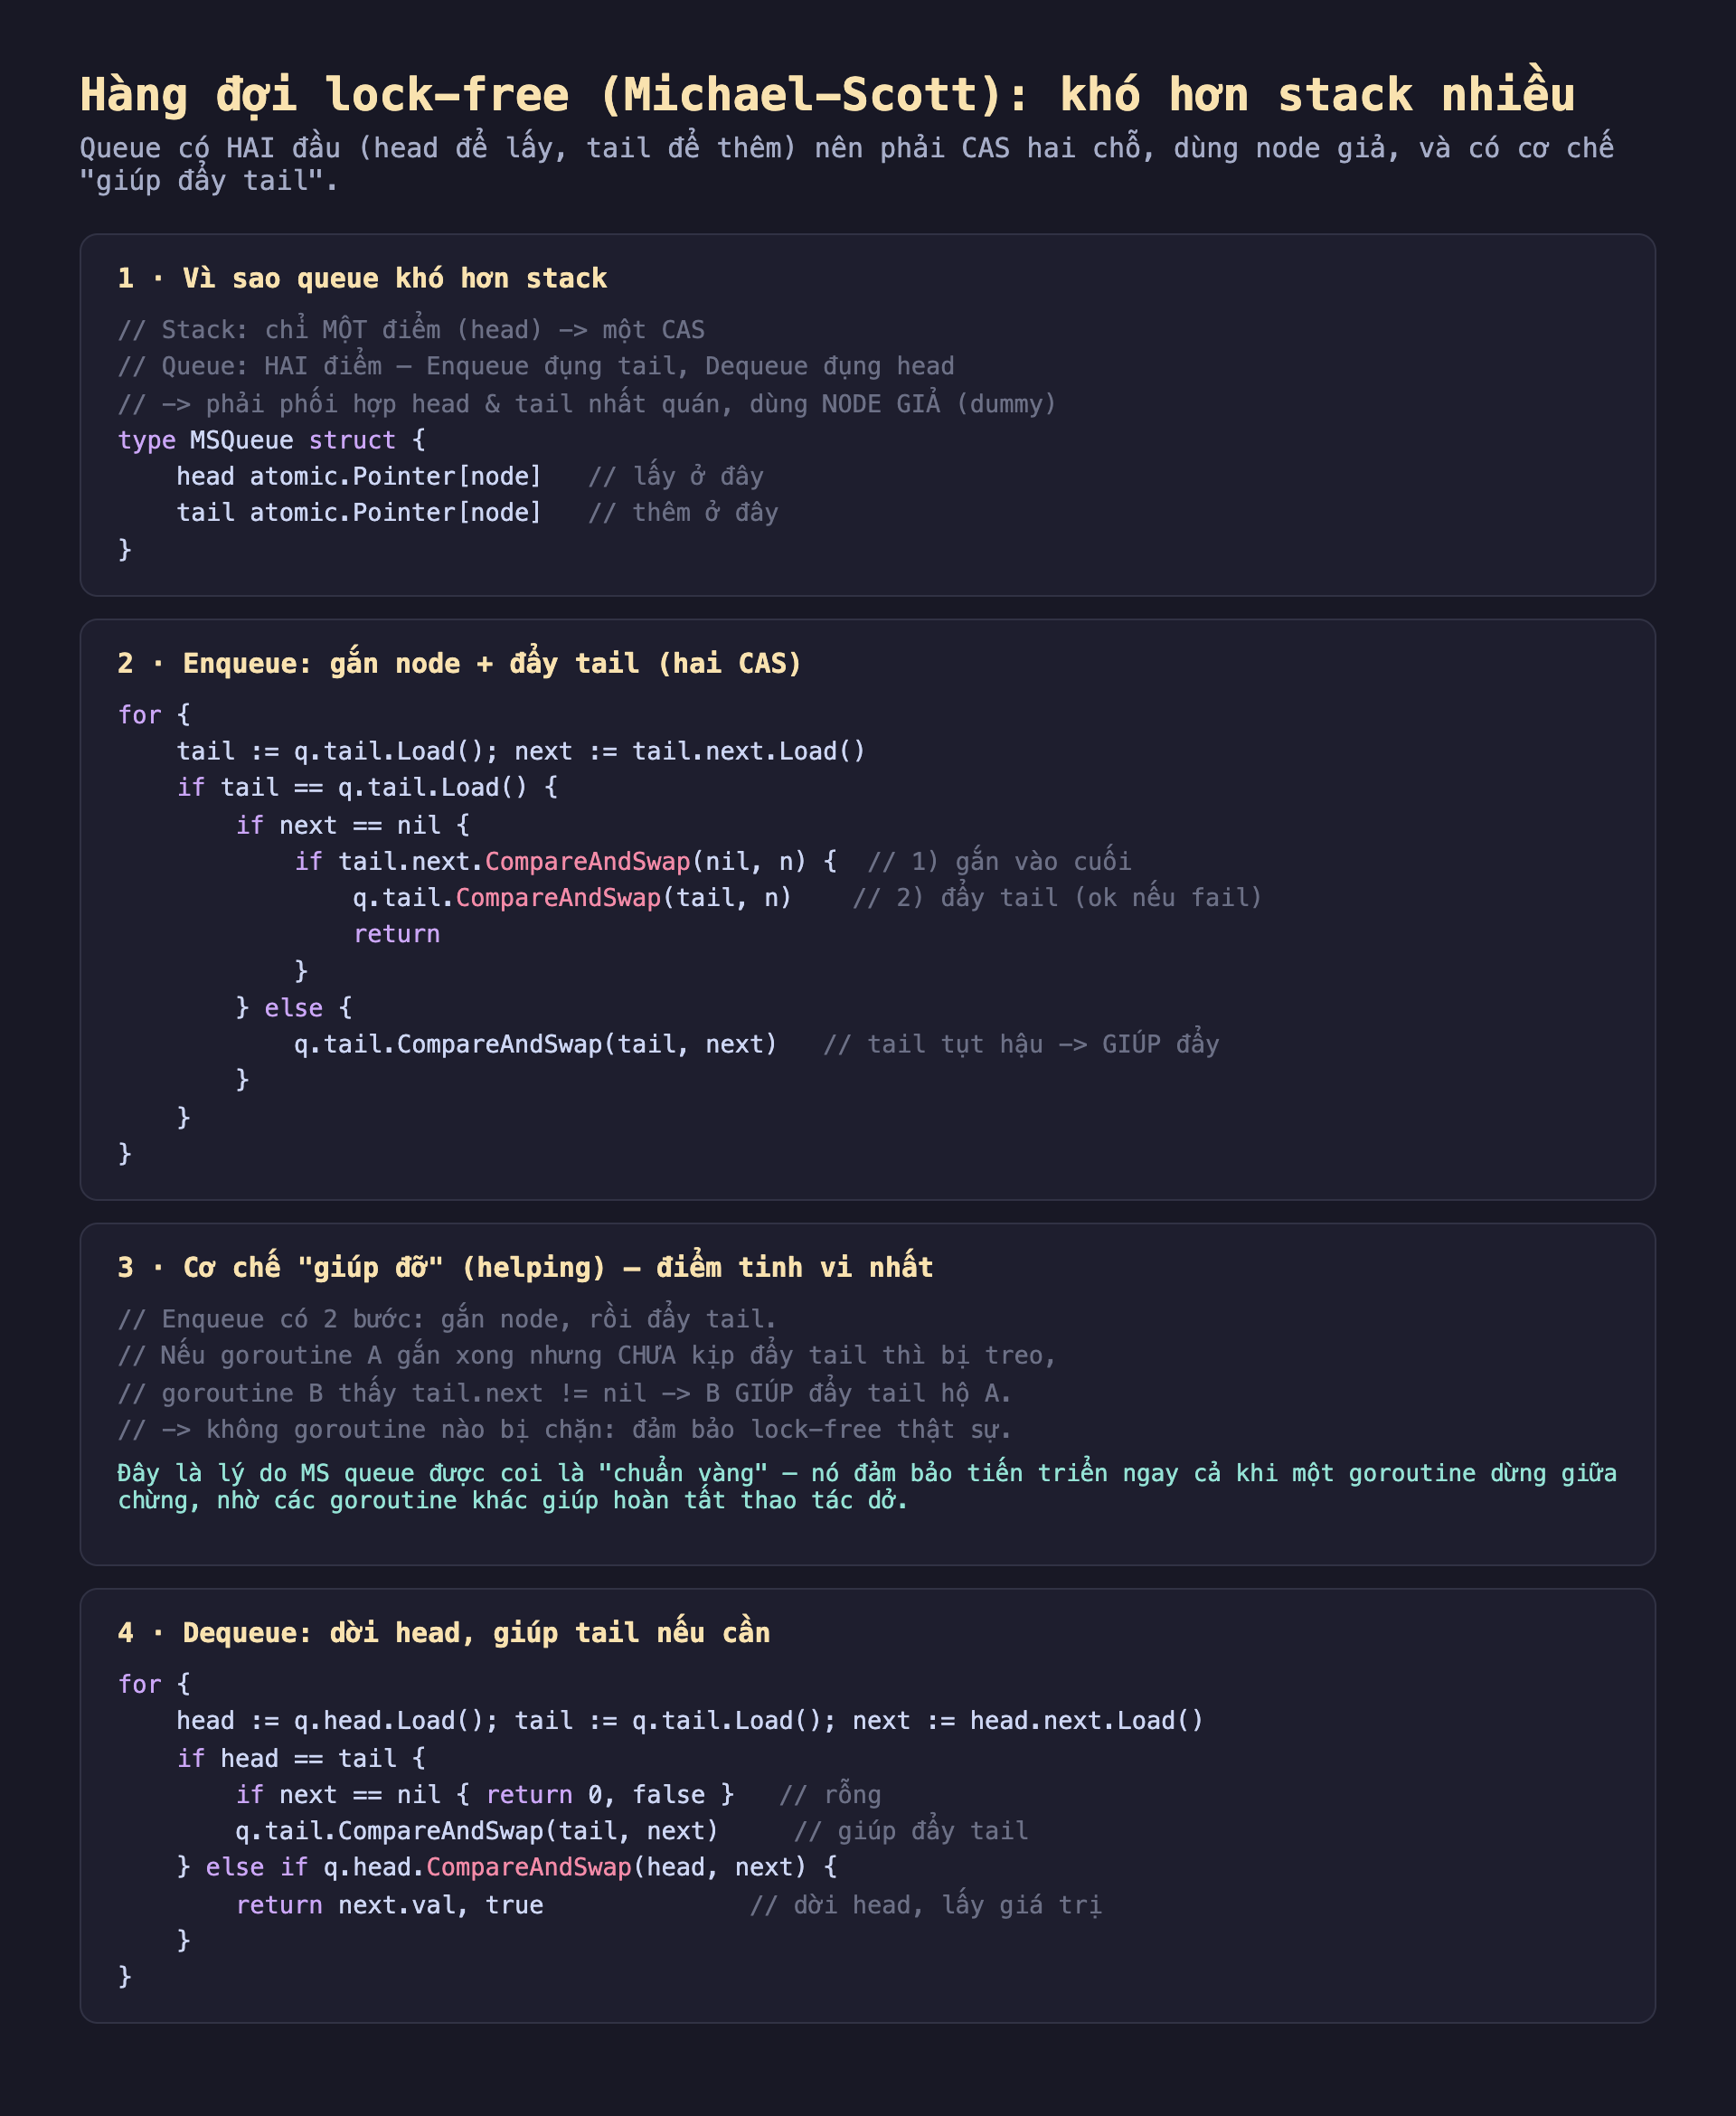
Hình 1: Michael-Scott queue. head/tail riêng, node giả, Enqueue hai CAS, và cơ chế "giúp đỡ" — goroutine khác giúp hoàn tất thao tác dở của goroutine bị treo.
Cơ chế "giúp đỡ": điểm tinh vi nhất
Enqueue có hai bước: gắn node mới vào tail.next, rồi đẩy tail trỏ tới node mới. Nếu goroutine A làm xong bước 1 nhưng bị treo trước bước 2, tail sẽ tụt hậu (chưa trỏ node cuối cùng). Michael-Scott giải quyết bằng helping:
} else {
	q.tail.CompareAndSwap(tail, next)   // tail tụt hậu → GIÚP đẩy hộ
}
Bất kỳ goroutine nào thấy tail.next != nil (tức tail tụt hậu) sẽ giúp đẩy tail hộ goroutine đang treo, rồi mới làm việc của mình. Nhờ vậy không goroutine nào bị chặn bởi một goroutine khác dừng giữa chừng — đây chính là điều làm nó thật sự lock-free (đảm bảo tiến triển), và là lý do MS queue được coi là "chuẩn vàng".
Đo thật: đúng đắn, nhưng chậm hơn channel
Kiểm đúng: 8 goroutine cùng enqueue 1000 phần tử, rồi dequeue hết:
enqueue 8 goroutine x 1000 = 8000;  dequeue được: 8000
go run -race:  SẠCH
Đủ 8000, FIFO bảo toàn, -race sạch — kể cả khi goroutine dừng giữa hai bước enqueue (nhờ helping). Nhưng hiệu năng dưới tranh chấp:
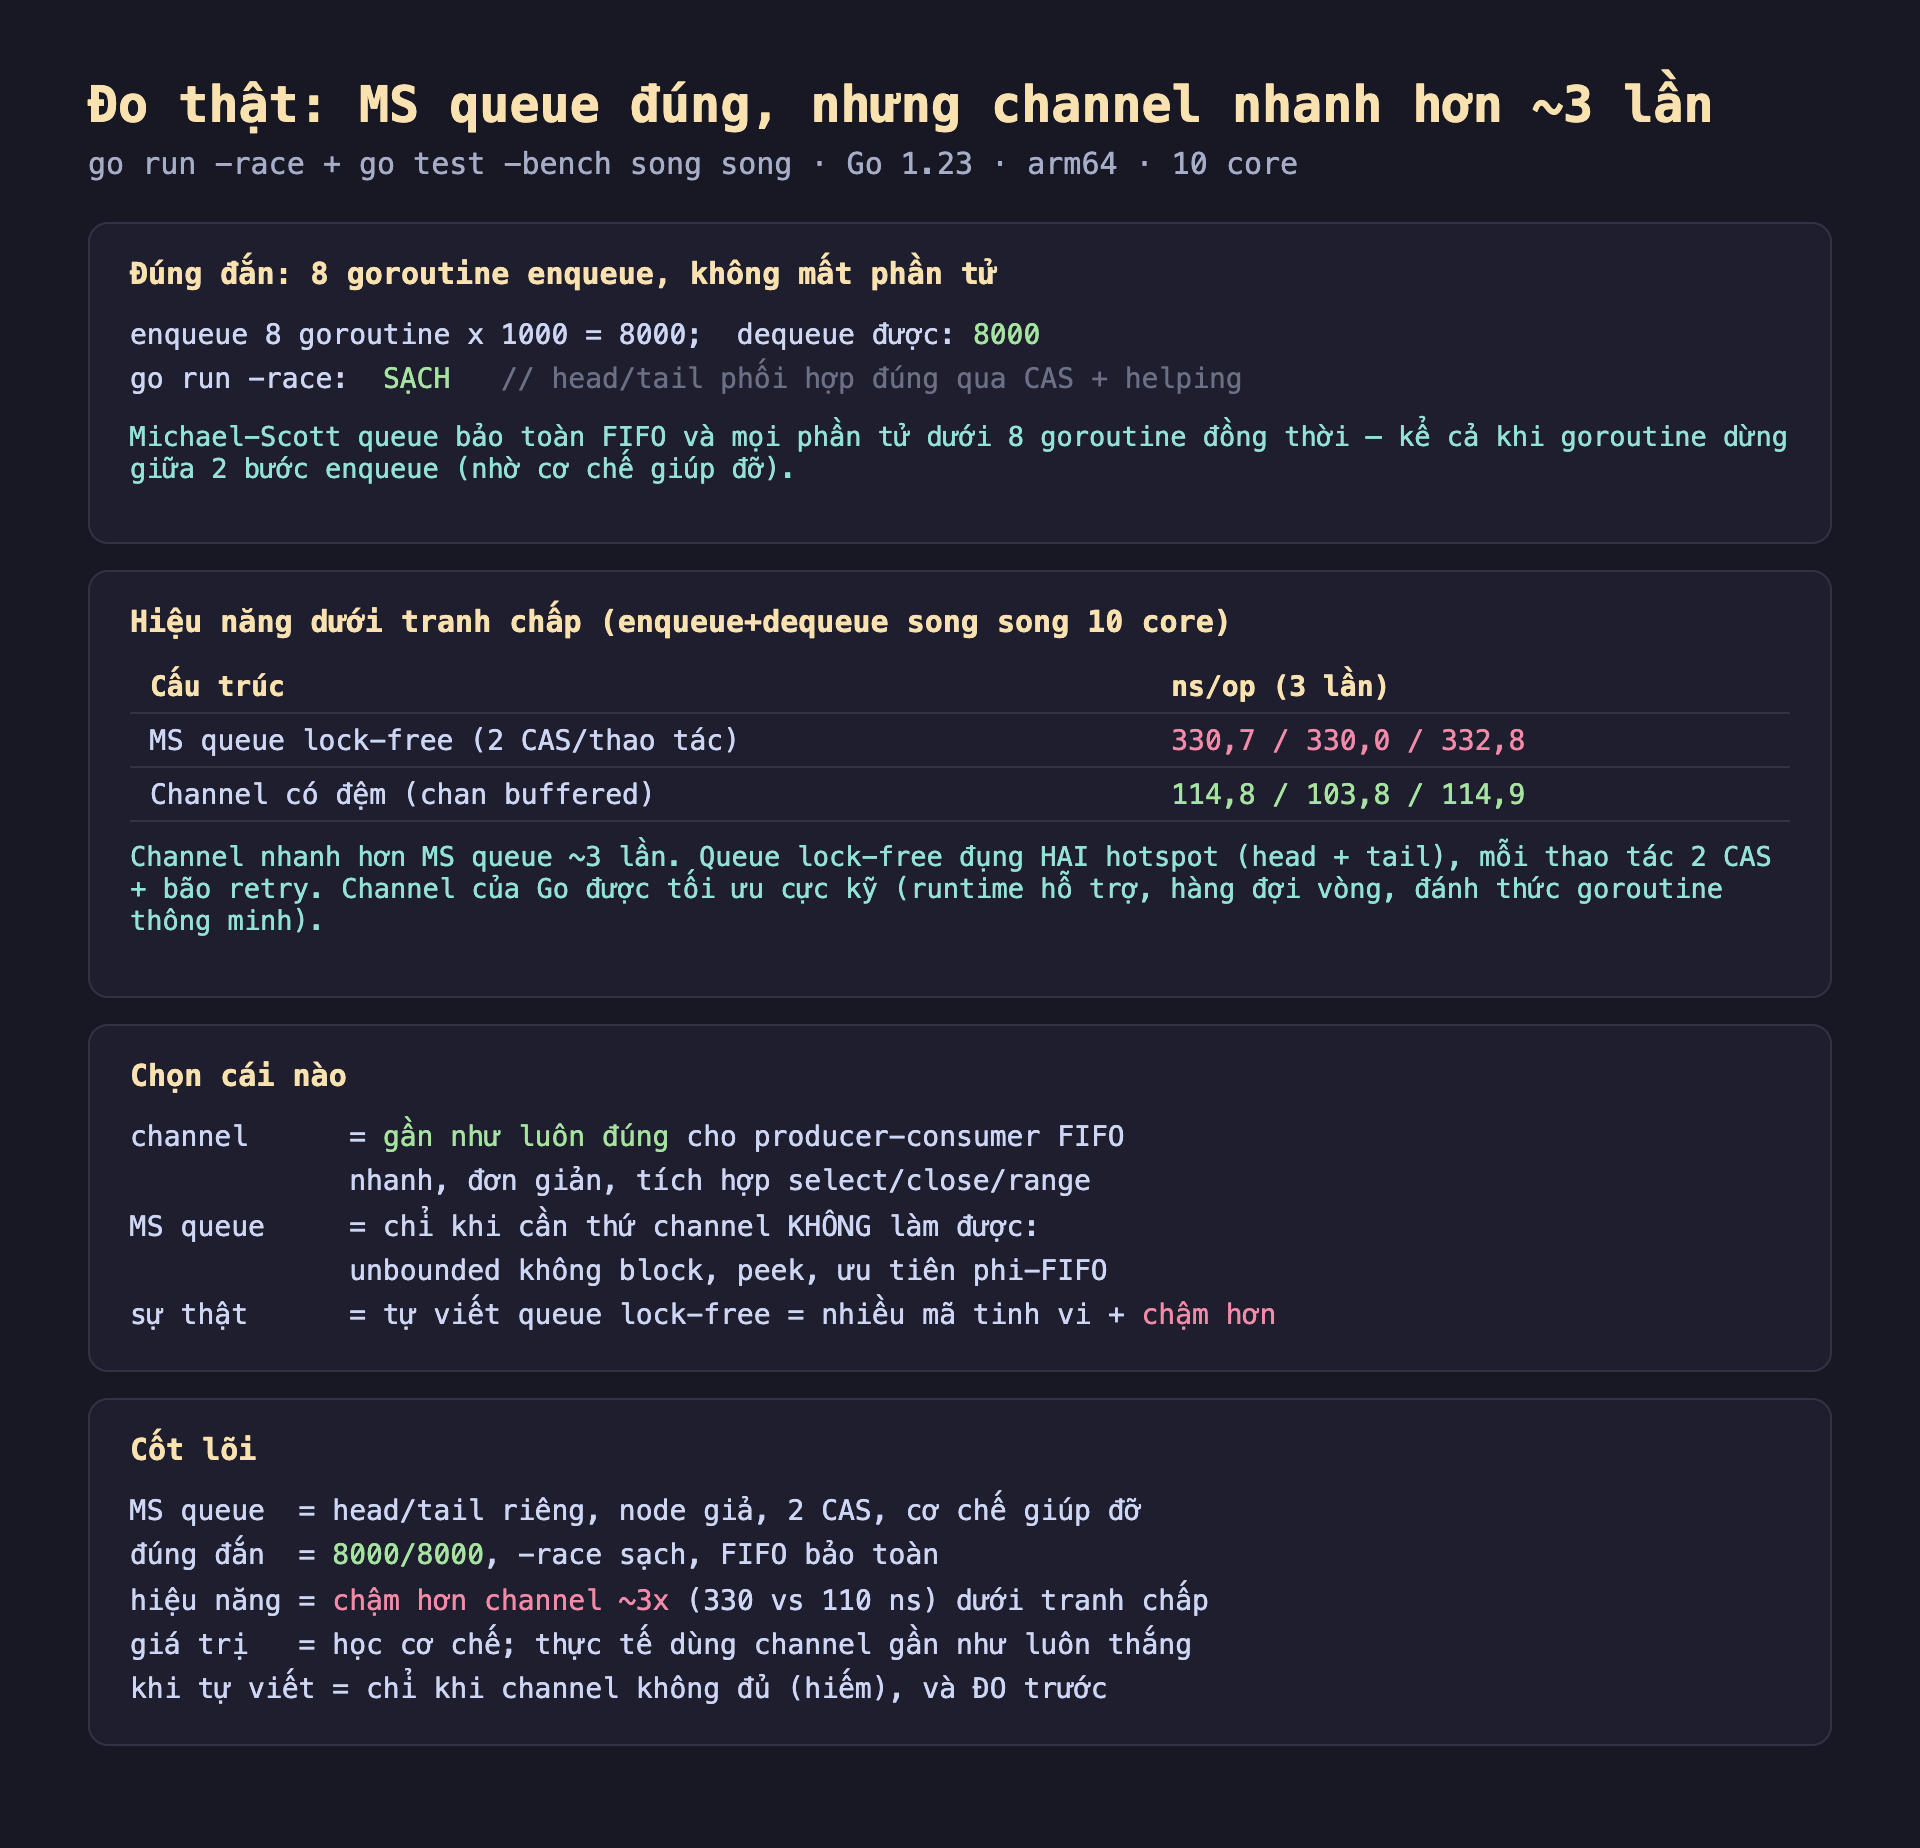
Hình 2: Đúng đắn (8000/8000, FIFO, -race sạch). Hiệu năng: MS queue ~330 ns so với channel ~110 ns — channel nhanh hơn ~3 lần. Bảng chọn channel vs MS queue.
- MS queue lock-free: 330,7 / 330,0 / 332,8 ns/op.
- Channel có đệm: 114,8 / 103,8 / 114,9 ns/op.
Channel nhanh hơn MS queue ~3 lần dưới tranh chấp. Lý do tương tự stack nhưng nặng hơn: queue lock-free đụng hai hotspot (head và tail), mỗi thao tác cần 2 CAS cộng bão retry. Trong khi channel của Go được tối ưu cực kỹ ở tầng runtime — hàng đợi vòng (ring buffer), đánh thức goroutine thông minh, tích hợp scheduler.
Ứng dụng thực tế
Channel là câu trả lời cho gần như mọi producer-consumer FIFO. Nhanh, đơn giản, và tích hợp select, close, range. Trước khi nghĩ tới bất kỳ hàng đợi tự viết nào, hãy dùng channel — nó gần như luôn đúng và luôn đủ nhanh. "Đừng giao tiếp bằng chia sẻ bộ nhớ, hãy chia sẻ bộ nhớ bằng giao tiếp" — channel hiện thực triết lý này.
Chỉ tự viết queue lock-free khi channel không làm được. Vài trường hợp channel không phủ: hàng đợi unbounded không bao giờ block (channel có đệm cố định, đầy thì block/drop), hoặc cần peek (xem phần tử đầu không lấy ra), hoặc thứ tự phi-FIFO (ưu tiên). Đây là những lý do hiếm; nếu gặp, cân nhắc thư viện đã kiểm chứng trước khi tự viết.
MS queue là kiến thức nền quý, dù ít dùng trực tiếp. Hiểu cơ chế helping và cách phối hợp head/tail giúp bạn đọc được code lock-free của người khác (runtime Go, thư viện hiệu năng cao) và suy luận đúng về đồng thời. Học nó để hiểu, không nhất thiết để viết.
Đánh đổi cần cân nhắc
Độ phức tạp của queue lock-free rất cao so với lợi ích. MS queue có nhiều trường hợp tinh vi (node giả, helping, kiểm tra tail chưa đổi hai lần) mà một lỗi nhỏ gây bug đồng thời cực khó tìm. So với make(chan T, n) một dòng, chi phí bảo trì không đáng trừ khi có lý do rất cụ thể. Đơn giản là một tính năng.
Node-per-element gây áp lực cấp phát và GC. Mỗi Enqueue cấp một node mới; queue rỗng vẫn giữ node giả. Với throughput cao, đây là nguồn rác đáng kể (channel dùng ring buffer cấp phát một lần). Nếu tự viết, cân nhắc pool node — nhưng điều đó lại mở ra vấn đề ABA đã bàn ở bài trước.
Đo trên mẫu tải thật. Như cả stack lẫn queue cho thấy, "lock-free nhanh hơn" là niềm tin sai cho tranh chấp cao một hotspot. Nếu bạn đang cân nhắc lock-free vì hiệu năng, hãy đo channel/mutex trước — chúng thường thắng và đơn giản hơn nhiều. Chỉ khi đo chứng minh chúng là nút thắt và không có cách giảm tranh chấp (sharding), mới tính tới lock-free.
Ba ý mang về
- Hàng đợi lock-free khó hơn stack vì có hai điểm truy cập: Michael-Scott queue dùng head/tail riêng, node giả, và cập nhật hai bước (gắn node rồi đẩy tail) với cơ chế helping — goroutine khác giúp đẩy tail hộ goroutine treo giữa chừng, đảm bảo tiến triển thật sự; đo thật đúng đắn 8000/8000 phần tử, FIFO,
-racesạch. - Channel vẫn nhanh hơn MS queue lock-free ~3 lần dưới tranh chấp: đo thật 330 ns so với 110 ns — queue lock-free đụng hai hotspot (head + tail), mỗi thao tác 2 CAS + bão retry, trong khi channel được tối ưu cực kỹ ở tầng runtime (ring buffer, đánh thức thông minh).
- Dùng channel cho gần như mọi producer-consumer FIFO: nhanh, đơn giản, tích hợp select/close/range — chỉ tự viết queue lock-free khi cần thứ channel không làm được (unbounded không block, peek, ưu tiên phi-FIFO), và luôn đo trước; MS queue là kiến thức nền quý để hiểu code lock-free, không phải để viết hằng ngày.
Bài tập làm thử
Bài 1 (đọc hiểu — so sánh khái niệm). Nêu ba lý do cụ thể (theo bài viết) khiến hàng đợi (queue) lock-free khó xây hơn hẳn stack lock-free.
Đáp án
(1) Hai điểm truy cập thay vì một: Enqueue thao tác trên tail, Dequeue thao tác trên head — phải giữ hai con trỏ nhất quán với nhau, trong khi stack chỉ cần CAS một con trỏ head duy nhất. (2) Cần node giả (dummy): queue phải bắt đầu với một node rỗng để head và tail luôn trỏ tới một node hợp lệ, tránh phải xử lý trường hợp đặc biệt khi hàng đợi rỗng. (3) Cập nhật hai bước: thêm một phần tử cần hai thao tác riêng biệt (gắn node vào cuối danh sách liên kết, rồi mới đẩy con trỏ tail tới node đó) — và giữa hai bước này có thể bị một goroutine khác chen vào, đòi hỏi cơ chế xử lý riêng (helping).
Bài 2 (đọc hiểu cơ chế cốt lõi — helping). Giải thích chính xác vấn đề gì xảy ra nếu một goroutine A đã gắn node mới vào tail.next (bước 1 của Enqueue) nhưng bị hệ điều hành treo/lấy CPU trước khi kịp đẩy tail (bước 2), và cơ chế "helping" của Michael-Scott queue giải quyết nó thế nào.
Đáp án
Vấn đề: tail bị "tụt hậu" — nó vẫn trỏ tới node cũ, chưa trỏ tới node mới nhất mà A vừa gắn vào. Nếu không có xử lý gì thêm, các goroutine khác thao tác dựa trên tail sẽ dùng thông tin lỗi thời, và nếu A bị treo lâu (hoặc chết hẳn), hệ thống có thể bị kẹt chờ A hoàn tất — vi phạm tính chất lock-free (không ai được phép chặn ai). Cơ chế helping giải quyết: bất kỳ goroutine nào khác nhìn thấy tail.next != nil (dấu hiệu tail đang tụt hậu) sẽ tự mình gọi CompareAndSwap để đẩy tail tiến lên node đó — "giúp" hoàn tất bước 2 hộ goroutine A, trước khi thực hiện thao tác riêng của mình. Nhờ vậy không goroutine nào bị chặn vô thời hạn chỉ vì một goroutine khác dừng giữa chừng — đây chính là điều đảm bảo tiến triển thật sự (true lock-freedom).
Bài 3 (đọc hiểu số liệu). Bài đo dưới tranh chấp cao (enqueue+dequeue song song 10 core): MS queue lock-free ~330 ns/op, channel có đệm ~110 ns/op — channel nhanh hơn ~3 lần. Giải thích lý do, so sánh với trường hợp stack lock-free ở bài trước (chậm hơn mutex ~3,5 lần) — điểm nào nặng hơn ở đây.
Đáp án
Lý do tương tự stack (bão retry do CAS thất bại dưới tranh chấp cao) nhưng nặng hơn: MS queue có hai hotspot bị tranh chấp (cả head lẫn tail), và mỗi thao tác Enqueue/Dequeue cần hai lần CAS thay vì một — nhân đôi cơ hội thất bại và làm lại. Trong khi đó, channel có đệm của Go được tối ưu cực kỹ ở tầng runtime: dùng cấu trúc hàng đợi vòng (ring buffer) và cơ chế đánh thức goroutine thông minh tích hợp sẵn với scheduler, nên hiệu năng vượt trội hơn một cấu trúc lock-free tự viết ngay cả khi cấu trúc đó (MS queue) là thuật toán "chuẩn vàng" trong tài liệu học thuật.
Bài 4 (vận dụng thực tế). Một lập trình viên định tự viết một hàng đợi lock-free để dùng làm producer-consumer trong service của mình, với lý do "channel có đệm cố định, không linh hoạt". Dựa trên khuyến nghị của bài, khi nào việc tự viết queue lock-free mới thực sự hợp lý? Liệt kê các trường hợp cụ thể được nêu.
Đáp án
Bài viết khuyến nghị channel gần như luôn là câu trả lời đúng cho producer-consumer FIFO — chỉ nên cân nhắc tự viết (hoặc tìm thư viện đã kiểm chứng) khi gặp đúng những nhu cầu mà channel không đáp ứng được: (1) cần hàng đợi unbounded và không bao giờ block (channel có đệm cố định, khi đầy sẽ block hoặc phải drop); (2) cần peek — xem phần tử đầu hàng đợi mà không lấy nó ra (channel không hỗ trợ); (3) cần thứ tự phi-FIFO, ví dụ hàng đợi có ưu tiên. Đây là những nhu cầu hiếm; ngay cả khi gặp, bài khuyến nghị tìm thư viện đã kiểm chứng trước khi tự viết, vì độ phức tạp và rủi ro lỗi tinh vi của lock-free rất cao so với lợi ích.
Bài 5 (bẫy/đánh đổi). Nêu hai chi phí "ẩn" của Michael-Scott queue mà bài viết chỉ ra, ngoài việc nó chậm hơn channel dưới tranh chấp.
Đáp án
Chi phí 1 — độ phức tạp cực cao so với lợi ích: MS queue có nhiều trường hợp tinh vi (node giả, cơ chế helping, kiểm tra tail chưa đổi tới hai lần trong vòng lặp) mà chỉ một lỗi nhỏ có thể gây ra bug đồng thời cực khó tìm và tái hiện — so với một dòng make(chan T, n) đơn giản, chi phí bảo trì này thường không xứng đáng trừ khi có lý do rất cụ thể. Chi phí 2 — áp lực cấp phát và garbage collector: mỗi lần Enqueue cấp phát một node mới trên heap, và ngay cả khi hàng đợi rỗng vẫn phải giữ một node giả — với throughput cao, đây là nguồn tạo rác đáng kể, trong khi channel dùng ring buffer cấp phát một lần duy nhất. Nếu định khắc phục bằng cách pool lại node, điều đó lại mở ra nguy cơ vấn đề ABA đã bàn ở bài trước.
Phần sau ta xem một cấu trúc đồng thời của thư viện chuẩn được tối ưu sẵn: Phần sau mổ xẻ sync.Map — cấu trúc read/dirty hai tầng bên trong, khi nào nó thắng map+mutex, và vì sao nó không phải "map nhanh hơn" cho mọi trường hợp.
