Bài trước ta gặp CompareAndSwap như "nền tảng lock-free". Bài này ta thực sự xây một cấu trúc lock-free — một stack — bằng vòng lặp CAS, kiểm tra nó đúng, và đo hiệu năng. Kết quả gây bất ngờ và là một trong những sự thật quan trọng nhất về lập trình đồng thời: lock-free không tự động nhanh hơn. Dưới tranh chấp cao, stack lock-free này còn chậm hơn một mutex thường tới 3,5 lần. Bài này chỉ cách xây, và giải thích trung thực khi nào lock-free thực sự đáng.
Xây stack lock-free bằng vòng lặp CAS
Ý tưởng: thay vì khóa, mỗi thao tác đọc trạng thái hiện tại, tính trạng thái mới, rồi dùng CAS để cập nhật chỉ nếu trạng thái chưa đổi. Nếu CAS thất bại (ai đó chen vào giữa), thử lại.
func (s *Stack) Push(v int) {
	n := &node{val: v}
	for {
		old := s.head.Load()      // đọc head hiện tại
		n.next = old              // node mới trỏ tới head cũ
		if s.head.CompareAndSwap(old, n) {
			return                // đổi thành công
		}
		// CAS thất bại: ai đó đã đổi head → thử lại vòng mới
	}
}
Pop theo cùng mẫu: đọc head, tính head mới (old.next), CAS. CompareAndSwap(old, moi) là một lệnh CPU nguyên tử: nếu head vẫn là old thì đặt thành moi và trả true; ngược lại trả false (báo có người chen vào).
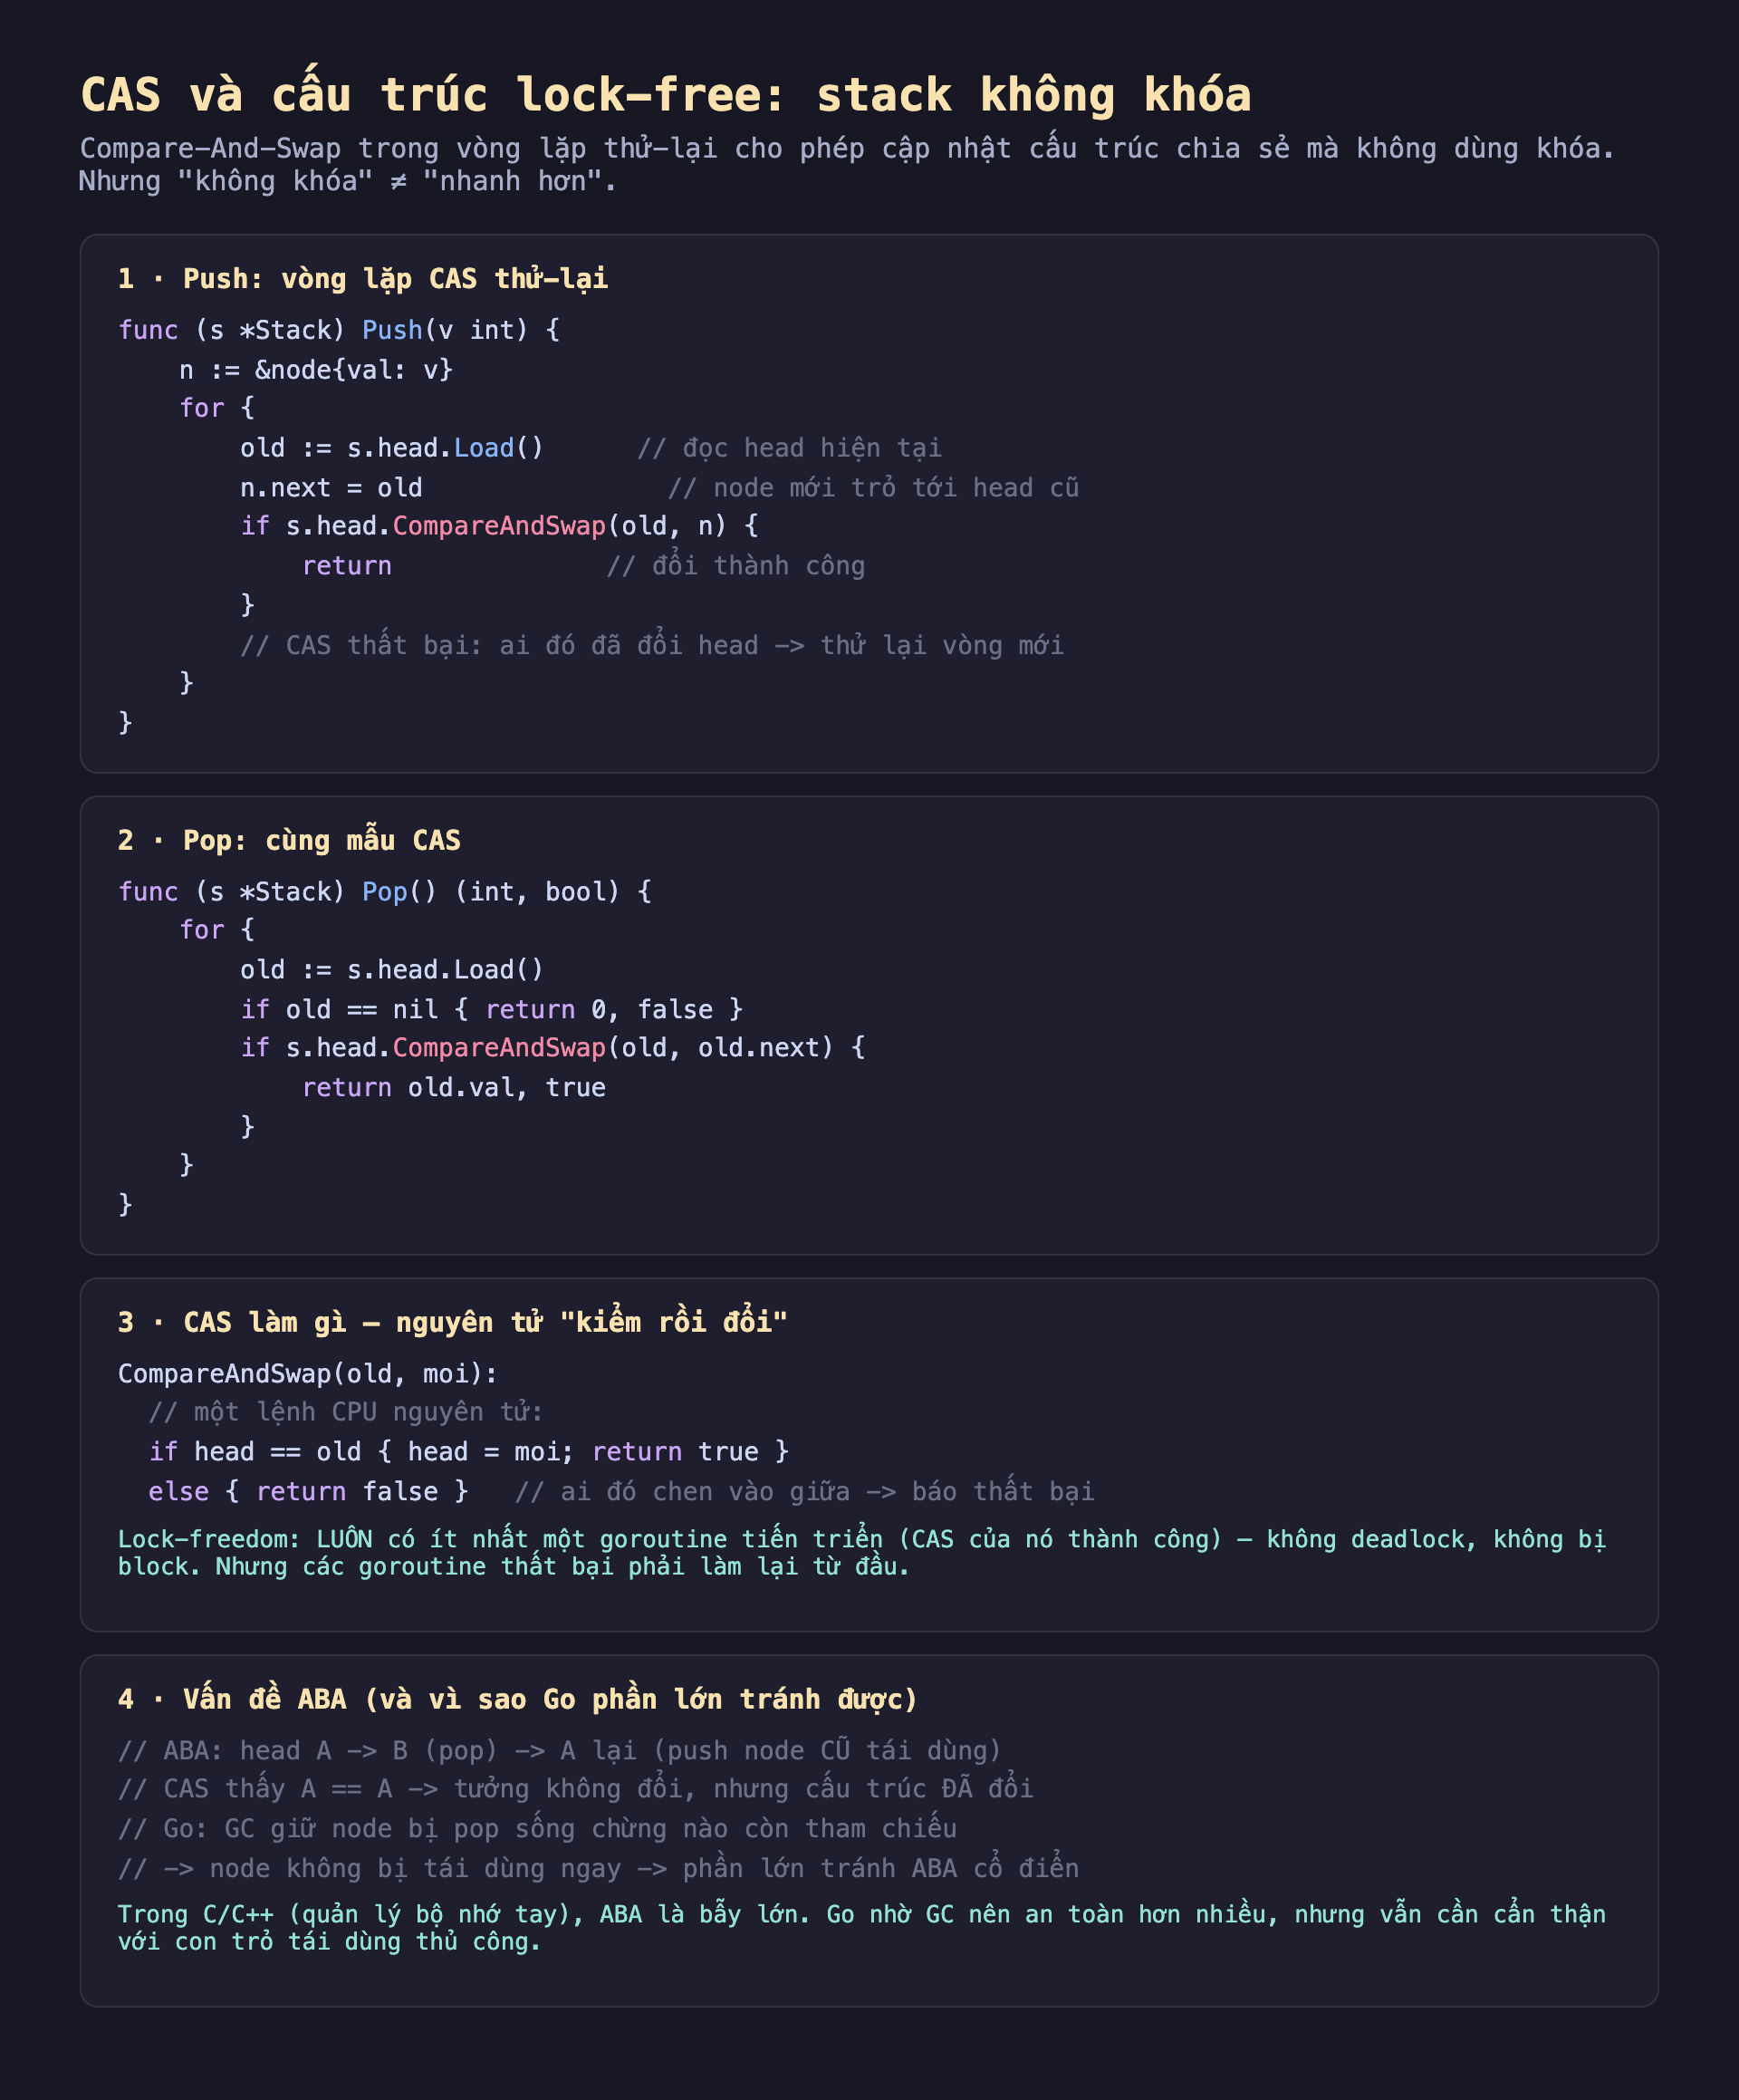
Hình 1: Vòng lặp CAS cho Push/Pop. CAS là "kiểm rồi đổi" nguyên tử; lock-freedom đảm bảo luôn có goroutine tiến triển; và vấn đề ABA mà Go phần lớn tránh nhờ GC.
Đo thật: đúng đắn, nhưng chậm hơn mutex
Kiểm đúng đắn trước: 10 goroutine cùng push 1000 phần tử, rồi pop hết:
push 10 goroutine x 1000 = 10000;  pop được: 10000
go run -race:  SẠCH (không data race)
Đủ 10000 phần tử, không mất cái nào, và -race sạch — vòng lặp CAS đúng đắn. Nhưng hiệu năng dưới tranh chấp cao (push+pop song song 10 core) mới là phần bất ngờ:
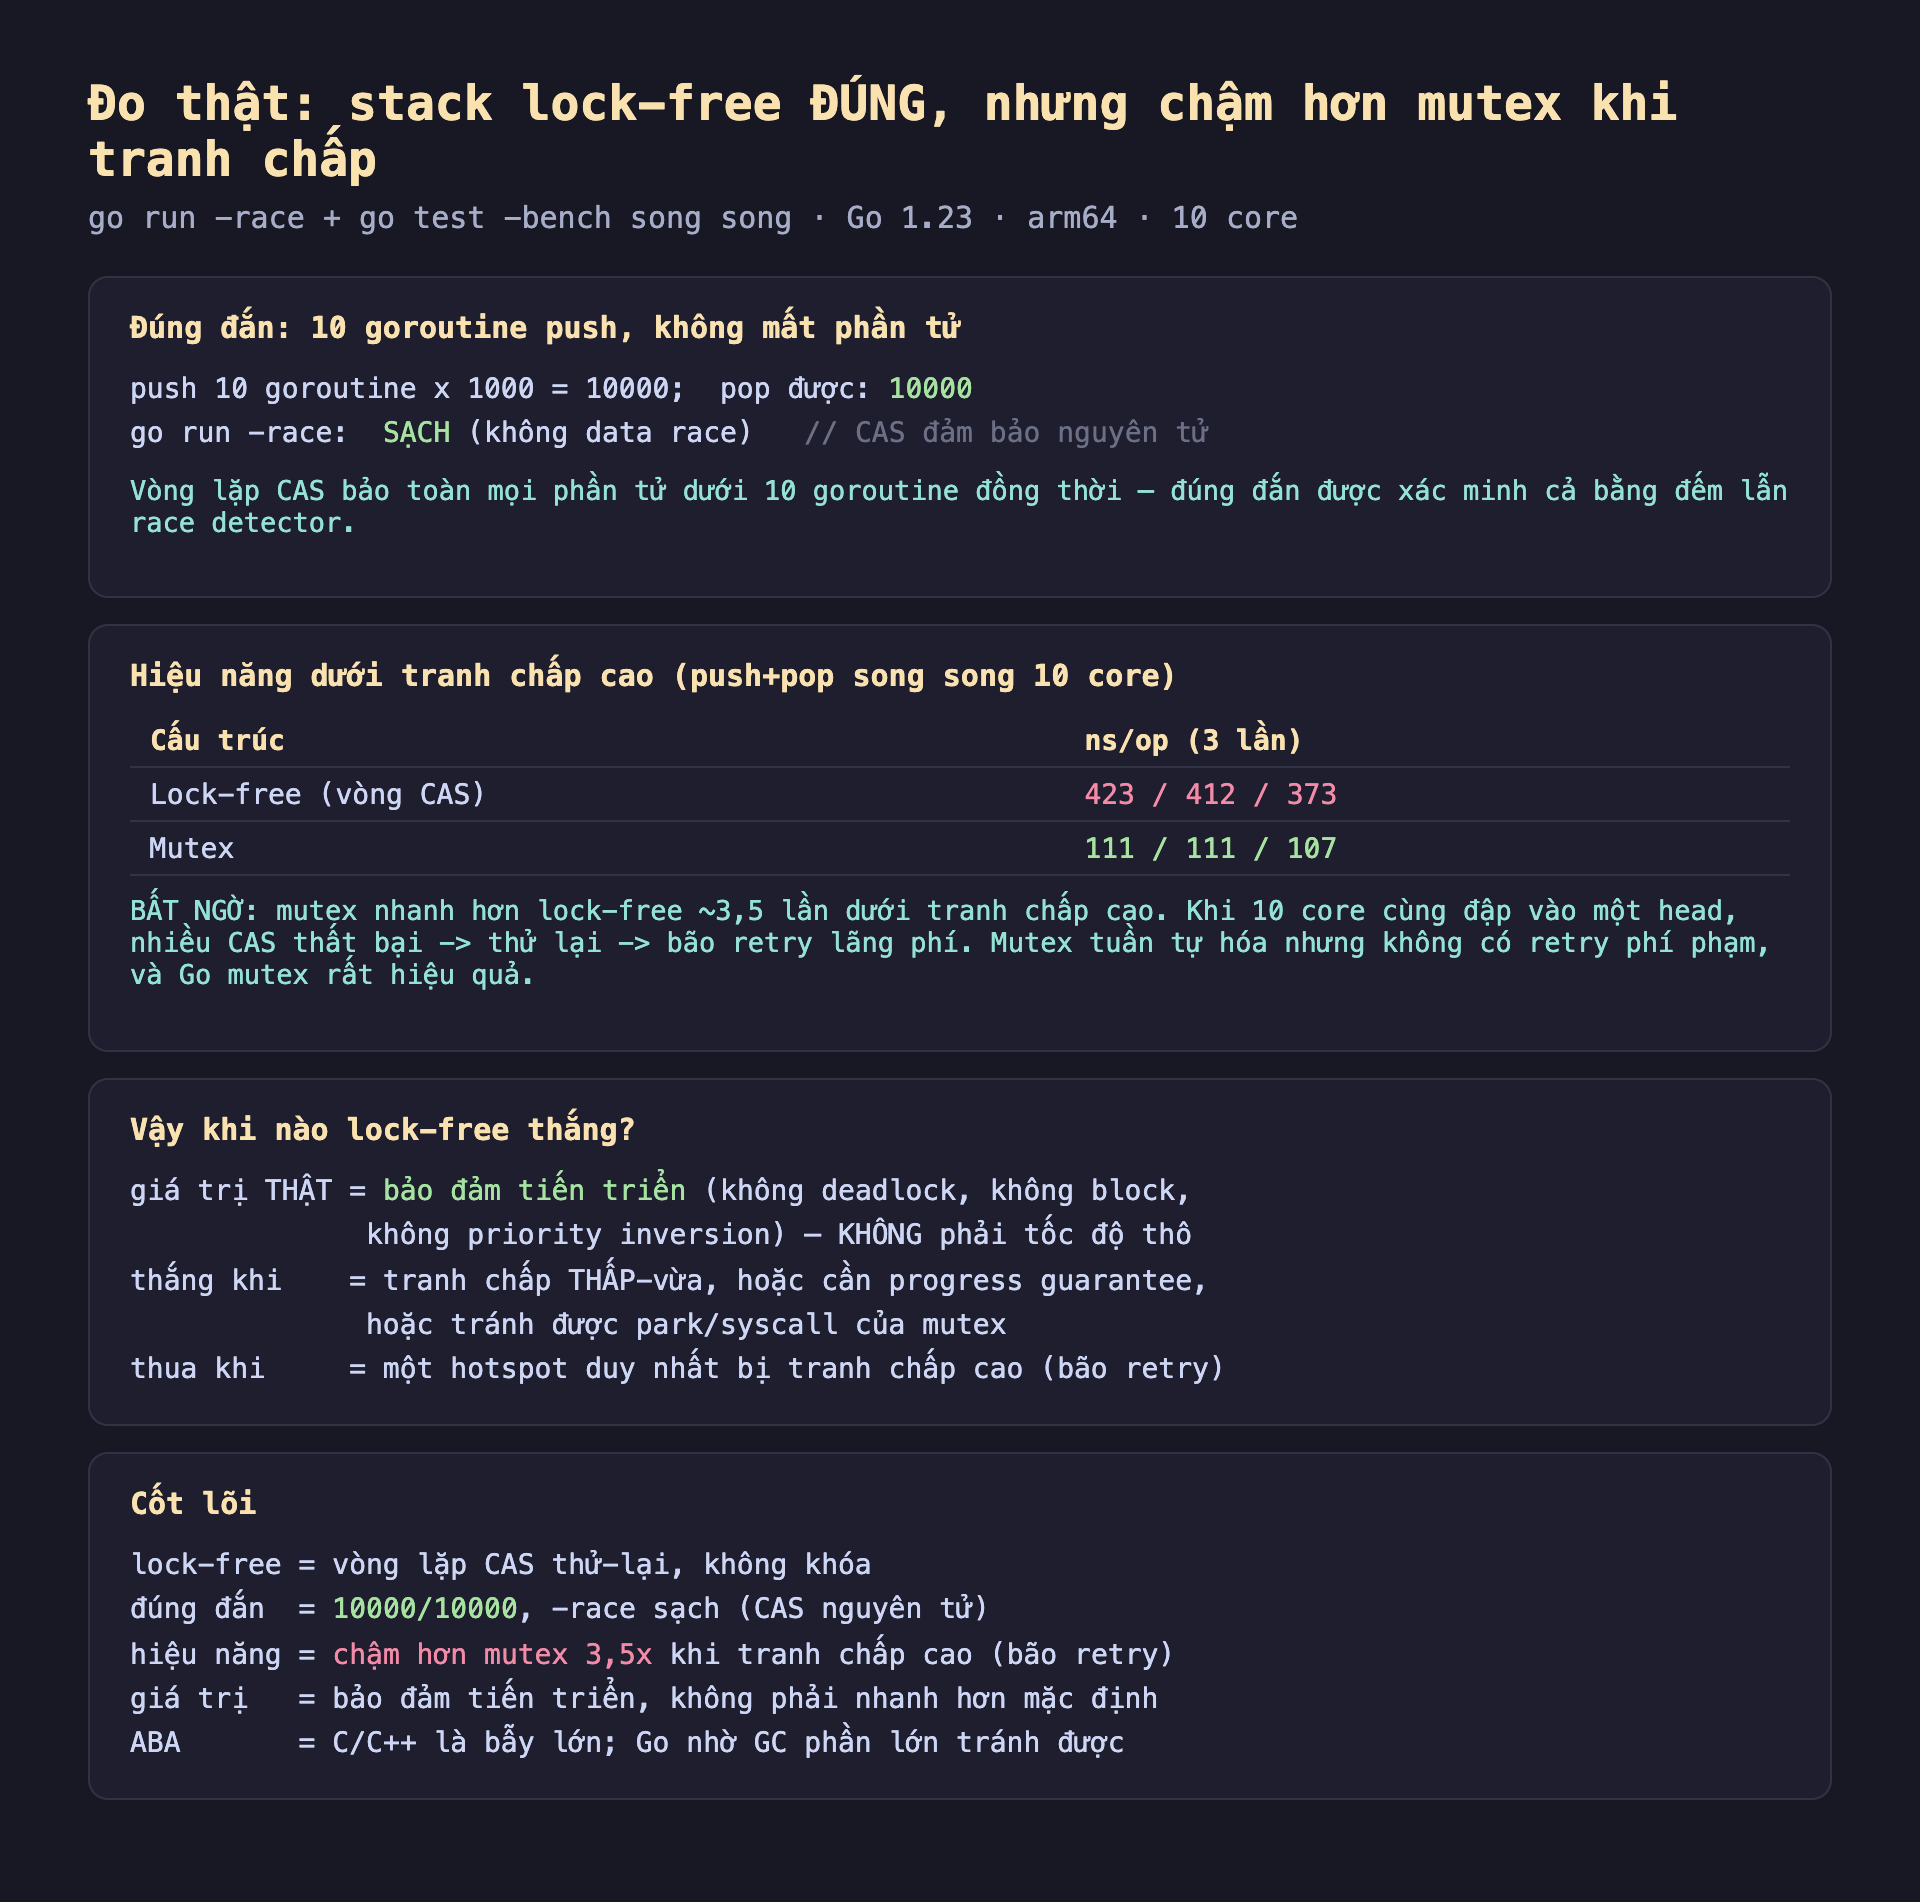
Hình 2: Đúng đắn (10000/10000, -race sạch). Hiệu năng: lock-free ~373-423 ns so với mutex ~107-111 ns — mutex nhanh hơn ~3,5 lần dưới tranh chấp cao. Bảng "khi nào lock-free thắng".
- Lock-free (vòng CAS): 423 / 412 / 373 ns/op.
- Mutex: 111 / 111 / 107 ns/op.
Mutex nhanh hơn lock-free ~3,5 lần dưới tranh chấp cao. Vì sao? Khi 10 core cùng đập vào một con trỏ head, rất nhiều CAS thất bại — mỗi lần thất bại phải làm lại cả vòng lặp (đọc lại head, dựng lại, CAS lại). Đây là bão retry: công sức lãng phí tăng theo mức tranh chấp. Mutex thì tuần tự hóa, nhưng một khi giữ khóa, nó làm việc không có retry phí phạm, và mutex của Go rất hiệu quả (spin ngắn rồi park).
Vậy khi nào lock-free thực sự thắng?
Giá trị thật của lock-free không phải tốc độ thô mà là bảo đảm tiến triển (progress guarantee): luôn có ít nhất một goroutine tiến lên, không bao giờ deadlock, không bị block vô hạn, không priority inversion (goroutine ưu tiên thấp giữ khóa chặn goroutine ưu tiên cao). Lock-free thắng khi:
- Tranh chấp thấp tới vừa: ít CAS thất bại nên ít retry, và tránh được chi phí park/unpark của mutex.
- Cần đảm bảo tiến triển: hệ thống thời gian thực, hoặc nơi một goroutine bị treo không được phép chặn cả hệ thống.
- Tránh syscall của mutex: khi mutex phải park goroutine (chờ lâu), lock-free tránh được chi phí đó.
Lock-free thua khi có một hotspot duy nhất bị tranh chấp rất cao — đúng như benchmark này.
Ứng dụng thực tế
Đừng viết lock-free để "nhanh hơn". Nếu mục tiêu chỉ là tốc độ dưới tranh chấp, một mutex tốt (hoặc sharding để giảm tranh chấp) thường thắng và dễ đúng hơn nhiều. Chỉ chọn lock-free khi bạn cần thuộc tính tiến triển của nó, không phải vì nghe "không khóa thì nhanh".
Giảm tranh chấp quan trọng hơn bỏ khóa. Nếu một cấu trúc là điểm nóng, cách tốt nhất thường là chia nhỏ (sharding: nhiều stack/counter, mỗi core một cái) để giảm tranh chấp — rồi mỗi shard dùng mutex đơn giản. Điều này thắng cả lock-free lẫn mutex đơn lẻ vì loại bỏ hotspot.
Dùng thư viện chuẩn khi có. sync.Map, atomic, channel đã được tối ưu kỹ. Tự viết cấu trúc lock-free là việc dễ sai (ABA, memory ordering) và hiếm khi thắng. Chỉ tự viết khi profiler chứng minh cần và không có sẵn giải pháp.
Đánh đổi cần cân nhắc
Lock-free đúng rất khó, và Go giúp một phần. Vấn đề ABA (head đổi A→B→A, CAS tưởng không đổi nhưng cấu trúc đã đổi) là bẫy lớn trong C/C++ với quản lý bộ nhớ tay. Go nhờ GC giữ node bị pop sống chừng nào còn tham chiếu, nên phần lớn tránh được ABA cổ điển — nhưng bạn vẫn phải cẩn thận với con trỏ tái dùng thủ công và memory ordering. Đừng đánh giá thấp độ khó.
Bão retry làm hiệu năng khó dự đoán. Không như mutex (chi phí tương đối ổn định), lock-free dưới tranh chấp có hiệu năng phụ thuộc mạnh vào mức tranh chấp và may rủi lịch trình. Ở tải cao đột biến, retry có thể bùng nổ. Mutex cho hành vi dễ đoán hơn — quan trọng với hệ thống cần độ trễ ổn định.
Đo trên tải thật, không tin lý thuyết. "Lock-free nhanh hơn" là niềm tin phổ biến mà benchmark này bác bỏ cho trường hợp tranh chấp cao một hotspot. Luôn đo cấu trúc của bạn dưới mẫu tải thật — số goroutine, tỷ lệ đọc/ghi, mức tranh chấp — trước khi chọn lock-free.
Ba ý mang về
- Cấu trúc lock-free xây bằng vòng lặp CAS thử-lại: đọc trạng thái, tính mới,
CompareAndSwapchỉ đổi nếu chưa ai chen vào, thất bại thì thử lại — đo thật stack lock-free đúng đắn (10000/10000 phần tử không mất,-racesạch nhờ CAS nguyên tử). - Lock-free KHÔNG tự động nhanh hơn: đo thật dưới tranh chấp cao, stack lock-free chậm hơn mutex ~3,5 lần (373 so 107 ns) vì bão retry — mỗi CAS thất bại phải làm lại cả vòng, lãng phí tăng theo tranh chấp; mutex tuần tự hóa nhưng không retry phí phạm.
- Giá trị lock-free là bảo đảm tiến triển, không phải tốc độ: thắng khi tranh chấp thấp-vừa, cần progress guarantee (không deadlock/block/priority inversion), hoặc tránh park của mutex — nhưng để "nhanh hơn" thì giảm tranh chấp bằng sharding + mutex đơn giản thường tốt hơn; Go nhờ GC phần lớn tránh ABA nhưng lock-free đúng vẫn rất khó.
Bài tập làm thử
Bài 1 (đọc hiểu). Giải thích từng bước hoạt động của hàm Push sau, đặc biệt là ý nghĩa của việc lặp lại vòng for khi CompareAndSwap thất bại.
func (s *Stack) Push(v int) {
	n := &node{val: v}
	for {
		old := s.head.Load()
		n.next = old
		if s.head.CompareAndSwap(old, n) {
			return
		}
	}
}
Đáp án
Mỗi vòng lặp: đọc con trỏ head hiện tại (old), gán node mới trỏ tới old (chuẩn bị chèn lên đầu), rồi thử CompareAndSwap(old, n) — chỉ thành công nếu head vẫn đúng là old (chưa ai đổi). Nếu một goroutine khác đã Push hoặc Pop chen vào giữa lúc Load và CAS, head không còn bằng old nữa, CAS trả false, và vòng lặp phải bắt đầu lại: đọc head mới nhất, dựng lại n.next, thử CAS lại — cho tới khi thành công. Đây là mẫu "đọc, tính, thử đổi nguyên tử, thất bại thì lặp lại" đặc trưng của lock-free.
Bài 2 (đọc hiểu số liệu — trọng tâm bất ngờ của bài). Bài đo dưới tranh chấp cao (push+pop song song trên 10 core): stack lock-free (vòng CAS) ~373-423 ns/op, còn stack bảo vệ bằng mutex chỉ ~107-111 ns/op. Giải thích hiện tượng "mutex nhanh hơn lock-free" này, nêu đúng cơ chế gây ra nó.
Đáp án
Khi 10 core cùng liên tục thao tác trên một con trỏ head duy nhất, rất nhiều lần CompareAndSwap thất bại vì có goroutine khác vừa đổi head trước đó. Mỗi lần thất bại buộc phải làm lại toàn bộ vòng lặp (đọc lại, dựng lại, CAS lại) — đây gọi là "bão retry", và công sức lãng phí tăng theo mức độ tranh chấp. Mutex thì ngược lại: nó tuần tự hóa truy cập (chỉ một goroutine vào critical section tại một thời điểm), nhưng khi đã giữ được khóa thì làm việc dứt khoát, không có retry lãng phí nào — và cơ chế mutex của Go được cài đặt rất hiệu quả (spin ngắn rồi mới park).
Bài 3 (khái niệm — giá trị thật của lock-free). Bài viết khẳng định "giá trị của lock-free không phải là tốc độ mà là bảo đảm tiến triển (progress guarantee)". Giải thích "bảo đảm tiến triển" nghĩa là gì, và nêu ba tình huống mà lock-free thực sự thắng theo bài.
Đáp án
"Bảo đảm tiến triển" nghĩa là: luôn có ít nhất một goroutine trong hệ thống tiếp tục làm được việc (CAS của nó thành công), hệ thống không bao giờ deadlock, không bị block vô hạn, và không có priority inversion (một goroutine ưu tiên thấp giữ khóa chặn đứng goroutine ưu tiên cao) — dù các goroutine khác có thể phải thử lại. Ba tình huống lock-free thắng: (1) tranh chấp thấp tới vừa (ít CAS thất bại nên ít retry, tránh được chi phí park/unpark của mutex); (2) hệ thống cần đảm bảo tiến triển thật sự, ví dụ hệ thống thời gian thực nơi một goroutine bị treo không được phép chặn cả hệ thống; (3) muốn tránh chi phí syscall khi mutex phải park goroutine chờ lâu.
Bài 4 (vận dụng thực tế). Một đồng nghiệp gặp một stack dùng chung là điểm nóng (hotspot) tranh chấp cao trong hệ thống, và định thay bằng cấu trúc lock-free để "nhanh hơn". Dựa trên bài viết, góp ý một hướng tiếp cận khác có thể tốt hơn cả lock-free lẫn mutex đơn lẻ, và giải thích vì sao.
Đáp án
Hướng tốt hơn: sharding (chia nhỏ) — thay vì một stack duy nhất bị mọi goroutine tranh chấp, dùng nhiều stack nhỏ (ví dụ một stack cho mỗi core hoặc theo hash của goroutine/key), mỗi stack bảo vệ bằng một mutex đơn giản. Cách này giảm hẳn mức độ tranh chấp trên từng cấu trúc con — vì gốc rễ của cả vấn đề lock-free chậm lẫn mutex chậm dưới tải cao đều là quá nhiều goroutine cùng đụng vào một điểm dữ liệu. Loại bỏ hotspot bằng sharding thường thắng cả lock-free (không tốn bão retry) lẫn một mutex đơn lẻ (không phải tuần tự hóa toàn hệ thống qua một khóa), và dễ viết đúng hơn nhiều so với tự cài đặt CAS.
Bài 5 (bẫy/đánh đổi — ABA). Giải thích vấn đề ABA trong bối cảnh cấu trúc lock-free, và vì sao Go phần lớn (không hoàn toàn) tránh được nó nhờ GC.
Đáp án
Vấn đề ABA: một goroutine đọc giá trị head = A, dự định CAS để đổi nó; trong lúc đó, một goroutine khác đổi head từ A sang B rồi lại đổi về A (có thể là node A cũ bị pop ra rồi cấp phát lại/tái sử dụng và push trở lại). Khi goroutine đầu tiên thực hiện CAS, nó thấy head vẫn là A như mong đợi nên CAS "thành công" — nhưng thực chất cấu trúc bên dưới đã thay đổi hoàn toàn (node A giờ có thể có next khác), dẫn tới cập nhật sai dù CAS báo thành công. Đây là bẫy kinh điển và rất nguy hiểm trong C/C++ với quản lý bộ nhớ thủ công, vì node cũ có thể bị giải phóng rồi tái cấp phát ngay với cùng địa chỉ. Go phần lớn tránh được nhờ garbage collector: một node đã bị pop nhưng còn goroutine khác giữ tham chiếu (ví dụ đang đọc dở trong vòng CAS) sẽ được GC giữ sống, không bị tái sử dụng ngay cho một node hoàn toàn khác — khác với việc tự quản lý bộ nhớ tay nơi con trỏ có thể bị tái dùng ngay lập tức.
Phần sau ta xây một cấu trúc lock-free phức tạp hơn và hữu dụng hơn: Phần sau mổ xẻ hàng đợi lock-free (Michael-Scott queue) — vì sao queue khó hơn stack, cách xử lý cả head lẫn tail bằng CAS, và khi nào nó đáng so với channel.
