Có một mẫu cực phổ biến trong dịch vụ Go: một cấu hình (hoặc bảng định tuyến, danh sách feature flag) được đọc hàng triệu lần mỗi giây bởi nhiều goroutine, nhưng cập nhật rất hiếm. Dùng mutex để bảo vệ nó là lãng phí — mỗi lần đọc phải khóa. atomic.Pointer giải quyết đúng chỗ này: đọc một con trỏ chia sẻ nguyên tử, không khóa, và đo được nhanh hơn RWMutex tới ~870 lần. Bài này mổ xẻ cơ chế và đo thật.
atomic.Pointer: hoán đổi cả cấu hình bằng một lệnh
atomic.Pointer[T] (Go 1.19+, generic type-safe) cho phép đọc/ghi một con trỏ *T nguyên tử:
var cfg atomic.Pointer[Config]
cfg.Store(&Config{Timeout: 30})   // đặt con trỏ nguyên tử

c := cfg.Load()                   // đọc không khóa, trả *Config trực tiếp

// đổi CẢ cấu hình bằng MỘT lệnh atomic — reader thấy cũ HOẶC mới, không nửa vời
cfg.Store(&Config{Timeout: 60})
Điểm cốt lõi là tính nguyên tử của con trỏ: reader luôn nhận một Config nhất quán — hoặc con trỏ cũ (trỏ struct cũ trọn vẹn) hoặc con trỏ mới (struct mới trọn vẹn), không bao giờ thấy một struct đang sửa dở. Đây là mẫu copy-on-write: muốn đổi, tạo một Config mới hoàn chỉnh rồi Store con trỏ mới trong một thao tác.
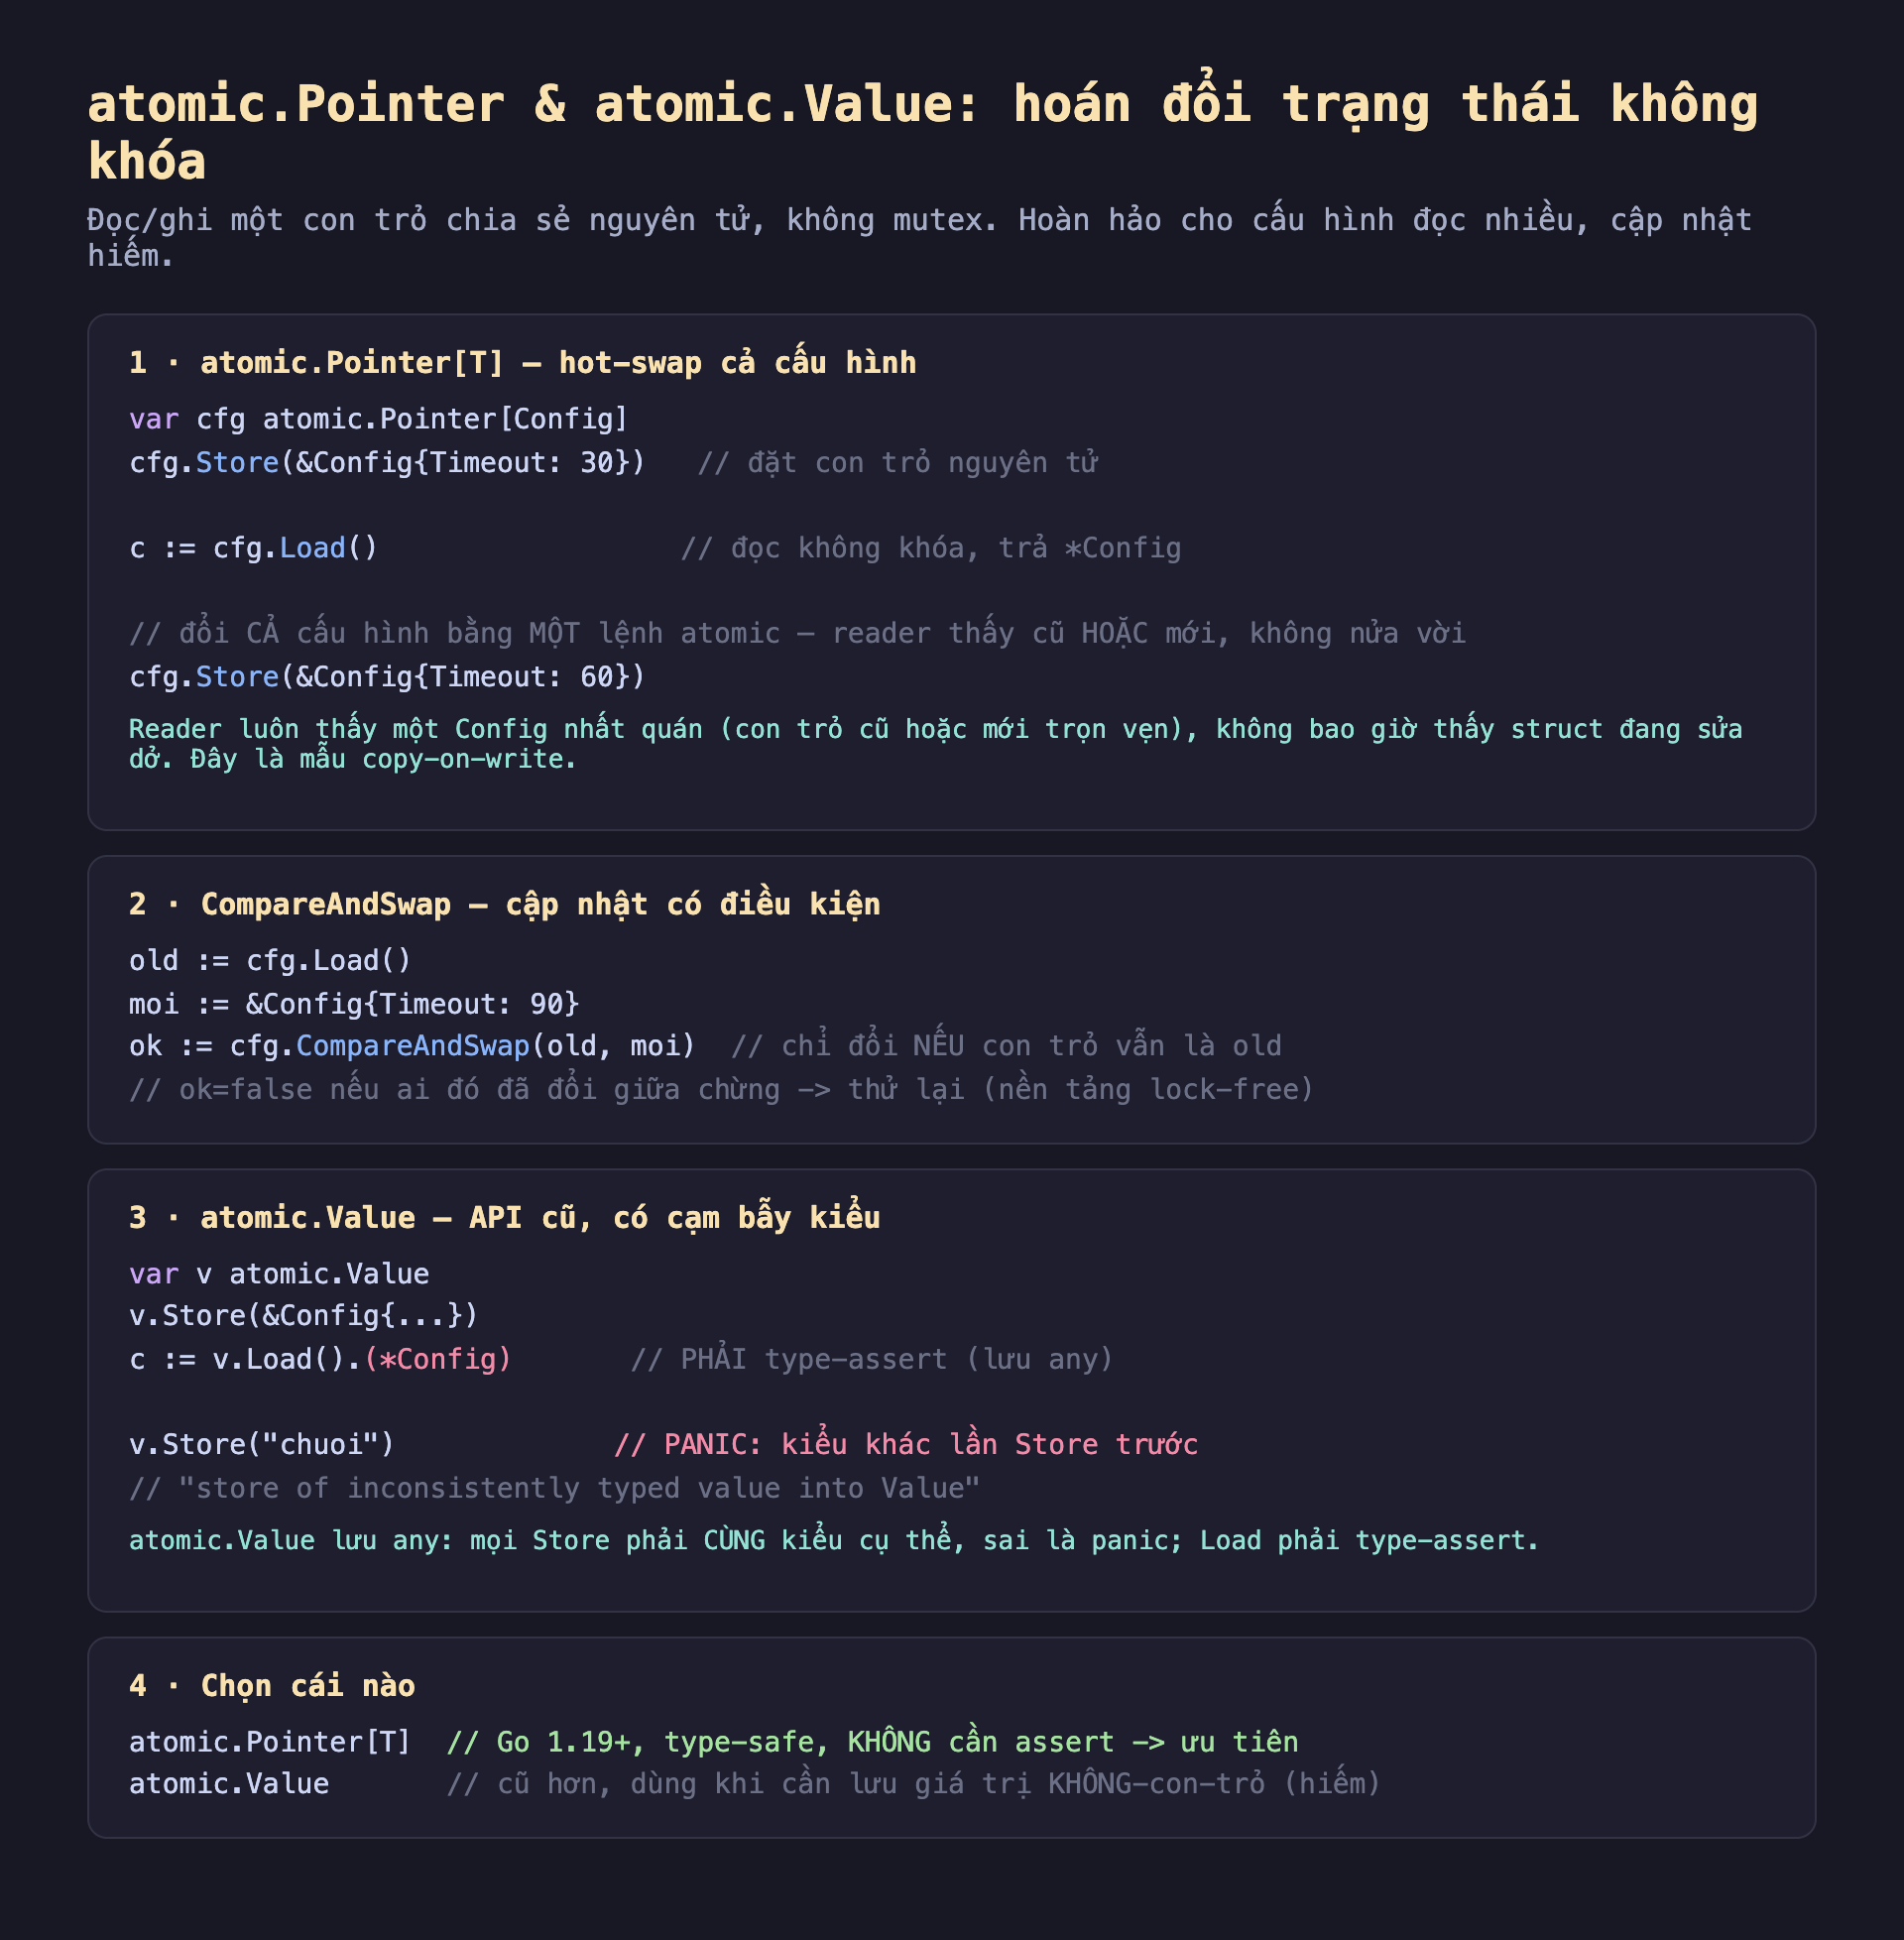
Hình 1: atomic.Pointer hot-swap cấu hình, CompareAndSwap cập nhật có điều kiện, và so sánh với atomic.Value (API cũ cần type-assert, panic nếu Store sai kiểu).
CompareAndSwap: nền tảng lock-free
Ngoài Store/Load, CompareAndSwap cho cập nhật có điều kiện:
old := cfg.Load()
moi := &Config{Timeout: 90}
ok := cfg.CompareAndSwap(old, moi)   // chỉ đổi NẾU con trỏ vẫn là old
// ok=false nếu ai đó đã đổi giữa chừng → thử lại
CAS chỉ ghi nếu con trỏ hiện tại đúng như bạn mong đợi. Nếu một goroutine khác đã đổi nó giữa lúc bạn Load và lúc CAS, CAS trả false và bạn thử lại. Đây là nền tảng của mọi cấu trúc dữ liệu lock-free (chủ đề bài sau).
Đo thật: nhanh hơn RWMutex ~870 lần
So ba cách đọc một cấu hình song song trên 10 core (mẫu đọc-nhiều thực tế):
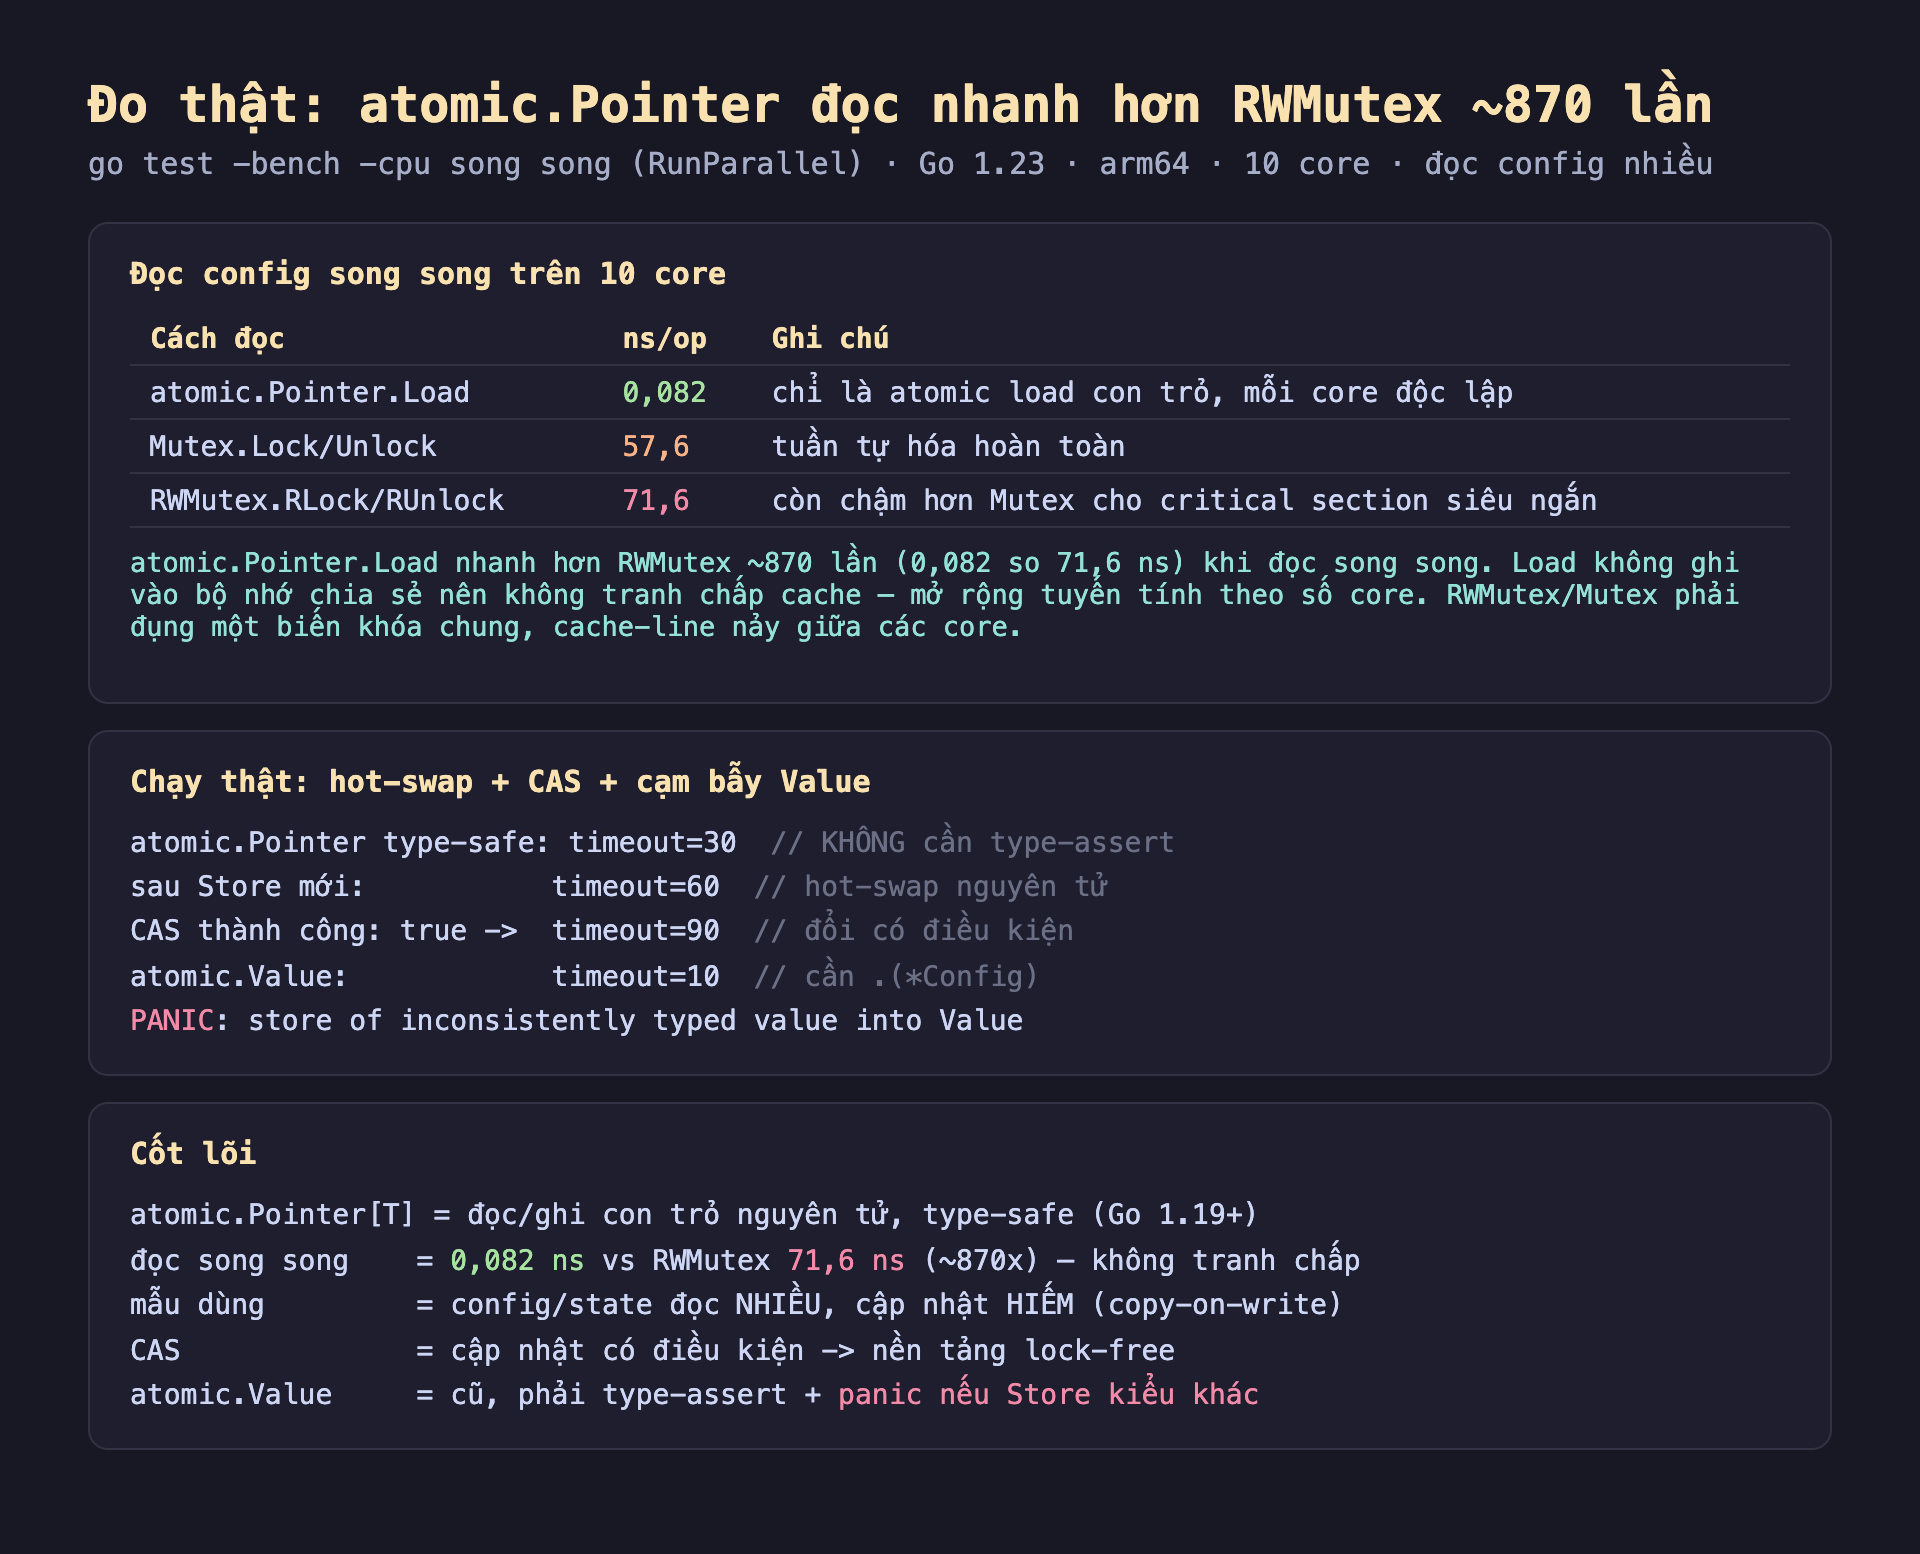
Hình 2: Đọc song song 10 core — atomic.Pointer.Load 0,082 ns so với Mutex 57,6 ns và RWMutex 71,6 ns. atomic.Pointer nhanh hơn ~870 lần; và chạy thật hot-swap/CAS/panic của atomic.Value.
- atomic.Pointer.Load: 0,082 ns/op.
- Mutex (Lock/Unlock): 57,6 ns/op.
- RWMutex (RLock/RUnlock): 71,6 ns/op.
atomic.Pointer nhanh hơn RWMutex ~870 lần khi đọc song song. Vì sao khác biệt khủng khiếp vậy? Load chỉ là một atomic load con trỏ — không ghi vào bộ nhớ chia sẻ, nên mỗi core đọc độc lập, không tranh chấp cache, mở rộng tuyến tính theo số core. Mutex/RWMutex phải ghi vào một biến khóa chung (đếm reader, cờ lock), khiến cache-line "nảy" qua lại giữa các core — điểm nghẽn kinh điển.
Đáng chú ý: RWMutex ở đây còn chậm hơn Mutex. Với critical section siêu ngắn (đọc một field), overhead quản lý reader-count của RWMutex lớn hơn lợi ích cho phép đọc song song — một sự thật ngược trực giác đã đo được.
Ứng dụng thực tế
Cấu hình/feature flag hot-reload. Đây là use case số một: load config từ file/API, Store vào atomic.Pointer, mọi goroutine Load không khóa. Khi config đổi, tạo struct mới và Store — reader tự nhận bản mới ở lần Load kế. Không downtime, không khóa.
Bảng định tuyến / snapshot dữ liệu đọc-nhiều. Bất cứ dữ liệu nào đọc rất nhiều, cập nhật hiếm, và có thể thay toàn bộ bằng một con trỏ mới (copy-on-write) đều hợp: routing table, danh sách server, cache metadata. Cập nhật tốn (copy cả cấu trúc) nhưng đọc cực rẻ — đánh đổi đúng cho tỷ lệ đọc/ghi cao.
Ưu tiên atomic.Pointer[T] hơn atomic.Value. atomic.Value (API cũ) lưu any, cần type-assert khi Load và panic nếu Store một kiểu khác lần trước (đo thật: store of inconsistently typed value into Value). atomic.Pointer[T] type-safe, không cần assert, an toàn hơn — dùng nó trừ khi cần lưu giá trị không-con-trỏ (hiếm).
Đánh đổi cần cân nhắc
atomic.Pointer chỉ hợp copy-on-write, không hợp cập nhật từng phần. Nó thay toàn bộ con trỏ. Nếu bạn cần sửa một phần của cấu trúc chia sẻ (tăng một field, thêm vào map), atomic.Pointer không giúp — bạn phải copy cả cấu trúc rồi swap, tốn nếu cấu trúc lớn hoặc cập nhật thường xuyên. Khi ghi nhiều, mutex hoặc sync.Map có thể hợp hơn.
Con trỏ cũ vẫn sống chừng nào còn reader giữ. Sau Store con trỏ mới, các reader đã Load con trỏ cũ vẫn dùng struct cũ an toàn (GC giữ nó sống tới khi không ai tham chiếu). Đây là ưu điểm (không cần đồng bộ giải phóng) nhưng cũng nghĩa là struct cũ chưa được thu ngay — cân nhắc nếu struct rất lớn và swap liên tục.
Đừng thay mọi mutex bằng atomic. atomic.Pointer thắng lớn cho đọc-nhiều-ghi-hiếm copy-on-write. Với logic cần bảo vệ nhiều biến cùng lúc, hoặc critical section phức tạp, mutex vẫn đúng và dễ đúng hơn. Chọn atomic khi mẫu truy cập khớp, không phải vì "atomic nhanh hơn".
Ba ý mang về
- atomic.Pointer[T] cho đọc/ghi con trỏ chia sẻ nguyên tử, type-safe (Go 1.19+): hot-swap cả cấu hình bằng một
Store(reader thấy cũ hoặc mới trọn vẹn, không nửa vời — copy-on-write), vàCompareAndSwapcho cập nhật có điều kiện (nền tảng lock-free). - Đọc bằng atomic.Pointer nhanh hơn RWMutex ~870 lần khi song song: đo thật Load 0,082 ns so với RWMutex 71,6 ns trên 10 core — vì Load không ghi bộ nhớ chia sẻ nên không tranh chấp cache, mở rộng tuyến tính; RWMutex thậm chí chậm hơn Mutex cho critical section siêu ngắn.
- Ưu tiên atomic.Pointer[T] hơn atomic.Value cũ: atomic.Value lưu
any, cần type-assert và panic nếu Store kiểu không nhất quán — nhưng atomic.Pointer chỉ hợp copy-on-write (thay toàn bộ con trỏ), không hợp cập nhật từng phần hay ghi nhiều.
Bài tập làm thử
Bài 1 (đọc hiểu). Giải thích tại sao đoạn code sau đảm bảo reader không bao giờ thấy một Config "đang sửa dở" (nửa cũ nửa mới), dù nhiều goroutine đọc đồng thời lúc cấu hình được cập nhật.
var cfg atomic.Pointer[Config]
cfg.Store(&Config{Timeout: 30})
// ... nhiều goroutine gọi cfg.Load() liên tục ...
cfg.Store(&Config{Timeout: 60})
Đáp án
Vì atomic.Pointer chỉ đổi con trỏ một cách nguyên tử, không sửa nội dung struct đang tồn tại. Mỗi Store tạo một Config mới hoàn chỉnh rồi thay toàn bộ con trỏ trong một thao tác nguyên tử duy nhất (mẫu copy-on-write). Vì vậy bất kỳ Load() nào tại bất kỳ thời điểm nào cũng chỉ trả về một trong hai khả năng: con trỏ cũ (trỏ tới Config{Timeout: 30} trọn vẹn) hoặc con trỏ mới (Config{Timeout: 60} trọn vẹn) — không bao giờ có trạng thái lai giữa hai bản.
Bài 2 (vận dụng — CAS). Viết một vòng lặp dùng CompareAndSwap để tăng Timeout của cấu hình hiện tại lên thêm 10, đảm bảo đúng ngay cả khi có goroutine khác cũng đang cập nhật đồng thời (retry cho tới khi thành công).
Đáp án
for {
	old := cfg.Load()
	moi := &Config{Timeout: old.Timeout + 10}
	if cfg.CompareAndSwap(old, moi) {
		break
	}
	// có goroutine khác đã đổi giữa chừng → thử lại
}
CompareAndSwap(old, moi) chỉ ghi moi nếu con trỏ hiện tại của cfg vẫn đúng bằng old như lúc Load. Nếu một goroutine khác đã Store/CAS thành công trước, giá trị hiện tại không còn là old nữa, CAS trả false, và vòng lặp đọc lại giá trị mới nhất rồi thử lại — đây là mẫu vòng lặp CAS kinh điển, nền tảng của cấu trúc dữ liệu lock-free.
Bài 3 (sửa lỗi — cạm bẫy atomic.Value). Đoạn code sau bị panic lúc chạy. Xác định nguyên nhân và sửa bằng cách dùng atomic.Pointer[T] thay thế.
var v atomic.Value
v.Store(Config{Timeout: 10})
// ...
v.Store("khong phai config nua")
Đáp án
Nguyên nhân: atomic.Value lưu any, nhưng mọi lần Store phải cùng kiểu cụ thể với lần đầu tiên. Ở đây lần đầu Store một Config, lần sau Store một string — kiểu không nhất quán khiến runtime panic với thông báo dạng store of inconsistently typed value into Value. Sửa bằng atomic.Pointer[Config] (type-safe, không cần type-assert và không có cạm bẫy kiểu này):
var v atomic.Pointer[Config]
v.Store(&Config{Timeout: 10})
// muốn đổi kiểu khác thì phải dùng một biến atomic.Pointer khác — lỗi này không còn xảy ra được nữa vì kiểu đã cố định lúc khai báo bằng generic
Bài 4 (đọc hiểu số liệu). Bài đo, khi đọc song song trên 10 core: atomic.Pointer.Load ~0,082 ns/op, Mutex.Lock/Unlock ~57,6 ns/op, RWMutex.RLock/RUnlock ~71,6 ns/op. Giải thích vì sao Load nhanh hơn cả hai loại mutex tới mức đó, và vì sao RWMutex — vốn được thiết kế cho đọc-nhiều — ở đây lại còn chậm hơn Mutex thường.
Đáp án
Load chỉ đọc một con trỏ đã có sẵn — nó không ghi vào bất kỳ bộ nhớ chia sẻ nào, nên mỗi core đọc hoàn toàn độc lập, không tranh chấp cache, và hiệu năng mở rộng tuyến tính theo số core. Ngược lại, cả Mutex và RWMutex phải ghi vào một biến trạng thái khóa chung (cờ lock, hoặc bộ đếm reader của RWMutex) mỗi lần Lock/Unlock hay RLock/RUnlock, khiến cache-line chứa biến đó "nảy" liên tục giữa các core — điểm nghẽn kinh điển của bộ nhớ chia sẻ nhiều lõi. RWMutex chậm hơn Mutex ở đây vì chi phí quản lý bộ đếm reader (để biết khi nào an toàn cho writer vào) lớn hơn lợi ích cho phép nhiều reader cùng lúc, đặc biệt khi critical section cực ngắn (chỉ đọc một field).
Bài 5 (bẫy/đánh đổi). Một lập trình viên thấy atomic.Pointer nhanh hơn RWMutex ~870 lần, nên quyết định thay mọi cấu trúc dữ liệu chia sẻ trong dự án (kể cả một map cần cập nhật từng key liên tục) bằng atomic.Pointer. Nêu vấn đề với quyết định này.
Đáp án
atomic.Pointer chỉ phù hợp với mẫu copy-on-write: thay toàn bộ con trỏ một lần, phù hợp khi đọc rất nhiều và ghi rất hiếm. Nếu cần cập nhật từng phần của cấu trúc (ví dụ thêm/sửa một key trong map thường xuyên), dùng atomic.Pointer buộc phải copy toàn bộ cấu trúc mỗi lần ghi rồi swap — tốn kém nếu cấu trúc lớn hoặc ghi thường xuyên, và không giải quyết được nhu cầu sửa từng phần. Trong trường hợp ghi nhiều hoặc cần sửa từng phần, mutex hoặc sync.Map phù hợp hơn. Bài viết nhấn mạnh: chọn atomic khi mẫu truy cập (đọc-nhiều, ghi-hiếm, thay-toàn-bộ) khớp, không phải chỉ vì nó đo được nhanh hơn trong một benchmark cụ thể.
Phần sau ta đi sâu vào chính nguyên thủy nền tảng vừa nhắc: Phần sau mổ xẻ CAS (Compare-And-Swap) và cấu trúc lock-free — cách xây một stack/counter không khóa bằng vòng lặp CAS, vấn đề ABA, và khi nào lock-free thực sự thắng mutex.
